
Gemini 3.5 Flash – Google 推出的一代 AI 大模型
导读摘要:
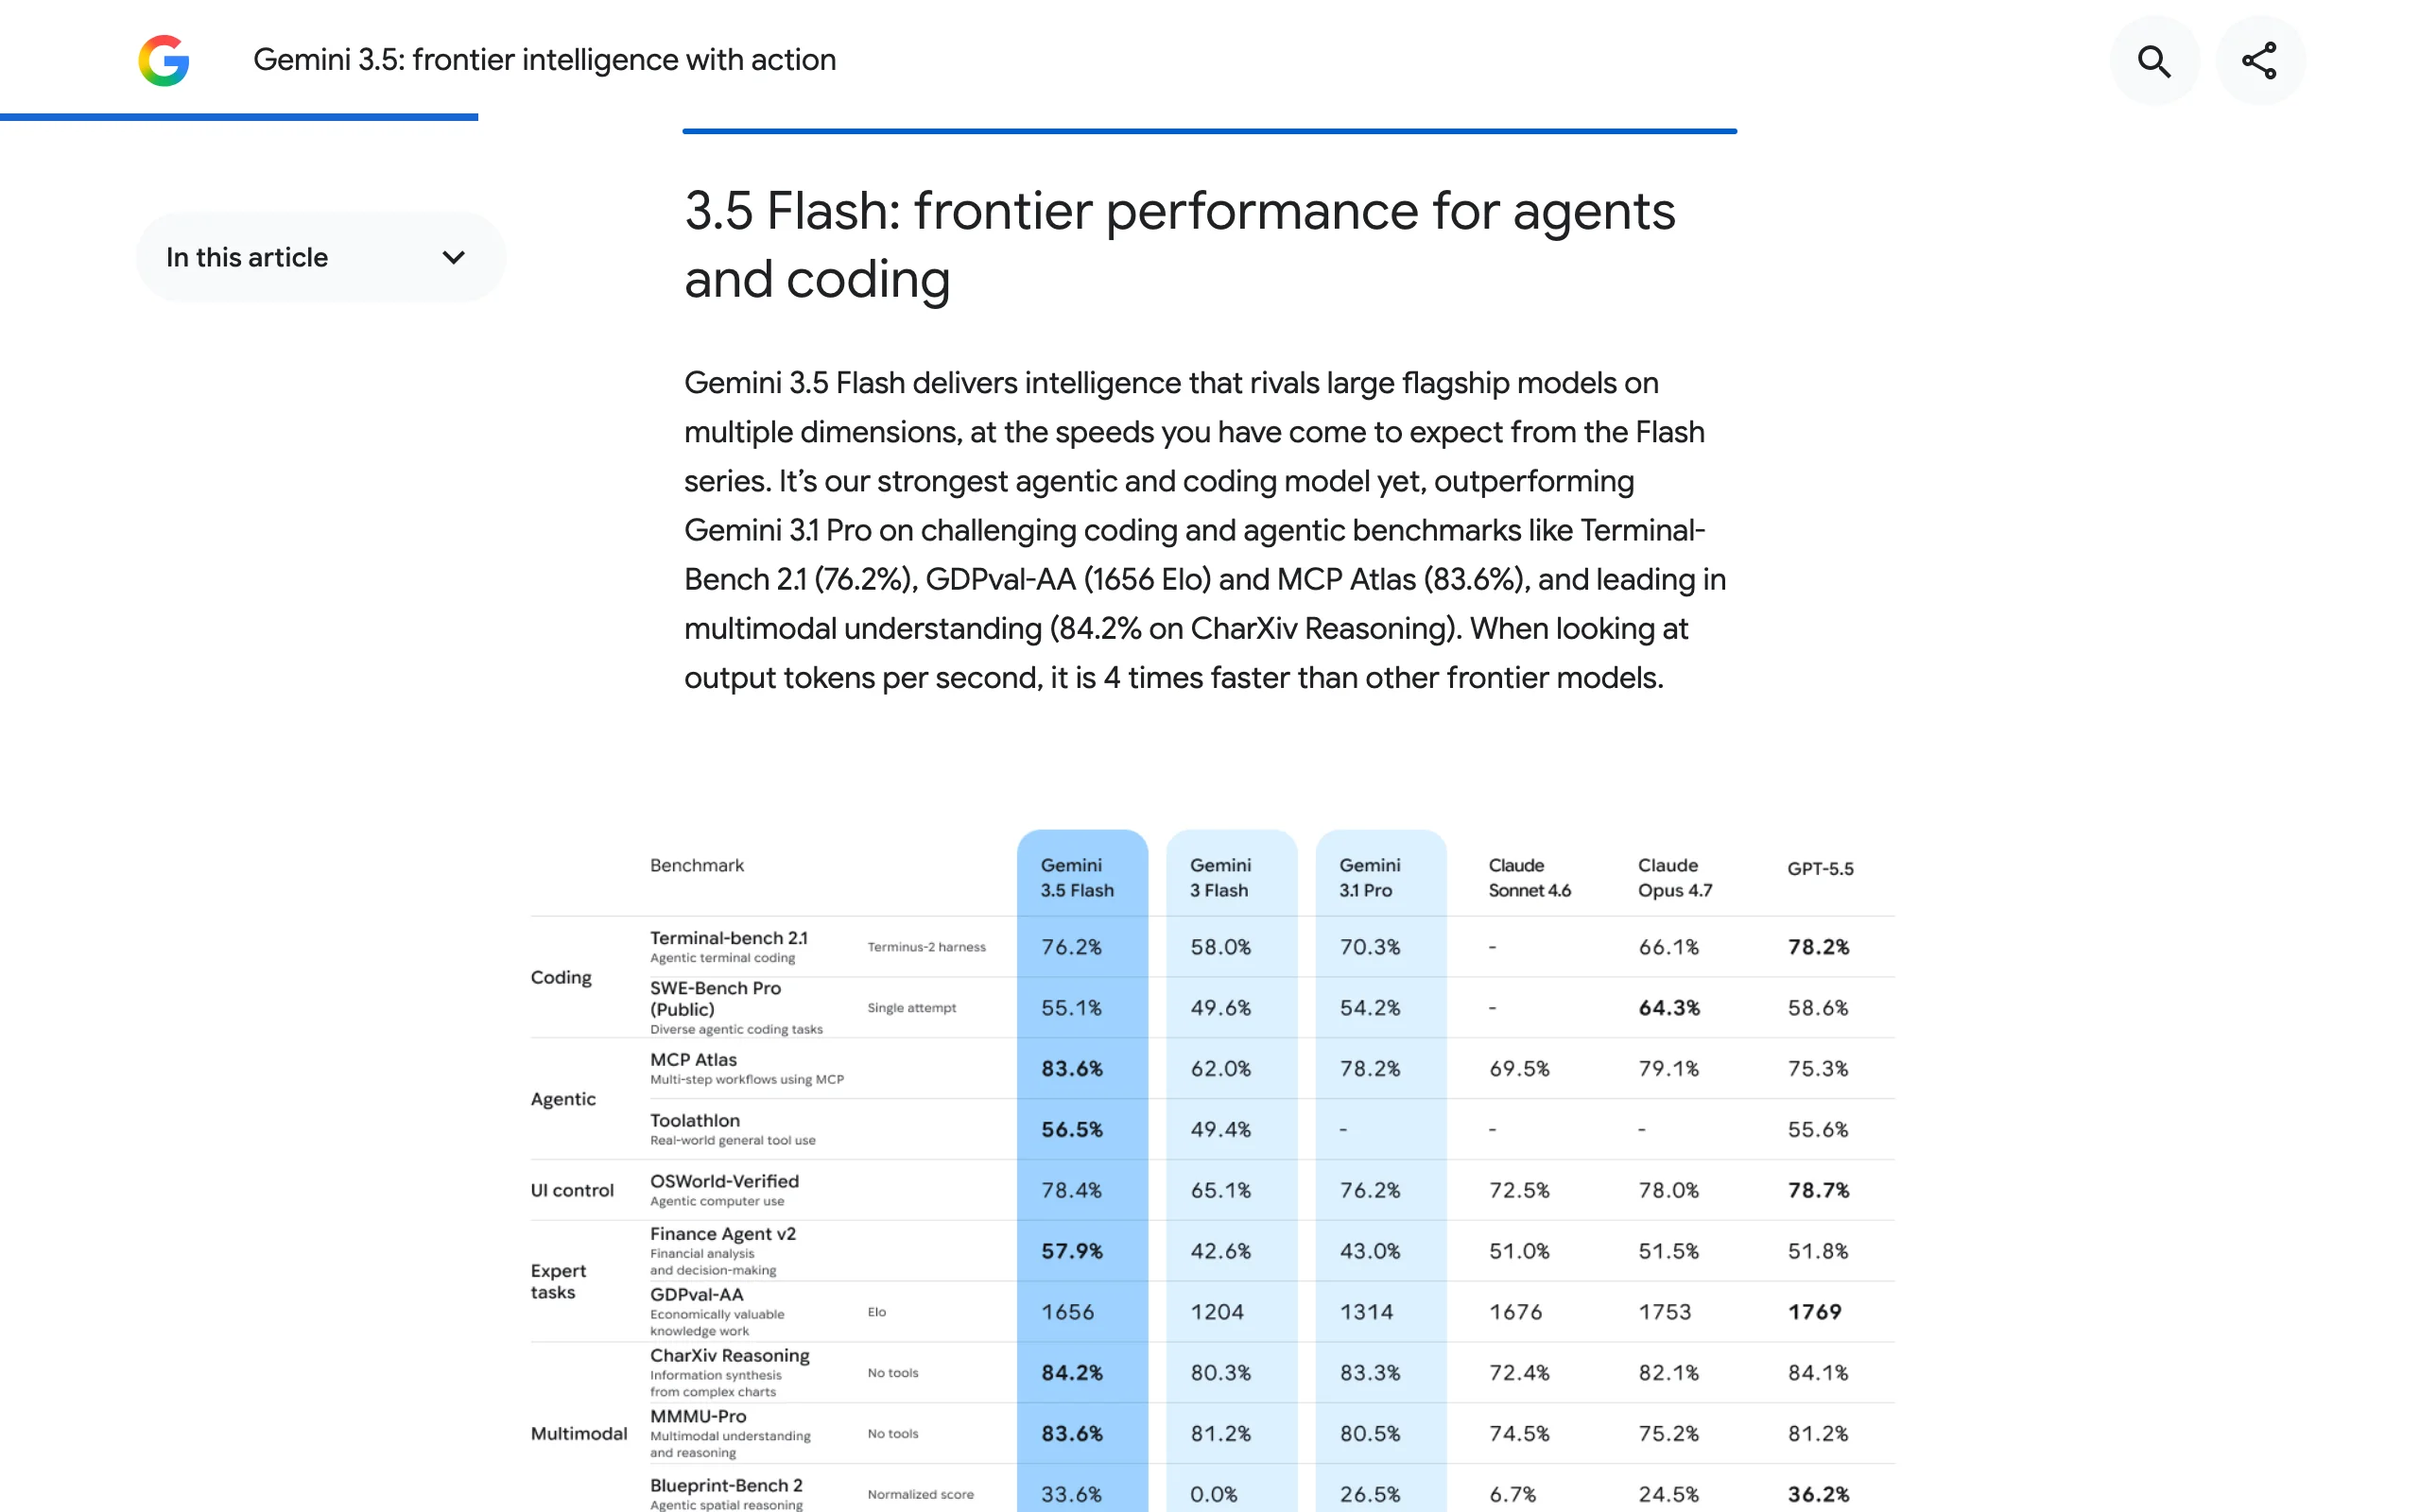
Gemini 3.5 Flash 是 Google 推出的新一代 AI 大模型,以“前沿智能+行动能力”为核心定位,标志着 Google 在高效推理与 Agent 能力融合上的重大突破。该模型在 Terminal-Bench 2.1 编码基准上取得 76.2% 的得分,在 GDPval-AA 代理任务中达到 1656 Elo,在 MCP Atlas 上获得 83.6%,三项关键指标均超越前代旗舰 ...
1. Gemini 3.5 Flash是什么
Gemini 3.5 Flash 是 Google 推出的新一代 AI 大模型,以“前沿智能+行动能力”为核心定位,标志着 Google 在高效推理与 Agent 能力融合上的重大突破。该模型在 Terminal-Bench 2.1 编码基准上取得 76.2% 的得分,在 GDPval-AA 代理任务中达到 1656 Elo,在 MCP Atlas 上获得 83.6%,三项关键指标均超越前代旗舰 Gemini 3.1 Pro。其输出速度达到前沿模型平均水平的 4 倍,而成本仅为不到一半,并原生支持 100 万 Token 的多模态上下文窗口。目前,Gemini 3.5 Flash 已全球上线至 Gemini App 与 Search AI Mode,面向消费者、开发者和企业用户同步开放。
技术定位与领域: 属于自然语言处理与多模态 AI 大模型领域,定位于高效推理型 Agent 模型。与传统大语言模型侧重通用对话能力不同,Gemini 3.5 Flash 专注于在极低延迟下执行复杂编码、工具调用和多步推理任务,是面向 Agent 时代设计的“行动型”模型。
研发背景: 由 Google DeepMind 团队基于 Gemini 3.5 系列全新架构开发。研发动机源于对 Agent 应用场景中“推理速度与成本”瓶颈的深刻洞察——传统前沿模型虽然能力强,但推理延迟高、成本昂贵,难以支撑大规模 Agent 部署。通过先进的蒸馏技术与动态推理预算分配机制,Google 成功在保持接近 Pro 级能力的同时,大幅降低计算开销。
核心价值: 解决了 Agent 场景中长期存在的“能力-速度-成本”三角矛盾。模型在保持顶级编码与工具调用能力的同时,实现了 289 tokens/秒的极速推理,API 定价仅为 $1.50/$9.00 每百万 Token(输入/输出),比 Claude Opus 4.7、GPT-5.5 等竞品便宜一半以上。Google 估算,头部 Cloud 客户将 80% 的前沿工作负载迁移至 3.5 Flash 后,每年可节省超 10 亿美元。
技术特点: 核心技术优势包括:基于蒸馏压缩的轻量化架构,实现接近 Pro 级能力但体积大幅减小;引入动态推理预算分配机制(thinking_level 参数),根据任务类型自动分配计算资源;采用原生多模态统一编码器,将文本、图像、音视频嵌入同一语义空间;支持 100 万 Token 的超长上下文窗口,可一次性处理整本长篇小说或百页法律合同。
2. 主要功能
极速推理与生成: 输出速度达到 289 tokens/秒,是其他前沿模型的 4 倍。经 Antigravity 内部联合优化后,在特定 Agent 工作流中可实现 12 倍的端到端提升,显著降低多轮 Agent 调用的感知延迟,使实时交互体验接近自然对话。
顶级编码与 Agent 能力: 在 Terminal-Bench 2.1(76.2%)、SWE-Bench Pro(55.1%)、MCP Atlas(83.6%)和 Toolathlon(56.5%)等关键基准上全面超越 Gemini 3.1 Pro。MCP Atlas 得分 83.6%,是目前该基准上的最佳成绩,体现了模型在复杂工具编排与多步推理上的领先优势。
多模态长上下文理解: 原生支持 100 万 Token 输入窗口,可统一处理文本、图像、视频、音频及 PDF 等多种模态数据。CharXiv Reasoning 得分 84.2%,MMMU-Pro 达 83.6%,在跨模态推理任务上表现优异,特别适合法律文档审核、长视频内容分析等场景。
子代理协作编排: 通过 Antigravity 2.0 框架部署并行子代理,支持大规模 Agent 协同工作。官方演示中,93 个 subagent 在 12 小时内以不到 1000 美元的成本完成了完整操作系统的开发,展示了模型在大规模 Agent 编排上的实用价值。
动态推理级别控制: 引入
thinking_level参数,支持标准(standard)和扩展(extended)两种模式。用户可按任务需求切换思维深度:代码生成与工具调用默认使用 low 档位优化速度,复杂推理任务可选择 high 档位获得更深度的分析。全平台生态覆盖: 已接入 Gemini App、Search AI Mode、Antigravity 2.0、AI Studio、Android Studio 等 Google 全系产品。消费者、开发者和企业用户三端同步可用,降低了部署和使用的技术门槛。
3. 如何使用
选择接入平台: 根据使用场景选择合适的接入方式。消费者可通过 Gemini App 或 Google Search AI Mode 直接使用;开发者推荐使用 Google AI Studio 或 Antigravity 2.0 桌面应用;企业用户可通过 Vertex AI 进行大规模部署。
更新 API 模型标识: 若已使用旧版预览 API,需将代码中的模型名称从旧版预览标识替换为正式版标识
gemini-3.5-flash。注意检查 API 版本兼容性,确保 SDK 已更新至最新版本。配置推理级别(thinking_level): 根据任务类型设置
thinking_level参数以优化性能。代码生成与工具调用任务推荐使用low档位以最大化速度;通用对话任务使用medium档位平衡速度与质量;复杂推理任务使用high档位获得深度分析能力。移除采样参数覆盖: 建议删除手动设置的
temperature、top_p、top_k等采样参数默认值,让模型使用内部优化配置。Gemini 3.5 Flash 已针对不同任务类型优化了默认参数,手动覆盖可能影响推理效果。注意功能迁移例外: 若工作流依赖 Computer Use 浏览器控制功能,需继续使用
gemini-3-flash-preview版本。Gemini 3.5 Flash 暂不支持该功能,迁移前需确认功能兼容性。性能调优建议: 对于高并发 Agent 场景,建议使用 Antigravity 2.0 的并行子代理功能,利用模型的低延迟特性实现多任务并行处理。同时注意监控 Token 消耗,合理设置上下文窗口大小以优化成本。
4. 优缺点分析
| 优点 |
|---|
| 极速推理性能: 输出速度达 289 tokens/秒,是其他前沿模型的 4 倍,经 Antigravity 优化后可达 12 倍提升,显著降低 Agent 多轮调用延迟。 |
| 成本优势显著: API 定价 $1.50/$9.00 每百万 Token(输入/输出),比 Claude Opus 4.7、GPT-5.5 等竞品便宜一半以上,大规模部署成本优势突出。 |
| Agent 能力领先: MCP Atlas 得分 83.6%,支持 93 个子代理并行协作,12 小时内以不到 1000 美元完成操作系统开发,专为复杂 Agent 任务优化。 |
| 超长上下文窗口: 支持 100 万 Token 多模态输入,可一次性处理整本长篇小说、百页法律合同或长视频内容,长文档分析能力突出。 |
5. 同类工具对比
| 对比维度 | Gemini 3.5 Flash | Claude Opus 4.7 | GPT-5.5 |
|---|---|---|---|
| 核心架构 | 蒸馏压缩架构,动态推理预算分配 | 大规模 Transformer,静态计算预算 | 混合专家模型(MoE),动态路由 |
| 输出速度 | ~289 tokens/秒(4x 领先) | ~67 tokens/秒 | ~71 tokens/秒 |
| Terminal-Bench 2.1 | 76.2% | 未公布 | 78.2% |
| MCP Atlas | 83.6%(领先) | 79.1% | 75.3% |
| 上下文窗口 | 1M Token | 200K Token | 128K Token |
| API 定价(输入/输出) | $1.50 / $9.00 每百万 Token | ~$3.00 / $15.00 每百万 Token | ~$2.50 / $10.00 每百万 Token |
| 部署方式 | 云端 API + 全平台生态 | 云端 API | 云端 API + Azure |
选型建议:
对于追求极致速度和成本效益的 Agent 应用场景,Gemini 3.5 Flash 是最优选择。其在 MCP Atlas 和 Terminal-Bench 2.1 上的领先表现,结合 4 倍的速度优势和不到一半的成本,使其成为大规模 Agent 部署的首选。特别适合需要频繁调用模型进行编码、工具操作和多步推理的任务。
对于需要最强复杂推理能力的场景,GPT-5.5 在 GDPval-AA 等综合代理基准上表现更优。如果团队已经深度绑定 Google 生态(如使用 Google Cloud、Android Studio 等),Gemini 3.5 Flash 的全平台集成能力将带来显著的开发效率提升。而对于依赖 Claude 生态或需要 Computer Use 功能的用户,Claude Opus 4.7 仍是必要选择。
6. 编辑点评
Gemini 3.5 Flash 的推出,标志着 AI 大模型从“通用对话”向“高效行动”的关键转变。从技术创新性来看,模型在蒸馏压缩架构上的突破值得关注——通过先进的蒸馏技术将 Gemini 3.1 Pro 的能力压缩到更小的模型体积中,同时实现了 4 倍的速度提升,这在业界尚属首次。动态推理预算分配机制(thinking_level 参数)更是巧妙解决了“速度-质量”权衡问题,让用户能根据任务需求灵活调整计算资源分配。
从实用价值分析,Gemini 3.5 Flash 在 Agent 场景中的表现尤为突出。MCP Atlas 83.6% 的得分和 93 个子代理并行协作的演示,证明了模型在复杂工具编排和大规模 Agent 协作上的实用能力。对于企业级 Agent 自动化、金融文档智能审核、实时编程助手等场景,模型的速度优势和成本效益将带来显著的效率提升。
适用人群定位方面,该模型最适配三类用户:一是需要高频调用 AI 进行编码和工具操作的开发者;二是需要大规模部署 Agent 自动化系统的企业;三是需要处理超长文档或多模态内容的专业人士。对于普通对话场景,Gemini 3.5 Flash 的能力可能超出需求,反而推荐使用更轻量的模型。
未来发展潜力巨大。随着 Agent 应用场景的爆发式增长,对高效推理模型的需求将持续上升。Google 在模型压缩和动态推理预算分配上的技术积累,有望在后续版本中进一步优化。建议关注 Antigravity 2.0 框架的更新,以及 Computer Use 功能的回归时间表。
7. 应用场景
实时 AI 编程助手: 低延迟特性使其特别适合 IDE 自动补全、代码审查与交互式调试场景。Antigravity 2.0 已将其设为默认模型,开发者可在编码过程中获得近乎实时的代码建议和错误检测,显著提升开发效率。
企业级 Agent 自动化: 部署并行子代理处理多周工作流,如 Xero 用于自动管理 1099 税表供应商识别与信息收集。通过 Antigravity 2.0 框架,企业可将复杂的业务自动化流程拆解为多个子代理并行执行,大幅缩短处理周期。
金融文档智能审核: Macquarie Bank 使用 Gemini 3.5 Flash 推理 100 页以上的复杂金融文档,加速客户入职与合规审核流程。模型的多模态长上下文能力使其能一次性处理整份合同,提取关键条款并生成审核报告。
多模态发票与 OCR 处理: Ramp 利用模型的多模态理解能力与历史模式推理,实现复杂发票的智能化识别与分类。模型不仅能提取文字信息,还能理解发票结构、识别异常模式,大幅提升财务处理的自动化水平。
长视频内容分析: 利用 100 万 Token 上下文窗口,可一次性处理整段长视频内容,提取关键信息、生成摘要或进行语义搜索。适用于影视内容审核、教育培训视频分析等场景。
学术研究与文献综述: 研究人员可使用模型处理整本学术专著或大量论文,进行跨文档的语义分析和知识整合。模型的多模态能力使其能同时分析文本、图表和公式,提升文献综述效率。
8. 常见问题FAQ
Q:Gemini 3.5 Flash 与 Gemini 3.1 Pro 相比,主要优势是什么?
A:主要优势体现在速度、成本和 Agent 能力三个维度。输出速度是 3.1 Pro 的 2 倍以上(289 vs 135 tokens/秒),API 定价更低,且在 Terminal-Bench 2.1、MCP Atlas 等关键 Agent 基准上全面超越。但 3.1 Pro 在某些复杂推理任务上可能仍有优势。
Q:是否支持本地部署?
A:目前 Gemini 3.5 Flash 主要通过 Google 云端 API 提供服务,暂不支持本地部署。用户可通过 Gemini App、Google AI Studio、Antigravity 2.0 等平台接入。对于需要本地部署的场景,建议关注 Google 后续的开源计划。
Q:thinking_level 参数如何选择?
A:推荐根据任务类型选择:代码生成与工具调用使用 low 档位以最大化速度;通用对话任务使用 medium 档位平衡速度与质量;复杂推理任务使用 high 档位获得深度分析。如果不确定,建议从 medium 开始尝试。
Q:100 万 Token 上下文窗口的实际使用效果如何?
A:在实际测试中,模型能有效处理 100 万 Token 的输入,但在长上下文场景下,推理速度会有所下降。建议根据实际需求合理设置上下文窗口大小,对于超长文档,可考虑分段处理以获得更好的性能表现。
Q:为什么需要移除采样参数默认值?
A:Gemini 3.5 Flash 已针对不同任务类型优化了内部采样参数配置。手动设置 temperature、top_p、top_k 等参数可能会覆盖模型的优化配置,导致推理效果下降。建议让模型使用默认配置,仅在特定场景下进行微调。
Q:Computer Use 功能何时会支持?
A:Google 尚未公布 Computer Use 功能的回归时间表。依赖该功能的用户需继续使用 gemini-3-flash-preview 版本。建议关注 Google AI 官方博客和 API 更新日志,获取最新功能发布信息。
9. 项目地址
- 项目官网: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5/#gemini-3-5-flash
- Google AI Studio: https://aistudio.google.com/
- Gemini API 文档: https://ai.google.dev/gemini-api/docs/models#gemini-3-5-flash
- Antigravity 2.0: https://antigravity.google/
相关推荐
Xing4.0-29B-Intent:星辰实验室开源的意图理解专用模型深度评测
Xing4.0-29B-Intent是星辰实验室(XingChen Lab)开源的意图理解专用模型,基于自研的Xing4.0-29B-A4B通用基座模型微调而成。该模型采用“类别+参数”的结构化输出范式,将用户自然语言输入同时转换为意图分类结果与参数抽取结果,支持意图识别、实体识别、关系抽取、事件抽取四类核心任务。凭借MoE架构带来的计算效率优势,模型平均仅输出数十个Token即可完成完整的语义解...
CleanYourTV – 开源的电视广告去除工具,垃圾软件全清空
CleanYourTV 是一款开源的电视系统优化工具,通过 Wi-Fi 网络利用 ADB(Android Debug Bridge)协议连接安卓电视,借助 Claude Code、Codex、Gemini CLI 等 AI Agent 自动识别并停用厂商预装的广告应用、数据遥测服务和臃肿软件,同时安装一款风格类似 Apple TV 的极简桌面 Launcher。该工具全程无需 Root 权限、不卸...

MiniMax M3.1 Flash – MiniMax 推出的一代 Flash 模型
MiniMax M3.1 Flash是MiniMax于2026年推出的新一代Flash系列模型,以匿名“Space Bunny”身份在各大评测基准中亮相,训练数据量超过200T Token。该模型在Agentic任务、编程、Computer Use及网络安全四大领域均展现出色表现,DeepSWE v1.1得分73.7%、OSWorld V2得分61.7、CyberGym得分82%,已全面上线Min...
Hy Memory 2.0 – 腾讯混元开源的智能体记忆框架
Hy Memory 2.0 是腾讯混元开源的智能体记忆框架,采用"模型 + 框架 + 应用"三层架构:专为记忆训练的 Hy-Memory-30A3B 模型、支持聊天/工作/代码三类记忆的 SDK,以及可连接 10 种 AI 工具的本地记忆管理应用 MemHub。该框架能够跨对话、跨工具沉淀和同步个人记忆,使 Agent 具备连续、完整的长期记忆能力,已在腾讯自选股、腾讯新闻等核心业务中落地验证。
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。