
Hyra 2.0 – 腾讯混元推出的 AI 科研智能体
导读摘要:
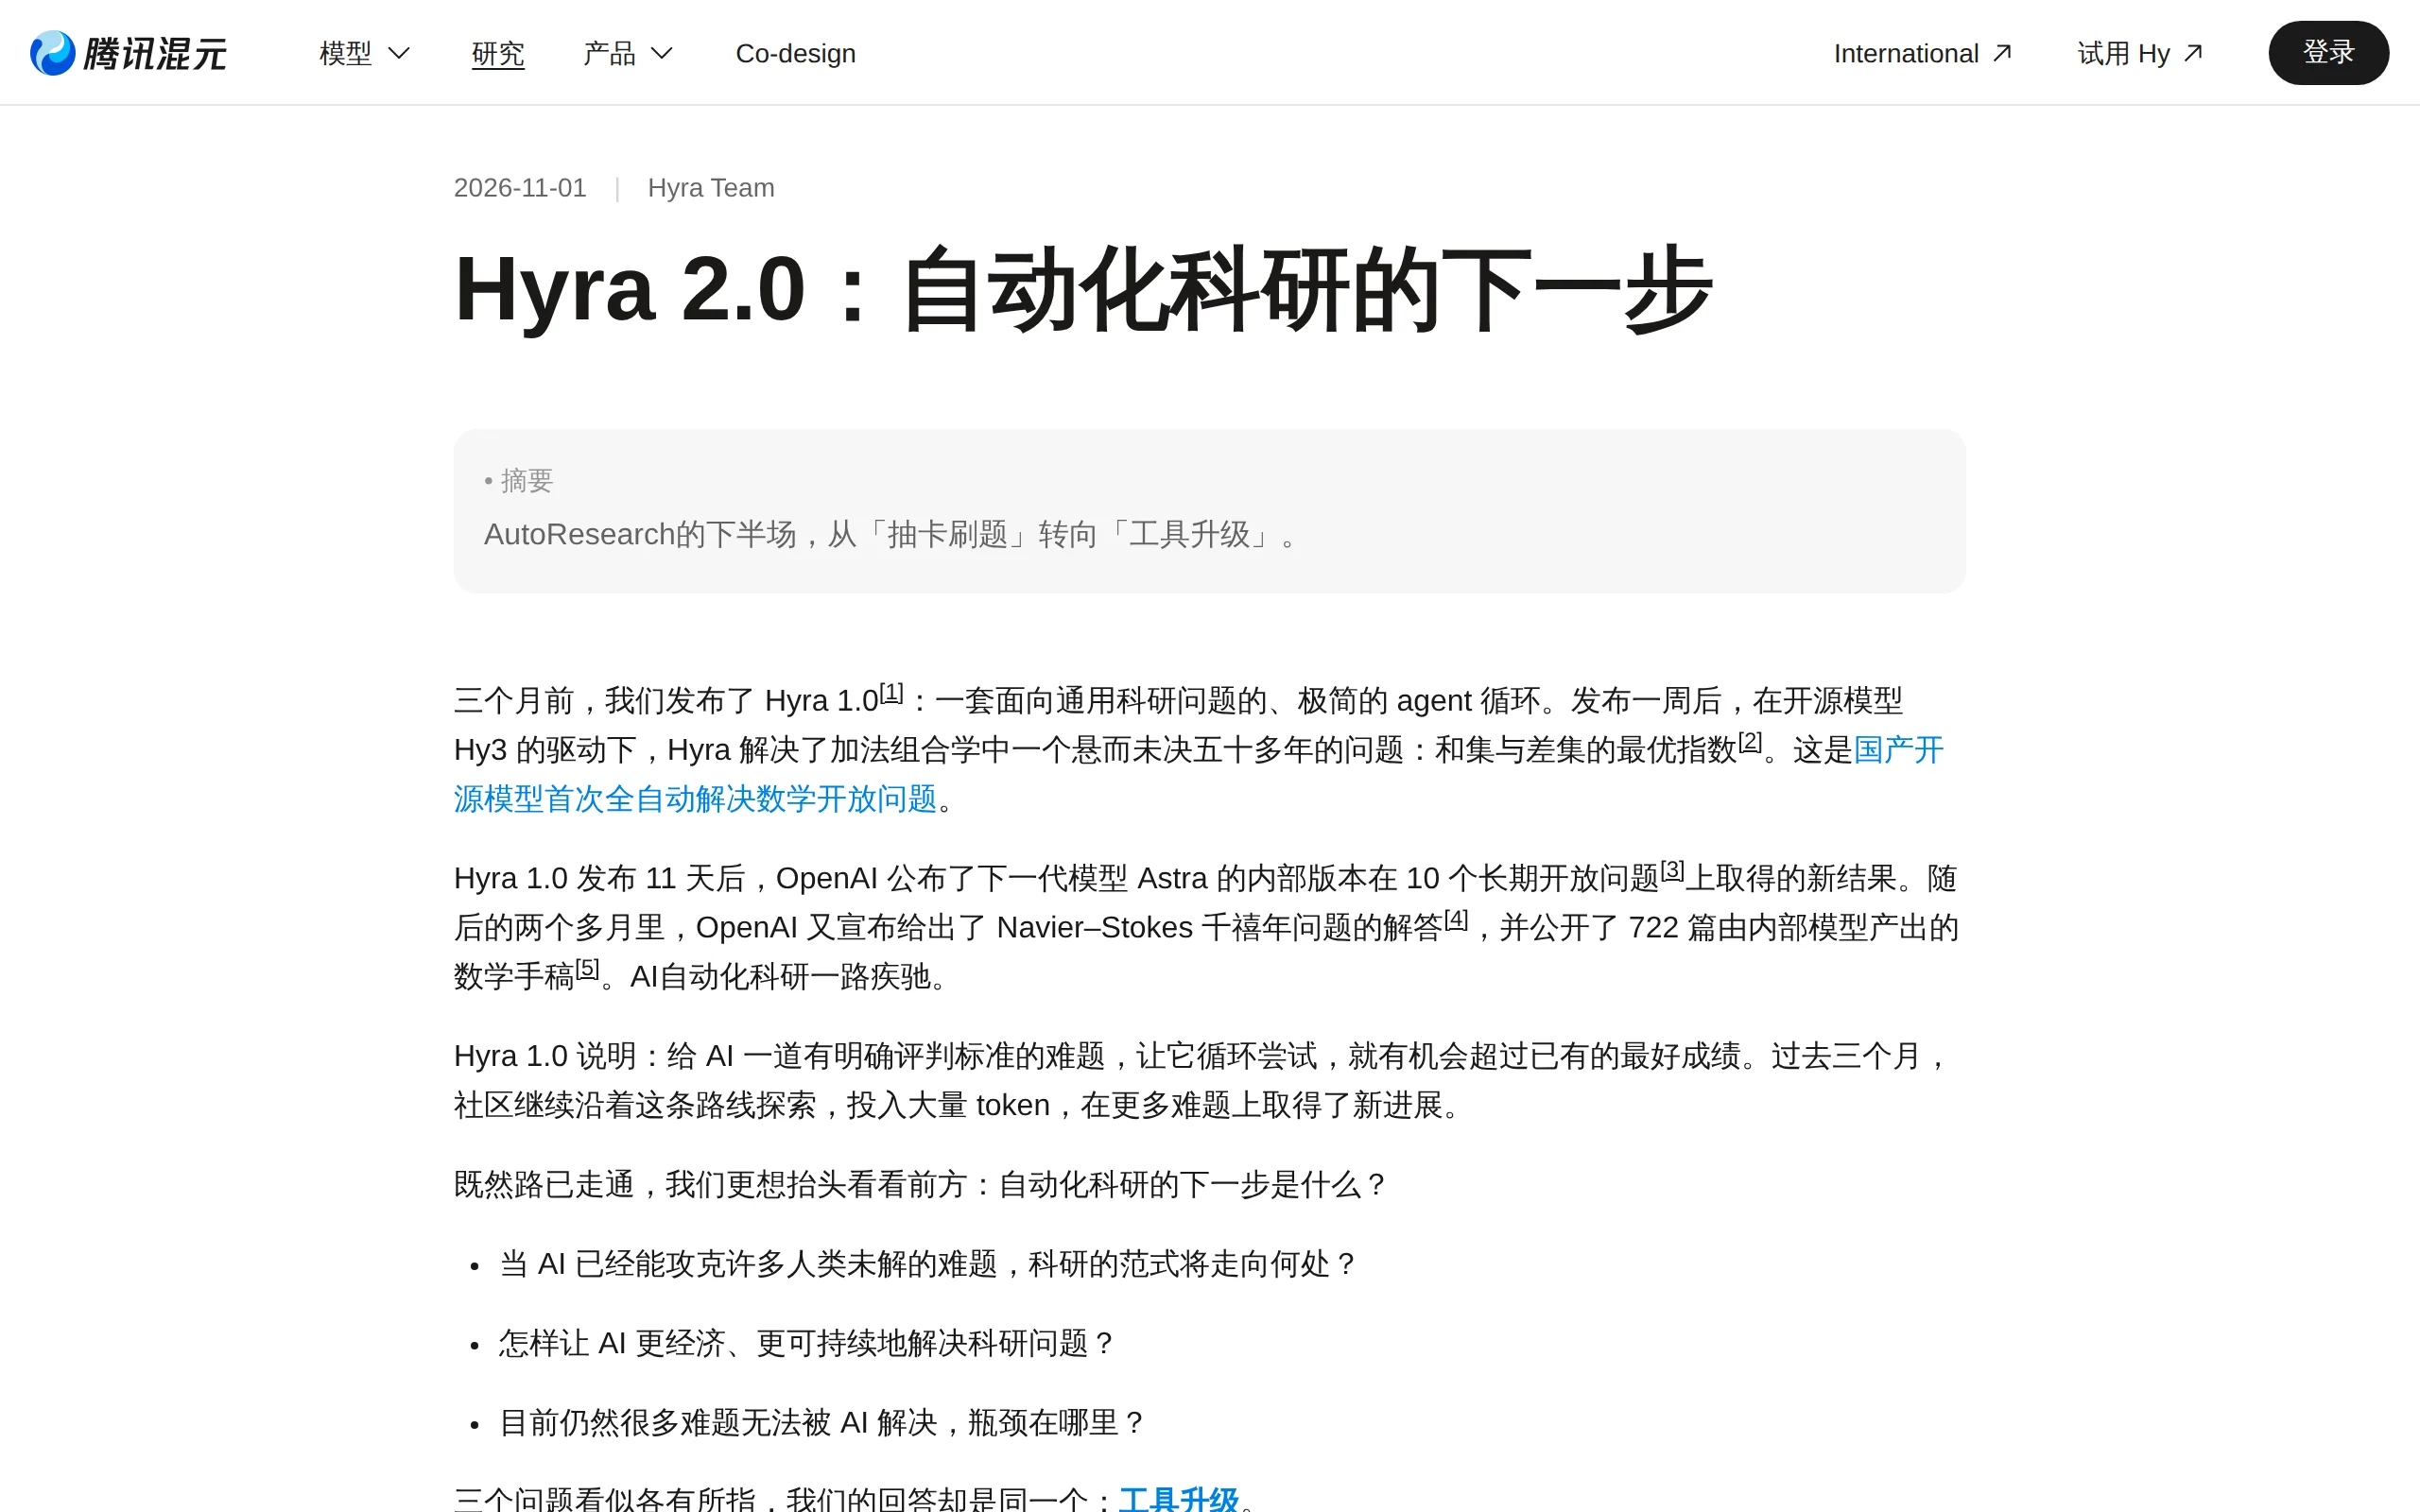
Hyra 2.0是腾讯混元推出的AI科研智能体,是Hyra 1.0的升级版,核心定位从自动解题转向研发工具。该智能体能够长期自主训练科学模型、优化研究工作流,并将研究经验沉淀为可复用的资产,在蛋白质设计、分子模拟、数学证明、量子纠错等领域已产出实际成果。其长期目标是让工具升级与模型增强彼此驱动,形成递归自我改进的闭环。
1. Hyra 2.0是什么
Hyra 2.0是腾讯混元推出的AI科研智能体,是Hyra 1.0的升级版,核心定位从自动解题转向研发工具。该智能体能够长期自主训练科学模型、优化研究工作流,并将研究经验沉淀为可复用的资产,在蛋白质设计、分子模拟、数学证明、量子纠错等领域已产出实际成果。其长期目标是让工具升级与模型增强彼此驱动,形成递归自我改进的闭环。
技术定位与领域: Hyra 2.0属于AI for Science领域的科研智能体系统,致力于将大语言模型从「解题工具」升级为「研发工具」。与常规AI助手不同,它并非停留在回答科学问题的层面,而是直接参与科学模型的设计、训练、评估与部署全流程,构建可复用的研究基础设施。
研发背景: 该智能体由腾讯混元大模型团队研发。其在Hyra 1.0的基础上实现了范式升级——从自动解题转向科研工具研发。腾讯混元持续投入基础科研,通过Hyra系列将大模型能力引入科学发现流程,目前已覆盖蛋白质设计、分子模拟、数学证明、量子纠错等多个高难度领域。
核心价值: Hyra 2.0的核心价值在于实现了「智能复利」——每一次研发成果都能被后续研究反复使用。相比一次性解题,工具升级能让所有下游任务受益,形成可持续积累的科研资产体系。同时,其异步协作与独立复核机制显著提升了AI科研结论的可信度。
技术特点: 技术上采用Overall、Mission、Worker三层组织架构,配合持久化任务队列和调度系统,支持数天至数周的长周期多项目并行研究。其独创的Review Worker独立复核机制和Books三级可信度知识库,在AI科研智能体中具有差异化优势。
2. 主要功能
端到端工具研发: 由agent端到端完成科学模型的设计、训练、评估与部署全流程。HyInv、HyPLM等均是从头完成预训练、微调、强化学习和推理优化的新模型,而非简单调用已有模型,体现真正的研发能力而非应用能力。
三层协作研发架构: 通过Overall、Mission、Worker三层分工组织长期研究。Overall对接人类并管理优先级与资源;Mission长期负责一个研究问题并对结论负责;Worker执行探索与实验,可独立验证并质疑Mission的判断。这种组织方式确保了研究方向的连贯性和执行层面的独立性。
持久化任务调度: 任务进入持久化队列后,由调度系统按优先级、依赖关系和资源上限启动。当某个任务等待训练结果或人工审批时,其他任务照常推进。agent可设置唤醒时间,在检查节点自动接续工作,实现跨数天至数周的长期任务管理。
独立复核机制: Review Worker在新上下文中先接触原始问题与证据,对执行者的结论进行交叉验证,排除执行者结论的影响。Worker报告完成时必须附上代码版本、实验结果、日志或运行轨迹作为证据,复核发现的错误或更窄的结论范围都如实保留。
三层记忆分离与分级知识库: 系统将项目状态、agent分层工作记忆(当前认识、关键假设、已排除路线、下一步计划)、跨任务共享知识库Books分开保存。Books中的每条记录须说明做法、理由、适用条件并附原始证据,按「观察」、「已验证」、「约定」三级可信度管理。
多领域成果落地: 首批产出覆盖蛋白质设计、分子模拟、数学证明、量子纠错、机器人本体设计与芯片优化六个领域。具体成果包括量子码[488,123,22]编码效率超原榜首约48%、丘成桐猜想相关证明核验、香山芯片优化等效官方2至3个月迭代。
参与大模型研发: Hyra 2.0介入下一代Hy模型的预训练基建、后训练数据管线与推理系统优化,为混合模型的整体能力迭代提供科研智能体的支撑。
3. 应用场景
药物设计与酶工程: 调用HyInv等逆折叠模型,在50毫秒内完成128条蛋白质序列的设计,实现候选分子的高效筛选。该场景适用于制药企业、生物技术公司,可显著加速新药研发前期阶段的候选分子发现流程。
分子动力学模拟: 以HyFF原子级力场驱动大规模模拟,在原子尺度追踪分子运动与反应过程。适用于材料科学和药物研发领域,帮助科研人员理解分子机制、预测材料性能,减少物理实验次数。
数学理论研究: 借助HyProver工作流组织猜想提出、证明构造与独立复核,辅助数学家攻克开放问题。在丘成桐猜想相关证明的核验中已展现应用价值,可承担大规模逻辑推导与核验工作。
量子纠错码研发: 用HyQEC构造新量子码并精确认证码距,为量子计算机的纠错开销优化提供工具。其发现的量子码[488,123,22]编码效率超原榜首约48%,对量子计算实用化进程具有重要意义。
芯片设计与验证: 像优化香山处理器那样开展性能调优、fuzz测试与形式化验证,缩短芯片迭代周期。成果等效于官方2至3个月的迭代工作量,适用于半导体设计企业的架构探索与验证环节。
4. 如何使用
Hyra 2.0目前是腾讯混元内部的科研研发系统,非对外开放的SaaS产品。使用方式以了解与跟进官方进程为主:
了解项目背景: 首先通过官方研究页面获取Hyra 2.0的技术原理、功能特性和成果详情。阅读技术文章可了解三层组织架构、Review Worker机制、Books知识库等核心设计。
访问官方研究成果仓库: Hyra 2.0的成果仓库hyra-results已公开(Apache 2.0许可证),社区可查看和使用其产出的新模型、验证系统、证明工作流等可复用资产。具体访问方式以官方页面指引为准。
关注开放计划: 由于系统本身尚在内部研发阶段,外部用户需关注腾讯混元官方发布渠道,获取后续可能的开放计划、API接入或开源安排。具体时间表以官方公告为准。
参与社区讨论与应用: 对于已公开的成果资产(如蛋白质设计模型、量子纠错码数据),科研人员可通过Apache 2.0许可将其整合到自有研究流程中。同时可关注腾讯混元研究团队在学术会议和技术博客中的更新。
确认合规性: 使用公开成果进行再研发时,需遵循Apache 2.0许可证要求,保留版权声明并注明修改内容。商业用途需关注许可证具体条款限制。
5. 优缺点分析
| 优点 |
|---|
| 范式升级与智能复利: 从agent直接解题转向研发和升级科研工具,让一次研究成果被后续研究反复使用,形成可持续积累的智能复利效应。 |
| 长期研发能力: Overall、Mission、Worker三层架构加持久化队列,支持数天至数周的长周期、多项目并行研究,超越一般AI助手的短会话限制。 |
| 结论可信度高: Review Worker在新上下文中独立复核,要求附代码版本、日志等证据,降低agent自证错误的风险,提升科研结论可靠性。 |
| 经验可沉淀: 项目状态、agent记忆、共享知识库三层分离,Books按观察—已验证—约定分级管理,skill可跨任务复用,构建组织级科研记忆。 |
| 领域覆盖广: 首批成果横跨蛋白质设计、分子模拟、数学证明、量子纠错、机器人本体设计和芯片优化六个高难度领域,验证了通用科研能力。 |
6. 同类工具对比
| 对比维度 | 腾讯混元 Hyra 2.0 | Google DeepMind AlphaEvolve | Sakana AI AI Scientist |
|---|---|---|---|
| 核心定位 | 通用agent研发和升级科学工具与模型,构建可复用研发系统 | Gemini驱动的编码智能体,专注设计先进算法 | 自动化科研流水线,覆盖从创意到论文全流程 |
| 工作对象 | 参数化工具(科学模型)+符号化工具(工作流、验证系统)并重 | 以符号化产出为主:算法代码与优化方案 | 以符号化产出为主:研究论文与实验代码 |
| 领域范围 | 蛋白、分子模拟、数学、量子纠错、机器人、芯片6个领域 | 算法设计与优化(矩阵乘法、数据调度等) | 机器学习算法研究为主 |
| 成果形态 | 可复用资产:新模型、验证系统、证明工作流、skill体系 | 算法方案:如发现的矩阵乘法算法 | 完整论文、实验代码、图表 |
| 研发组织 | 三层Harness:持久化队列、异步协作、Review Worker独立复核、人工审批 | 以进化循环+LLM提议为核心 | 单agent流水线+迭代反馈循环 |
| 知识沉淀 | Books三级可信度知识库+skill跨任务复用 | 系统化知识沉淀机制 | 可复用的论文生成与实验流程 |
| 自我改进闭环 | RSI:升级训练Hy模型的工具链,下一代模型反哺自身 | 无明确自我改进机制 | 有限度自我迭代 |
| 代表成果 | 量子码[488,123,22]编码效率超原榜首约48%;丘成桐猜想证明核验;香山芯片优化 | 4×4复数矩阵乘法仅需48次乘法;为Google数据中心节省0.7%资源 | 自动生成多篇机器学习论文并通过审核 |
选型建议: 对于需要综合性科研基础设施的团队——尤其是希望覆盖多个学科领域、构建可复用科研资产生态、并具备从工具层面自我进化能力的组织——Hyra 2.0的三层架构和持久化队列设计值得深入参考。其RSI自我改进闭环虽然尚未完全对外开放,但设计思路对科研智能化建设具有重要借鉴意义。对于算法优化和代码生成场景,Google DeepMind AlphaEvolve在符号化算法发现方面有充分验证;而需要从零到一搭建科研论文自动化产线的团队,可参考Sakana AI AI Scientist的流水线设计。对于物理、化学、生物领域的基础研究团队,Microsoft AI4Science提供的开源工具库和研究方法沉淀更贴近科研工作者的实际使用场景。
7. 编辑总结
Hyra 2.0代表着AI科研智能体从「解题」向「造工具」的范式跨越,其价值判断贯穿于整个架构设计之中:解出一道题只得到一个答案,而升级一件工具能让所有下游任务受益。这一核心论点使其与市面上绝大多数科研AI工具形成本质区分——它不只是提供更优的答案,而是构建能让后续研究持续获益的工具生态。
从技术创新性看,Hyra 2.0的三层组织架构(Overall、Mission、Worker)借鉴了现代软件工程的组织方式,将其应用于AI长期研究任务的管理。持久化队列、异步协作、独立复核机制、三层记忆分离,这些设计共同构建了一个可运行数周、支持多项目并行的科研AI中台。Review Worker在新上下文中独立接触原始问题与证据的机制,是应对AI科研结论可信度挑战的有效尝试——要求Worker报告附代码版本与日志作为证据,也在工程层面保障了可追溯性。
从实用价值看,Hyra 2.0首批成果横跨六个高难度领域,量子码构造效率提升48%、香山芯片优化等效2至3个月人工迭代,这些成果验证了AI科研智能体在真实科研场景中的有效产出。其将经验沉淀为skill、按可信度分级管理知识库的做法,为AI科研资产的持续积累提供了可行路径——这对于科研团队的长期能力建设具有参考价值。
适用人群方面,Hyra 2.0的设计理念对AI科研基础设施的建设者、大模型研发团队、以及希望构建自动化科研流水线的机构具有较大参考价值。尽管系统本身尚未对外开放,但其公开的成果仓库(Apache 2.0)为科研社区提供了可复用的基础模型与验证工具。未来发展上,其RSI设计方向——工具升级与模型增强彼此驱动——若持续有效,将可能形成AI科研能力的正向飞轮。随着成果逐步公开和可能的开放计划推进,其模式有望被更多科研机构借鉴,推动AI for Science的整体基础设施升级。这也回应了AI科研领域一个长期问题:当前方法仍以「解题」为主,而Hyra 2.0选择了一条更难但更可持续的道路。
8. 常见问题FAQ
Q:Hyra 2.0与普通AI科研助手有什么区别?
A:普通AI科研助手通常以回答问题、提供建议为主,产出是单个答案或方案。Hyra 2.0则将定位从自动解题转向研发工具,能够长期自主训练科学模型、优化研究工作流,并沉淀经验为可复用资产。其核心产出是新模型、验证系统、证明工作流和skill体系,而非一次性答案,形成可持续积累的智能复利。
Q:Hyra 2.0的Review Worker机制是如何保证结论可信度的?
A:Review Worker在全新上下文中先接触原始问题和证据,独立验证执行者的结论,避免执行者的推理过程影响判断。同时,Worker报告完成时必须附上代码版本、实验结果、日志或运行轨迹作为证据。复核发现的错误或更窄的结论范围都会如实保留,不掩盖或修正。
Q:Hyra 2.0目前对外开放吗?外部用户能否使用?
A:目前Hyra 2.0是腾讯混元内部的科研研发系统,并非对外开放的SaaS产品。但成果仓库hyra-results已公开(Apache 2.0许可证),社区可复用其产出的新模型、验证系统等资产。具体的开放计划和时间表需要关注腾讯混元官方发布信息。
Q:Books知识库的可信度分级机制具体如何运作?
A:Books知识库中的每条记录须说明做法、理由、适用条件并附原始证据,按三级可信度管理:「观察」级别表示初步观察结果;「已验证」级别表示经过验证后的结论;「约定」级别表示作为团队共识的约定。当新证据出现时,已有记录可被修正或升级。
Q:Hyra 2.0的长期自主研究能力是如何实现的?
A:通过三层组织架构与持久化调度实现:Overall对接人类并管理优先级与资源,Mission长期负责一个研究问题并对结论负责,Worker执行探索与实验。任务进入持久化队列后按优先级、依赖关系和资源上限调度,某个任务等待训练结果或人工审批时其他任务照常推进,agent可设置唤醒时间在检查节点接续工作。
Q:Hyra 2.0已产出哪些代表性成果?
A:代表性成果包括:量子码[488,123,22]编码效率超原榜首约48%;丘成桐猜想相关证明核验;香山芯片优化等效官方2至3个月迭代;HyInv逆折叠模型实现50毫秒内完成128条蛋白质序列设计;以及分子模拟力场HyFF等新模型。
9. 项目地址
相关推荐
SenseNova 6.8 Flash评测:商汤日日新多模态智能体模型的主动办公与全形态设计实践
SenseNova 6.8 Flash是商汤科技日日新大模型体系推出的旗舰级多模态智能体模型,核心定位聚焦于主动办公智能化与全形态设计生成两大方向。该模型依托显式长期记忆机制,能够跨会话沉淀客户背景、合作进度与偏好信息,并在外部条件发生变化时主动向用户预警并生成调整建议,从而实现从“事后补救”到“提前跟进”的工作范式转变。在设计生成领域,SenseNova 6.8 Flash覆盖动态PPT、动态海...
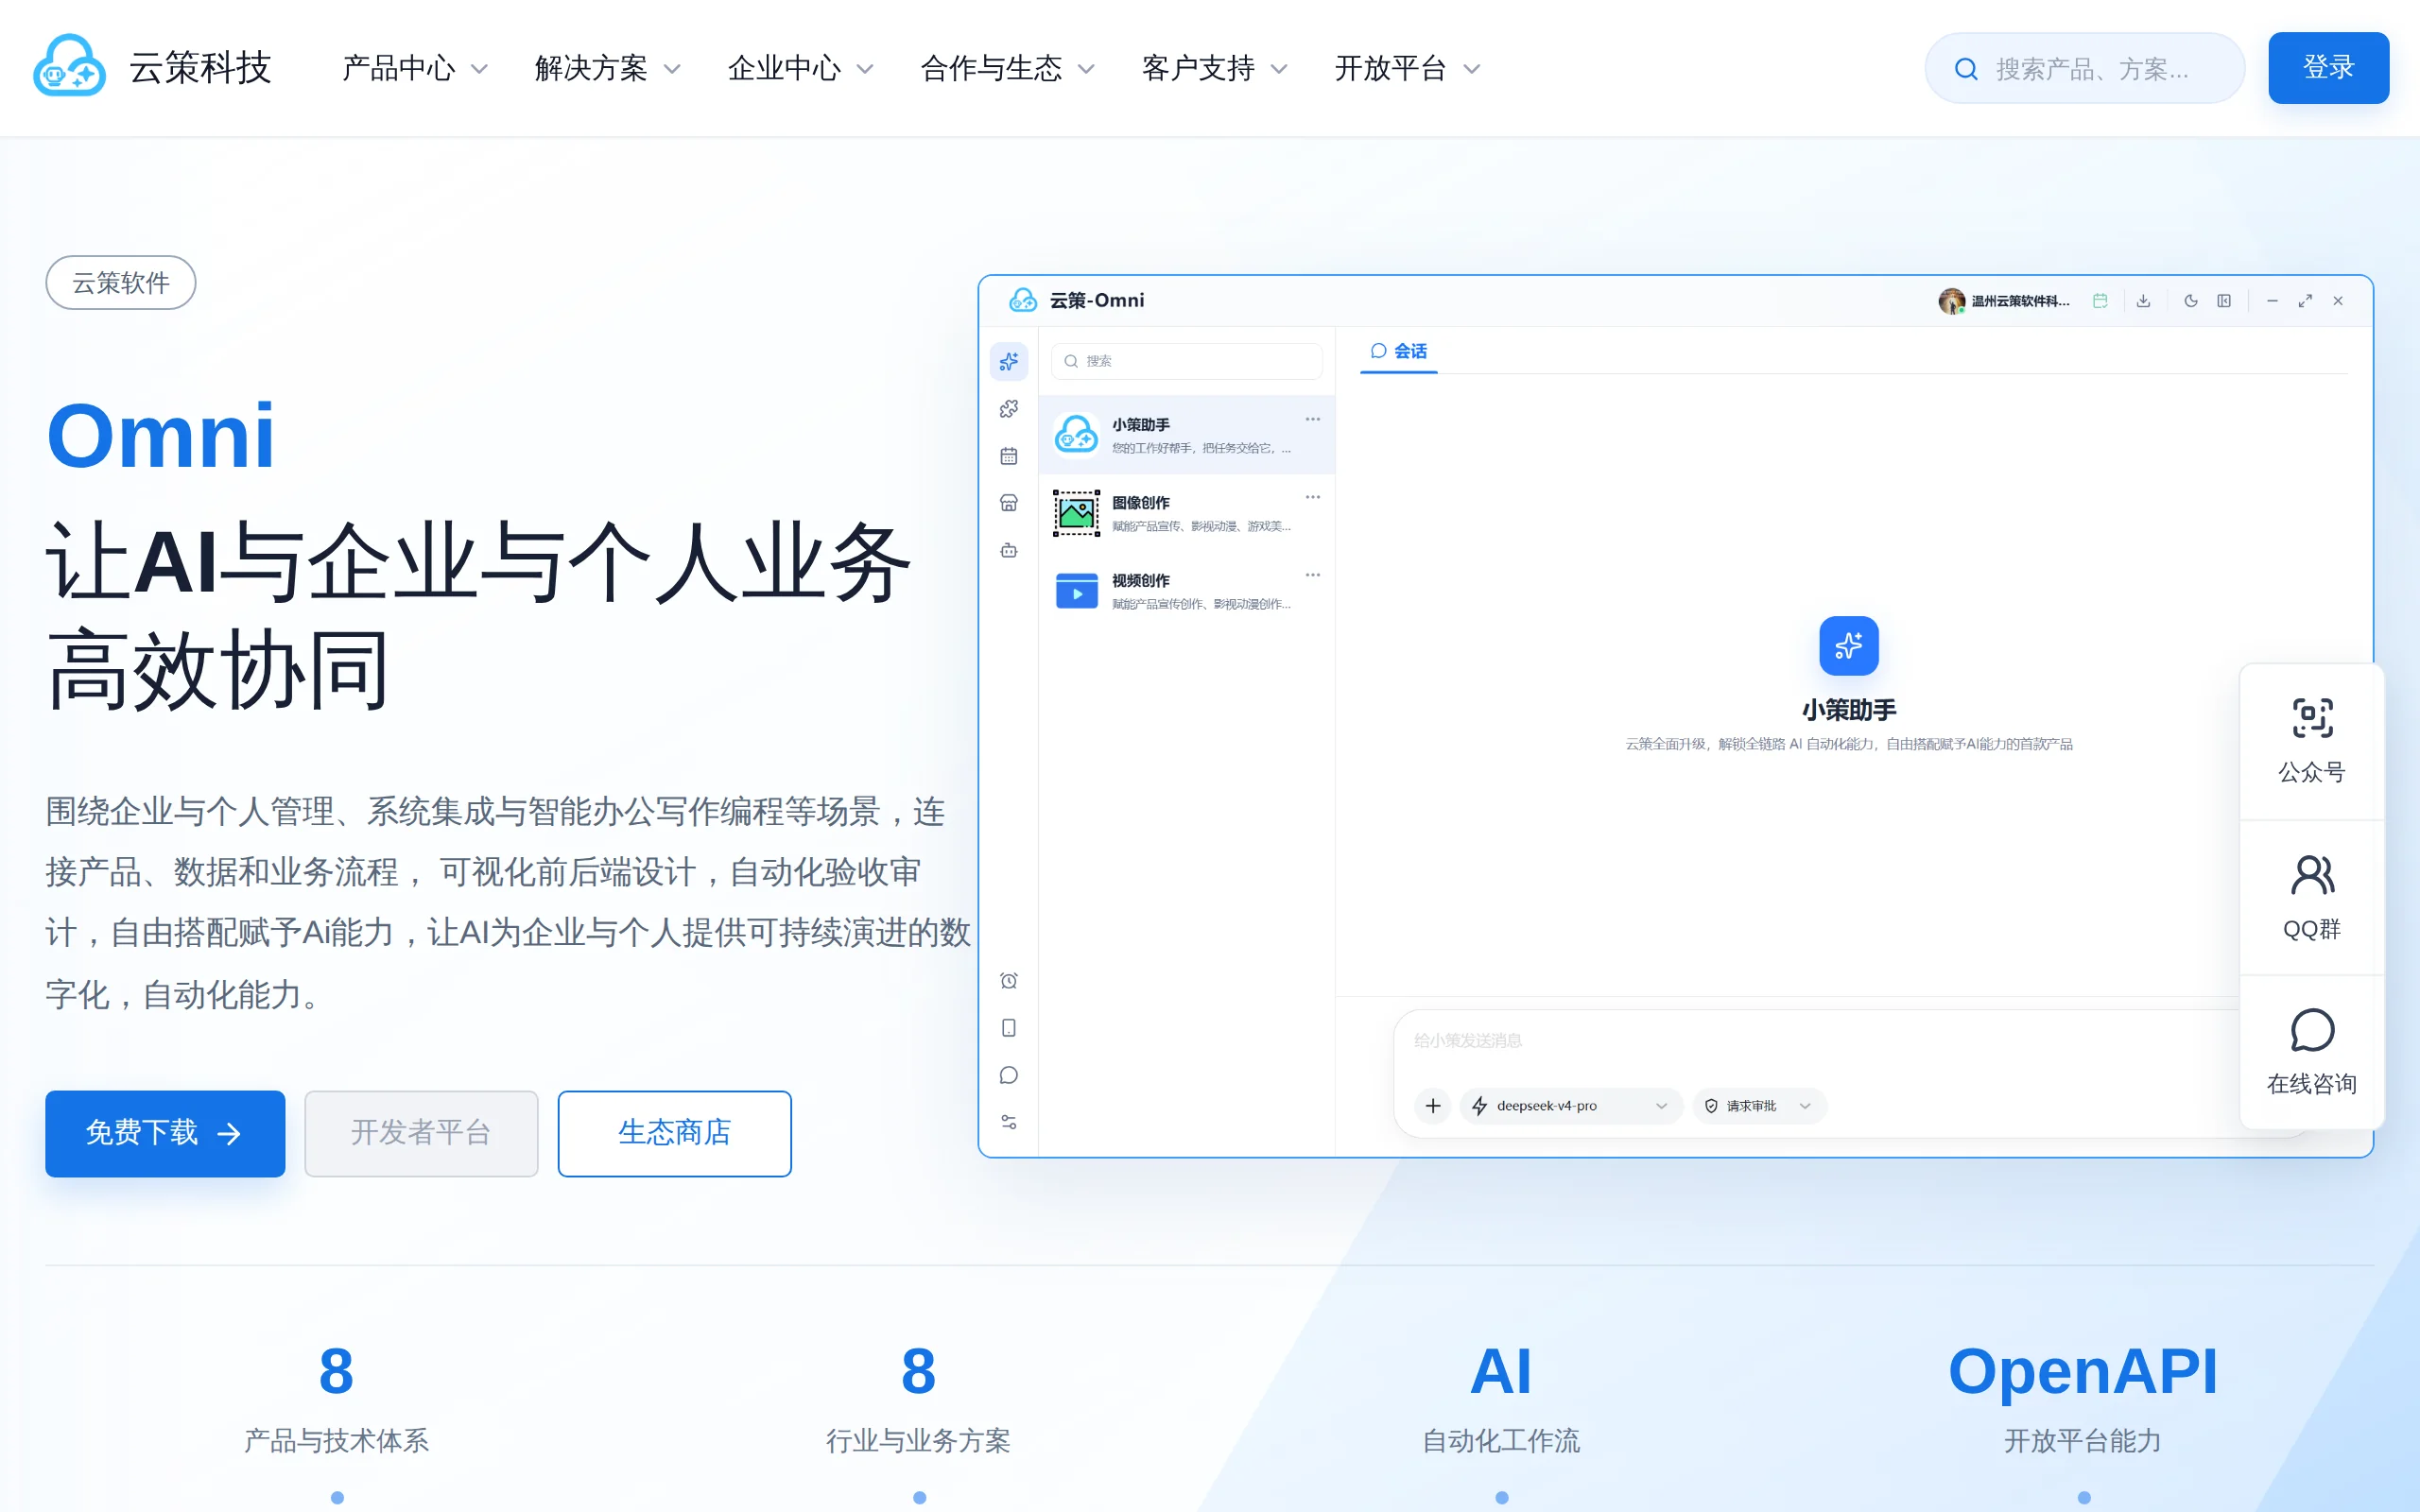
云策Omni – 本地 AI 工作平台,可自定义赋予 AI 能力
云策Omni是跨平台桌面本地AI工作平台,也是首款主打"可自定义赋予AI能力"的互联网产品。该平台通过"模型+技能+插件+虚拟运行环境"的松耦合架构,让AI在用户授权范围内完成项目开发、图像与视频创作、数据操作、远程管理与自动化验收等实际任务。与传统的单点AI工具不同,云策Omni将模型接入、任务理解、确定性执行与安全隔离整合为统一工作空间,强调AI能力的按需装配和权限受控。
DeepSeek Super-agent 深度评测:从被动对话到持续在线协作者的架构跃迁
Super-agent 是由 DeepSeek Harness 团队推出的持续在线 Agent 系统架构。该架构通过双层设计、事件驱动机制、异步多信道交互、存算分离以及 Watchdog 异常自愈能力,实现了连续、高效、主动、持久四个核心特征:跨 IM/GitHub 无缝推进同一任务、并行处理多项工作、主动观察环境事件并自主推进、异常自动恢复。配套开源 MIT 原型 dsh-superagent-...
LongCat-2.5 – 美团 LongCat 推出的原生多模态模型深度评测
LongCat-2.5是美团LongCat团队推出的原生多模态模型,总参数达1.6万亿,每token激活约480亿参数。该模型面向长程智能体任务设计,将视觉信号离散化为多层级token与文本统一处理,显著强化了Visual Coding能力。依托大规模Agentic强化学习、数据合成流水线以及国产算力上的长上下文训练与W4A4量化优化,LongCat-2.5在终端编程、浏览检索、视觉理解等多项评测...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。