
KAT-Coder-Pro V2.5 – 快手推出的 Agentic Coding 模型

导读摘要:
KAT-Coder-Pro V2.5是快手KwaiKAT推出的旗舰级Agentic Coding模型,专注于长程工程能力与通用Agentic能力。通过自研AutoBuilder将真实仓库环境构建成功率从16.5%提升至57.2%,沉淀超10万个可运行仓库;并建设KwaiClawEnv通用Agentic训练体系,结合多框架强化学习与MOPD多专家融合技术。模型在SWE-Bench Pro取得65.2...
1. KAT-Coder-Pro V2.5是什么
KAT-Coder-Pro V2.5是快手KwaiKAT推出的旗舰级Agentic Coding模型,专注于长程工程能力与通用Agentic能力。通过自研AutoBuilder将真实仓库环境构建成功率从16.5%提升至57.2%,沉淀超10万个可运行仓库;并建设KwaiClawEnv通用Agentic训练体系,结合多框架强化学习与MOPD多专家融合技术。模型在SWE-Bench Pro取得65.2分,PinchBench达94.2分,现已全量上线StreamLake平台。该模型定位为企业级全栈编码智能体,旨在实现从模糊issue到测试通过的全自动化工程闭环,弥补现有模型在真实仓库环境构建和长程任务稳定性上的不足。
技术定位与领域: KAT-Coder-Pro V2.5属于Agentic Coding模型领域,聚焦于自动化软件工程(ASE),特别是长程代码仓库级任务。与普通代码补全模型不同,它能够理解自然语言问题描述,在跨文件代码库中定位、修改并验证代码,实现端到端交付,属于当前AI编码领域的前沿方向。
研发背景: 由快手KwaiKAT团队开发,依托快手在短视频和AI领域的技术积累。研发动机源于当前编码模型在真实仓库环境构建成功率低(不足20%)、缺乏通用Agentic训练体系以及多框架适配困难等痛点,旨在打造一个能应对复杂工程任务的智能编码助手,推动Agentic Coding从实验室走向工业级应用。
核心价值: 解决了现有模型在真实仓库环境构建成功率低、长程任务稳定性差、跨框架适配困难等核心问题。通过AutoBuilder环境构建和数据飞轮策略,将环境构建成功率提升至57.2%,并沉淀超10万个可运行仓库用于训练。同时,多框架强化学习使模型具备框架无关性,能够在不同Agent协议下稳定工作,大幅降低企业接入成本。
技术特点: 核心技术包括自研AutoBuilder自动化环境构建流水线、KwaiClawEnv三层训练体系、非对称PPO与分层奖励机制,以及MOPD多专家融合技术,确保在新增长程工程与Agentic能力时,前端美学等既有能力不被牺牲。模型在多项基准测试中表现领先,尤其在PinchBench(94.2分)和SWE-Bench Pro(65.2分)上展现了强大的工程能力,同时支持终端命令执行与前端页面生成,实现多模态能力融合。
2. 主要功能
长程仓库工程: 模型能够理解自然语言issue,在跨文件代码库中定位问题根源、修改多处代码并跑通测试验证,实现从问题描述到代码交付的端到端闭环。这一能力基于AutoBuilder构建的真实仓库环境训练,确保模型在复杂工程场景中的可靠性。
通用Agentic工作流: 支持数据分析、跨系统整合、批量文档处理与报告生成等复杂多轮任务,平均可支撑10轮以上的工具交互。模型通过KwaiClawEnv通用训练体系,学会了在动态工具池中自主调度和组合工具,完成高度定制化的任务流程。
终端与前端能力: 模型不仅擅长后端代码修改,还能直接执行终端命令(如编译、测试、部署),并具备前端页面美学生成能力。用户无需在多个模型间切换即可完成全栈开发任务,显著提升开发效率。
多框架适配: 兼容多种Agent交互协议(如mini-swe-agent、Claude Code、Codex、OpenClaw),具备跨工具、跨平台的通用问题解决能力。这一特性源于多框架强化学习训练,使模型不依赖特定交互框架,具备强泛化与迁移能力。
自动化环境构建(AutoBuilder): 自研自动化流水线让模型扮演“环境搭建工程师”,分析仓库结构、生成配置脚本、在隔离沙箱中验证测试执行,将真实仓库环境构建成功率从16.5%提升至57.2%。累计沉淀覆盖12种编程语言的超10万个可运行、可验证环境,为训练和推理提供高质量数据基础。
数据飞轮与失败轨迹利用: 通过全流程行为过滤识别“差一步成功”的高价值失败轨迹,配合针对性提示重新执行,将约20%的失败尝试转化为完整、可复现、可验证的训练数据。这一机制让模型学会纠错与回拉,显著提升任务完成率。
非对称PPO与分层奖励: 采用非对称PPO架构,执行时模型仅见真实环境信息,避免训练时的信息泄露。设计三层奖励机制——核心任务分数、标准行为约束、失败轨迹激励,鼓励探索同时纠正不规范行为,使训练过程更加稳定高效。
MOPD多专家融合: 通过多专家融合技术,确保在新增长程工程与Agentic能力时,前端美学等既有能力不被牺牲。模型在扩展过程中实现能力无损增长,避免了传统微调中的灾难性遗忘问题。
3. 如何使用
环境要求与前置条件: 使用KAT-Coder-Pro V2.5需要访问StreamLake平台,无需本地部署模型。用户需注册StreamLake账号并具备有效的API KEY。硬件方面,用户端仅需稳定的网络连接,推理计算由快手云端集群完成,推荐使用支持HTTPS请求的开发环境。
申请API权限: 访问StreamLake平台KAT-Coder产品页((链接待官方发布后更新) KEY申请。申请通过后,平台会提供唯一的认证密钥,用于后续接口调用。建议企业用户提前申请以获取更高并发配额。
查阅接入文档: 阅读官方开发工具接入指南,了解接口规范、认证方式、请求格式与返回数据模型。文档详细说明了REST API的端点、参数说明、错误码及限流策略,开发者需仔细阅读以避免调用错误。
集成开发环境: 将API接入VS Code、JetBrains等IDE插件,或直接集成到自有CI/CD流水线中。快手提供了官方SDK(支持Python、Java、Go等语言),简化集成过程。推荐在IDE中通过插件形式使用,以便在编码过程中直接触发模型能力。
提交工程任务: 以自然语言描述issue或工作流需求,触发模型自动在仓库中分析、修改与验证。任务描述应尽量清晰、包含具体上下文(如仓库路径、问题复现步骤、期望输出),以获得更精准的结果。模型支持单轮任务和多轮对话式任务。
验收与迭代: 审核模型生成的补丁、测试报告与交付物,根据反馈优化任务描述以获得更精准结果。平台提供任务历史记录和结果对比功能,方便团队协作审核。建议在重要任务中先在小范围验证,再批量应用。
最佳实践: 对于复杂跨文件修改,建议分步骤描述任务,先让模型定位问题,再逐步指导修改。对于数据分析类任务,提供数据源连接信息和输出格式要求可大幅提升结果质量。注意:模型当前主要针对英文仓库优化,中文issue描述虽支持但建议配合英文关键词使用。
4. 优缺点分析
| 优点 |
|---|
| 端到端工程闭环: 模型不仅生成代码片段,更能完成从模糊issue到测试通过的完整长程任务,涵盖定位、修改、验证全流程,大幅减少人工介入。 |
| 真实环境训练: AutoBuilder将仓库环境构建成功率提升至57.2%,模型在10万+真实仓库中实战训练,泛化能力和工程实用性远高于仅在合成数据上训练的模型。 |
| 框架无关性: 通过多框架RL训练,模型不依赖特定Agent交互协议,可无缝接入现有工具链(如VS Code、JetBrains、CI/CD流水线),降低迁移成本。 |
| 能力无损扩展: MOPD融合机制确保新增长程工程与Agentic能力时,前端美学等既有能力不被牺牲,实现能力叠加而非替换,适合需要多面手能力的团队。 |
| 高基准分数: 在SWE-Bench Pro(65.2分)和PinchBench(94.2分)等权威评测中取得领先成绩,尤其在复杂多轮交互任务上表现稳定,验证了其工程可靠性。 |
5. 同类工具对比
| 维度 | KAT-Coder-Pro V2.5 | Claude Opus 4.8 | Devin (Cognition AI) |
|---|---|---|---|
| 核心定位 | 快手KwaiKAT旗舰Agentic Coding模型,聚焦端到端工程闭环 | Anthropic通用大模型旗舰版本,编码能力为多模态通用能力组成 | 自主AI软件工程师,专注于独立完成软件开发任务 |
| SWE-Bench Pro | 65.2分 | 69.2分 | 未公开具体分数(早期版本约13.86%) |
| PinchBench | 94.2分 | 93.5分 | 未公开 |
| 环境构建能力 | 自研AutoBuilder,成功率57.2%,沉淀10万+真实仓库 | 未公开自动化环境构建体系,依赖用户本地环境 | 内置沙箱环境,但构建成功率未公开 |
| 框架兼容性 | 多框架RL训练,兼容mini-swe-agent、Claude Code、Codex、OpenClaw等 | 仅支持Anthropic自有API和标准工具调用 | 自研Agent框架,封闭生态 |
| 部署方式 | 云端API(StreamLake平台),不支持本地部署 | 云端API,支持部分区域私有化 | 云端SaaS平台 |
| 开源协议 | 闭源商业产品(API服务) | 闭源商业产品 | 闭源商业产品 |
| 多模态能力 | 支持终端命令、前端页面生成,但主要聚焦代码 | 原生多模态(文本、图像、代码) | 聚焦代码和命令行 |
选型建议: 对于追求端到端工程自动化且希望快速集成到现有CI/CD流程的企业,KAT-Coder-Pro V2.5是最佳选择,其真实环境训练和框架无关性可显著降低部署成本。如果团队更看重通用多模态能力(如同时需要图像理解和代码生成),Claude Opus 4.8是更均衡的方案,但在专门的长程仓库工程任务上,KAT-Coder-Pro的长程稳定性更具优势。
对于希望自主控制数据安全和定制化开发的研究团队,SWE-Agent的开源特性提供了灵活的基座,但需要自行构建环境并训练模型,工程成本较高。Devin作为全自主AI工程师概念的先驱,但在环境构建和基准分数上尚未公开详细数据,且封闭生态限制了定制能力。总体而言,KAT-Coder-Pro在工程落地和实际效果之间取得了较好的平衡,尤其适合需要高成功率仓库构建和复杂工作流稳定的企业场景。
6. 编辑点评
KAT-Coder-Pro V2.5在技术创新性上展现了扎实的工程化思维。AutoBuilder将真实仓库环境构建成功率从16.5%提升至57.2%,这一突破直接解决了Agentic Coding领域长期存在的“训练与部署环境脱节”问题,使得模型能够在接近真实的条件下学习和推理。数据飞轮与失败轨迹利用机制更是一大亮点,将约20%的失败尝试转化为有效训练数据,不仅提升了数据利用率,还让模型学会了纠错能力,这在其他编码模型中较为罕见。
从实用价值来看,该模型真正实现了从issue到交付的端到端闭环,在SWE-Bench Pro和PinchBench上的高分验证了其在长程任务和复杂工作流中的稳定性。特别是框架无关性设计,让企业无需改变现有工具链即可接入,降低了采用门槛。不过,目前模型仅通过StreamLake平台提供API服务,对于数据敏感型企业和离线开发场景存在一定限制,未来若能推出私有化部署版本,将进一步提升市场竞争力。
适用人群方面,KAT-Coder-Pro V2.5最适合中大型企业的开发团队,尤其是那些需要频繁处理跨文件代码修改、自动化Bug修复和复杂数据分析任务的团队。对于独立开发者和小型团队,API的按量计费模式也提供了灵活的选择,但需要权衡成本与收益。
未来发展潜力值得期待。随着AutoBuilder持续积累更多真实仓库环境,以及多框架强化学习的进一步优化,模型在长程工程能力上还有提升空间。同时,中文支持和上下文窗口的扩展将是其打开更大市场的关键。总体而言,KAT-Coder-Pro V2.5代表了当前Agentic Coding模型在工程化方向上的重要进展,推荐指数为四星半(4.5/5星),扣分项主要在于闭源部署限制和文档完善度。
7. 应用场景
自动化Bug修复: 接收GitHub issue后,模型自动在大型代码仓库中定位根因、生成补丁并跑通回归测试。团队可将模型接入CI/CD流水线,当新issue创建时自动触发修复流程,经人工审核后合并,大幅减少Bug修复周期。
数据分析报告生成: 读取多平台原始数据(如数据库、CSV文件、API接口),自动进行数据清洗、统计分析并生成含图表的Markdown业务简报。模型支持多轮交互,用户可逐步调整分析维度,最终输出可直接用于汇报的文档。
跨系统数据整合: 调用多个内部API与数据库,自动完成数据抽取、转换、加载(ETL)与异常处理。模型能编写并执行Python脚本或SQL查询,将分散在不同系统的数据整合为统一格式,适用于数据仓库建设与报表自动化。
批量文档处理: 对大量技术文档或合同进行批量摘要、格式转换、关键信息提取与结构化归档。模型支持长文本理解和多轮处理,通过自然语言描述处理规则,即可实现对文档库的自动化管理,适合知识管理场景。
前端原型快速生成: 根据产品需求描述,自动生成符合设计规范的HTML/CSS页面并支持迭代调优。模型能理解组件化设计思想,生成响应式布局代码,同时保持视觉美观,适合快速验证产品概念或搭建内部工具界面。
8. 常见问题FAQ
Q:KAT-Coder-Pro V2.5是否免费使用?
A:该模型通过StreamLake平台以API服务形式提供,具体定价模式请参考平台官方报价。通常提供免费试用额度,但大规模商用需要按调用量付费。建议企业用户联系销售获取定制方案。
Q:模型支持哪些编程语言?
A:AutoBuilder已沉淀覆盖12种编程语言的仓库环境,包括Python、JavaScript、TypeScript、Java、Go、C++、Rust等主流语言。模型在Python和JavaScript生态中表现最佳,其他语言的支持持续优化中。
Q:如何保证代码修改的安全性?
A:模型生成的补丁和代码修改均需人工审核后方可合并。平台提供详细的修改对比视图和测试执行报告,帮助开发者快速评估改动影响。此外,分层奖励机制中的标准行为约束也减少了生成不安全代码的概率。
Q:与Claude Opus 4.8相比,KAT-Coder-Pro有哪些独特优势?
A:KAT-Coder-Pro专注于长程仓库工程和Agentic工作流,在真实环境构建和框架无关性上具有明显优势。Claude Opus 4.8在通用多模态能力和部分基准(如SWE-Bench Pro)上略高,但缺乏专门的工程闭环设计。选择取决于具体需求:若以代码工程为核心,KAT-Coder-Pro更合适;若需要多模态通用能力,Claude Opus 4.8更均衡。
Q:模型是否支持私有化部署?
A:目前仅提供StreamLake云端API服务,不支持本地私有化部署。对于有数据安全或离线需求的企业,建议关注快手后续可能推出的私有化方案,或通过平台的数据隔离功能满足合规要求。
Q:如何提升模型在中文任务上的表现?
A:模型主要针对英文优化,中文issue描述虽支持但效果略逊。建议在中文任务中混合使用英文关键词(如技术术语、函数名),并尽量提供清晰的上下文和示例。快手团队表示正在加强中文支持,未来版本将有所改善。
Q:调用API时有哪些限流策略?
A:平台根据用户等级设置不同的请求速率限制(如每分钟请求数、每日总请求数)。超出限制会返回429状态码。企业用户可申请提高配额,建议在任务提交时合理控制并发数,避免触发限流。
9. 项目地址
- 产品官网(StreamLake平台): https://streamlake.com/product/kat-coder
- arXiv技术论文: https://arxiv.org/pdf/2607.05471
相关推荐
Agents-A1 – 上海 AI Lab开源的混合专家智能体模型
Agents-A1是由上海人工智能实验室(上海AI Lab)开源的35B参数混合专家(MoE)智能体模型,专为复杂科研长程任务设计。该模型通过知识-行动图谱(KAG)构建可验证长轨迹基础设施,并采用三阶段多专家蒸馏训练,突破了大模型依赖海量参数实现复杂推理的局限。在长程搜索、科学推理、指令遵循等基准上,Agents-A1以35B参数实现了比肩甚至超越万亿参数模型的性能。
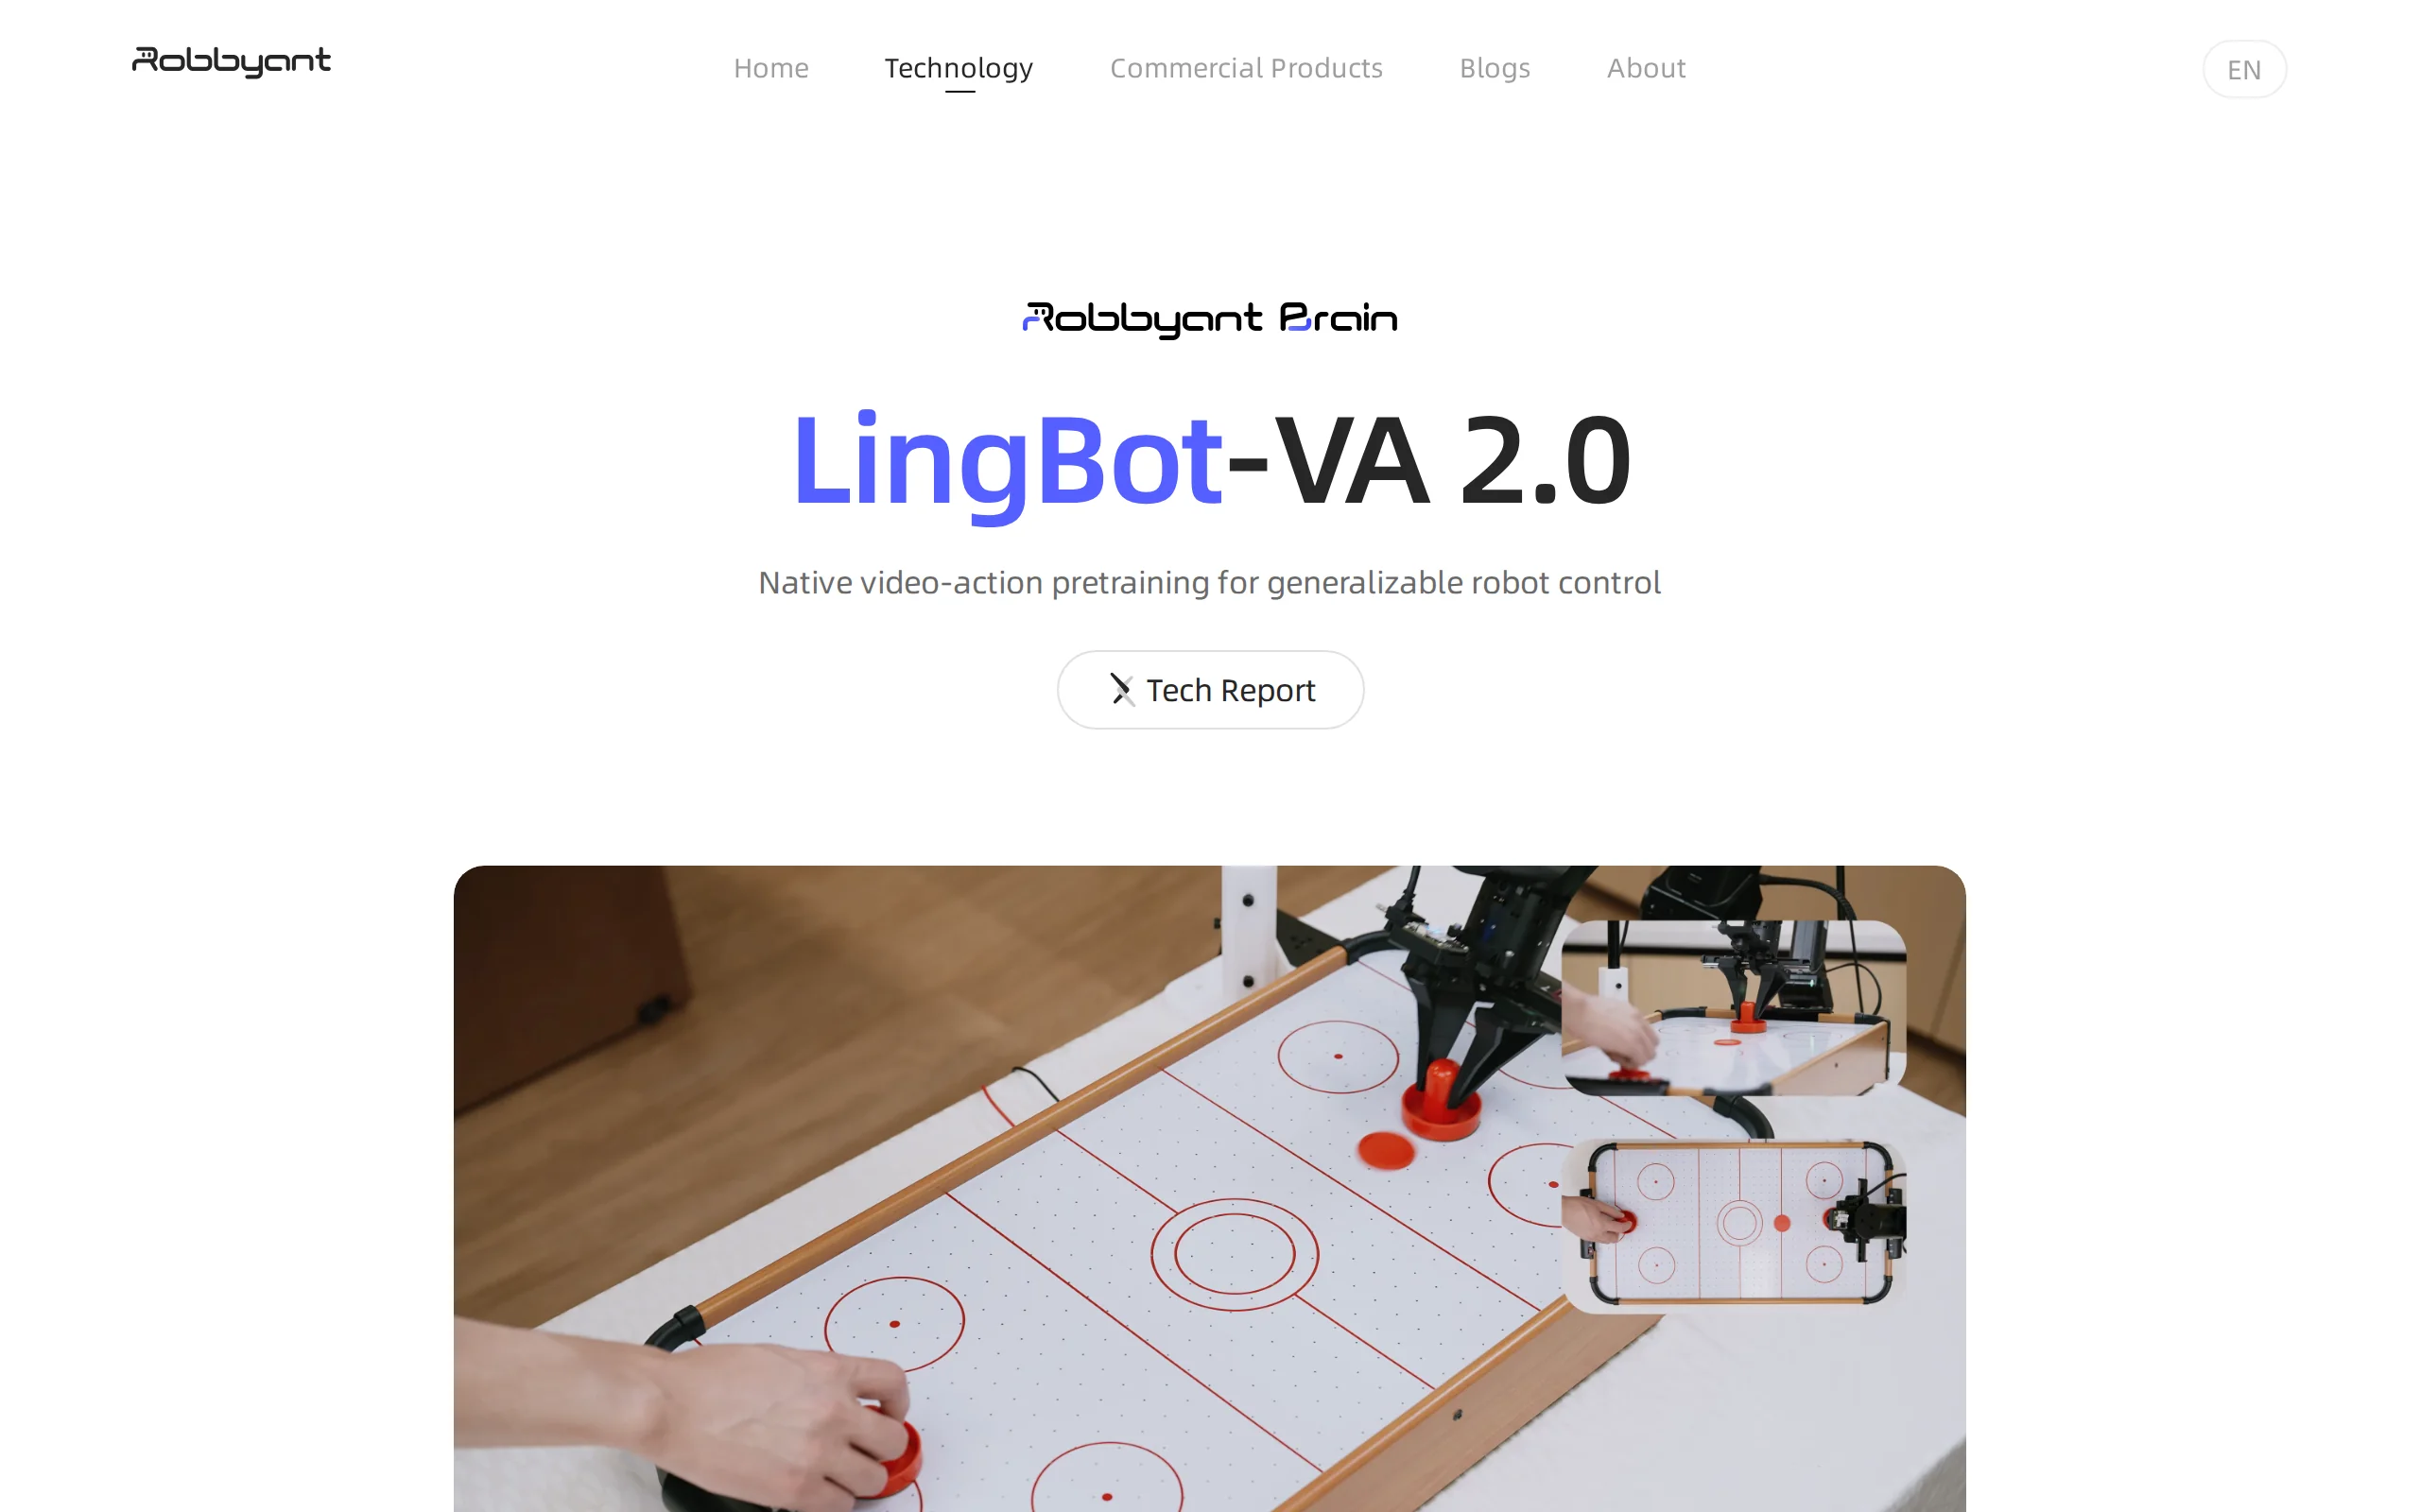
LingBot-VA 2.0 – 蚂蚁灵波推出的具身原生世界动作模型
LingBot-VA 2.0是蚂蚁灵波推出的行业首个具身原生世界动作模型,基于自回归架构从零预训练,使机器人具备“边推演、边行动”的通用控制能力。模型采用因果DiT与稀疏MoE架构,总参数15.3B但推理仅激活2.5B,在RoboTwin 2.0基准上实现93.6%的双臂任务成功率,单GPU推理速度达到150Hz,异步模式下可达225Hz。该模型从架构设计、数据采集到训练目标均为物理世界量身定制,...
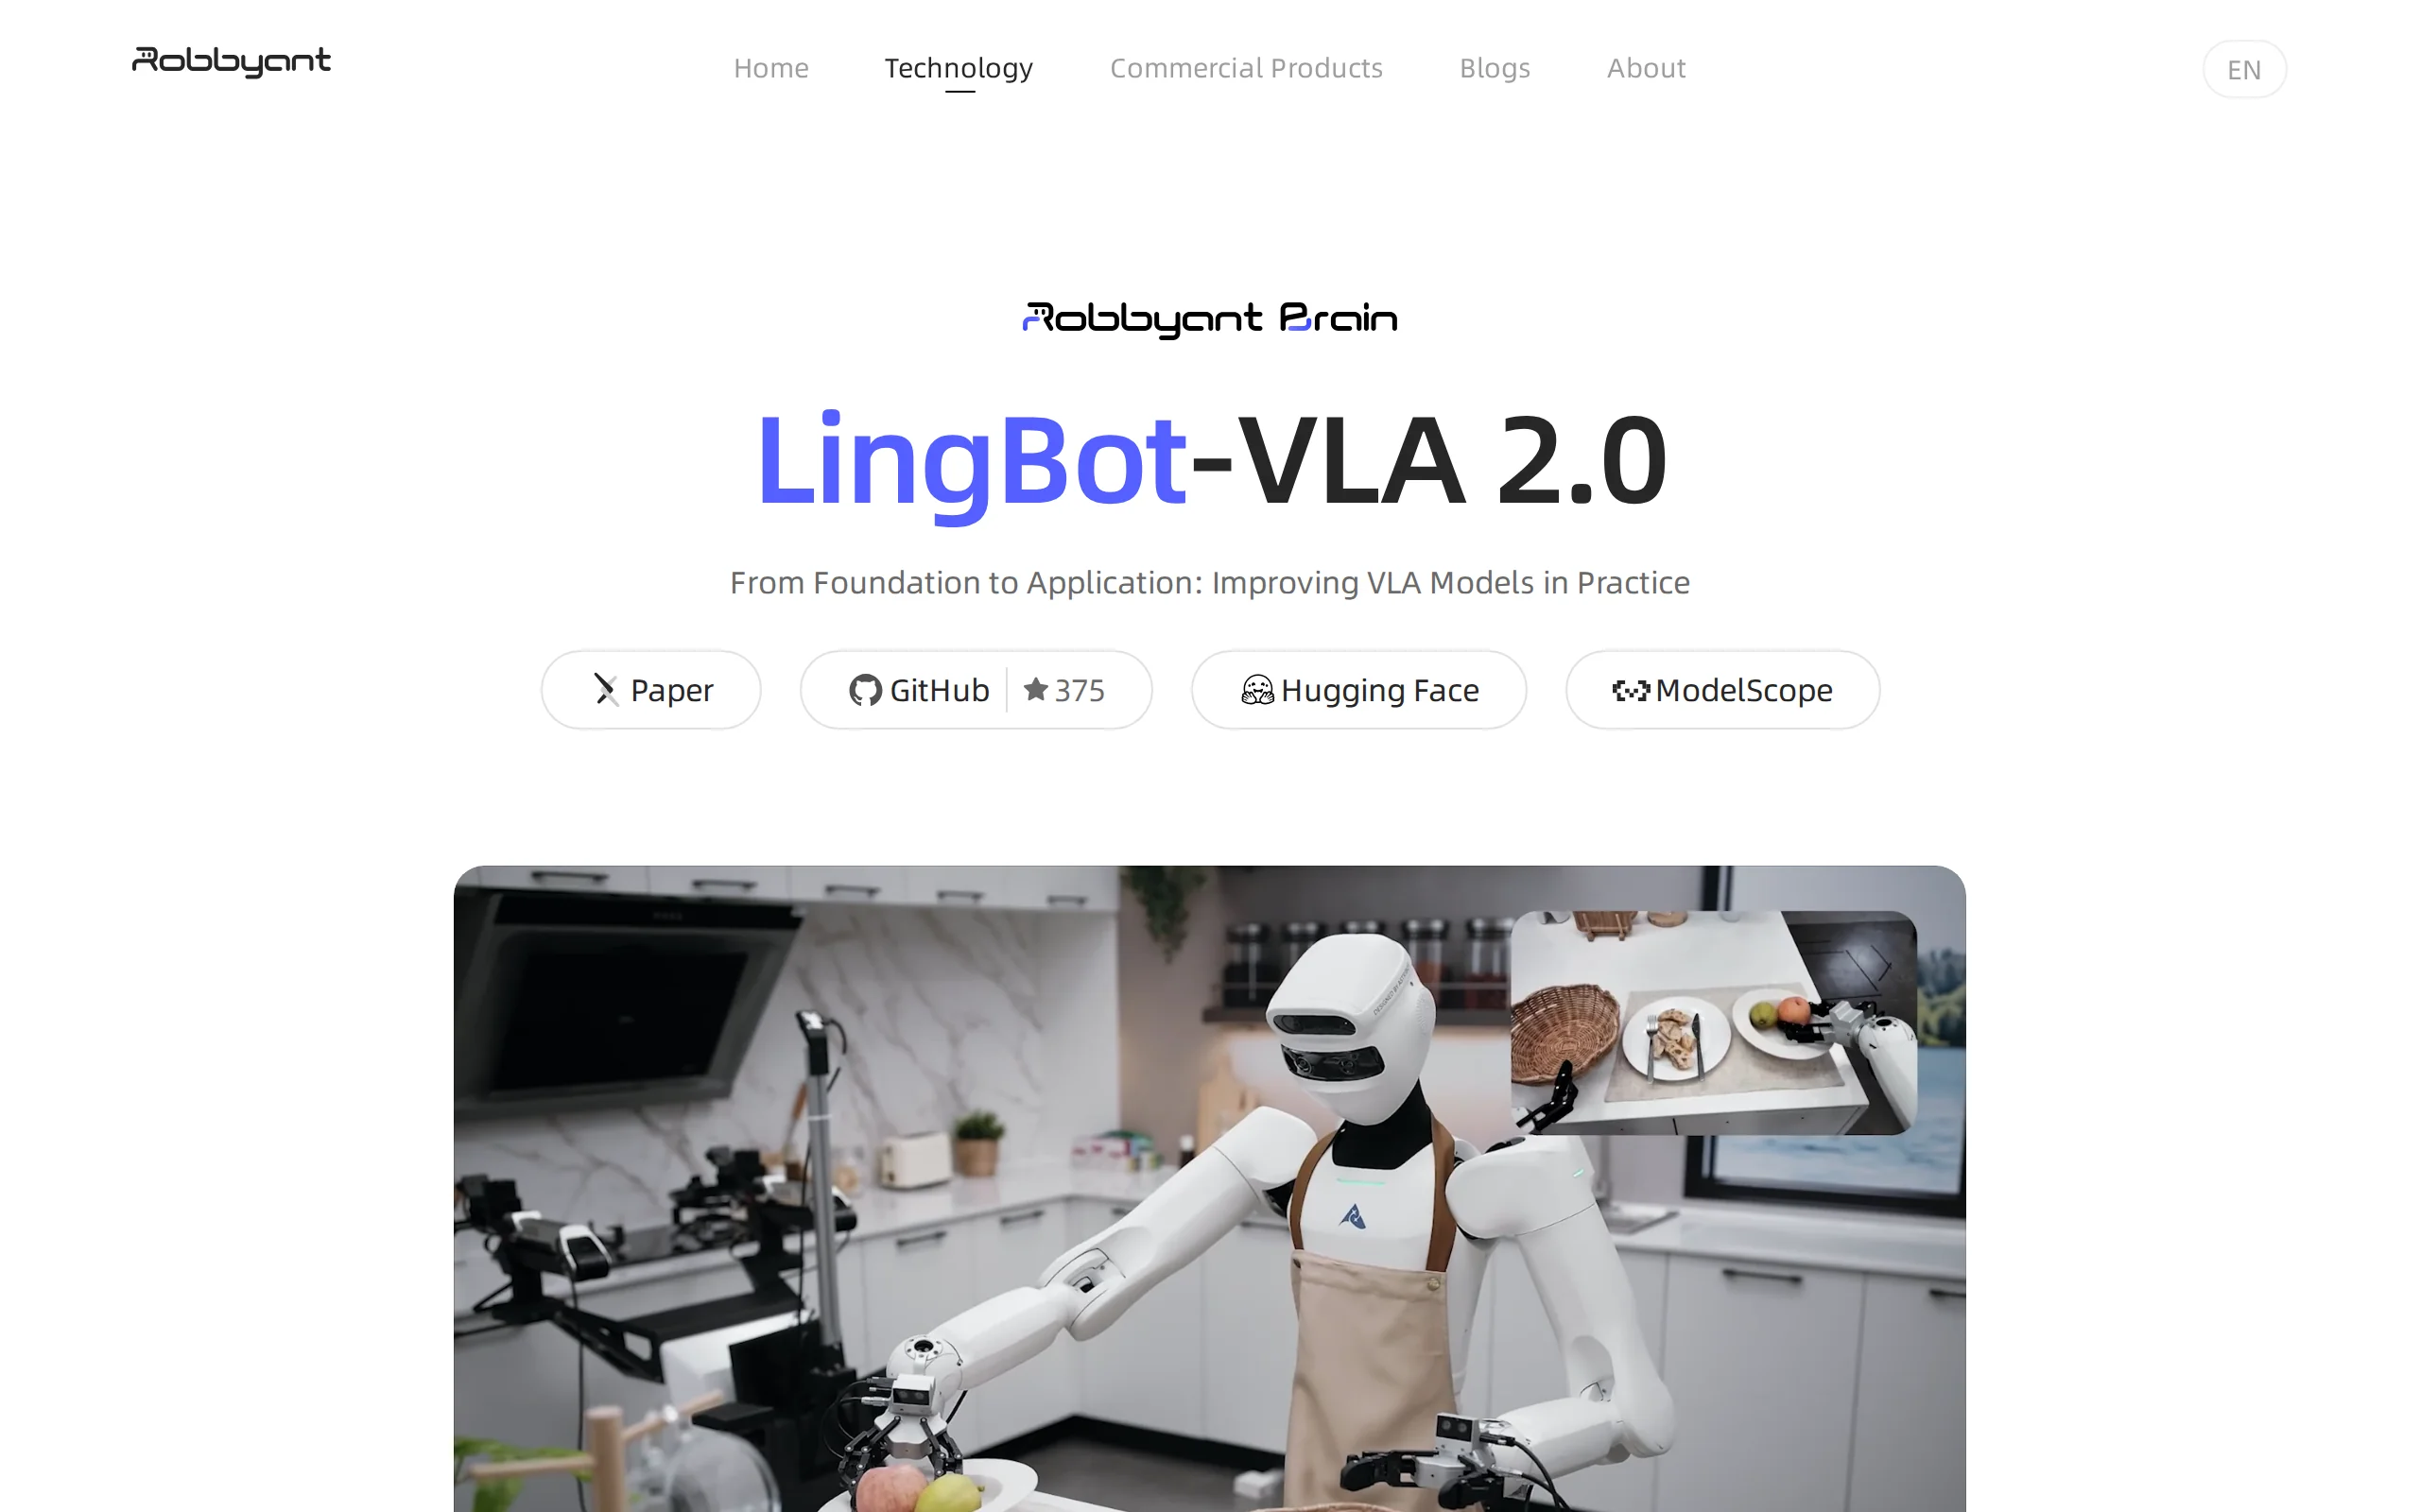
LingBot-VLA 2.0 – 蚂蚁灵波开源的一代具身智能基座模型
LingBot-VLA 2.0是蚂蚁灵波科技(Robbyant)开源的新一代具身智能基座模型,基于6万小时大规模预训练数据(含5万小时真机操作和1万小时人类操作视频),覆盖17个品牌20种机器人构型,支持单臂/双臂、双足/轮式及头部、腰部、底盘等多自由度控制。模型采用稀疏MoE架构(1.6B总参数,0.6B激活参数)与统一动作空间表示,在GM-100双臂评测和长程移动操作任务中均超越π0.5与GR...
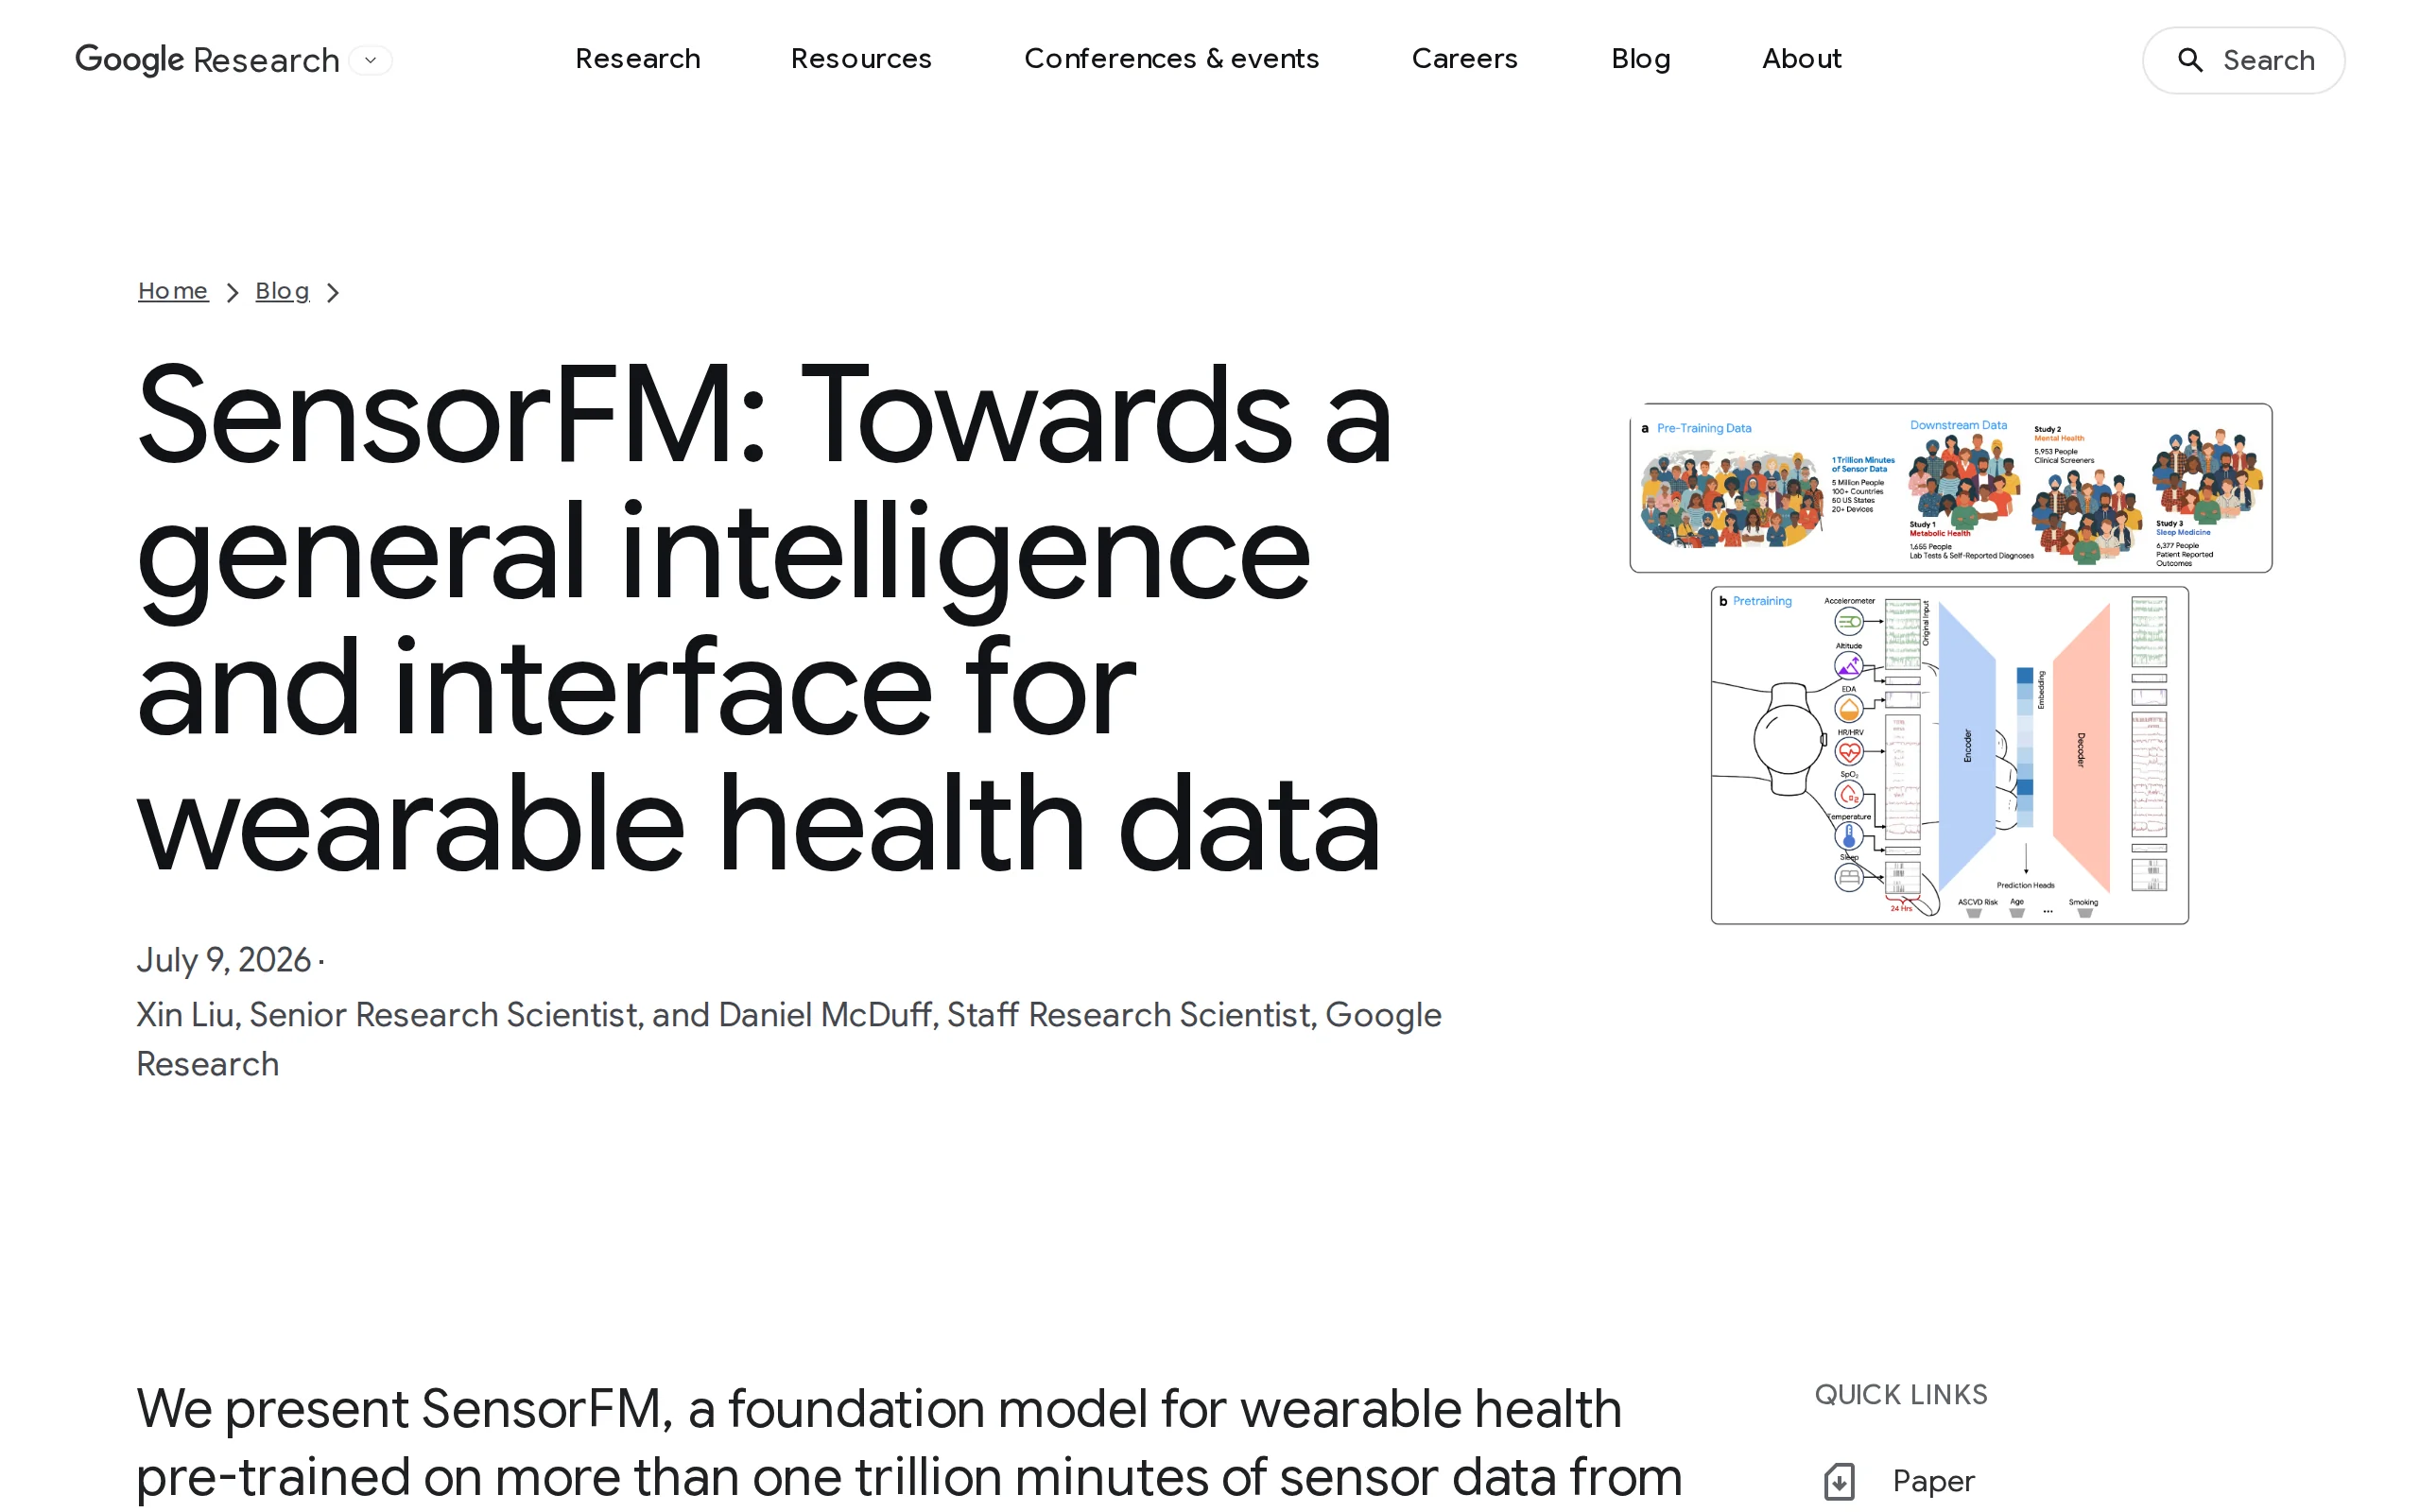
SensorFM – 谷歌推出面向可穿戴健康数据的通用基础模型
SensorFM是Google Research推出的大型传感器基础模型,专门面向可穿戴健康数据。该模型基于500万参与者、超过1万亿分钟的无标签多模态传感器数据进行预训练,学习通用的生理表征,能够迁移至心血管、代谢、睡眠、心理健康等六大类共35个健康预测任务。它具备缺失数据填充和标签高效适应能力,可作为个人健康代理的底层基础工具,提升健康回答的上下文感知和安全性。
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。