
Krea 2 – Krea AI 推出首个从零训练的基础图像生成模型

导读摘要:
Krea 2 是 Krea AI 推出的首个从零训练的基础图像生成模型,定位为“美学优先”的创意协作者,而非传统的提示词精确翻译器。该模型基于全新的自研架构,从数据筛选、训练策略到推理管线均围绕视觉美学一致性、风格迁移和创意控制进行设计。Krea 2 开源了两个版本:RAW(未蒸馏基础模型,可塑性极强,适合训练 LoRA)和 Turbo(8 步蒸馏模型,约 2 秒出图,支持 1K~2K 分辨率)。...
1. Krea 2是什么
Krea 2 是 Krea AI 推出的首个从零训练的基础图像生成模型,定位为“美学优先”的创意协作者,而非传统的提示词精确翻译器。该模型基于全新的自研架构,从数据筛选、训练策略到推理管线均围绕视觉美学一致性、风格迁移和创意控制进行设计。Krea 2 开源了两个版本:RAW(未蒸馏基础模型,可塑性极强,适合训练 LoRA)和 Turbo(8 步蒸馏模型,约 2 秒出图,支持 1K~2K 分辨率)。在 Artificial Analysis 评测中,Krea 2 位列独立实验室文生图模型第一,其输出具有编辑级视觉品质,显著降低了“AI 味”。
技术定位与领域: 属于计算机视觉与生成式 AI 交叉领域,专注于图像生成、风格迁移和创意控制。与传统文生图模型强调提示词精确遵循不同,Krea 2 更注重模型对美学构图、色彩和谐与视觉情感的自主理解,适合需要艺术风格一致性的专业创作场景。
研发背景: Krea AI 团队在图像生成领域有深厚积累,此前以 Krea 实时编辑平台闻名。Krea 2 并非基于现有开源模型(如 Stable Diffusion)微调,而是从零训练的基础模型,体现了团队在数据构建、模型架构和训练方法论上的独立创新。研发动机源于对“技术正确但视觉平淡”生成结果的反思,旨在打造真正具备审美品味的创作伙伴。
核心价值: 解决了当前主流生成模型在视觉美学一致性、风格迁移精度和创意自由度上的短板。Krea 2 允许用户通过上传多张参考图或情绪板(Moodboards)提取集体视觉意图,并利用四档创意参数(Raw/Low/Medium/High)在严格遵循与自主优化之间平衡。RAW+Turbo 双模型架构实现了“RAW 训练 LoRA + Turbo 推理”的最佳实践,兼顾可定制性与实时生成速度。
技术特点: 采用未蒸馏的 RAW 基础模型以保证最大可塑性,配合 8 步蒸馏的 Turbo 模型实现约 2 秒出图。支持 1K~2K 分辨率输出,并原生集成风格迁移、情绪板理解和区域级图像编辑(Krea Edit)。模型权重完全开源,支持 ComfyUI、Fal、SGLang 等主流平台,并提供完整的 API 和微调工具链。
2. 主要功能
风格迁移(Style Transfer): 上传一张或多张参考图,Krea 2 能自动提取其视觉风格(包括色调、纹理、光影和构图特征)并应用到新图像中。支持调节每张参考图的影响强度,也可混合多种风格,实现高度个性化的艺术融合。该功能是 Krea 2 的核心差异化能力,在同类模型中表现突出。
Moodboards(情绪板): 上传一组共享创意方向的图片,Krea 2 能理解整体的色调、纹理、氛围和构图意图,即使使用简单提示词也能输出风格一致的结果。情绪板功能特别适合项目早期快速统一视觉方向,减少反复试错成本。
创意参数(Creativity)四档控制: 提供 Raw(严格遵循提示词)、Low(接近提示词)、Medium(平衡默认)、High(模型自动添加美学深度、构图和视觉丰富度)四种模式。Raw 模式适合需要精准控制的任务(如产品图),High 模式则让模型发挥创作自由度,生成更具艺术感的图像。
文生图(Text-to-Image): 支持从文本提示词生成高质量图像。RAW 模型最高支持 1K 分辨率,Turbo 模型支持 1K~2K 分辨率。得益于美学优先的训练目标,即使简单提示词也能输出构图完整、色彩和谐的结果。
图生图 / 图像编辑: 配合 Krea Edit 功能,支持区域级图像编辑、场景重打光、外扩(Outpainting)。用户可对局部区域进行定向修改,无需重新生成整张图片,大幅提升迭代效率。该功能在商业设计场景中极具实用价值。
LoRA 训练与推理: 在 RAW 基础模型上训练 LoRA(低秩适配),然后在 Turbo 蒸馏模型上运行推理。这一“RAW 训练 + Turbo 推理”工作流兼顾了定制化与生成速度,是 Krea 2 独特的设计哲学。支持 Hugging Face Diffusers、Ostris AI toolkit、Kohya 等主流微调框架。
Krea Nodes 工作流: 通过自然语言描述图像处理流程,系统自动组装处理图,无需手动配置复杂参数。这降低了使用门槛,让非技术用户也能构建复杂的图像生成管线。
3. 如何使用
环境要求: 本地部署需要一台配备 NVIDIA GPU 的 Linux 或 Windows 系统,推荐显存至少 8GB(Turbo 模型)或 16GB(RAW 模型)。需安装 Python 3.10+、uv 包管理器和 Git。ComfyUI 用户需提前安装 ComfyUI 环境。
网页端直接使用: 访问 krea.ai,在界面中选择 Krea 2 模型,输入文本提示词,上传风格参考图或 Moodboards,调节 Creativity 参数(Raw/Low/Medium/High),点击生成即可。这是最快捷的方式,无需任何本地配置。
本地部署(RAW 模型): 克隆 GitHub 仓库(krea-ai/krea-2),运行
uv sync安装依赖。下载 RAW 模型权重并设置环境变量OSS_RAW(指向权重路径)。执行推理命令:uv run inference.py "提示词" --checkpoint oss_raw --steps 52 --cfg 3.5。RAW 模型支持最高 1K 分辨率,采样步数较多但可塑性极强。本地部署(Turbo 模型): 下载 Turbo 模型权重并设置
OSS_TURBO环境变量。执行命令:uv run inference.py "提示词" --checkpoint oss_turbo --steps 8 --cfg 0.0 --mu 1.15 --width 2048 --height 2048。仅需 8 步采样,约 2 秒出图,支持 1K~2K 分辨率。注意 cfg 设置为 0.0,mu 参数控制引导强度。ComfyUI 中使用: 将 Krea 2 模型导入 ComfyUI 工作流,加载 RAW 或 Turbo 模型节点,连接提示词和采样器节点进行推理。社区已有现成的自定义节点,可参考 GitHub 仓库中的示例工作流。
API 调用: 通过 Fal 等官方合作伙伴的 API 服务调用 Krea 2,将模型集成到自己的应用或工作流中。API 支持文生图、风格迁移、图生图等核心功能,适合需要自动化批量生成的场景。
LoRA 训练与推理: 使用 Hugging Face Diffusers、Ostris AI toolkit、Kohya(musubi tuner)或 Fal 在 RAW 模型上训练 LoRA。训练完成后,在 Turbo 模型上加载 LoRA 进行快速推理。注意训练时需使用 RAW 模型权重,推理时切换至 Turbo 模型以获得实时速度。
4. 优缺点分析
| 优点 |
|---|
| 美学质量行业领先: 在 Artificial Analysis 评测中位列独立实验室文生图模型第一,输出具有编辑级视觉品质,显著降低“AI 味”,更适合创意专业场景。 |
| 开源双模型架构: RAW 和 Turbo 权重完全开源,支持本地部署和微调,为开发者提供了极高的自由度。RAW 训练 LoRA + Turbo 推理的工作流是独特优势。 |
| 极强的风格迁移能力: 支持多张参考图混合风格和情绪板理解,能够从一组图片中提取集体视觉意图,实现风格一致的批量输出,这在同类模型中罕见。 |
| 创意参数灵活可控: 四档 Creativity 调节(Raw/Low/Medium/High)让用户能在严格遵循提示词与模型自主优化之间自由切换,适应不同创作需求。 |
5. 同类工具对比
| 对比维度 | Krea 2 | GPT Image 2 |
|---|---|---|
| 核心架构 | 从零训练的基础模型,RAW+Turbo 双架构 | 基于 GPT-4o 多模态架构的生成模块 |
| 美学质量 | 极高(编辑级温暖感,去 AI 味) | 好(技术正确但偏冷淡) |
| 提示词遵循 | 中等(偏艺术解读,自主优化构图) | 极高(逐字翻译,多部分复杂指令最强) |
| 风格迁移能力 | 极强(核心优势,支持多图混合和情绪板) | 好但不够一致,输出偏 polished 风格 |
| 文本渲染 | 弱(短词尚可,长文本不稳定) | 极强(标签、UI、包装文字最可靠) |
| 照片真实感 | 中等(偏风格化,非核心目标) | 极高 |
| 开源/可定制 | 完全开源(RAW+Turbo 权重+推理代码) | 闭源(仅 API/ChatGPT 访问) |
| LoRA 微调 | 支持(RAW 训练,Turbo 推理) | 不支持 |
| 生成速度 | Turbo 约 2 秒/8步 | 8~15 秒/张 |
选型建议: 对于需要精确提示词遵循和文本渲染的场景(如 UI 设计、包装设计、复杂指令的多对象生成),GPT Image 2 是更可靠的选择。对于追求照片级真实感的任务(如产品摄影模拟、写实肖像),Gemini Imagen 3 表现最佳。而 Krea 2 则最适合以视觉美学和风格一致性为核心的创意工作,如概念设计、情绪板探索、时尚 Lookbook 制作、游戏角色风格统一等。如果团队需要完全可控的本地部署和 LoRA 微调能力,Krea 2 是唯一开源且支持 RAW+Turbo 双模型工作流的选择。
6. 编辑点评
Krea 2 的推出标志着图像生成领域从“技术正确”向“美学优先”的重要转向。其核心创新在于:并非简单地在现有架构上堆砌数据,而是从零设计训练目标和数据筛选策略,使模型内化对构图、色彩、光影的审美理解。这在 Artificial Analysis 评测中位列第一的成绩已得到第三方验证。从实用价值看,RAW+Turbo 双模型架构巧妙平衡了可塑性与速度:RAW 模型作为 LoRA 训练的基座,提供最大自由度;Turbo 模型则通过 8 步蒸馏实现实时推理,使“训练-推理”闭环成为可能。风格迁移和情绪板功能在同类模型中独树一帜,尤其适合需要批量保持视觉一致性的商业场景。
然而,Krea 2 并非万能。其弱项在于文本渲染和复杂提示词遵循,这限制了它在 UI 设计、广告文案生成等领域的应用。照片真实感也非其强项,更适合风格化创作。对于追求极致写实或精确指令执行的用户,GPT Image 2 和 Imagen 3 仍是更优选择。此外,RAW 模型对硬件的要求较高,可能阻碍部分个人创作者使用。
适用人群定位: 专业设计师、创意工作室、游戏美术师、时尚行业从业者、建筑师,以及任何将视觉美学置于首位的创作者。对于需要本地部署、微调定制或构建自动化管线的开发者,Krea 2 的开源特性极具吸引力。
未来发展潜力: 随着社区对 RAW 模型进行更多 LoRA 微调,以及官方可能推出的更大参数量版本,Krea 2 的生态有望快速扩展。若能在文本渲染和提示词遵循方面迭代改进,其应用场景将进一步拓宽。
7. 应用场景
创意工作室与概念设计: 快速探索视觉方向、构建情绪板(Moodboards)、生成概念艺术和风格参考。团队可在项目早期上传灵感图片,让 Krea 2 自动生成风格一致的多个方案,大幅缩短前期调研和沟通时间。
营销与广告: 生成风格一致的编辑级/商业级 campaign 素材。品牌可上传品牌视觉指南图片作为情绪板,Krea 2 能批量输出符合品牌调性的海报、社交媒体图片,减少传统拍摄和后期成本。
时尚行业: 制作 Lookbook、时尚编辑图像。设计师可上传面料样本、秀场照片作为风格参考,精准控制面料质感、光影氛围和整体美学风格,实现从概念到成片的高效迭代。
建筑与空间设计: 进行概念可视化、材质研究和空间构图快速探索。上传参考建筑图片或室内风格图,Krea 2 能生成多种风格倾向的效果图,帮助设计师在方案阶段快速呈现不同美学方向。
游戏开发: 用于角色设计、场景概念、世界观构建和道具设计。通过风格迁移保持全项目视觉统一性,例如上传一组概念艺术作为情绪板,Krea 2 可生成风格一致的装备、建筑和生物设计。
电商与产品展示: 批量生成一致风格的高质量产品图。上传产品实拍图作为参考,调节创意参数至 Raw 模式,Krea 2 能生成不同场景、背景和风格的展示图,提升商品视觉吸引力。
8. 常见问题FAQ
Q:Krea 2 与 Stable Diffusion 3 相比有何优势?
A:Krea 2 是从零训练的基础模型,而非基于 SD 架构微调。其美学优先的设计使其在风格迁移、情绪板理解和视觉一致性上明显优于 SD 3。此外,RAW+Turbo 双模型架构提供了更好的可塑性与速度平衡,且完全开源。
Q:RAW 模型和 Turbo 模型如何选择?
A:如果需要训练 LoRA 或进行深度定制,应使用 RAW 模型(52 步,高质量但慢)。如果追求实时生成(约 2 秒),使用 Turbo 模型(8 步,支持 1K~2K 分辨率)。最佳实践是在 RAW 上训练 LoRA,然后在 Turbo 上推理。
Q:Krea 2 能否生成逼真的照片?
A:Krea 2 的核心目标是风格化美学,而非照片真实感。虽然能生成高质量图像,但在超写实方面不如 GPT Image 2 或 Imagen 3。若需要照片级输出,建议选择后两者。
Q:如何解决 Krea 2 文本渲染不准确的问题?
A:目前 Krea 2 的文本渲染能力较弱,长文本易出错。建议避免生成包含复杂文字的图像,或使用 Raw 创意参数并手动调整提示词。若必须生成文字,可考虑先用 Krea 2 生成背景,再用其他工具叠加文字。
Q:Krea 2 的 LoRA 训练需要多少数据?
A:通常 10~50 张高质量图片即可训练出有效的 LoRA。使用 RAW 模型作为基座,训练工具推荐 Hugging Face Diffusers 或 Kohya。训练完成后,在 Turbo 模型上加载 LoRA 进行推理,速度几乎没有损失。
Q:Krea 2 是否支持商业使用?
A:是的,模型权重采用 Apache 2.0 许可证,完全开源,支持商业和学术用途。但需注意,使用 API 服务(如 Fal)时需遵守相应服务条款。
9. 项目地址
- GitHub 仓库:https://github.com/krea-ai/krea-2
相关 AI 模型文章
PixelUMM深度评测:NVIDIA与滑铁卢大学联合打造的无编码器统一多模态模型
PixelUMM是NVIDIA与滑铁卢大学联合推出的无编码器统一多模态模型,其核心创新在于彻底移除传统多模态系统中的VAE和视觉编码器,构建了一个纯粹的Decoder-only Transformer架构,直接在原始像素空间读写图像与视频。该模型将图像按16×16 patch、视频按4帧tubelet切分,理解和生成任务共享同一解码器与自注意力机制,实现了端到端的像素级信息处理,代码已全面开源。
Nano Banana 2.1:Google DeepMind 图像生成与对话式编辑模型深度评测
Nano Banana 2.1(模型 ID:gemini-nano-banana-2.1)是 Google DeepMind 于 2026 年 10 月 6 日正式发布的第二代图像生成与对话式编辑模型,隶属于 Gemini 3 系列,底层架构基于 Gemini 3.6 Flash。该模型深度融合了原生多模态推理、1M token 长上下文与知识 grounding 能力,支持 1K/2K/4K 分...
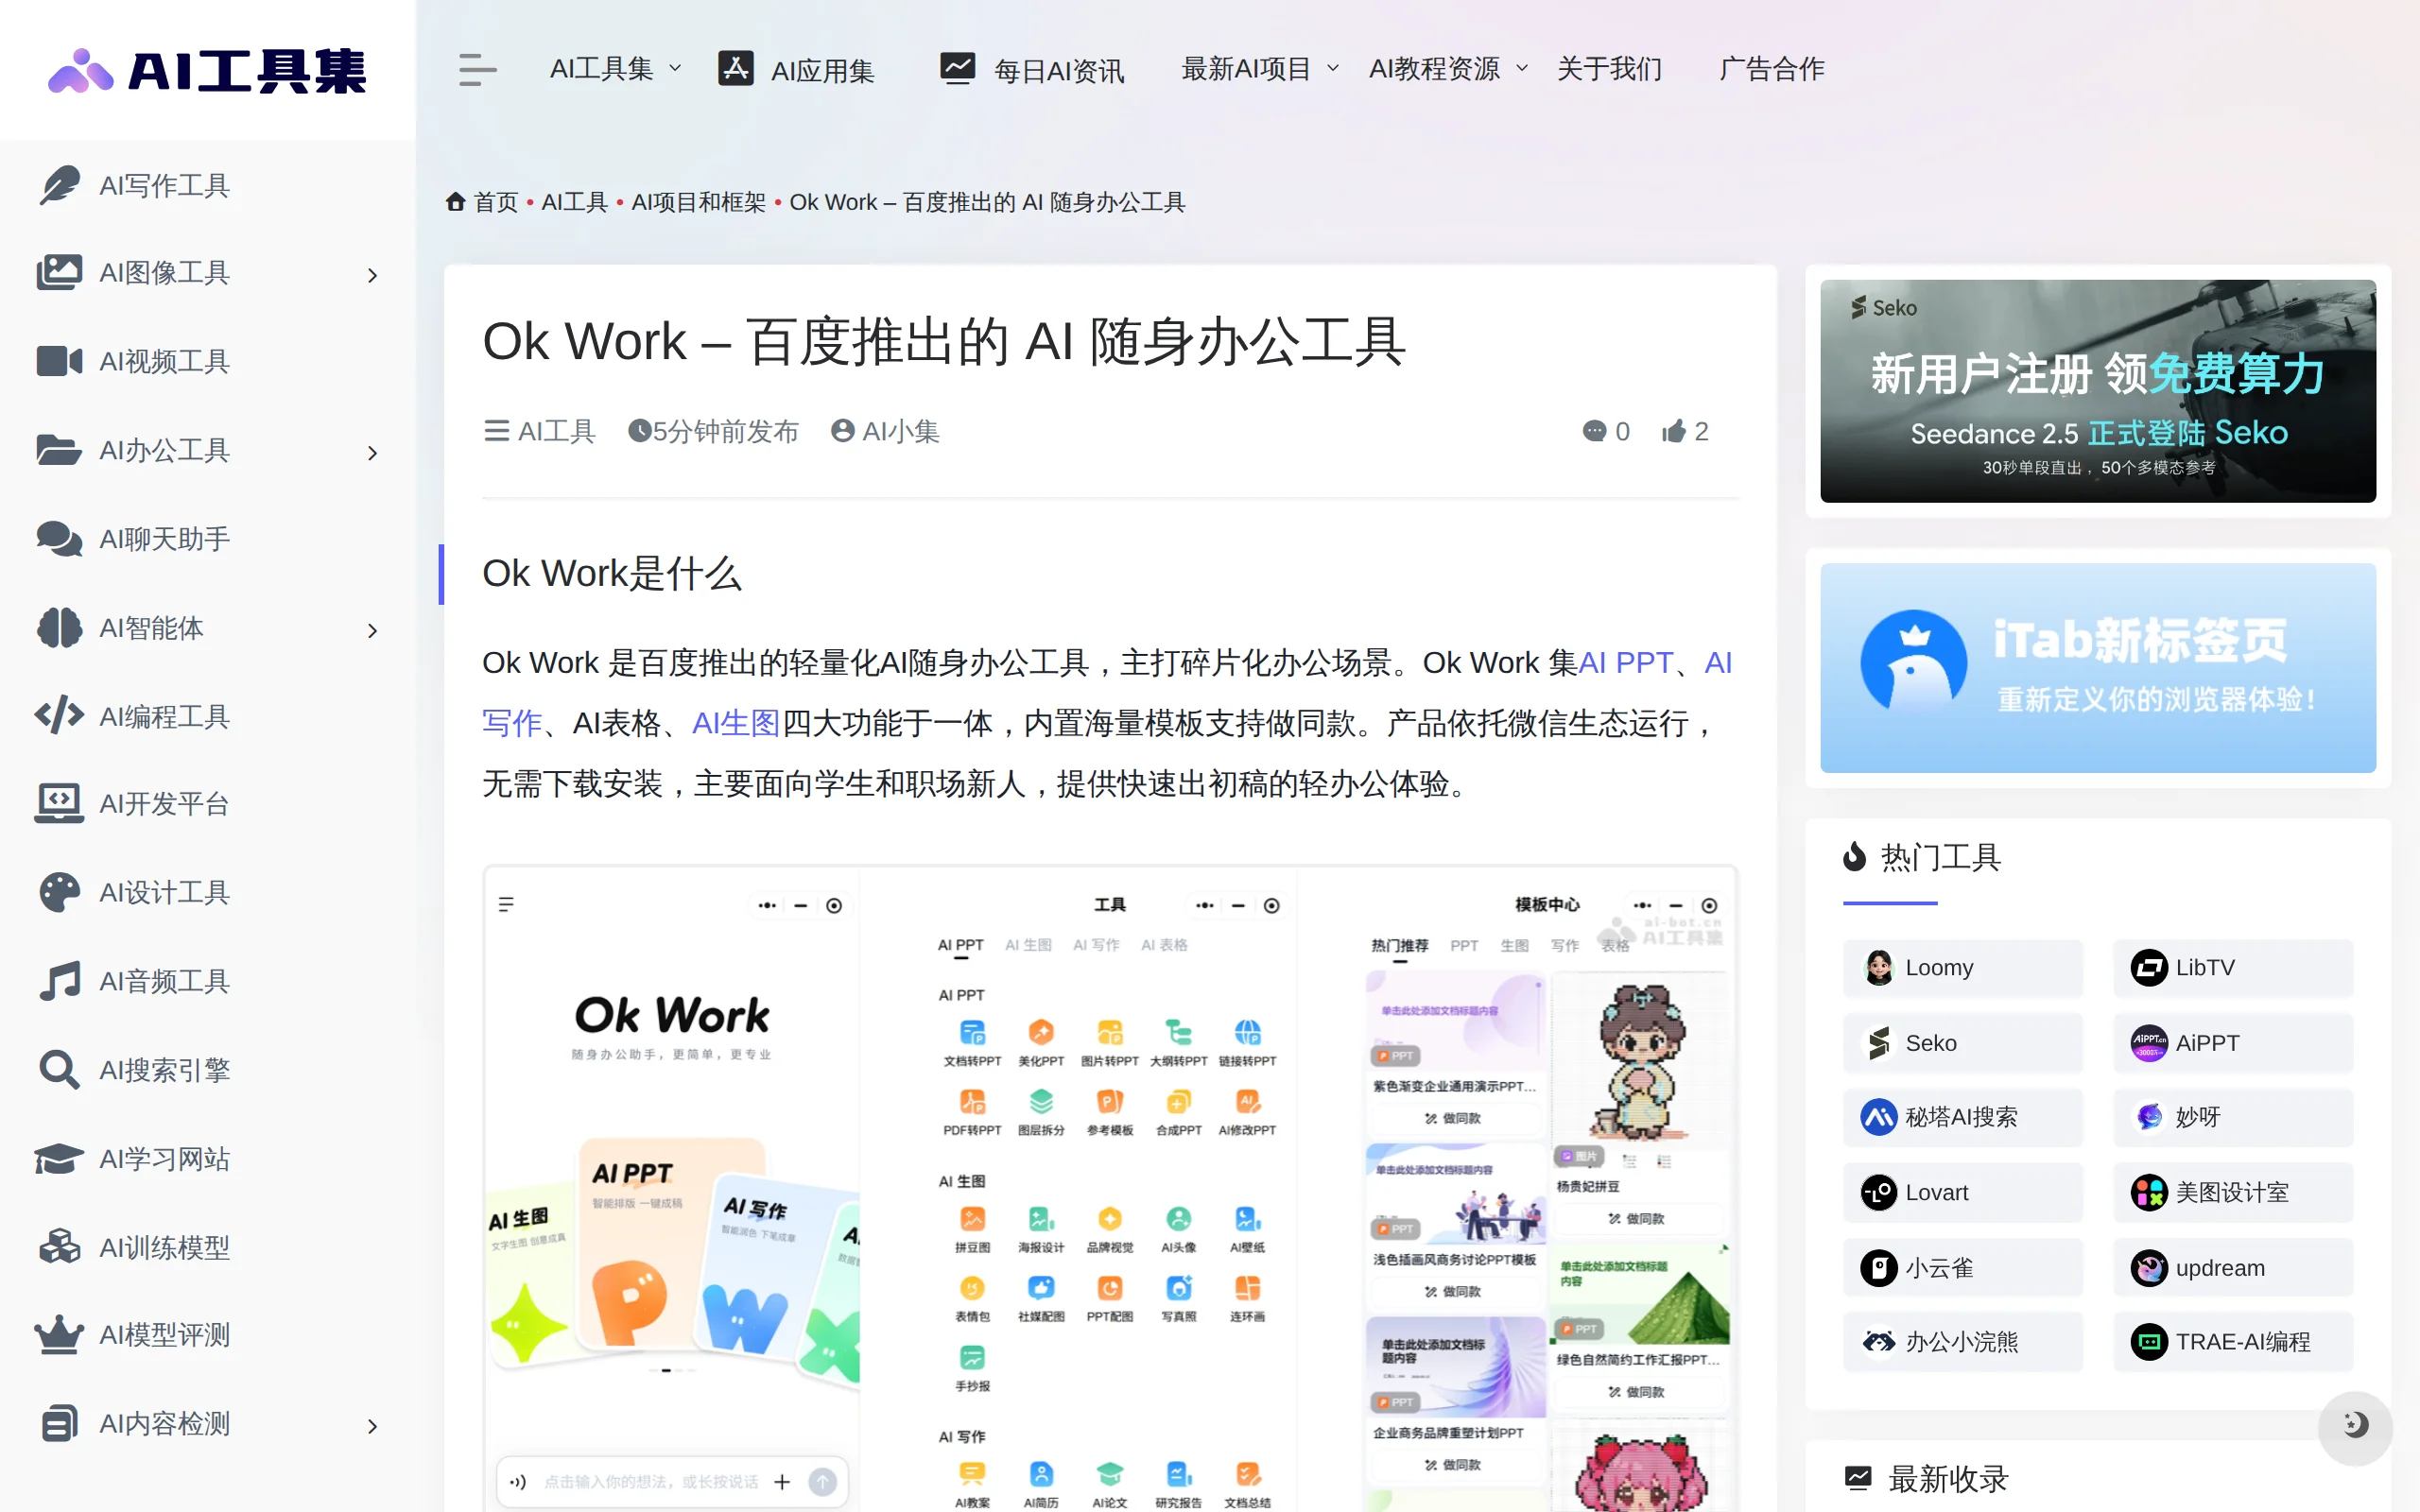
Ok Work – 百度推出的 AI 随身办公工具
Ok Work是百度推出的轻量化AI随身办公工具,以微信小程序形态运行,面向学生与职场新人,聚焦碎片化办公场景。产品将AI PPT、AI写作、AI表格、AI生图四大核心能力整合于同一对话界面,内置海量模板并支持"做同款"快速套用,无需下载安装即可完成从内容生成、文档转换到视觉设计的完整轻办公流程。依托文心大模型的底层能力,Ok Work将复杂的AI能力拆解为颗粒度精细的具体小工具,以极低的上手门槛...
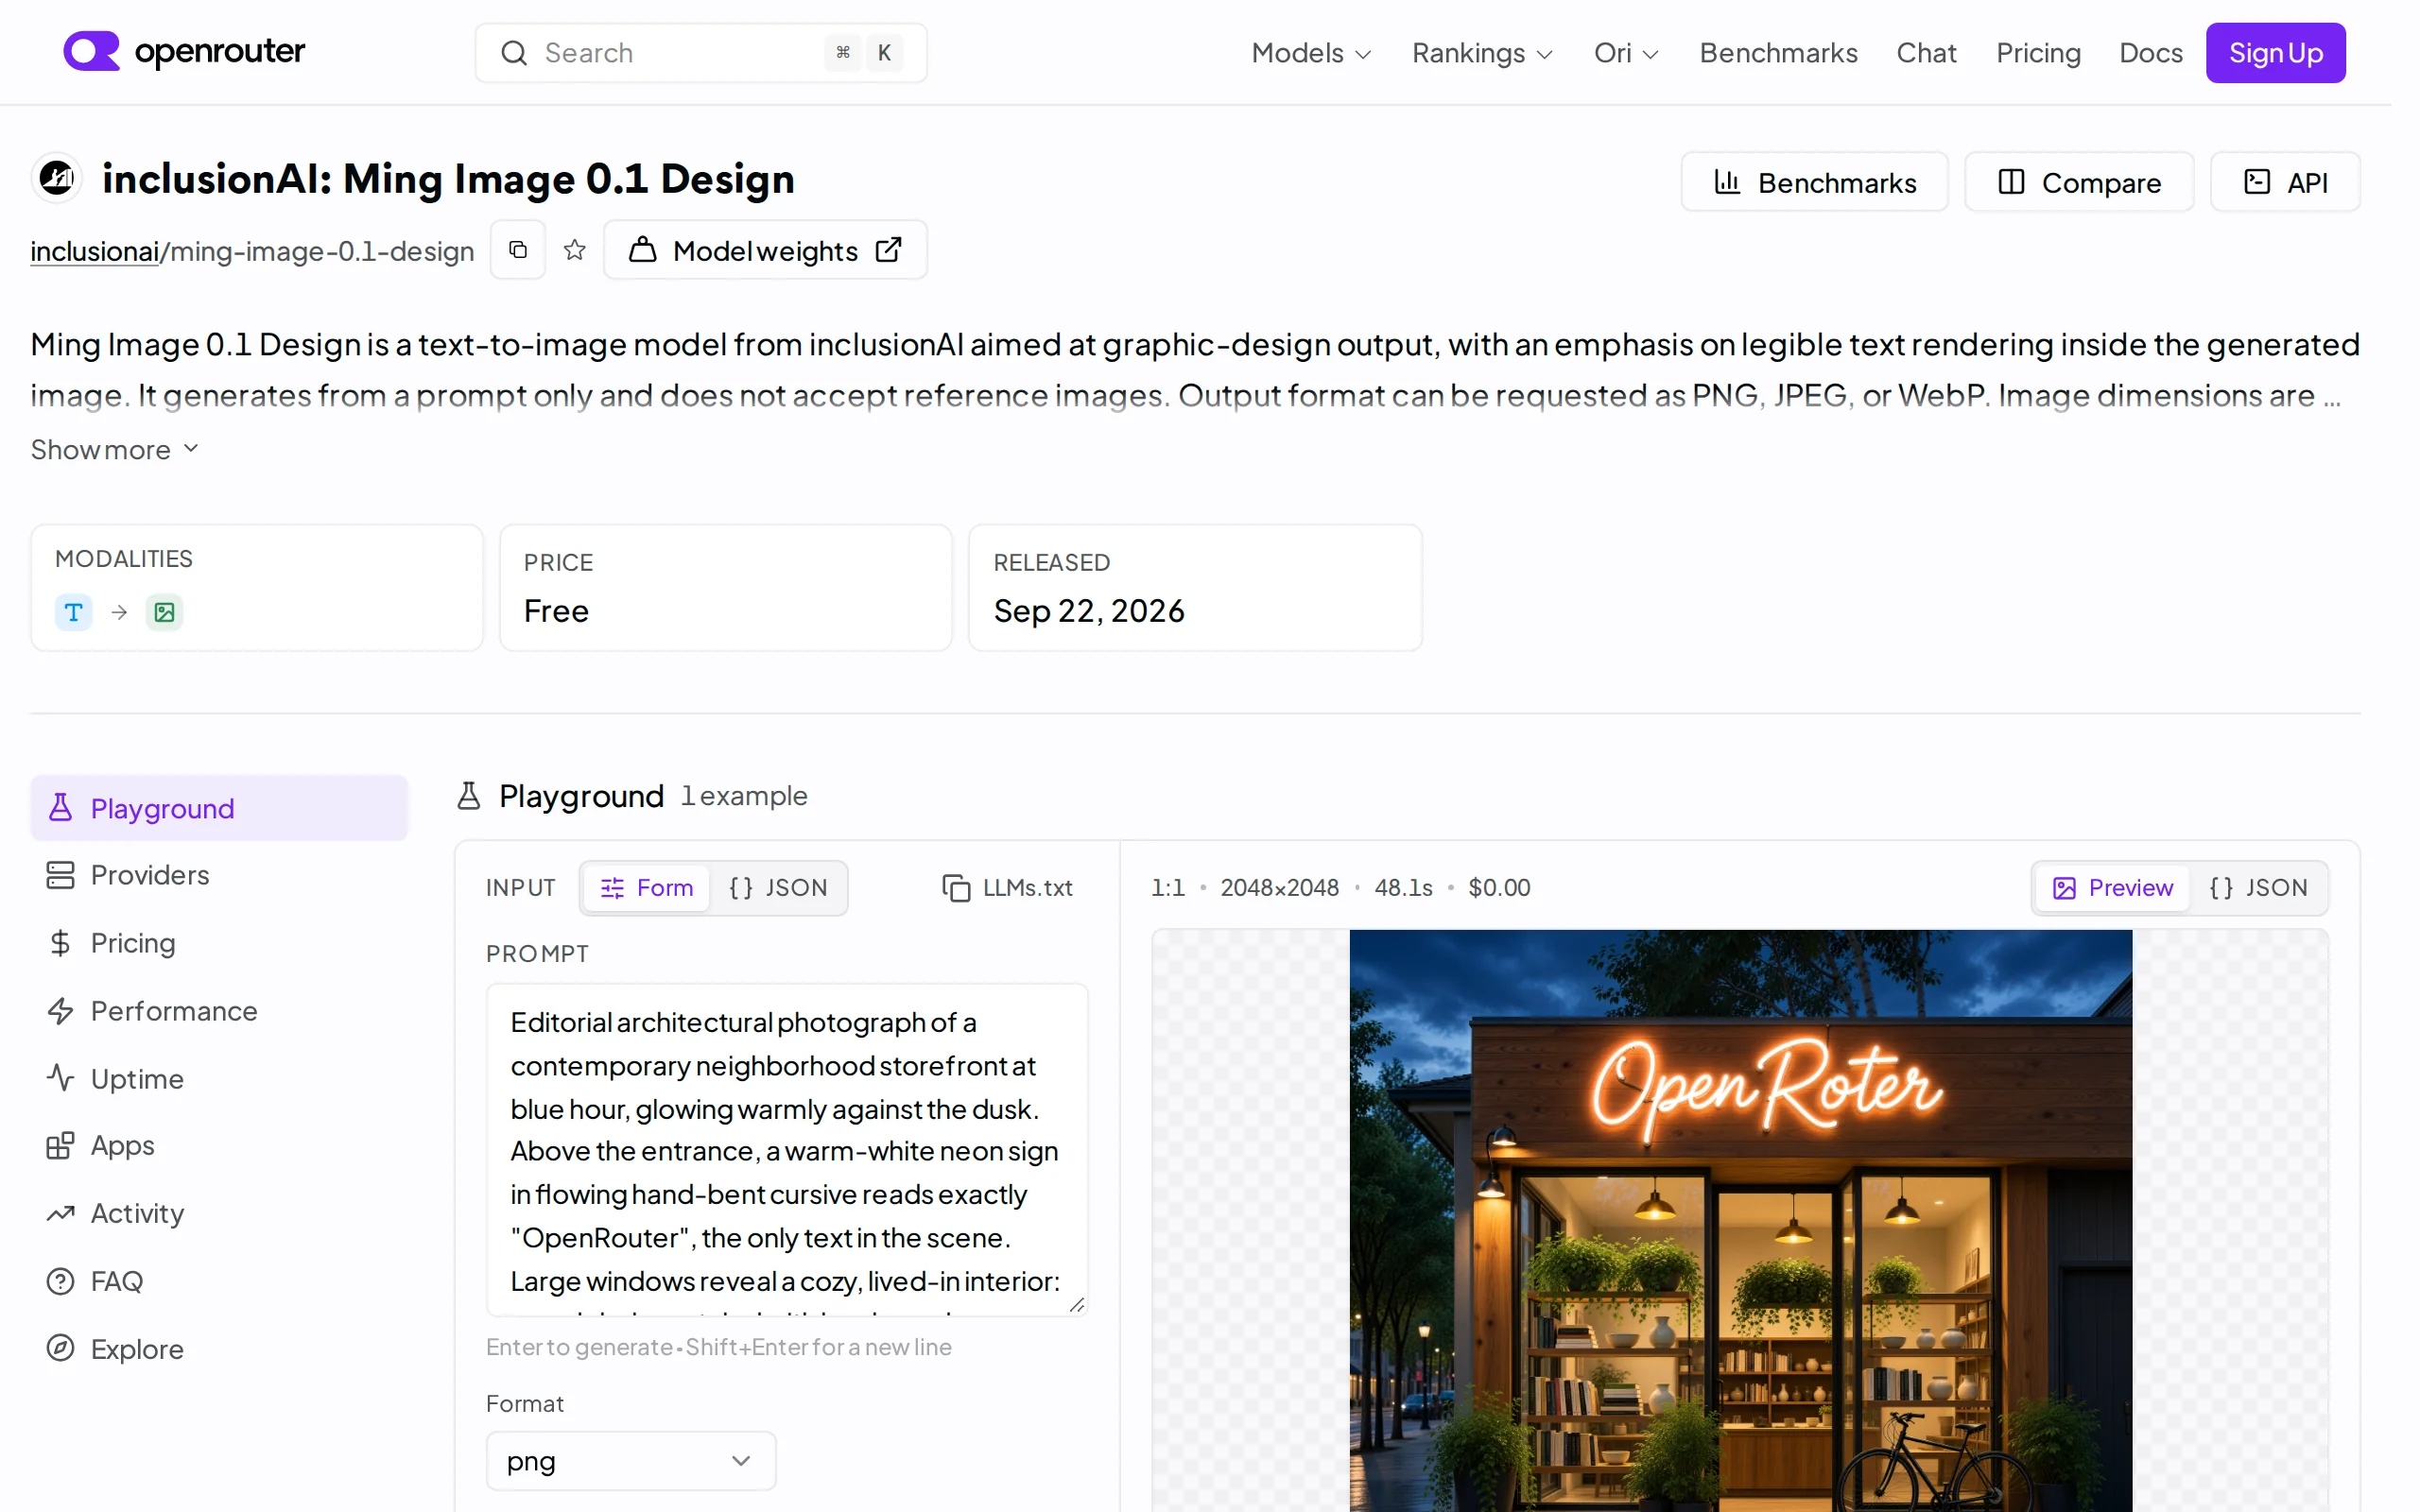
Ming-Image-0.1-Design:蚂蚁开源6B图像生成模型,端到端重构设计工作流
Ming-Image-0.1-Design是蚂蚁集团InclusionAI开源的一款6B参数图像生成模型,专注设计场景,支持8K长结构化提示词,能端到端生成UI、信息图、海报等完整视觉设计。配合同步开源的Design-Layer模型,该工具可将设计图拆解为2—9个可独立编辑的透明图层,实现"生成—分层—编辑—交付"全流程。Ming-Image-0.1-Design登顶Artificial Anal...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。