
M3.1-Flash-Preview 深度评测:MiniMax 面向日常开发场景的文本编程模型
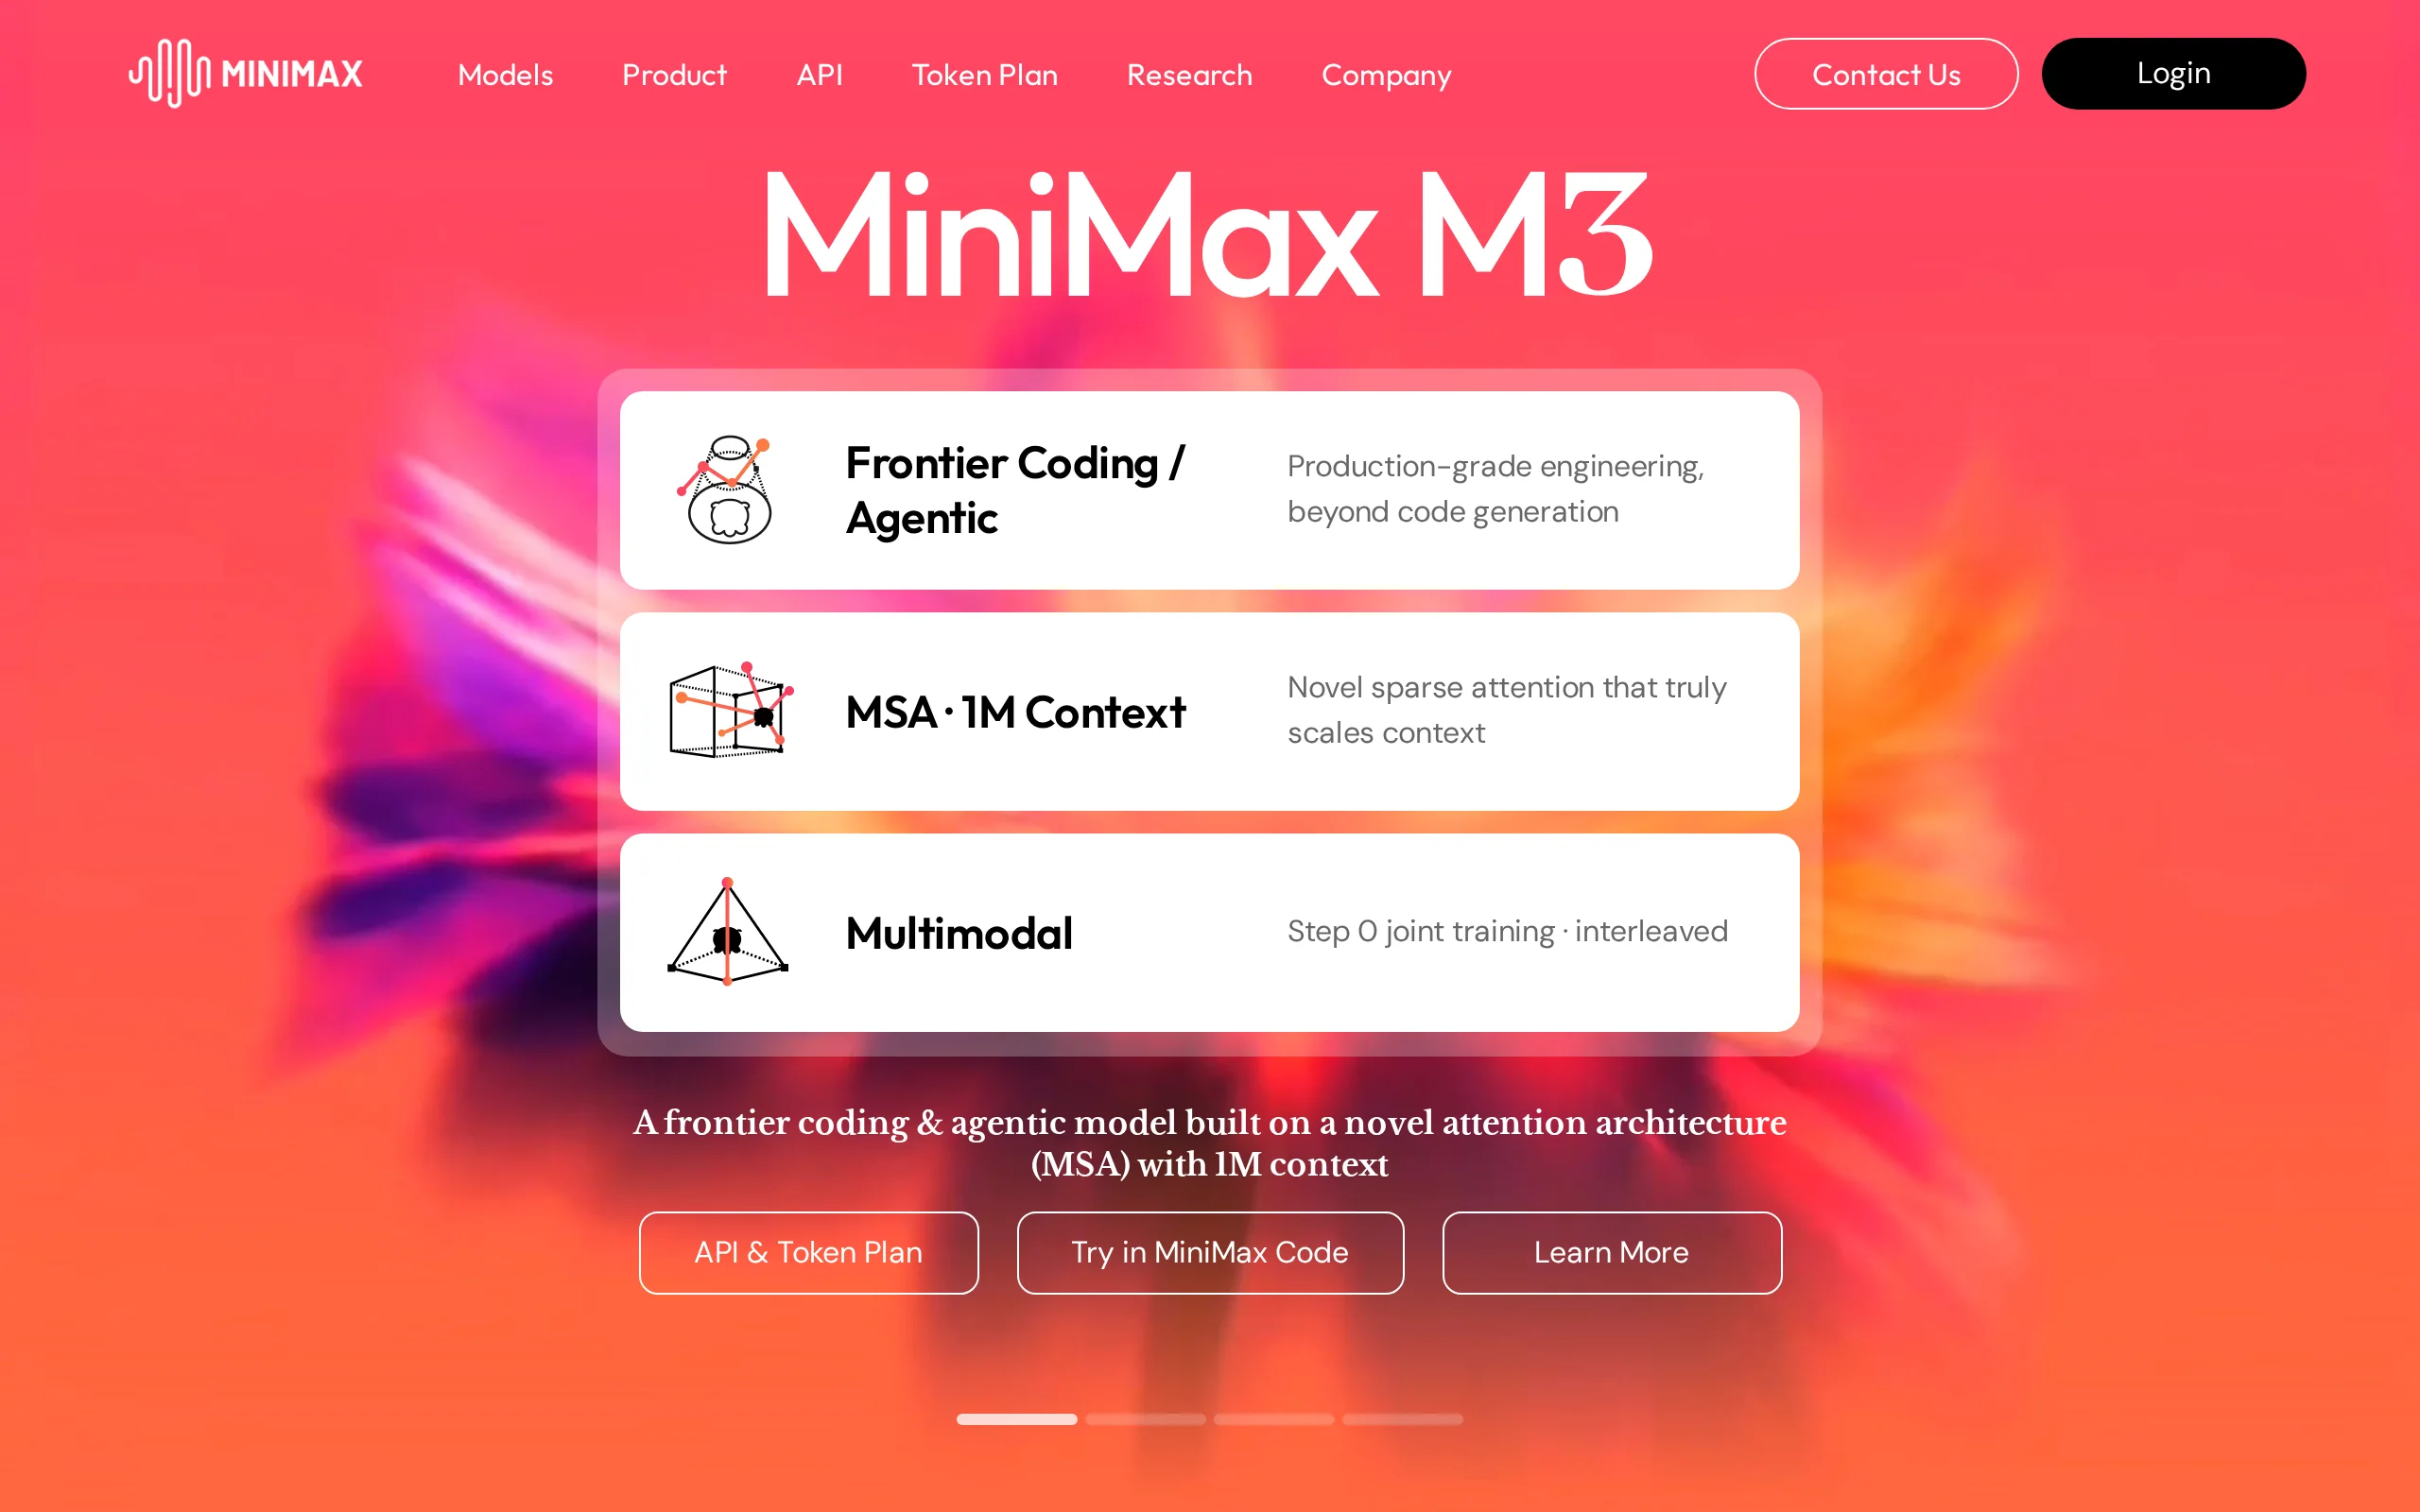
导读摘要:
M3.1-Flash-Preview 是 MiniMax 推出的最新文本编程模型,首发上线于 MiniMax Code 智能编程客户端。该模型面向日常开发场景设计,支持原生多模态输入和百万级上下文窗口,能够从 Bug 修复到完整功能开发形成"定位→实现→测试→交付"的完整闭环。M3.1-Flash-Preview 继承 M3 的 MoE 稀疏混合专家底座,提供 low 至 max 五档推理强度控制...
1. M3.1-Flash-Preview 是什么
M3.1-Flash-Preview 是 MiniMax 推出的最新文本编程模型,首发上线于 MiniMax Code 智能编程客户端。该模型面向日常开发场景设计,支持原生多模态输入和百万级上下文窗口,能够从 Bug 修复到完整功能开发形成"定位→实现→测试→交付"的完整闭环。M3.1-Flash-Preview 继承 M3 的 MoE 稀疏混合专家底座,提供 low 至 max 五档推理强度控制,目前仅限 MiniMax Code 和 Token Plan 用户使用。
技术定位与领域: 属于自然语言处理与代码生成交叉领域,聚焦于编程智能体(Coding Agent)方向。M3.1-Flash-Preview 在 MiniMax 产品矩阵中定位为"日常开发主力模型",与面向复杂任务的 M3 形成互补,以更低的推理成本和更快的响应速度覆盖高频迭代的编码场景。
研发背景: 由 MiniMax 团队开发,基于此前发布的 M3 模型底座进行针对性优化。M3 本身以 428B 总参、每 token 仅激活约 23B 参数的稀疏混合专家架构著称,M3.1-Flash-Preview 在此基础上进一步强化了推理速度与成本效率,体现了 MiniMax 在稀疏注意力与模型压缩方向的持续积累。
核心价值: 解决了代码大模型在"响应速度"与"理解深度"之间难以兼顾的痛点。通过 MSA 稀疏注意力将百万级上下文的计算量压缩至前代约 1/20,配合 Q8KV4 混合精度 KV Cache 与 W4A4 专家量化,在保持长上下文处理能力的同时显著降低显存占用和 token 消耗,使日常开发场景下的高频调用成为可能。
技术特点: 采用全稀疏化改造的 MSA 注意力机制,消除了模型中最后的全注意力计算瓶颈;以 DSpark 投机解码取代传统多头预测头,由小模型"猜测"、大模型并行验证,大幅提升生成吞吐。原生多模态输入能力支持文本、图像、视频多种形式,使需求理解更加直观。
2. 主要功能
开发全流程闭环: 从问题定位、代码实现到测试验证、成果交付一站式完成。模型能够自动拆解开发任务,在 Bug 修复和完整功能开发场景中稳定交付,可靠覆盖日常编码需求,减少开发者在多个工具间切换的成本。
需求深度理解与边界处理: 能够深入理解开发需求的技术本质,细致处理各种边界情况。在代码审查和功能实现中,模型会主动考虑空值、异常输入、并发冲突等边缘场景,交付质量稳定可靠,降低了返工概率。
回归测试自动补齐: 在代码改动后自动生成并补齐回归测试用例。模型会分析既有代码的测试覆盖情况,针对新增或修改的逻辑生成配套测试,并验证改动对现有功能的影响,有效降低代码合并后的回归风险。
原生多模态输入: 支持文本、图像、视频等多种输入形式。开发者可以直接上传 UI 设计稿、报错截图或操作录屏,模型能够结合视觉信息理解需求,比纯文本描述更加直观准确,特别适合前端开发和界面调试场景。
百万级上下文窗口: 支持 100 万 token 的上下文处理能力,可一次性吞入大型代码库和长文档进行分析。避免了传统模型因上下文截断导致的信息丢失问题,适合大型项目架构分析、跨文件重构等复杂任务。
五档推理强度控制: 提供 low / medium / high / xhigh / max 五档 Effort 调节选项。开发者可根据任务复杂度在速度与深度之间灵活平衡:轻量任务选择 low 档获得接近瞬时的响应,复杂任务选择 max 档获得更深入的推理。
极速响应与高吞吐: 约 280ms 首字延迟、126 tokens/秒 的生成速度,其中 low 档首字延迟可低至 210ms。配合 DSpark 投机解码加速机制,轻量开发任务的响应体验接近实时,显著提升编码时的交互流畅度。
低成本推理架构: 基于 MoE + MSA 稀疏架构配合激进量化策略,KV 缓存内存约为 M3 的一半,token 消耗和算力成本大幅低于同档模型。Q8KV4 混合精度 KV Cache 与 W4A4 NVFP4 专家量化在保证质量的同时显著降低显存占用。
3. 如何使用
下载安装 MiniMax Code: 访问 MiniMax Code 官方网站,根据操作系统(Windows / macOS / Linux)下载对应版本的客户端安装包,完成安装后启动应用程序。建议确认系统满足客户端的最低运行要求,以保证模型推理的流畅性。
注册或登录账号: 打开 MiniMax Code 客户端后,使用 MiniMax 账号登录。若尚无账号,需先完成注册流程。注意 M3.1-Flash-Preview 目前仅限 MiniMax Code 和 Token Plan 用户使用,需要确认账号已具备相应访问权限。
选择模型并配置推理强度: 在客户端的模型选择器中切换至 M3.1-Flash-Preview。根据当前任务的复杂度调整推理强度(Effort),可选范围为 low、medium、high、xhigh、max 五档——简单 Bug 修复建议使用 low 或 medium 档,复杂功能开发建议使用 high 及以上档位。
输入开发任务并接收交付: 用自然语言描述开发需求,可附加相关代码片段、报错日志、设计图或操作录屏。模型会自动完成问题定位、代码实现、测试验证并交付可运行的代码成果。建议在任务描述中明确功能边界和验收标准,以获得更符合预期的交付结果。
验证与迭代: 对模型交付的代码进行审查和运行验证。M3.1-Flash-Preview 会自动生成回归测试用例,开发者可运行测试确认改动未破坏既有功能。如需调整,可在对话中追加修改要求,模型会基于上下文进行迭代优化。
4. 优缺点分析
| 优点 |
|---|
| 开发全流程闭环: 从问题定位、代码实现到测试验证、成果交付一站式完成,覆盖日常开发全场景,减少开发者在多工具间切换的成本,提升整体交付效率。 |
| 超长上下文与多模态输入: 支持 100 万 token 上下文窗口和文本、图像、视频多种输入形式,可一次性处理大型代码库并理解视觉信息,在代码重构和 UI 开发场景中优势明显。 |
| 极速响应与高吞吐: 约 280ms 首字延迟、126 tokens/秒生成速度,low 档首字延迟可低至 210ms,轻量任务体验接近瞬时,显著提升编码交互的流畅度。 |
| 成本效率突出: MoE + MSA 稀疏架构配合 Q8KV4 混合精度 KV Cache 和 W4A4 专家量化,KV 缓存内存约为 M3 的一半,token 消耗和算力成本大幅低于同档模型。 |
5. 同类工具对比
| 对比维度 | M3.1-Flash-Preview(MiniMax) | Kimi K2.7 Code(月之暗面) |
|---|---|---|
| 核心架构 | MoE 稀疏混合专家,继承 M3 底座,MSA 稀疏注意力,官方未公布完整规格 | 1T 总参 / 32B 激活 MoE,MLA 注意力机制 |
| 上下文窗口 | 100 万 token,支持超长代码库一次性处理 | 256K token,长文本处理能力相对有限 |
| 推理强度控制 | low / medium / high / xhigh / max 五档 Effort 可调 | 锁定思维模式,不可关闭,灵活性较低 |
| 响应速度 | 约 280ms 首字延迟,126 tokens/秒生成速度 | 未公开具体首字延迟,以长思考为主 |
| 多模态支持 | 文本 / 图像 / 视频输入,原生多模态理解 | 文本 / 图像 / 视频输入(MoonViT) |
| 部署方式 | 仅限 MiniMax Code 客户端和 Token Plan,云端托管 | API 调用 + 官方客户端,云端托管 |
| 开源协议 | 闭源,未开放模型权重 | 闭源,未开放模型权重 |
| 社区生态 | MiniMax 生态内闭环,第三方接入有限 | 月之暗面生态,开发者社区较为活跃 |
选型建议: 对于追求极速响应和低成本高频调用的日常开发团队,M3.1-Flash-Preview 凭借五档推理强度控制和超长上下文能力,在敏捷迭代场景中具有明显优势,尤其适合需要处理大型代码库或依赖多模态输入的团队。但其封闭生态和客户端绑定特性,要求团队愿意接受 MiniMax Code 作为主力开发工具。
对于已经深度使用 Kimi K2.7 Code 或 Claude 3 的团队,迁移成本需要重点考量。Claude 3 在复杂推理和代码质量上表现成熟,且拥有更广泛的第三方集成;Kimi K2.7 Code 则在中文场景和长文本处理上有差异化优势。若团队对工具生态开放性要求较高,或需要在多种 IDE 环境中灵活调用,建议优先评估 API 接入方案更成熟的竞品。
6. 编辑总结
M3.1-Flash-Preview 在技术创新性上展现了 MiniMax 在稀疏注意力与模型压缩方向的扎实积累。将 M3 前三层的全注意力锚点层替换为 MSA 稀疏层,消除最后的全注意力计算瓶颈,配合 Q8KV4 混合精度 KV Cache 和 W4A4 NVFP4 专家量化,使百万级上下文的计算量压缩至前代约 1/20,KV 缓存内存减半——这些技术选择直指长上下文场景下的推理成本痛点,而非简单堆砌参数规模。DSpark 投机解码头的引入,以小模型"猜测"、大模型并行验证的方式提升生成吞吐,体现了工程实现上的务实取向。
从实用价值看,M3.1-Flash-Preview 的"定位→实现→测试→交付"闭环设计,加上五档推理强度控制,使其在日常开发场景中具备较高的实用性和灵活性。约 280ms 首字延迟和 126 tokens/秒的生成速度,让轻量任务接近实时响应,显著降低了 AI 辅助编码的等待成本。对于高频迭代的敏捷开发团队,这种体验提升是实质性的。
模型适用于追求开发效率和成本控制的个人开发者及中小团队,尤其是需要处理大型代码库、依赖多模态输入(如 UI 设计稿、报错截图)的开发者。其封闭生态和客户端绑定特性,也意味着使用者需要接受 MiniMax Code 作为主力开发工具。作为 Preview 版本,其在复杂任务上的稳定性仍需更多实际项目验证;后续若开放 API 和模型权重,有望进一步拓展应用边界。
7. 应用场景
日常 Bug 修复: 针对报错日志和代码片段快速定位问题根因。开发者将异常堆栈或错误截图直接粘贴到 MiniMax Code 中,选择 medium 档推理强度,模型可在约 320ms 首字延迟内完成边界条件检查并给出修复方案,适合高频迭代的敏捷开发流程。
完整功能开发: 从需求描述到可运行代码的全流程交付。开发者用自然语言描述功能需求,模型自动拆解任务、实现业务逻辑、补齐回归测试,形成"实现→测试→验证"的开发闭环,大幅减少从设计到落地的中间环节。
大型代码库理解与重构: 凭借 100 万 token 上下文窗口,可一次性吞入整个仓库进行架构分析、跨文件重构影响评估。开发者无需手动分割代码片段,模型能够基于全局视角给出重构建议,避免传统模型因上下文截断导致的遗漏。
回归测试补齐与质量保障: 在改动现有功能后,模型自动生成配套测试用例并验证改动对既有功能的影响。开发者提交代码变更后,M3.1-Flash-Preview 会分析改动范围、生成针对性测试,并评估潜在回归风险,降低代码合并后的质量问题。
多模态需求理解与前端开发: 支持上传 UI 设计稿、界面截图或操作录屏,模型结合视觉信息理解需求并生成对应代码。前端开发者可直接将设计图拖入客户端,模型据此生成页面结构和样式,减少文字描述与视觉预期之间的偏差。
8. 常见问题FAQ
Q:M3.1-Flash-Preview 和 M3 有什么区别?
A:M3.1-Flash-Preview 基于 M3 底座优化,面向日常开发场景,强化了推理速度与成本效率。它将 M3 前三层的全注意力锚点层替换为 MSA 稀疏层,采用 DSpark 投机解码取代 EAGLE 多头预测头,KV 缓存内存约为 M3 的一半,首字延迟降至约 280ms,更适合高频调用的编码场景。
Q:M3.1-Flash-Preview 支持哪些输入形式?
A:支持原生多模态输入,包括文本、图像和视频。开发者可以直接上传报错截图、UI 设计稿或操作录屏,模型会结合视觉信息理解需求,比纯文本描述更加直观准确,特别适合前端开发和界面调试场景。
Q:五档推理强度(Effort)如何选择?
A:low 档适合简单 Bug 修复和快速问答,首字延迟可低至 210ms;medium 档适合常规编码任务;high 及以上档位适合复杂功能开发和深度推理。建议根据任务复杂度动态调整:轻量任务用低档位获得即时响应,复杂任务用高档位换取更深入的推理质量。
Q:M3.1-Flash-Preview 是否支持 API 调用?
A:目前仅限 MiniMax Code 客户端和 Token Plan 用户使用,尚未开放公开 API。若需要在自有应用中集成,建议关注 MiniMax 官方后续的 API 开放计划。
Q:百万级上下文窗口实际使用中有什么限制?
A:虽然支持 100 万 token 上下文,但实际可用长度受限于硬件显存和推理成本。在处理超长代码库时,建议优先输入与当前任务最相关的文件,以平衡上下文利用效率和推理速度。
Q:M3.1-Flash-Preview 的代码生成质量如何保证?
A:模型会自动生成并补齐回归测试用例,验证代码改动对现有功能的影响。建议开发者对模型交付的代码进行审查和运行验证,在任务描述中明确功能边界和验收标准,以获得更符合预期的交付结果。
9. 项目地址
- MiniMax Code 官网: https://www.minimax.io/code (产品官网,提供客户端下载)
- MiniMax 官网: https://www.minimax.io (公司产品与模型总览)
- MiniMax 官方博客(M3 技术介绍): https://www.minimax.io/blog/minimax-m3 (官方技术发布说明,包含 M3 架构及 MiniMax Code 更新详情)
- MiniMax 开放平台: https://platform.minimax.io (官方 API 与 Token Plan 管理入口)
相关 AI 模型文章
Claude Haiku 5.5 – Anthropic 推出的最轻量级模型
Claude Haiku 5.5 是 Anthropic 于 2026 年 10 月 7 日正式发布的最新小型语言模型,定位为"最便宜、最快、最能打"的高性价比产品。该模型将输入价格降至 $0.10/百万 token,综合成本降低约 75%,同时实现了电脑操作能力从 15.7% 到 72.4% 的大幅跃升。其支持 100 万 token 上下文窗口和五档可调思考机制,适用于智能摘要、数据分类、实时...
Startlux-Decision – StartLux Labs 开源的决策模型家族深度评测
StartLux-Decision 是 StartLux Labs 推出的开源决策模型家族,涵盖从 0.8B 至 27B 的五个稠密模型以及 35B-A3B 混合专家模型,专为类型化决策任务设计。该模型家族接收文本、JSON 或图片形式的状态输入,针对选择、是非、评分等结构化问题,通过单次前向推理直接返回每个选项的概率分布,天然可作为置信度使用。模型原生支持 256K token 超长上下文,具备...
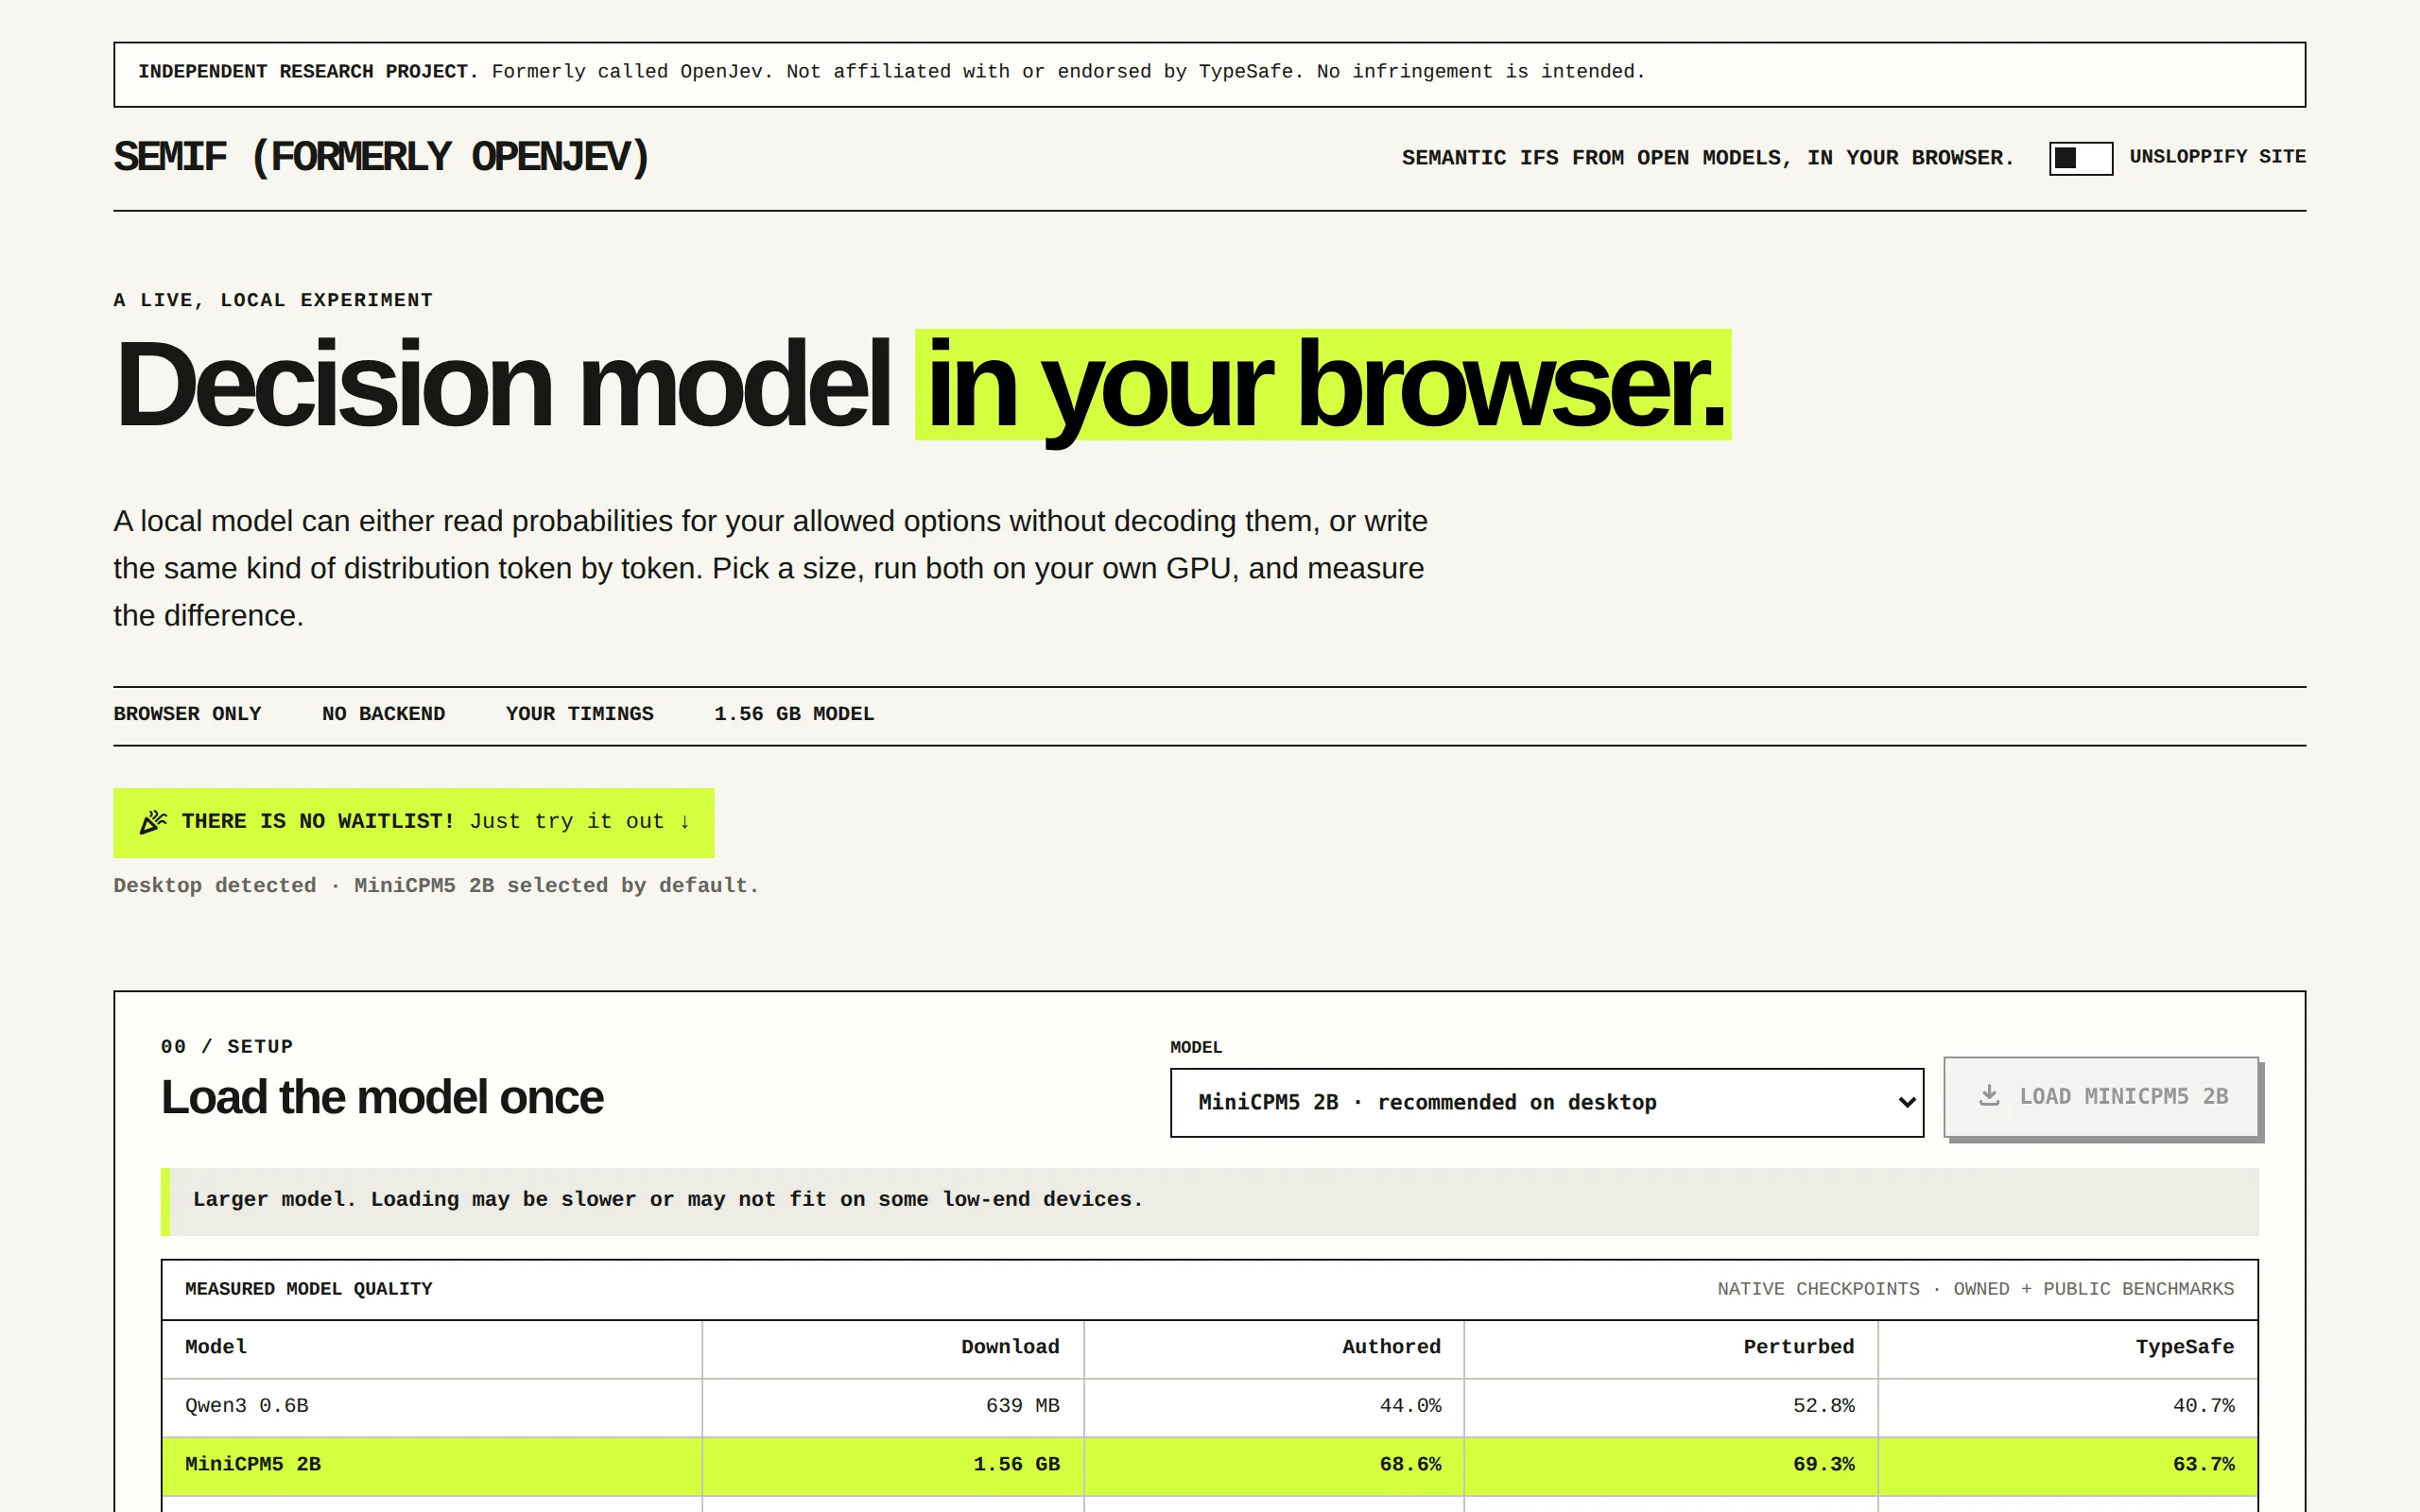
SemIf – 开源的 AI 决策模型,复现 Jev 语义决策模式
SemIf(原 OpenJev)是一个开源的 AI 决策模型,旨在通过开源手段复现 TypeSafe 闭源服务 Jev 的语义决策接口模式。该模型采用单次前向传播机制,直接读取候选选项对应的 logits 进行打分,由服务端构造结构化结果,从而规避了传统自回归生成后再解析文本的复杂流程。在多个问题共享相同状态时,SemIf 还可复用前缀计算,吞吐量提升近一个数量级。该模型在单张 RTX 3090 ...
MAI-Transcribe-2-Streaming:微软实时流式语音转写模型深度评测
MAI-Transcribe-2-Streaming 是微软推出的首个实时流式语音转写模型,能够在讲话进行时持续输出文字,覆盖 60 种语言并自动检测语言切换。该模型在 Artificial Analysis 流式转写榜单中以 2.50% 的词错误率和 0.13 秒的最终转录延迟双双登顶,首批文本延迟低至数百毫秒,文字最快在语音后 320 毫秒显示。其核心价值在于将传统语音转写从"说完再识别"的批...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。