
MOSS-Image – 模思智能联合OpenMOSS开源的文生图模型
导读摘要:
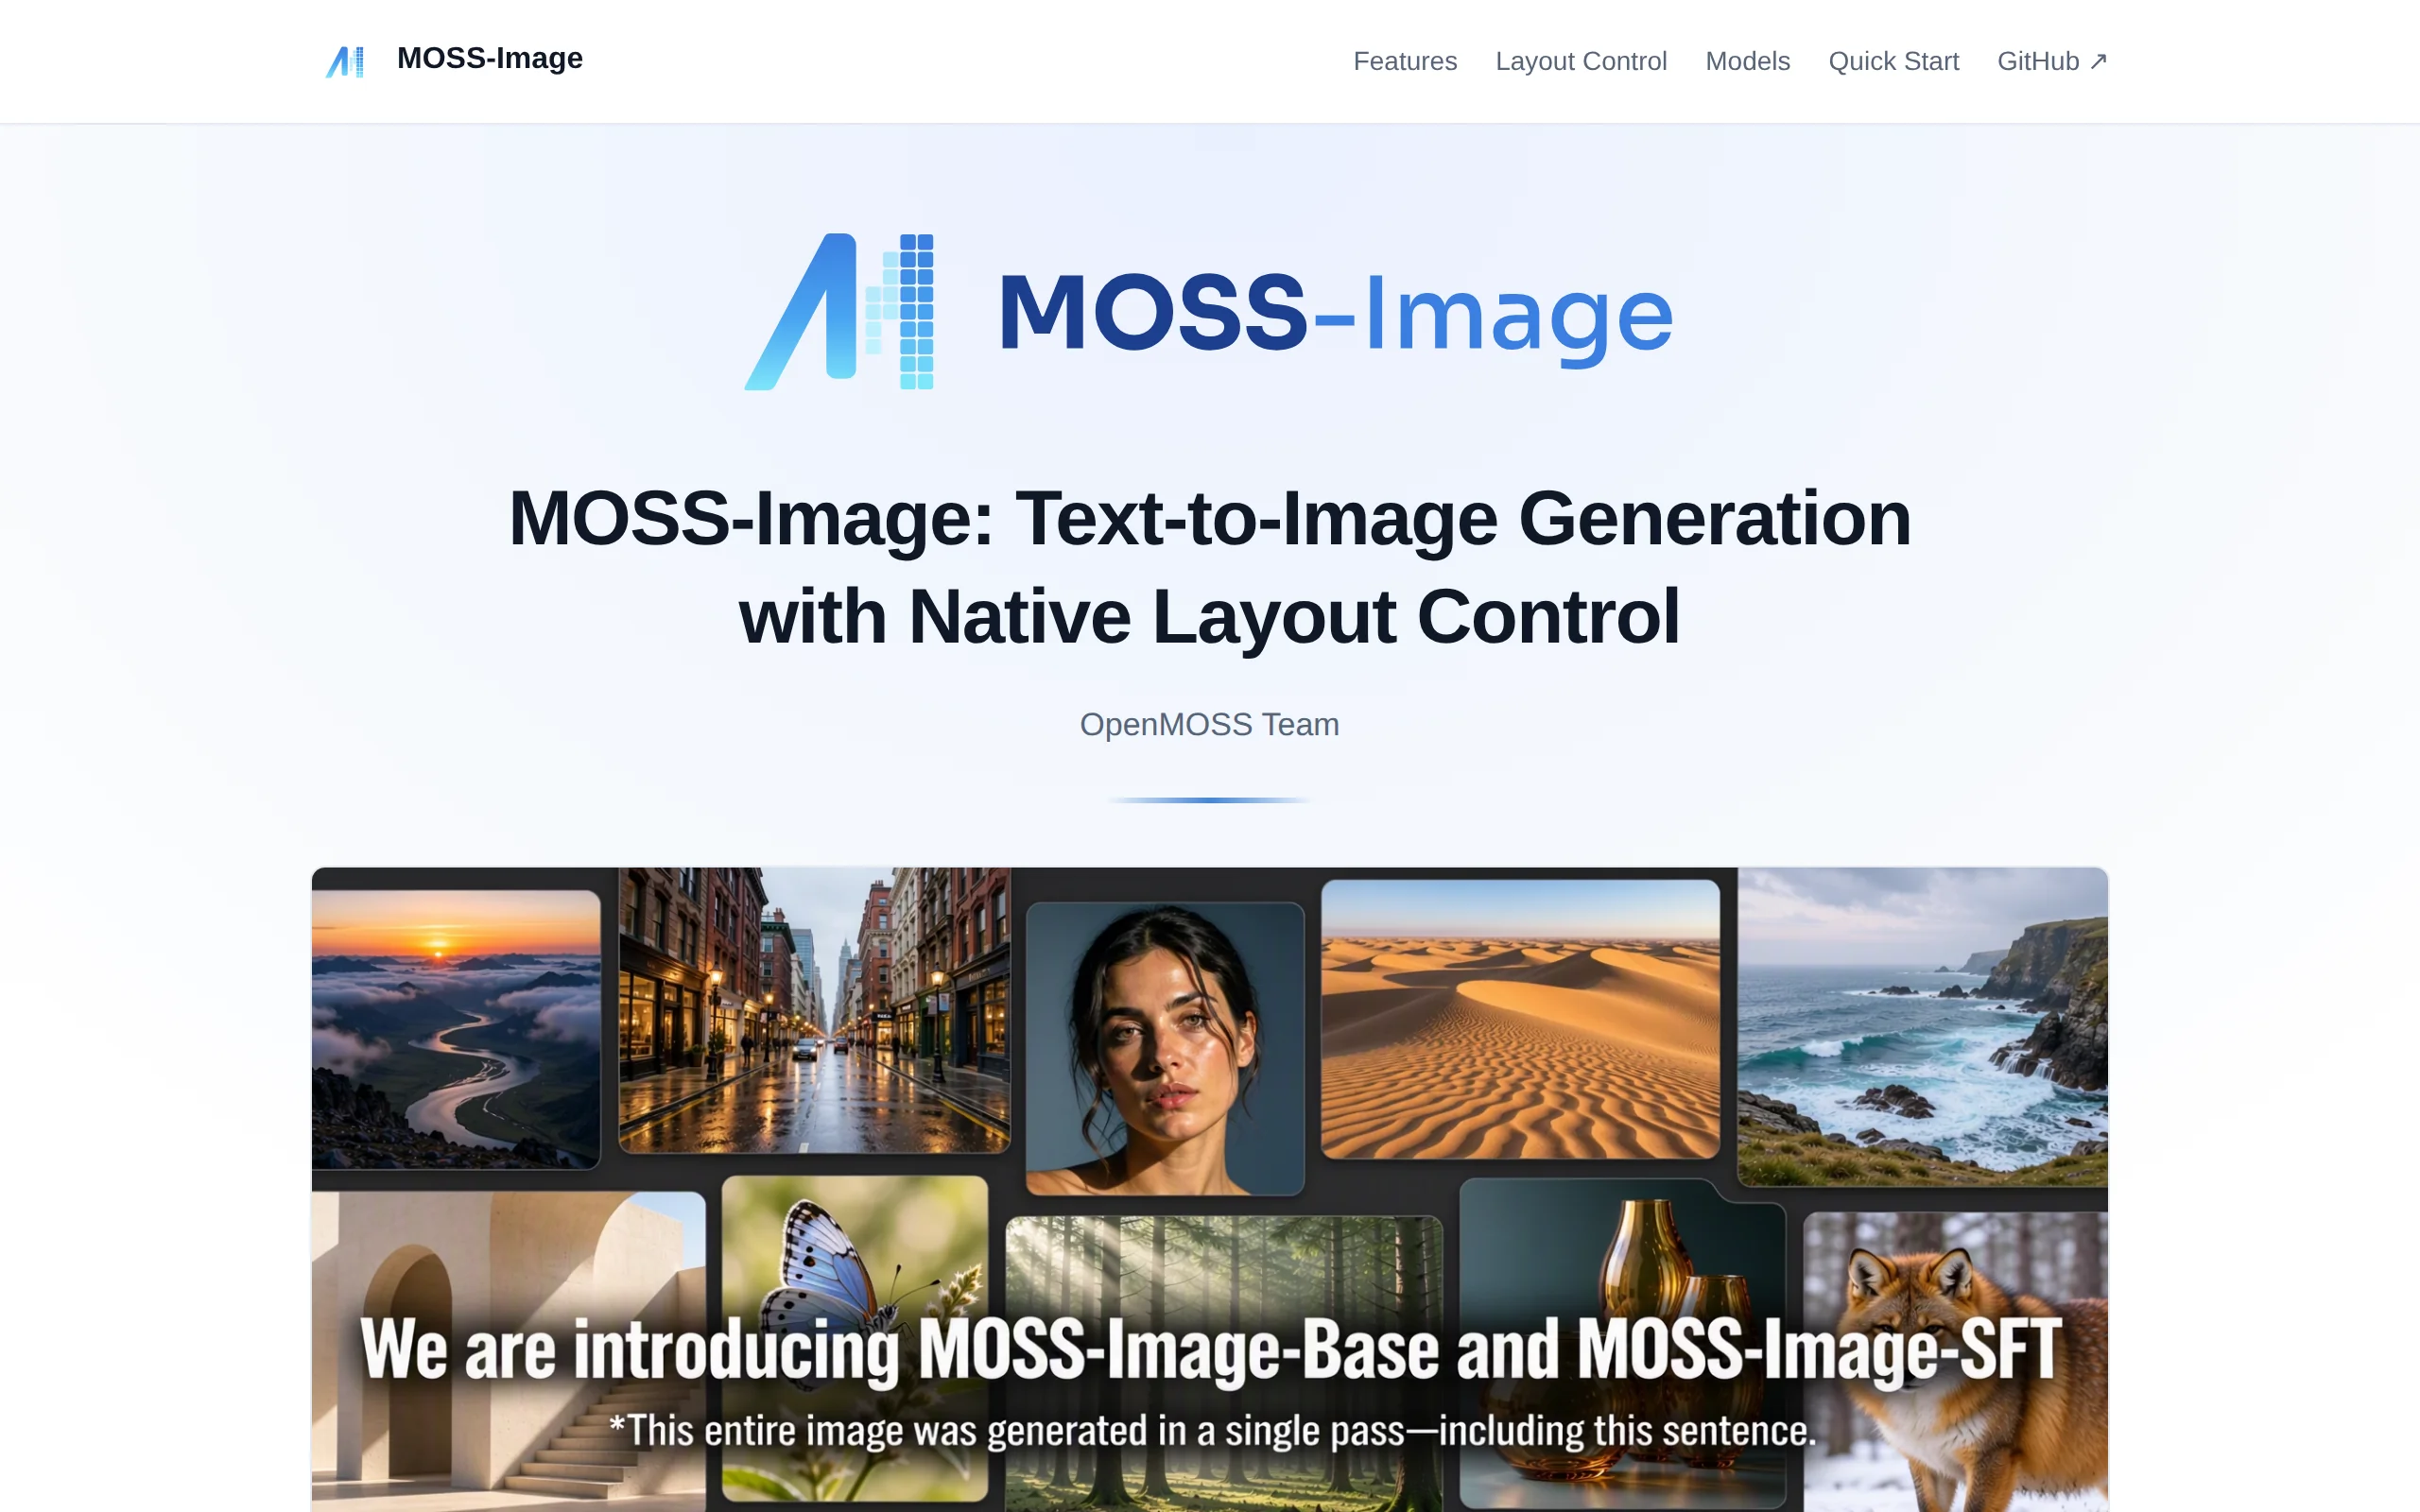
MOSS-Image是模思智能与OpenMOSS团队联合开源的文生图模型,其核心由5B参数的单流扩散Transformer(DiT)主干构成,配合冻结的Qwen3.5-9B文本编码器与FLUX.2 VAE,权重采用Apache-2.0协议发布。该模型在训练阶段剔除AI生成图像以降低"AI味",并针对中英文密集文本渲染、JSON Layout/Bounding Box结构化布局控制以及最长4096 ...
1. MOSS-Image是什么
MOSS-Image是模思智能与OpenMOSS团队联合开源的文生图模型,其核心由5B参数的单流扩散Transformer(DiT)主干构成,配合冻结的Qwen3.5-9B文本编码器与FLUX.2 VAE,权重采用Apache-2.0协议发布。该模型在训练阶段剔除AI生成图像以降低"AI味",并针对中英文密集文本渲染、JSON Layout/Bounding Box结构化布局控制以及最长4096 tokens的提示词支持进行了专项优化,整体面向可控设计类图像生成场景。
技术定位与领域: MOSS-Image属于扩散式文本生成图像(Text-to-Image)模型领域,专注于可控设计向的生成任务,即文字渲染、版面布局、物体空间关系的精确控制。该模型并非通用生成模型的简单复刻,而是将排版设计需求作为一等公民处理,在技术架构和训练策略上均有针对性调整。
研发背景: MOSS-Image由模思智能与OpenMOSS社区联合推出。OpenMOSS是活跃的开源大模型社区,此前在语言模型、多模态模型方向已有积累。此次推出文生图模型,是将其在文本理解方面的技术积累(Qwen3.5-9B作为文本编码器)与扩散生成技术相结合的产物,旨在为设计场景提供开源可控的生成方案。
核心价值: 该模型解决了开源文生图模型中常见的三个痛点:一是生成图像"AI味"明显的问题,通过训练数据剔除AI生成图来提升画面自然度;二是文字渲染能力弱的问题,在中英文密集文本场景下达到较高的文本覆盖率(LLTB Mean-6为96.3%);三是布局可控性差的问题,通过JSON Layout和Bounding Box实现结构化布局控制。
技术特点: 模型采用5B参数的DiT主干,在可控性和生成质量之间取得平衡;原生支持4096 tokens的长提示词输入,应对复杂多主体场景;Apache-2.0协议配合社区生态路径(Diffusers、ComfyUI、SGLang、vLLM-Omni),衍生出8步/4步加速、INT8/GGUF量化与多风格LoRA等丰富扩展。
2. 主要功能
自然语言文生图: 用户输入文本描述,模型可生成照片级写实、动漫、插画等多种风格的图像。该模型基于DiT主干在统一扩散框架中联合建模文本与图像潜变量,能够理解复杂的语义描述并转化为视觉呈现,其训练数据剔除了AI生成图像,使输出画面更接近真实摄影或人工创作的质感。
中英文文字渲染: 针对海报、电商图等设计场景中常见的密集文字排版需求进行了专项优化。模型能够生成包含中文和英文的文本内容,并尽量保留换行等排版结构,在LLTB基准的Mean-6文本覆盖率测试中达到96.3%,在参评开放权重模型中排名第一,有效解决了传统文生图模型中文字易扭曲、乱码的问题。
原生JSON Layout控制: 用户可通过JSON格式指定summary、items、text与bbox字段,显式约束标题、物体和文字在画面中的位置。坐标采用abs_centralized像素制、yxyx格式,使空间位置成为显式生成条件而非仅依赖自然语言的模糊暗示,在7Bench基准中目标定位mIoU达到0.88,布局AUC为0.70。
Bounding Box空间约束: 配合JSON Layout机制,模型支持对多个对象进行精确的边界框限定,适用于需要严格构图控制的场景。该机制将结构化提示词编译进生成过程,每个对象的位置、大小、层次关系均可通过数值坐标精确设定,极大提升了生成结果的构图一致性。
长Prompt支持: 最长支持4096 tokens的提示词输入,能够容纳多主体、空间关系、镜头语言与风格描述并存的复杂需求。同时提供Prompt Enhancer组件,可将创意描述扩展为详细caption或结构化Layout输入,帮助用户将复杂创意转化为模型可精确执行的指令。
多生态部署与量化加速: 提供Diffusers、Gradio、ComfyUI、SGLang、vLLM-Omni等多种使用路径。衍生生态包括8步/4步加速采样方案、INT8/GGUF/MLX量化方案以及多风格LoRA微调。12-24GB显存分层可用,低显存环境可通过分块推理或层卸载策略运行。
3. 如何使用
环境准备: 建议使用Python 3.10及以上版本,配备NVIDIA GPU(推荐显存12GB以上)。需安装与CUDA版本匹配的PyTorch,以及transformers、diffusers等基础库。显存低于12GB时,可结合INT8量化或4步加速方案运行。
拉取代码与环境配置: 执行
git clone https://github.com/OpenMOSS/MOSS-Image.git获取项目代码并进入目录。创建虚拟环境,激活后执行pip install -r requirements.txt安装项目依赖。ComfyUI用户可在ComfyUI Manager中搜索并安装MOSS-Image插件。加载模型权重: 使用Diffusers方式加载模型,关键代码为
custom_pipeline="pipeline_moss_image"和trust_remote_code=True,分别加载Base或SFT版本的权重。其中SFT权重偏向设计任务优化,Base权重偏向通用生成,两个版本均托管在HuggingFace的OpenMOSS-Team组织下。精度配置与推理参数: 建议DiT主干使用bfloat16精度、VAE使用float32精度,然后执行
pipe.to("cuda")迁移至GPU。普通生图设置num_inference_steps=50、guidance_scale=3.0作为起点。低显存环境下可尝试8步或4步加速,或开启分块推理与层卸载策略。布局生图流程: 将summary、items、bbox等字段按JSON格式组织,作为prompt传入。每个元素需按yxyx格式指定坐标(归一化至0-1范围),文本元素还需提供内容与字号信息。复杂创作需求可使用Prompt Enhancer先将想法扩展为结构化指令再输入。
4. 优缺点分析
| 优点 |
|---|
| 画面自然度高: 训练阶段剔除AI生成图像并标注水印、模糊等属性,输出画面弱化"AI味"与过度精致感,更接近真实拍摄或人工创作的效果。 |
| 文字渲染表现领先: 针对中英文密集文本与长文本排版专项优化,LLTB基准Mean-6文本覆盖率达96.3%,为参评开放权重模型第一,在菜单、海报等设计任务中表现突出。 |
| 结构化布局控制: 原生支持JSON Layout与Bounding Box,坐标精度高,在7Bench基准中目标定位mIoU达0.88、布局AUC为0.70,适合海报、电商图的精确构图需求。 |
| 长提示词处理能力: 支持4096 tokens条件输入,可同时容纳复杂主体关系、空间布局、镜头语言与风格描述,显著优于多数同类模型的上下文容量。 |
| 社区生态活跃: 5B主干参数规模适中,Apache-2.0协议放开权重使用限制,已衍生出8步/4步加速、INT8/GGUF量化、多风格LoRA等丰富的社区生态。 |
5. 同类工具对比
| 维度 | MOSS-Image | FLUX 3 Image Klein |
|---|---|---|
| 核心定位 | 可控设计向文生图,文字、排版、布局优先 | 通用高质量文生图基线,强调画质与风格 |
| 模型架构 | 5B DiT + Qwen3.5-9B文本编码器 + FLUX.2 VAE | 公开细节有限,Black Forest Labs未完整披露架构参数 |
| 文字渲染 | 中英文密集/长文本专项优化,LLTB Mean-6覆盖率达96.3% | 可用但设计排版类长文本通常需更多提示与工作流配合 |
| 布局控制 | 原生JSON Layout+Bounding Box结构化控制,目标定位mIoU 0.88 | 主要依赖自然语言描述与ControlNet类插件约束 |
| 长Prompt支持 | 最长4096 tokens,内置Prompt Enhancer扩展复杂指令 | 视版本与接口而定,长指令遵循能力非核心卖点 |
| 训练数据策略 | 剔除AI生成图像,降低"AI味",保留真实图像多样性 | 公开细节有限,社区关注其画质与成熟度 |
| 生态微调 | 5B主干、Apache-2.0,LoRA/量化/加速衍生快速 | 生态成熟、第三方工具丰富,可控设计需自行搭建 |
| 实时盲评表现 | RLA基准Elo 1698.7(短提示)/1807.3(增强提示) | 未公布与MOSS-Image相同的盲评对比数据 |
| 部署门槛 | 12-24GB显存分层可用,支持INT8/GGUF/MLX量化 | 轻量友好,完整高画质方案仍需较高显存 |
选型建议: 对于海报设计、电商主图、排版类设计任务,MOSS-Image在文字渲染、布局控制和长提示词支持方面具备针对性优势,且Apache-2.0协议允许商业使用与二次开发,适合有定制化需求的设计团队。FLUX 3 Image Klein适合追求通用画质上限、不依赖结构化布局控制的场景。ERNIE Image则适合深度绑定百度智能云生态、需要企业级服务保障的中文场景用户。
6. 编辑总结
MOSS-Image在开源文生图模型中有明确的差异化定位。从技术层面看,其架构沿用DiT + 强大文本编码器 + 先进VAE的主流组合,但在数据策略上选择了有别于同行的路径——剔除AI生成图像、强调真实图像多样性,这一取舍直接反映在输出画面的自然度上。从评测数据来看,其文字渲染能力在开放权重模型中表现突出(LLTB Mean-6达96.3%),布局控制的mIoU和AUC指标也验证了JSON Layout机制的实际有效性,在RLA盲评中已达部分商用模型的水平。
模型的实用性主要体现在设计场景:海报、电商图、社媒配图等需要文字、排版和空间控制的任务。5B参数规模在可控性与生成质量之间取得平衡,Apache-2.0协议则为商业应用扫清了授权障碍。对于设计师、电商运营、自媒体从业者等用户群体,该模型提供了可本地部署、可微调、可控性的生成方案。特别是其轻量易改的特性,使团队能够基于LoRA快速定制专属风格。
展望后续发展,MOSS-Image的社区生态正在快速成型,加速采样、量化、LoRA等衍生工具已初步到位。当前明显的短板在于图生图与编辑链路薄弱,复杂姿态处理仍有局限。若团队后续能在这些方向补齐能力,同时保持开源开放策略,该模型在可控生成细分领域的应用价值将进一步释放。
7. 应用场景
海报设计: 设计人员使用JSON Layout将标题、副标题、主视觉和辅助元素的位置坐标写入提示词,MOSS-Image依据结构化指令生成排版基本到位的宣传海报初稿。相比传统从空白画布起稿的工作流,可将前期构图时间压缩至数分钟,且文字部分直接以图像形式呈现,无需后续嵌字。
电商图制作: 商家将商品主体、价格标签、促销文案、背景区域通过Bounding Box分别限定,生成适合详情页和主图的营销视觉。模型对密集文字和真实感的优化,使生成的电商图更接近实拍质感,减少了人工PS合成的工作量。
社媒内容配图: 运营人员利用长Prompt支持特性,将品牌调性、内容主题、画面风格等要素压缩进4096 tokens的提示词,批量生成公众号封面、小红书笔记配图与广告创意素材。配合风格LoRA可维持视觉风格的一致性,适配多平台内容发布节奏。
动漫插画创作: 创作者引入多风格LoRA定制特定画风,使用自然语言描述人物动态、场景氛围与镜头语言,生成角色概念设定、场景原画和故事板草图。5B主干的可微调特性使创作者可以用少量作品集数据训练专属风格,形成差异化视觉语言。
中英文排版物料生成: 针对菜单、活动页、贴纸、包装说明等含密集文字的本地化设计任务,MOSS-Image的文字渲染与排版保持能力可生成多语言混合的成品级物料,文字清晰度和排版逻辑在同类开源模型中表现突出。
8. 常见问题FAQ
Q:MOSS-Image对显卡显存的最低要求是多少?如何降低显存占用?
A:官方推荐12GB以上显存可流畅运行。显存紧张时可选用INT8/GGUF/MLX量化版本降低权重占用量,或采用8步/4步加速采样减少计算压力。同时可开启模型分块推理与层卸载策略,在推理过程中动态加载部分层到显存。在上述方案配合下8GB显存设备也有可行性,但出图速度和分辨率上限会受影响。
Q:如何解决中文文字渲染偶尔出现的笔画错误问题?
A:中文字符笔画多、结构复杂,在特定字形或极小字号下可能出现细微笔画偏差。建议:确保提示词中的文字使用引号明确标注;适当增加文字区域在图像中的面积占比;提高num_inference_steps至50以上;对特别密集的文本可考虑分区块生成再拼接。如仍有个别字符出错,可对局部区域进行单次重绘修补。
Q:JSON Layout控制与自然语言描述的本质区别是什么?
A:自然语言描述是一种概率性的空间暗示(如"左侧"、"上方"),模型自行决定最终位置。JSON Layout将位置关系转化为确定性指令:用户以abs_centralized像素坐标和yxyx格式直接指定每个元素的精确位置和边界。这种结构化输入使生成过程必须遵守空间约束,实测7Bench中目标定位mIoU达0.88、布局AUC 0.70,适合对构图精度有硬性要求的设计任务。
Q:Base版本与SFT版本权重如何选择?
A:Base版本为通用基线权重,适应题材更广,适合探索性创作和风格定制微调。SFT版本针对设计任务进行了有监督微调,在文字准确率、布局遵循度和设计审美上更优,推荐海报、电商等直接设计出图场景优先选择SFT版本。若需进行LoRA风格训练,建议从Base版本出发以获得更大风格自由度。
Q:MOSS-Image在ComfyUI中如何使用?有哪些注意事项?
A:在ComfyUI Manager的插件市场中搜索"MOSS-Image"并一键安装,随后加载项目仓库提供的示例工作流即可。运行时需注意:若存在多个扩散模型,需在节点中明确选择MOSS-Image的权重路径;首次运行需下载模型文件;layout控制需要安装额外的JSON解析节点。低显存环境下可在工作流中加入分块推理节点,并配合量化权重版本使用。
Q:Apache-2.0协议允许将MOSS-Image用于商业项目吗?
A:允许。Apache-2.0许可证明确授予商业使用、修改、分发和专利授权权利,仅要求保留版权声明和许可证副本。这意味着生成的图片可用于商业设计项目,修改后的模型代码也可在遵守协议前提下内部使用或对外分发。相比部分仅限研究用途的模型权重,该协议对商业应用较为友好。
9. 项目地址
- 项目官网: https://openmoss.ai/MOSS-Image/
- GitHub仓库: https://github.com/OpenMOSS/MOSS-Image
- 技术论文: https://github.com/OpenMOSS/MOSS-Image/blob/main/paper/MOSS_Image_Technical_Report.pdf
- HuggingFace模型库 - SFT版本: https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT
- HuggingFace模型库 - Base版本: https://huggingface.co/OpenMOSS-Team/MOSS-Image-Base
相关推荐

FLUX 3 Max – fal 与 Black Forest Labs 推出的视频生成模型深度评测
FLUX 3 Max 是由 fal Research 与 Black Forest Labs 联合推出的后训练视频生成模型,基于 BFL 自研的 FLUX 3 多模态基础模型,支持文生视频、图生视频与关键帧插值三种工作流,可生成 5–20 秒、最高 1080p 分辨率且自带原生音频的视频内容。该模型主打极致推理速度与成本效率,10 秒成片约 12 秒完成生成,官方宣称在同画质条件下比 Seedan...
FLUX 3 Image Klein – Black Forest Labs 开源的AI图像模型
FLUX 3 Image Klein 是由 Black Forest Labs 开源的 AI 图像生成模型,以仅 5.6B 参数的轻量级体量实现了此前需要数十亿参数乃至闭源大模型才能达成的能力。该模型同时支持文生图、指令式图编辑以及最多 10 张参考图的多图生成,具备原生 4K 输出、像素级精确编辑和坐标框布局控制等差异化功能。官方内部盲测显示,其在中文生图、编辑、多参考三项任务中均排名第一,超越...
DMAD – 字节联合德州农工开源的扩散模型少步蒸馏技术
DMAD(Distribution Matching as Adversarial Distillation)是由字节跳动与德州农工大学联合开源的少步蒸馏框架,核心目标是显著加速扩散模型的生成过程。该方法通过训练二分类判别器直接学习目标分布与学生分布之间的差异,省去传统蒸馏方法中辅助扩散模型的依赖,在ImageNet-64数据集上实现了FID低至1.04的一步生成效果,并将50步教师模型高效压缩为...
ArtCraft 深度评测:开源AI图像视频创作工作台,以“可控性前置”重塑创作流程
ArtCraft 是一款开源的 AI 图像与视频创作工作台,其核心设计理念是将“可控性前置”,即在生成最终画面之前,通过三维空间布局、角色摆姿和场景搭建等手段,彻底解决传统 AI 绘画工具“出图不可控、角色场景不一致”的行业痛点。它允许创作者将虚拟演员固定于真实环境照片中,无论镜头如何调度,人物位置始终保持一致;同时支持在 3D 空间内拼贴素材、使用 3D 人偶精确控制姿势与机位。此外,ArtCr...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。