
PawBench – 阿里通义推出的通用智能体评测基准

导读摘要:
PawBench是通义实验室推出的通用智能体评测基准,面向个人助理与Agent场景,将底座模型与运行框架(Harness)纳入同一评测体系。PawBench v1.0构建了150道真实任务、4050个测试单元的评测集,通过9个模型×3个Harness的交叉评测,能够评估模型+Harness的最佳组合,帮助Harness开发者精准定位问题并验证优化效果,为Agent系统的协同进化提供了可量化、可复现...
1. PawBench是什么
PawBench是通义实验室推出的通用智能体评测基准,面向个人助理与Agent场景,将底座模型与运行框架(Harness)纳入同一评测体系。PawBench v1.0构建了150道真实任务、4050个测试单元的评测集,通过9个模型×3个Harness的交叉评测,能够评估模型+Harness的最佳组合,帮助Harness开发者精准定位问题并验证优化效果,为Agent系统的协同进化提供了可量化、可复现的技术基准。
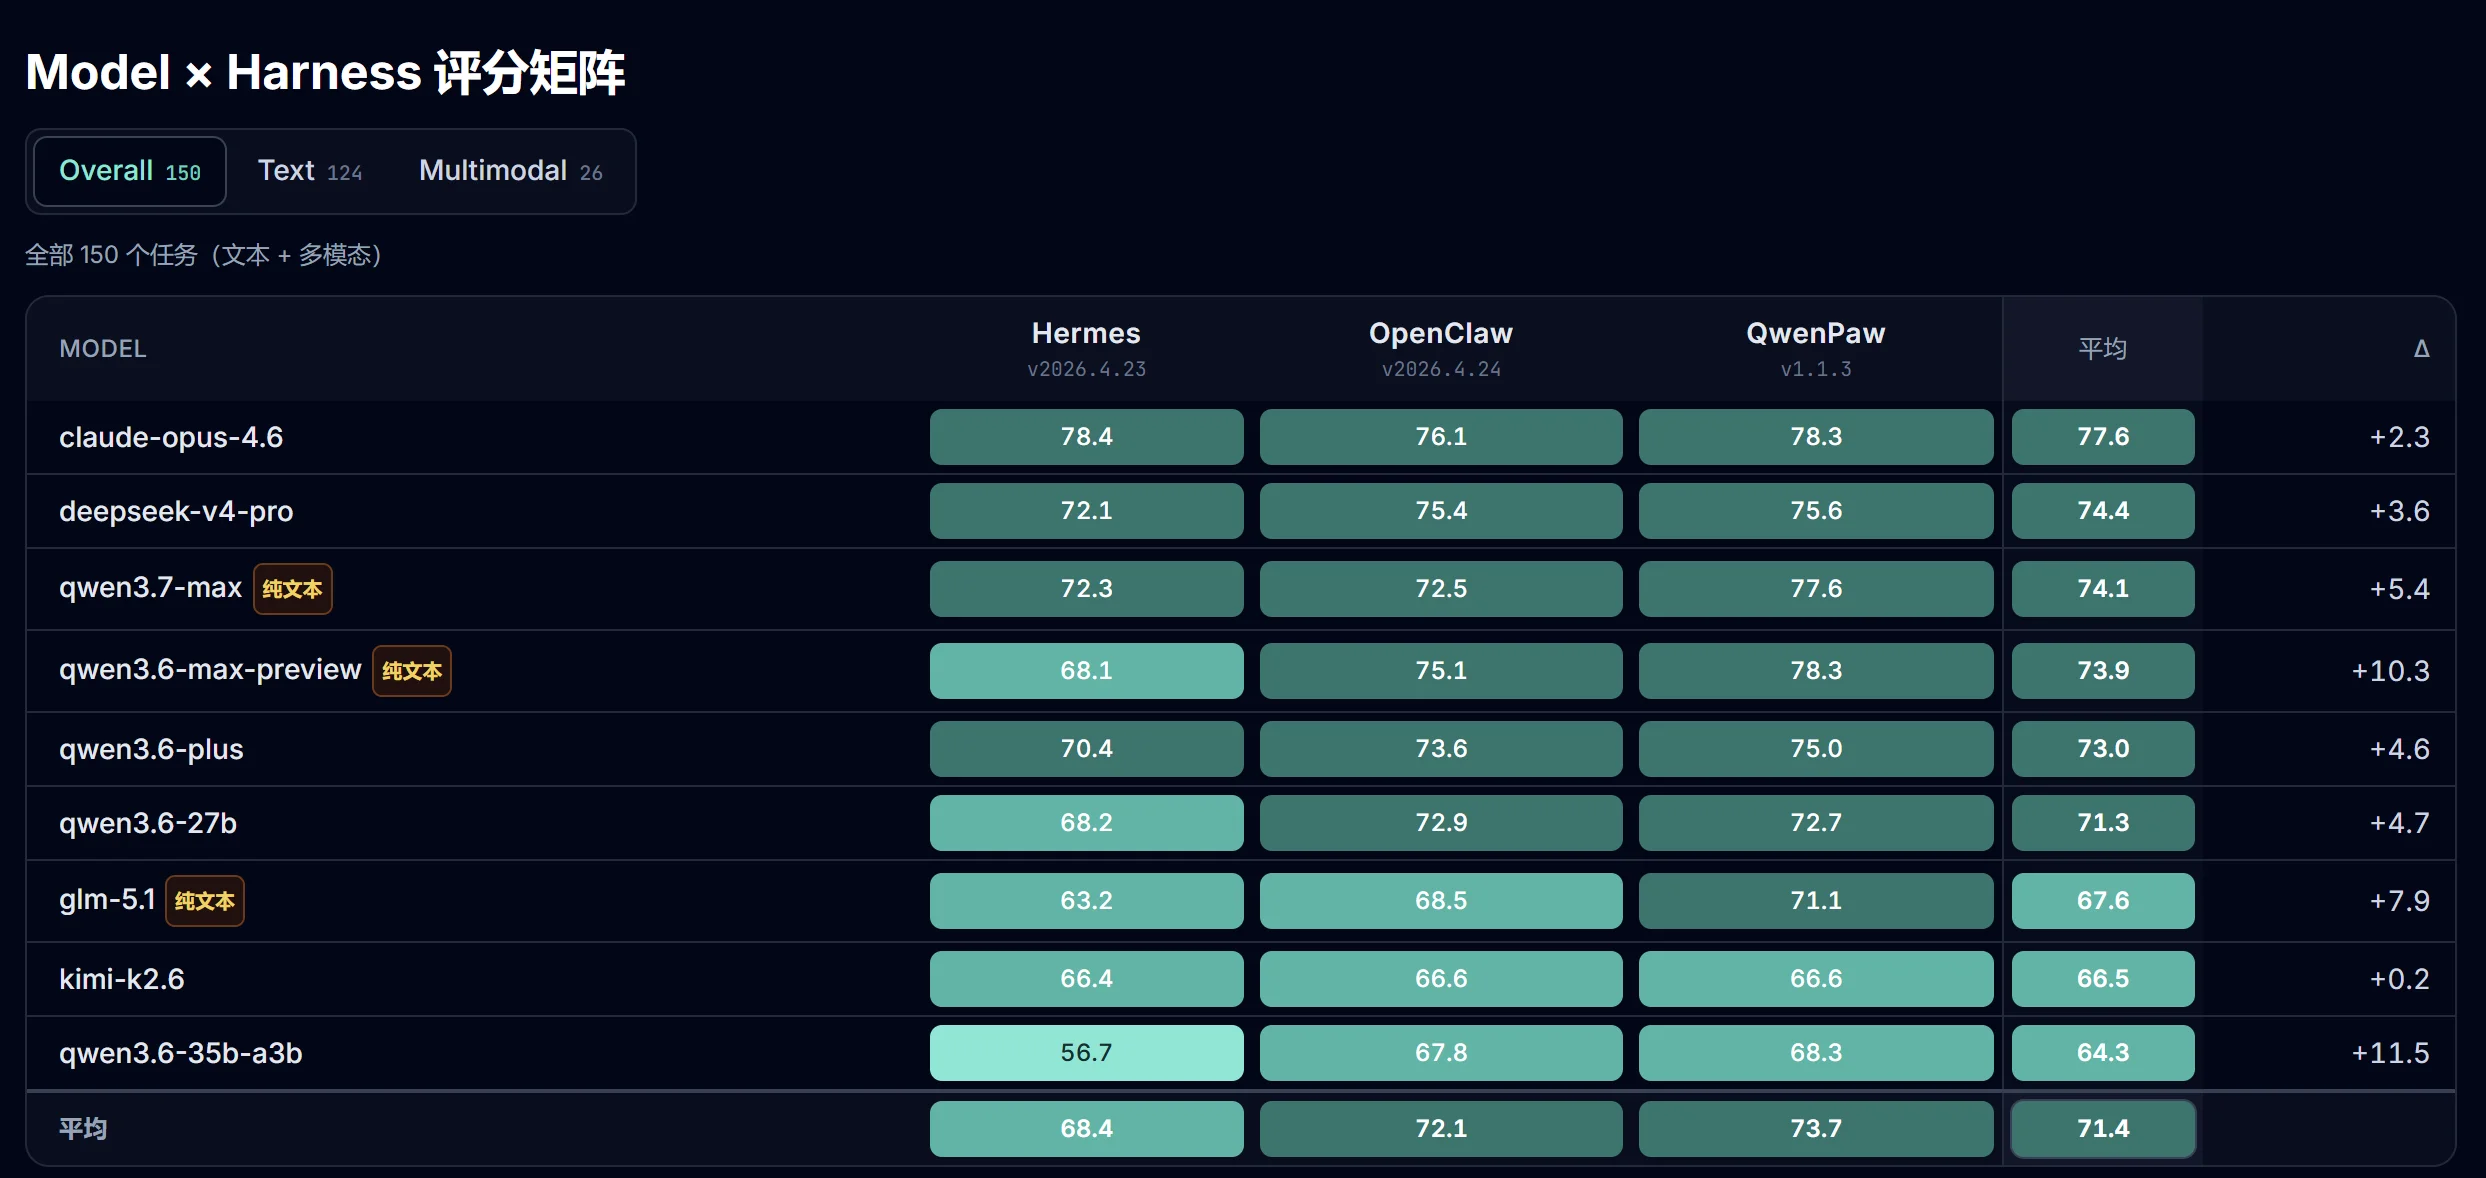
技术定位与领域: PawBench属于AI评测与基准测试领域,其独特之处在于打破了传统评测仅关注模型本身能力的局限,首次将运行框架(Harness)纳入评测体系,实现了对“智能体系统整体性能”的量化评估,填补了当前Agent评测中模型与框架协同评估的空白。
研发背景: 由阿里通义实验室开发,团队在自然语言处理、大模型训练及Agent系统构建方面拥有深厚的技术积累。研发动机源于当前Agent系统快速发展中,模型能力与框架能力难以分离评估的行业痛点——传统评测无法区分任务失败是源于模型推理错误还是框架实现缺陷,PawBench正是为解决这一系统性评估难题而设计。
核心价值: PawBench解决了Agent系统评测中的“归因困境”——当任务失败时,开发者无法快速判断是模型能力不足还是框架配置有误。通过构建交叉评测矩阵和五维标签体系,PawBench能够量化Harness对任务成功率的影响(最高6.4分差距),帮助开发者精准定位框架在Skill加载、路径感知、工具配置等方面的具体缺陷,从而指导优化方向。
技术特点: PawBench采用Docker沙箱隔离执行环境,确保每个测试单元的可复现性与问题可追溯性;引入混合评分机制,结合确定性规则断言与LLM-as-judge语义评估,平衡了评测的客观性与灵活性;其五维标签体系支持多维度切片下钻分析,使Harness开发者能够从场景、能力、复杂度、模态、环境等多个维度深入诊断问题。
2. 主要功能
联合评测: 将底座模型与运行框架(Harness)纳入同一评测体系,评估LLM×Harness的联合效果。通过9个模型与3个Harness的交叉组合,PawBench能够量化Harness对整体性能的贡献,首次证明了Harness差距(最高6.4分)堪比一次重大模型版本升级,为小模型反超提供了可行路径。
真实任务集: 构建150道真实任务、4050个测试单元的评测集,从6个高质量Agent评测集(如GAIA、WebArena等)中抽取并聚合。这些任务覆盖办公协同、软件工程、自动化脚本、Web搜索、Skill调用等典型Agent场景,确保评测结果具有实际参考价值。
五维标签体系: 每道题按应用场景、原子能力、复杂度(L1-L3)、输入模态、运行环境进行结构化标注。这一体系支持多维度切片下钻分析,使开发者能够从任意维度切入,精准定位Harness在特定场景下的行为缺陷。
混合评分机制: 结合自动评分器(规则断言)与LLM-as-judge(语义质量评估),分数范围0到1。规则断言负责检查文件存在性、字段匹配、exit code等硬性指标,LLM-as-judge评估输出内容的语义质量,两者加权后给出最终分数,平衡了评测的客观性与灵活性。
多切片榜单: 支持Overall(150题)、Text(124题)、Multimodal(26题)三个维度自由切换查看。这种设计使开发者能够根据自身需求选择关注点——纯文本任务开发者可聚焦Text榜单,多模态任务开发者可关注Multimodal榜单。
全量轨迹保留: 所有任务在Docker沙箱中运行,执行轨迹、grader产物和环境快照完整保存。这一功能确保了失败案例可逐层回溯复盘,开发者可以精确查看每一步的执行日志和中间产物,定位问题根因。
深度诊断分析: 支持按模型规模、模态、任务类型、技能领域等维度切片,定位Harness具体行为缺陷。例如,开发者可以快速发现Harness在“Skill加载”场景下的路径感知问题,或在“Web搜索”场景下的工具默认配置缺陷。
3. 如何使用
环境准备与前置条件: 使用PawBench前,需要准备一台安装了Docker的运行环境(推荐Linux系统,支持macOS和Windows的Docker Desktop)。同时,需要获取至少一个待测模型的API密钥(如通义千问、GPT-4等),以及配置Harness运行环境所需的依赖项(如Python 3.8+、Node.js等)。
克隆源码: 访问GitHub仓库
agentscope-ai/PawBench,使用git clone https://github.com/agentscope-ai/PawBench.git命令克隆评测框架。克隆完成后,进入项目目录并安装所需的Python依赖包(通过pip install -r requirements.txt完成)。配置环境与API密钥: 在项目根目录创建
.env文件,写入待测模型的API密钥(如OPENAI_API_KEY=sk-xxx)。同时,根据使用的Harness类型,配置对应的运行环境变量,包括模型端点、超参数设置等。PawBench支持多种Harness,包括AgentScope、AutoGPT等。选择任务切片并运行评测: 使用命令行工具选择评测任务切片。例如,运行纯文本任务切片可使用
python run_benchmark.py --slicing text,运行多模态任务切片使用python run_benchmark.py --slicing multimodal,全量任务使用python run_benchmark.py --all。在Docker沙箱中执行任务时,系统会自动保留执行轨迹与产物。查看评分与诊断报告: 评测完成后,系统会生成详细的评分报告,包括每道题的自动评分器分数、LLM-as-judge分数以及加权总分。通过
python report.py --output report.html命令可生成HTML格式的诊断报告,支持按维度切片查看Harness的具体行为缺陷。提交结果与排名: 访问PawBench官网
agentscope-ai.github.io/PawBench,按照页面指引提交评测结果。提交后,系统会更新榜单排名,支持Overall、Text、Multimodal三个维度的自由切换查看。
注意事项: 首次使用时建议运行默认配置(不追求“配齐所有API Key的理论上限”),以还原开发者首次clone后的默认体验。在多次评测中,建议保持模型和Harness版本不变,确保结果的可比性。Docker沙箱运行期间,请确保磁盘空间充足(每个测试单元约需500MB临时存储空间)。
4. 优缺点分析
| 优点 |
|---|
| 联合评测能力: 将模型与Harness纳入同一评测体系,首次量化了Harness对任务成功率的贡献(最高6.4分差距),为Harness开发者提供了明确的优化方向。 |
| 真实复现性: 基于Docker沙箱运行,执行轨迹与环境快照完整保留,失败案例可逐层回溯复盘,确保评测结果的可复现性与可追溯性。 |
| 零门槛开箱评测: 还原开发者首次clone后的默认体验,不追求“配齐所有API Key的理论上限”,降低了使用门槛。 |
| 深度诊断分析: 支持按模型规模、模态、任务类型、技能领域等多维度切片分析,帮助Harness开发者精准定位框架在Skill加载、路径感知、工具配置等方面的具体行为缺陷。 |
| 持续回归验证: Harness每次修复后可重新切片跑分,验证优化是否真实对应到问题维度,支持迭代式开发流程。 |
5. 同类工具对比
| 对比维度 | PawBench | SWE-bench | GAIA |
|---|---|---|---|
| 核心定位 | 评测“模型+Harness”联合效果 | 评测模型解决真实代码问题的能力 | 评测模型解决通用AI助手任务的能力 |
| Harness/框架评估 | ✅ 核心能力,明确隔离框架贡献 | ❌ 否,仅评估模型本身 | ❌ 否,仅评估模型本身 |
| 任务来源 | 6个Agent评测集聚合(150道) | 真实GitHub Issue/PR(2000+) | 人类设计的真实任务(165道) |
| 典型任务 | 办公协同、软件工程、自动化脚本、Web搜索、Skill调用 | 代码Bug修复、功能实现、测试通过 | 多步骤推理、信息检索、工具使用 |
| 评分机制 | 自动规则断言+LLM-as-judge混合 | 单元测试通过/失败(二元) | 人工评分+自动检查 |
| 环境隔离 | Docker沙箱+工作区产物校验 | 代码沙箱+Git仓库快照 | 无严格环境隔离 |
| 任务标签体系 | 五维标签(场景/能力/复杂度/模态/环境) | 按编程语言/仓库切片 | 按任务类型/难度分级 |
| 榜单维度 | Overall/Text/Multimodal三切片 | 按Verified/Multimodal/Full分榜 | 按难度(L1-L3)分榜 |
| 失败诊断能力 | 保留执行轨迹、产物快照、环境状态,支持逐层回溯 | 保留代码补丁与测试日志 | 保留人工评分记录 |
| 零配置评测 | 还原首次clone后的默认体验 | 需配置代码仓库环境 | 需配置API密钥 |
| 最佳适用场景 | Harness开发者优化、模型+框架选型 | 代码模型能力评估、编程助手研发 | 通用AI助手能力评估 |
选型建议:
对于从事Harness开发或Agent系统集成的团队,PawBench是首选工具。其联合评测能力能够帮助开发者量化Harness对整体性能的贡献,精准定位框架层面的行为缺陷。相比之下,SWE-bench和GAIA仅关注模型本身能力,无法区分任务失败源于模型还是框架。在模型选型场景中,PawBench的多切片榜单(Text/Multimodal)能够帮助用户根据具体任务类型选择最佳模型+Harness组合,实用性显著优于仅提供单一榜单的竞品。
对于专注于代码生成模型评估的研究人员,SWE-bench的2000+真实GitHub Issue任务提供了更丰富的代码场景,但缺乏对Agent框架的评估能力。对于通用AI助手能力评估,GAIA的165道人类设计任务在任务质量上表现优异,但任务数量有限且缺乏环境隔离机制。AgentBench在多环境模拟方面具有优势,但其评分机制相对简单,且同样不涉及Harness评估。综合来看,PawBench在Harness评估、失败诊断和零配置体验三个维度上具有明显差异化优势。
6. 编辑点评
PawBench在技术创新性方面表现突出,其核心创新在于将模型与Harness纳入同一评测体系,首次量化了框架对智能体系统整体性能的贡献。这一设计思路切中了当前Agent系统发展中的关键瓶颈——开发者难以区分任务失败是源于模型推理错误还是框架实现缺陷。通过构建9个模型×3个Harness的交叉评测矩阵,PawBench能够通过控制变量法隔离模型能力与框架能力的贡献,这种方法论在AI评测领域具有开创性意义。
在实用价值方面,PawBench的深度诊断分析能力尤为突出。其五维标签体系支持从应用场景、原子能力、复杂度、输入模态、运行环境等多个维度进行切片分析,使Harness开发者能够快速定位框架在Skill加载、路径感知、Web工具默认可用性等方面的具体缺陷。这种“诊断而非简单打分”的设计理念,使PawBench成为Harness开发者的实用工具,而非仅仅是一个排名榜单。此外,Docker沙箱隔离和全量轨迹保留机制确保了评测结果的可复现性,这对于学术研究和工业应用都具有重要价值。
从适用人群来看,PawBench主要面向三类用户:一是Harness开发者,通过切片分析定位框架行为缺陷;二是模型选型决策者,根据具体任务类型选择最佳模型+Harness组合;三是Agent系统研究人员,利用交叉评测矩阵探索模型与框架协同进化的规律。对于普通应用开发者,PawBench的零门槛开箱评测设计降低了使用门槛,但深度使用仍需一定的技术背景。
未来发展潜力方面,PawBench有望成为Agent系统评测的标准工具。随着Agent系统的快速发展,模型与框架的协同优化将成为关键竞争维度,PawBench率先提供了这一维度的评测能力。未来若能扩展任务覆盖范围(如医疗、金融等专业领域),并支持更多新兴Harness(如LangChain Agent、CrewAI等),其行业影响力将进一步扩大。
7. 应用场景
Harness开发者优化: 通过切片分析定位框架在Skill加载、路径感知、Web工具默认可用性等方面的具体缺陷。例如,开发者可以使用五维标签体系中的“原子能力”维度,快速发现Harness在“文件操作”场景下的路径解析错误,从而针对性优化。
模型选型参考: 帮助用户根据纯文本/多模态/Skill/Web搜索等任务类型选择最佳模型+Harness组合。例如,在多模态任务场景下,PawBench的Multimodal榜单可以显示哪组模型+Harness组合在图像理解任务上表现最优,为技术选型提供数据支撑。
基准回归测试: Harness迭代修复后重新跑分,验证优化是否真实解决对应切片问题。例如,Harness开发者在修复了“Skill加载”路径感知问题后,可以重新运行PawBench的Skill相关任务切片,验证优化效果是否达到预期。
学术研究: 为通用智能体研究提供可复现的交叉评测基准,推动模型与框架协同进化。研究人员可以利用PawBench的交叉评测矩阵,探索不同模型架构与框架设计的协同效应,为Agent系统的设计提供理论指导。
Agent系统集成测试: 在部署Agent系统前,使用PawBench对模型+Harness组合进行端到端测试,确保系统在办公协同、软件工程、自动化脚本等典型场景下的稳定性和可靠性。
8. 常见问题FAQ
Q:PawBench与传统的AI模型评测基准(如MMLU、HellaSwag)有何不同?
A:传统评测基准仅评估模型本身的推理能力,而PawBench将运行框架(Harness)纳入评测体系,评估“模型+Harness”的联合效果。这意味着PawBench能够量化框架对任务成功率的影响,帮助开发者区分任务失败是源于模型能力不足还是框架实现缺陷。
Q:如何向PawBench提交评测结果?
A:首先在本地运行PawBench评测框架,生成包含评分和诊断信息的报告文件。然后访问PawBench官网 agentscope-ai.github.io/PawBench,按照页面指引上传报告文件。提交后,系统会更新榜单排名,支持Overall、Text、Multimodal三个维度的自由切换查看。
Q:PawBench的任务集是否支持扩展?
A:当前v1.0版本的任务集是固定的150道任务,但PawBench的框架设计支持任务扩展。开发者可以按照项目文档中的指导,自定义添加新的评测任务,并为其配置五维标签。扩展后的任务集可以本地运行,但无法直接提交到官方榜单。
Q:PawBench的评分机制如何平衡客观性与灵活性?
A:PawBench采用混合评分机制:自动评分器(规则断言)负责检查文件存在性、字段匹配、exit code等硬性指标,确保评分客观性;LLM-as-judge负责评估输出内容的语义质量,提升评分灵活性。两者加权后给出最终分数(范围0到1),权重可根据任务类型动态调整。
Q:运行PawBench是否需要高性能GPU?
A:不需要。PawBench的评测框架本身不要求GPU,它通过API调用待测模型(如通义千问、GPT-4等),模型推理在云端完成。本地环境仅需运行Harness和Docker沙箱,推荐配置为8GB内存、50GB磁盘空间。
Q:PawBench支持哪些Harness?
A:当前v1.0版本支持3个主流Harness:AgentScope(阿里自研)、AutoGPT(开源)和BabyAGI(开源)。后续版本计划扩展支持LangChain Agent、CrewAI等新兴框架。
Q:PawBench的“零配置评测”具体指什么?
A:指还原开发者首次clone后的默认体验——不要求用户配置所有API Key,不要求用户调整复杂的超参数。用户只需克隆源码、配置一个API Key即可运行默认评测,降低了使用门槛。
9. 项目地址
相关推荐
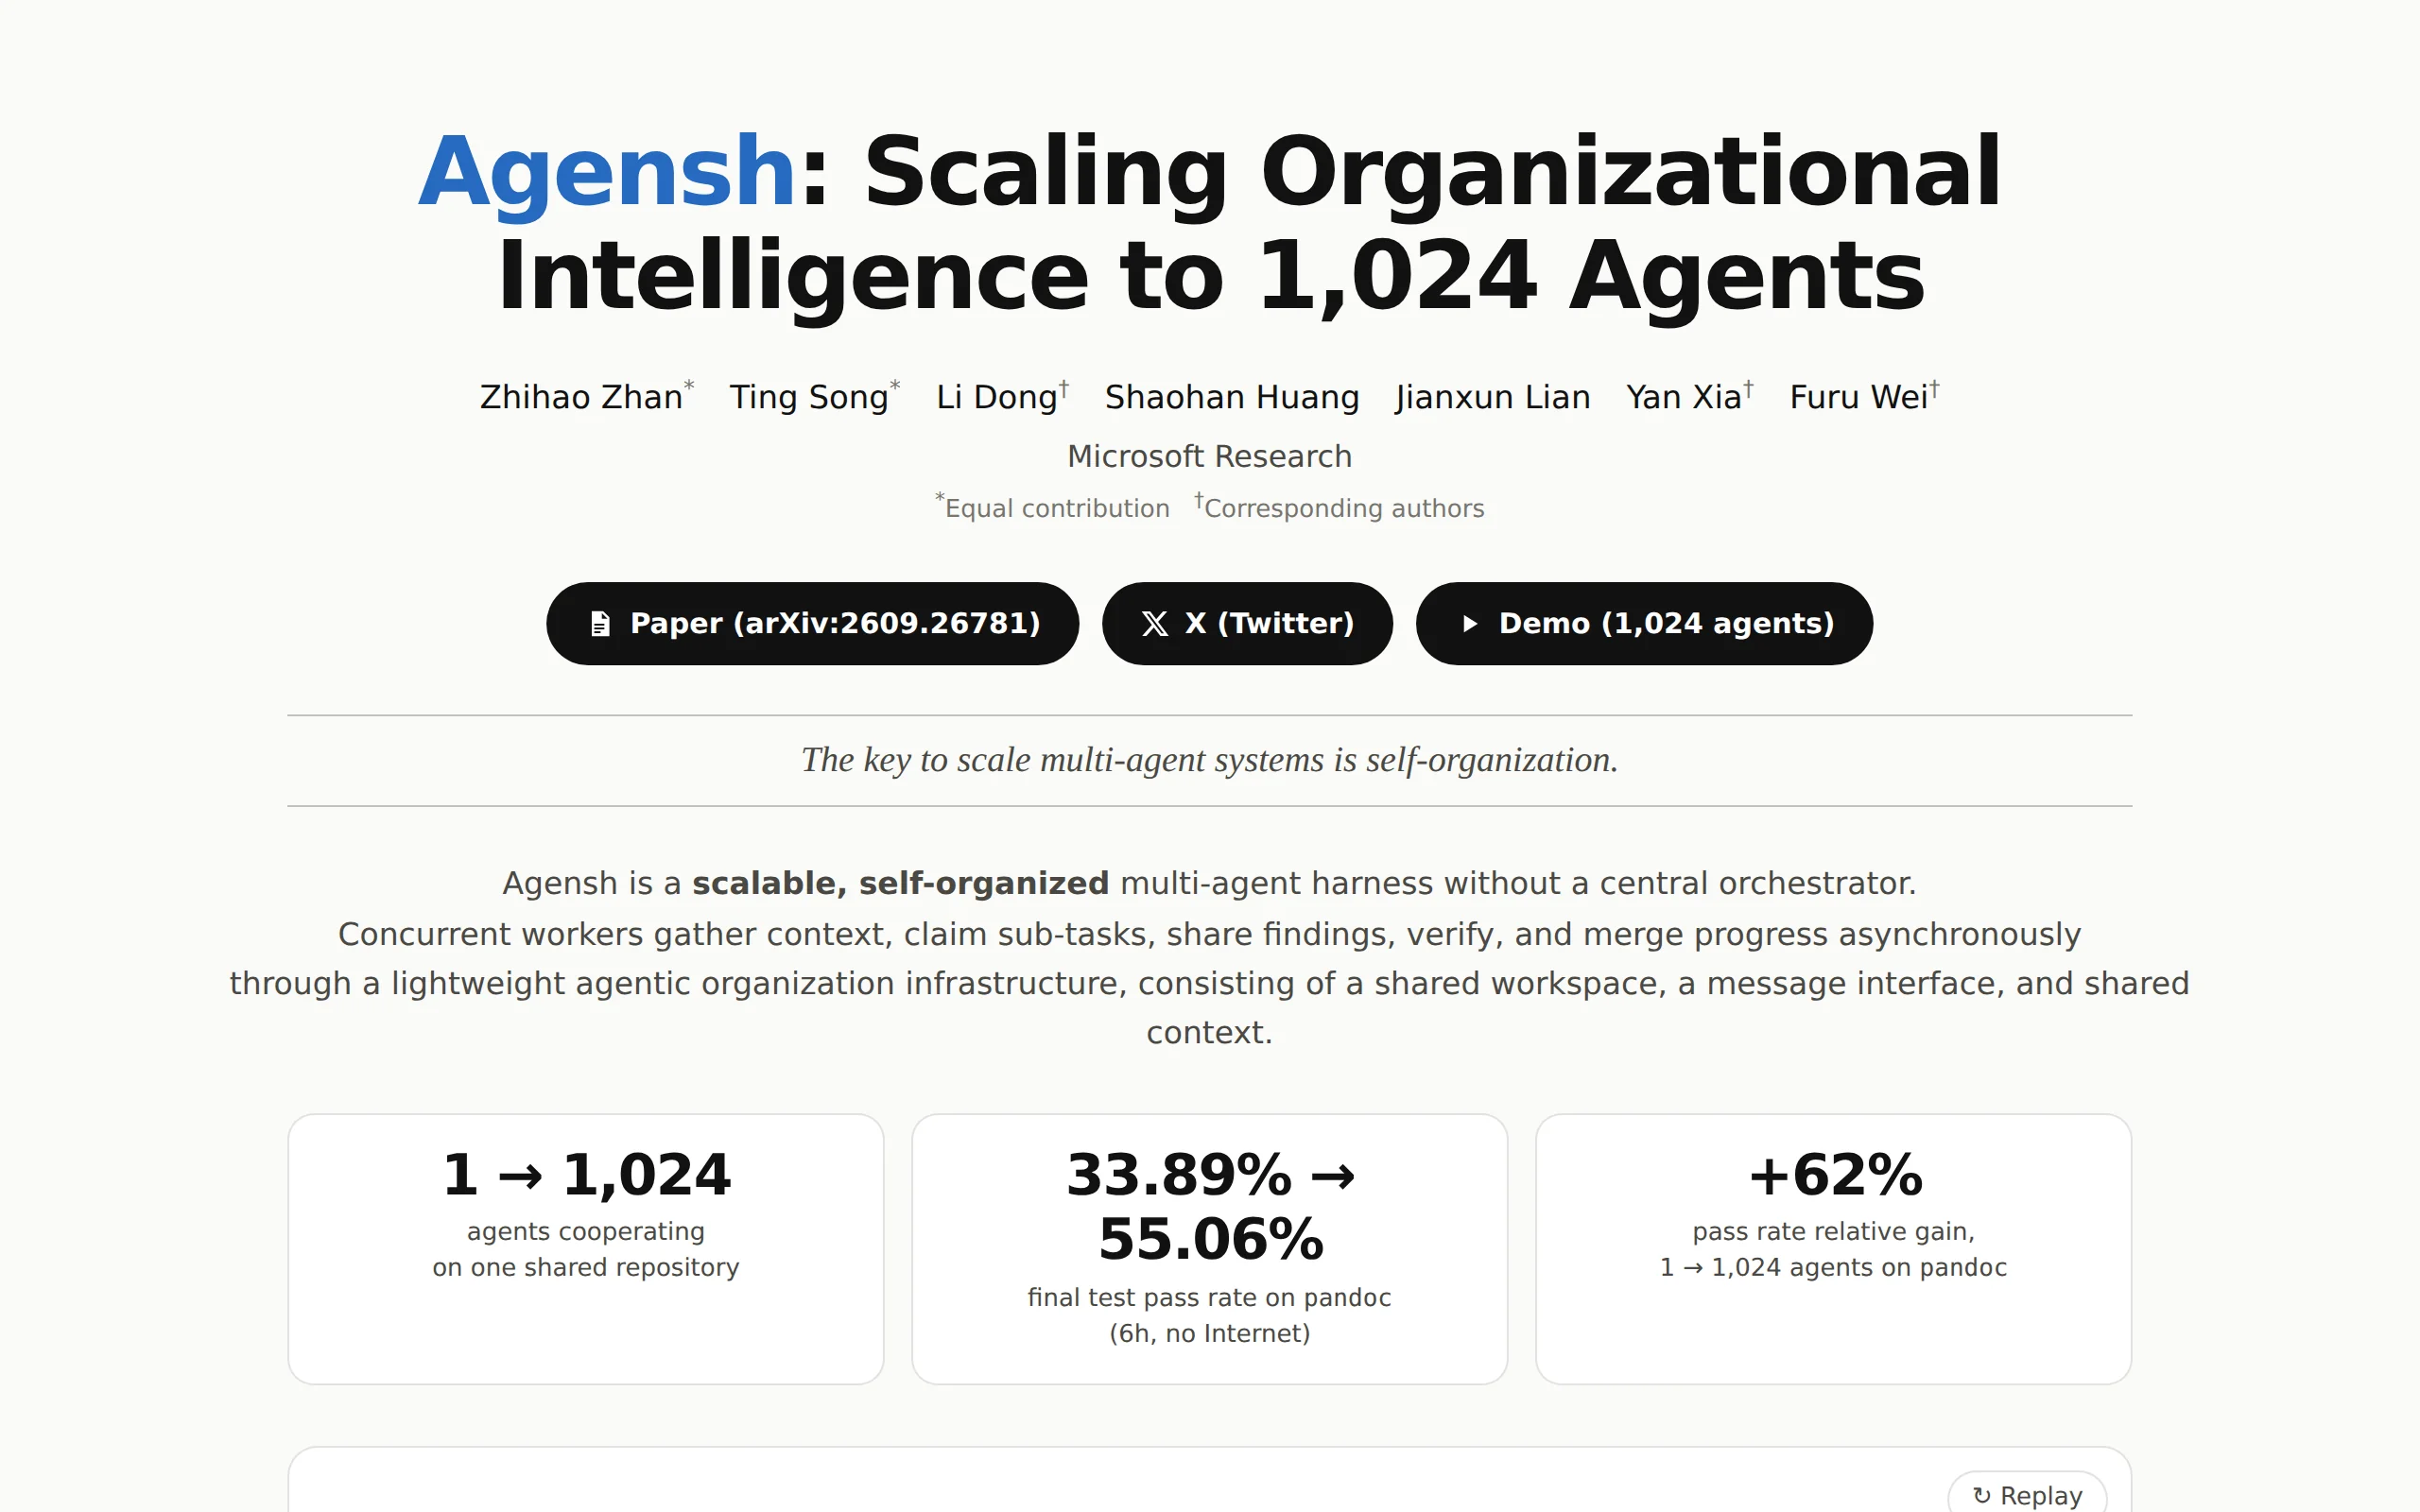
Agensh – 微软研究院推出的多智能体协作框架
Agensh是微软研究院推出的多智能体协作框架,其核心创新在于完全去中心化的组织架构——所有智能体遵循统一的五步协作循环,通过共享代码仓库、即时消息和结构化看板实现自组织分工,彻底移除传统架构中的主管智能体。实验数据显示,在底层模型完全不变的前提下,将智能体数量从1个扩展至1024个,软件复现测试通过率从33.89%提升至55.06%,提升幅度约49%。这一结果论证了智能体数量本身可以成为独立于模...
Eleven Realtime:ElevenLabs 一体化语音 Agent 模型的架构突破与工程实践
Eleven Realtime 是 ElevenLabs 推出的一体化语音 Agent 模型系列,包含 v1 Mini 与 v1 Max 两个版本,核心设计思想是将语音识别(ASR)、语言模型推理、工具调用与语音合成(TTS)整合进单一模型,替代传统方案中多组件串联的复杂架构。该系列支持 90 多种语言,并可调用 ElevenLabs 声音库中 17,000 余种音色,v1 Max 在保持 98....
Xing4.0-29B-Intent:星辰实验室开源的意图理解专用模型深度评测
Xing4.0-29B-Intent是星辰实验室(XingChen Lab)开源的意图理解专用模型,基于自研的Xing4.0-29B-A4B通用基座模型微调而成。该模型采用“类别+参数”的结构化输出范式,将用户自然语言输入同时转换为意图分类结果与参数抽取结果,支持意图识别、实体识别、关系抽取、事件抽取四类核心任务。凭借MoE架构带来的计算效率优势,模型平均仅输出数十个Token即可完成完整的语义解...
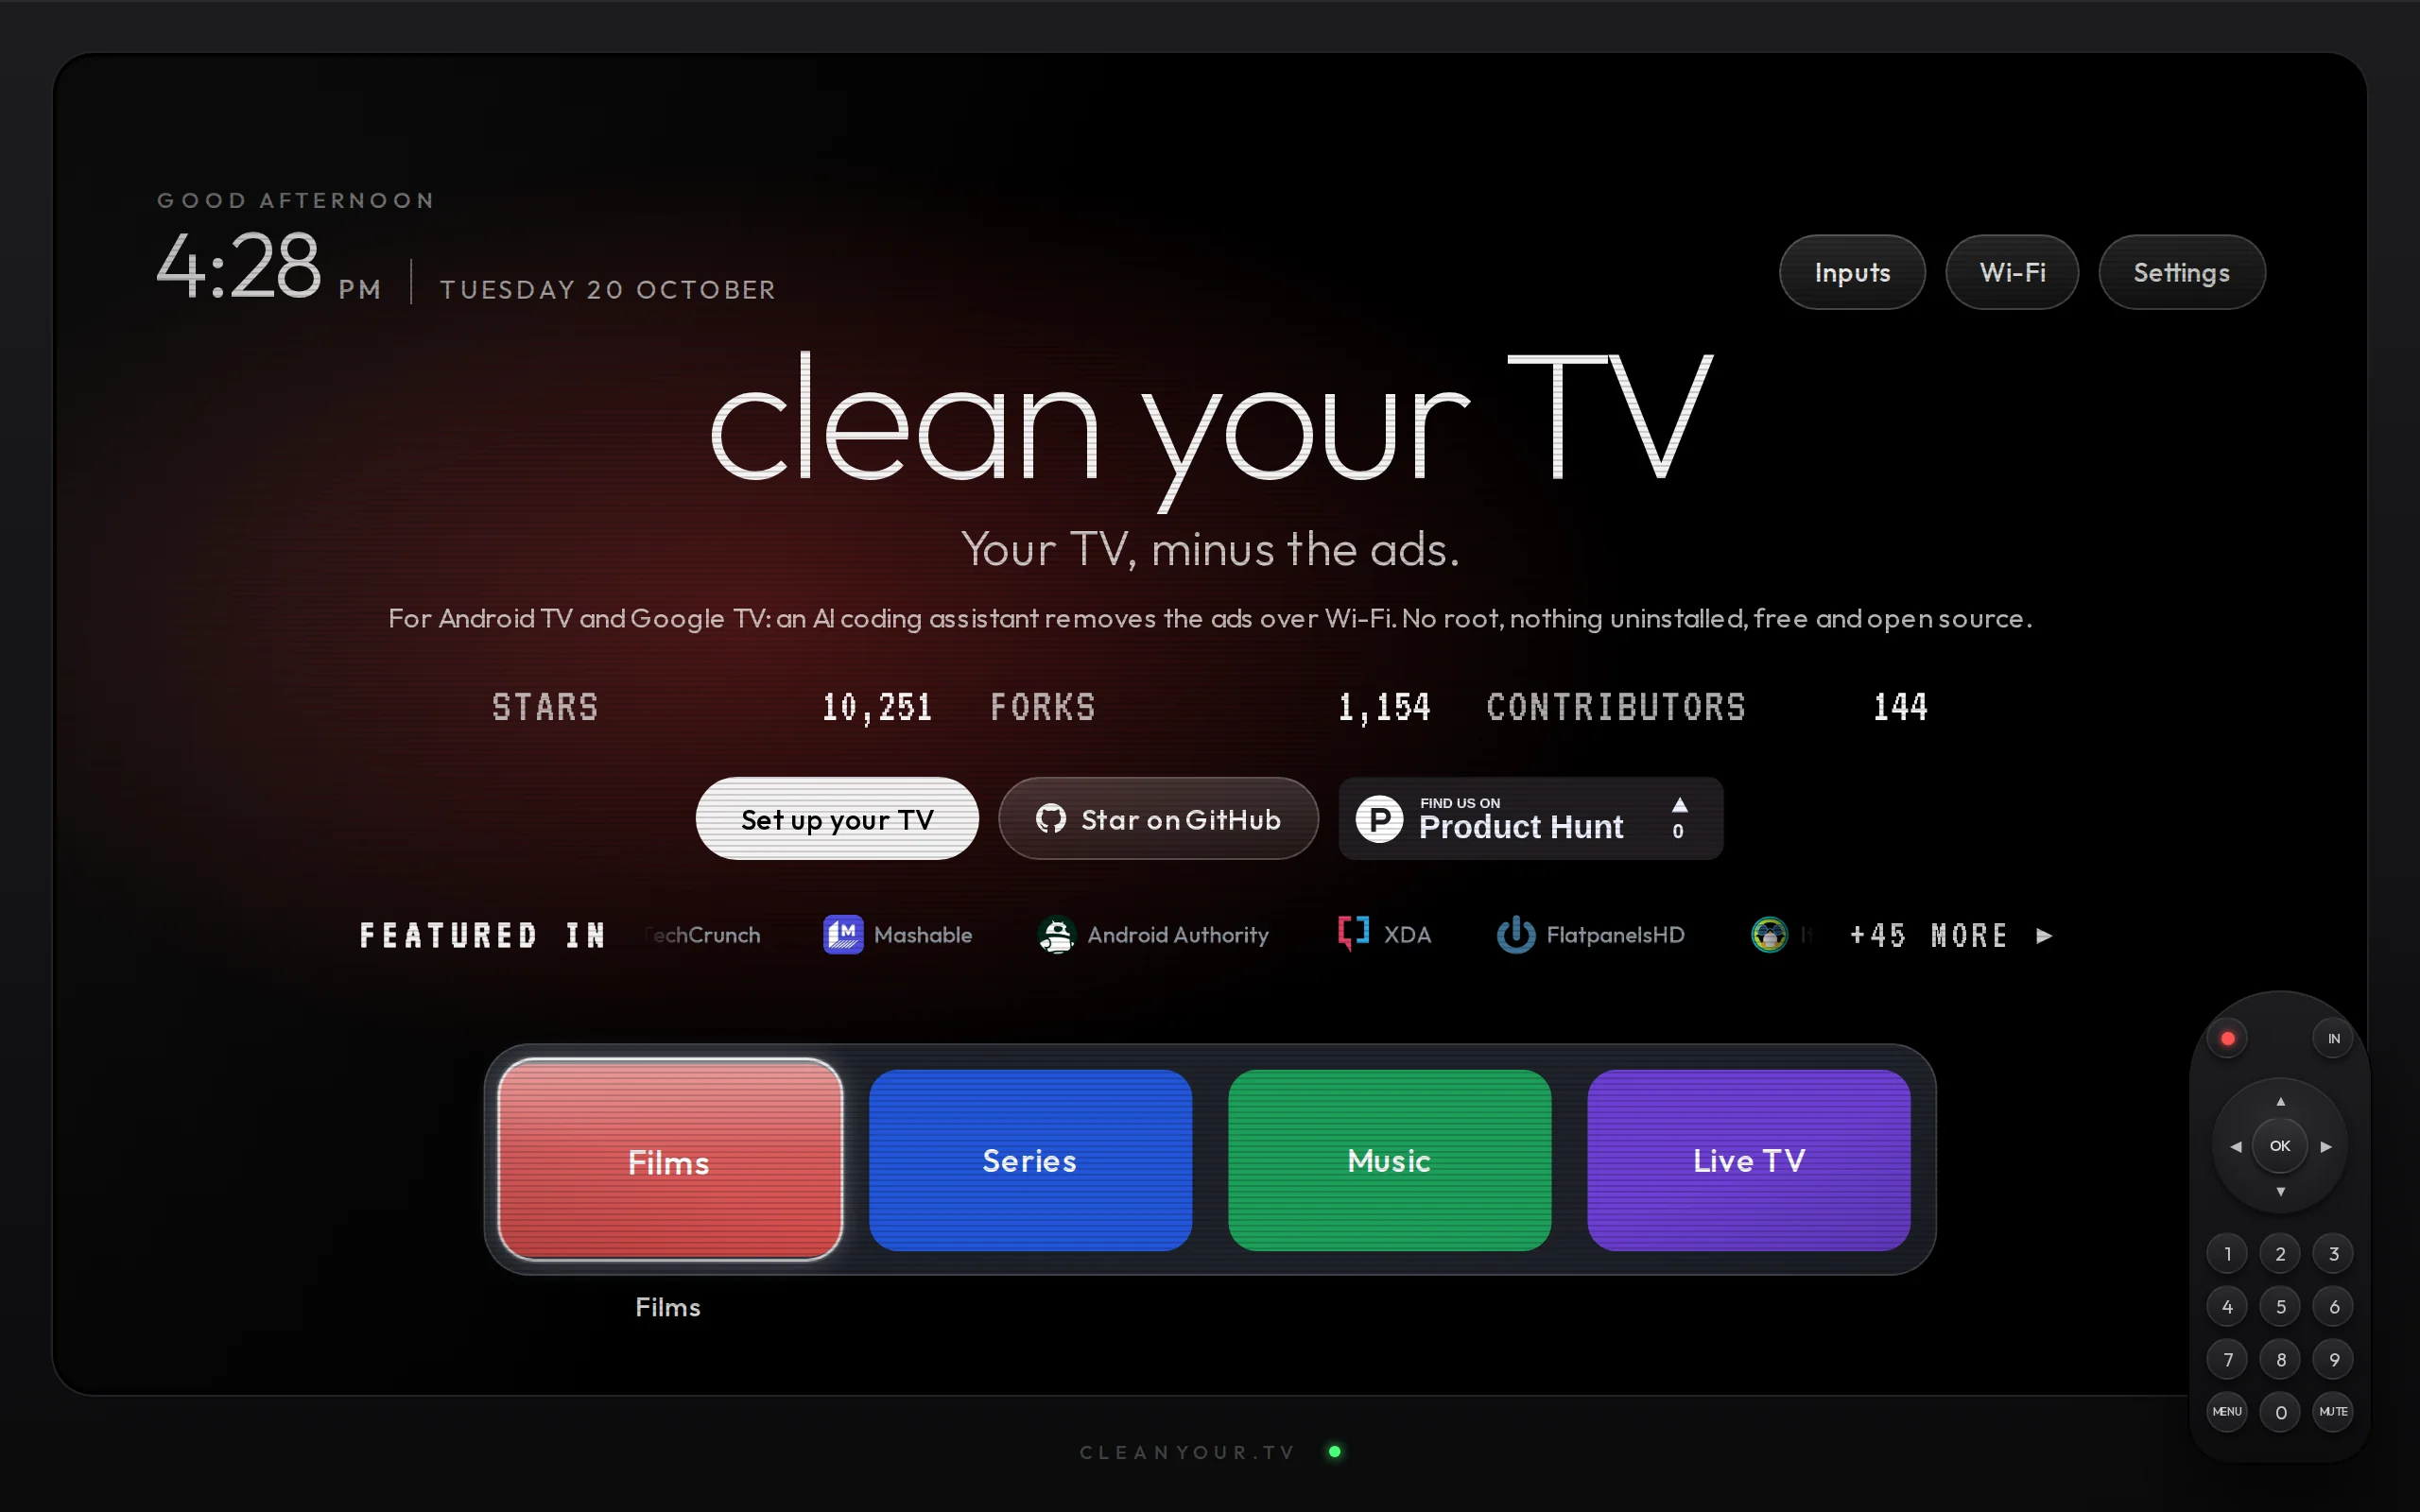
CleanYourTV – 开源的电视广告去除工具,垃圾软件全清空
CleanYourTV 是一款开源的电视系统优化工具,通过 Wi-Fi 网络利用 ADB(Android Debug Bridge)协议连接安卓电视,借助 Claude Code、Codex、Gemini CLI 等 AI Agent 自动识别并停用厂商预装的广告应用、数据遥测服务和臃肿软件,同时安装一款风格类似 Apple TV 的极简桌面 Launcher。该工具全程无需 Root 权限、不卸...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。