
Piccolo – 阿里 AgentScope 团队开源的决策模型系列深度评测
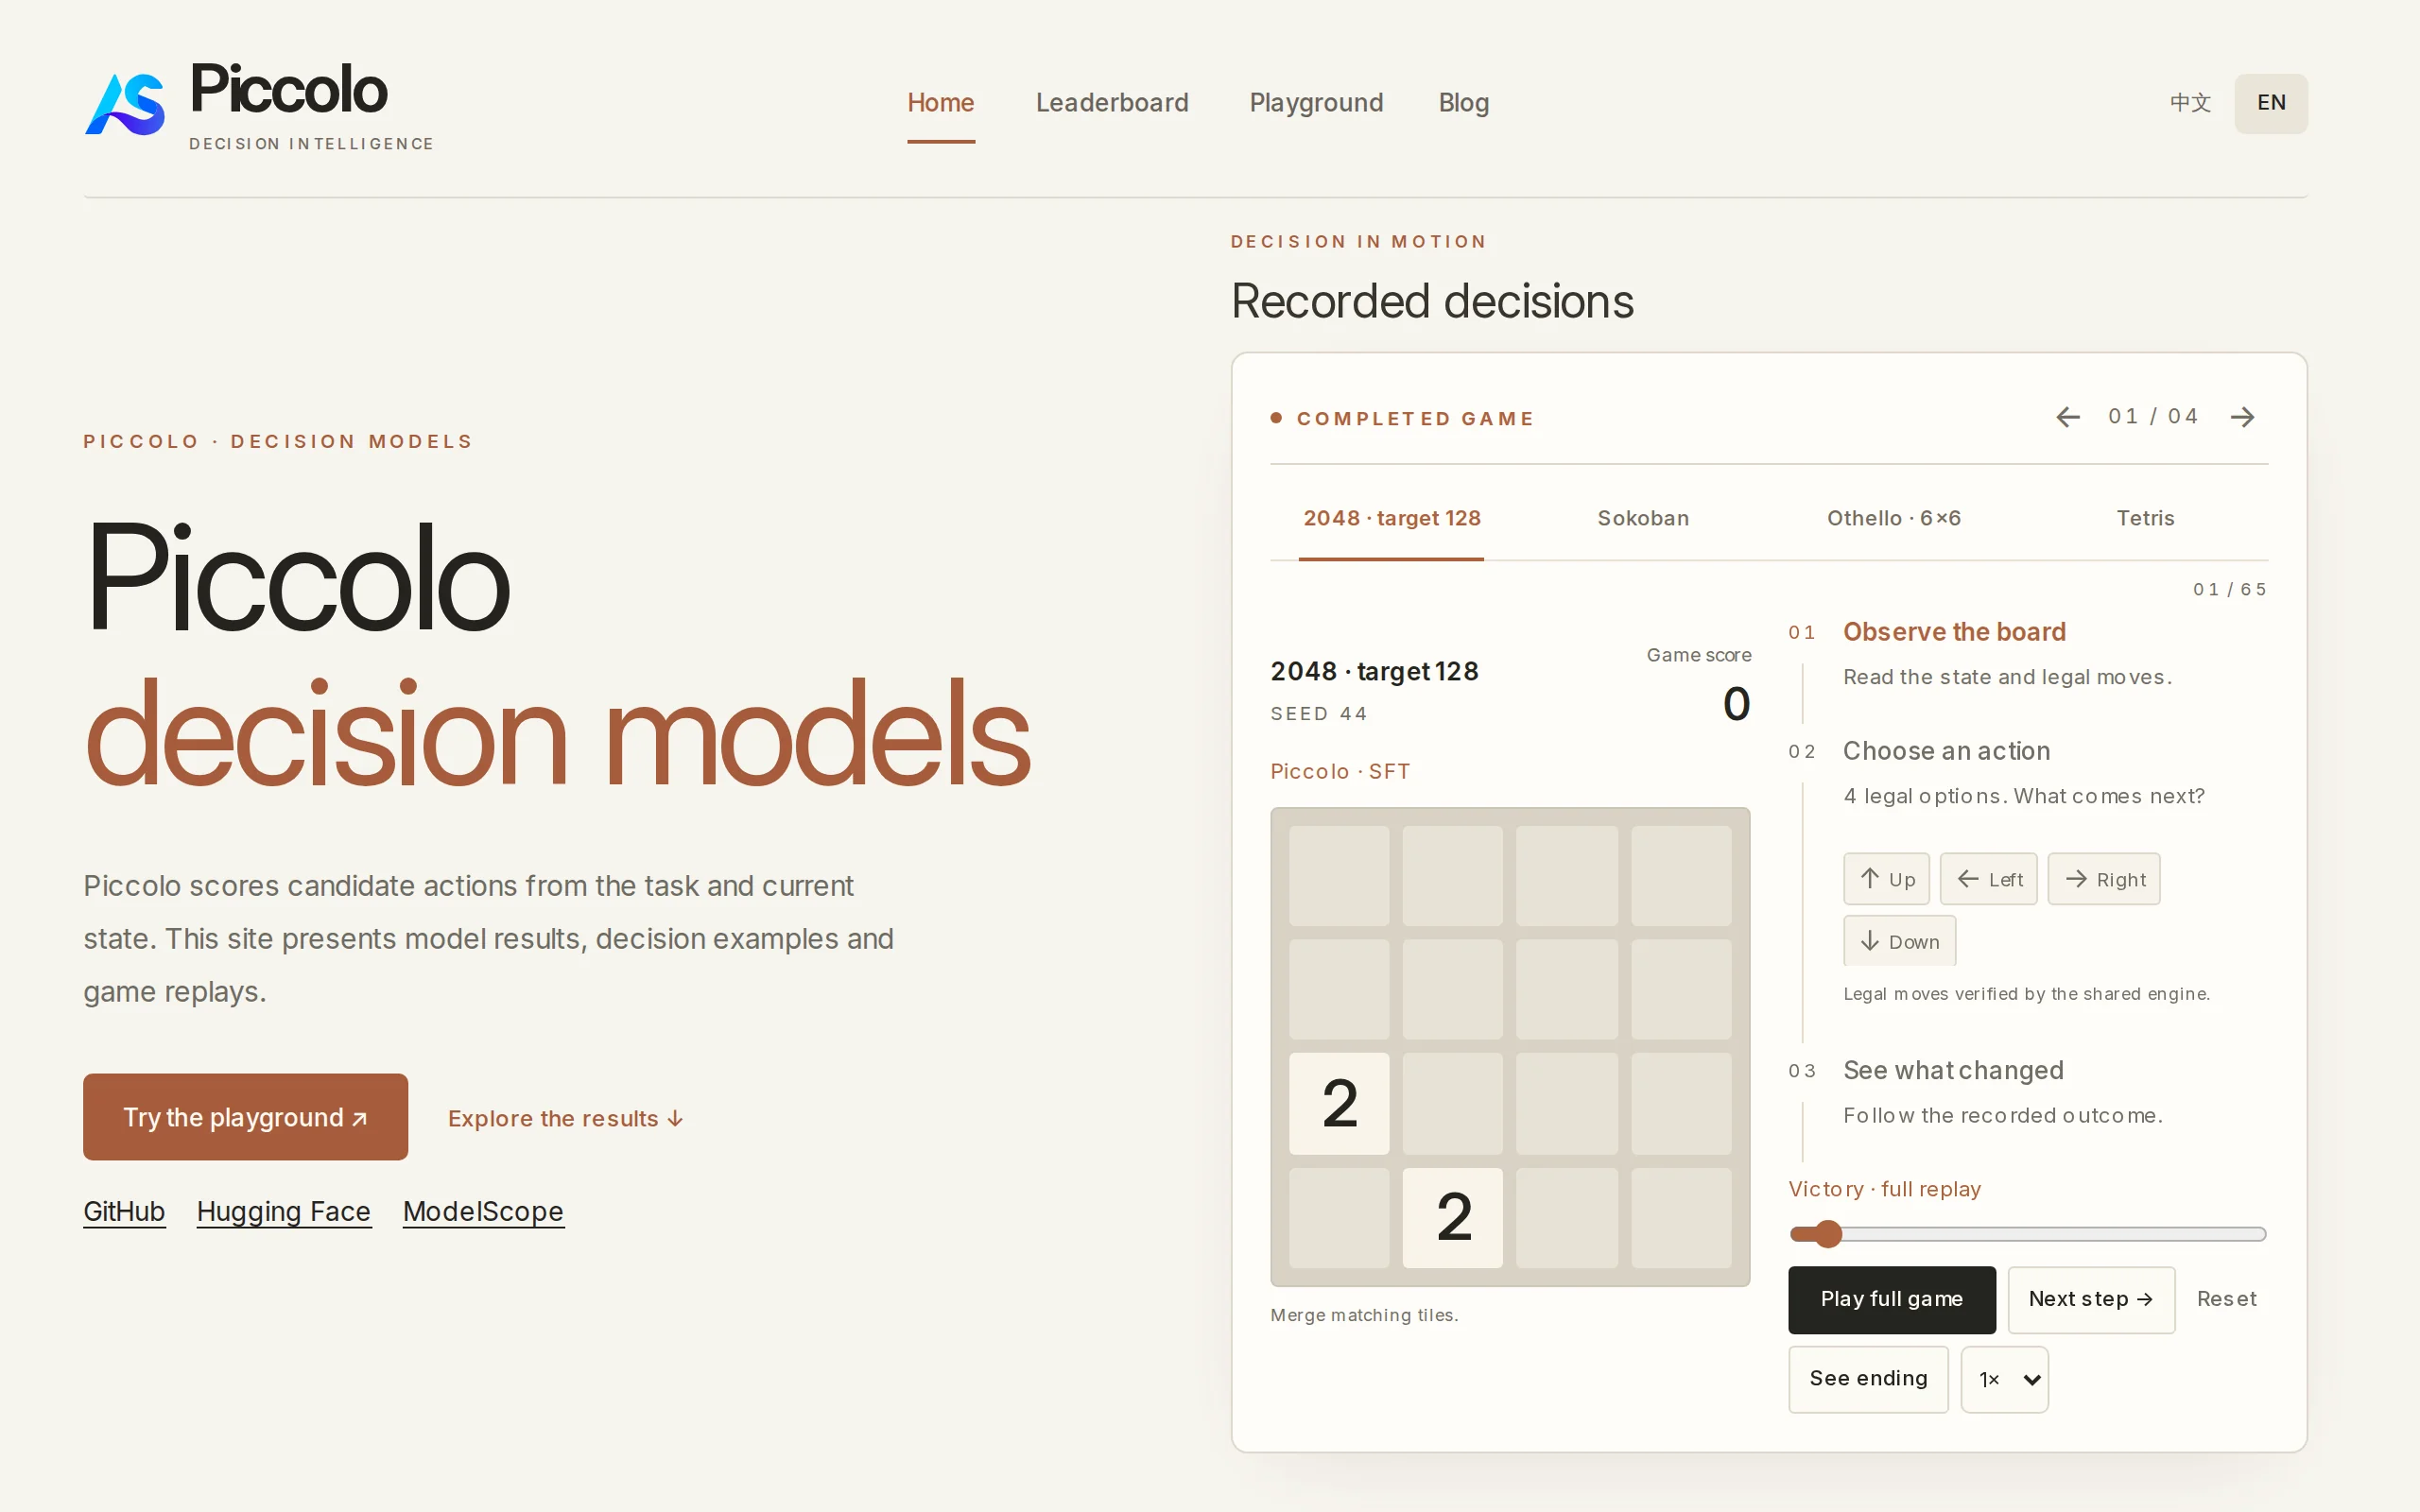
导读摘要:
Piccolo是阿里AgentScope团队开源的决策模型系列,包含27B、9B、4B三个规格尺寸。该系列模型能够直接输出结构化决策结果与对应概率,可嵌入智能体工作流的工具选择、权限判断、失败恢复等关键环节,同时适用于数据处理与游戏实时决策等场景。其中27B版本在JevBench Public基准上达到92.21%的正确率,文本Decision Index达到68.59。团队还自建并开源了Harn...
1. Piccolo是什么
Piccolo是阿里AgentScope团队开源的决策模型系列,包含27B、9B、4B三个规格尺寸。该系列模型能够直接输出结构化决策结果与对应概率,可嵌入智能体工作流的工具选择、权限判断、失败恢复等关键环节,同时适用于数据处理与游戏实时决策等场景。其中27B版本在JevBench Public基准上达到92.21%的正确率,文本Decision Index达到68.59。团队还自建并开源了HarnessJevBench与DataJevBench两个场景化基准,并采用递归自改进框架,通过研究Agent分析错题、迭代数据实现模型的持续进化。
技术定位与领域: Piccolo属于自然语言处理与智能体决策领域的专用判断组件。不同于通用大语言模型追求广泛的文本生成能力,Piccolo专注于做出高质量的决策判断,其定位是Agent工作流中的"判断中枢",解决智能体在复杂执行链路中"该做什么、不该做什么"的核心问题。
研发背景: 该模型系列由阿里巴巴AgentScope团队开发。AgentScope是阿里推出的多智能体应用开发框架,团队在构建和落地智能体应用过程中积累了大量的决策判断需求——工具调用选择、权限边界判断、任务完成验收等,这些场景需要高频、低延迟且可靠的判断能力,由此催生了Piccolo系列模型的研发。
核心价值: Piccolo解决了智能体在实际运行中面临的决策可靠性问题。通用大模型的文本生成方式在决策场景中存在延迟高、输出不稳定、难以程序化消费等缺陷。Piccolo通过直接读取候选token的logits输出结构化决策与概率,将判断延迟降到最低,同时保证决策结果可被程序直接解析和消费,显著提升智能体工作流的自动化水平和稳定性。
技术特点: 模型采用双向prompt注意力机制,让题面与候选项相互参考,全程不产生任何生成文本。训练数据源自开源社区收集的665万条样本,覆盖分类、检索、数理推理、偏好判断等多种任务,并统一整理为"状态、问题、候选项、目标分布"的决策格式。团队基于Data-Juicer构建了13个标注维度、551个预定义取值的语义标签体系,并采用递归自改进闭环持续优化模型表现。
2. 主要功能
工具选择: 根据当前任务目标、已有证据和约束条件,从候选工具列表中判断应该调用哪一个工具。例如当用户查询交付日期时,模型能够识别出需要调用订单系统中的查询接口,而非其他无关工具。
模型路由: 在多个模型都能完成同一任务的情况下,结合预算、延迟要求、任务复杂度等因素,判断选择哪一个执行资源最为合适。该能力对于控制智能体运行成本具有直接价值。
上下文与记忆筛选: 在对话或工作流的上下文中,判断哪些信息应当保留、哪些属于过期或无关内容可以过滤。有助于控制上下文长度,降低后续推理的计算开销,同时保证关键信息不丢失。
权限与信任判断: 在权限边界内做出合规决策。例如一个Agent仅被授权保存草稿而未获批准直接发送时,模型会判断选择"保存"而非"发送",有效防止越权操作。
完成验收与失败恢复: 当任务执行完毕后判断证据是否充分、结果是否达到完成标准;证据不足时继续核验,遇到临时故障时判断是否应当重试。该能力对Agent的自主运行可靠性至关重要。
数据处理决策: 在数据工作流中判断清洗与去重的先后顺序、选择适当的摘要方案、在缺失字段时请求补充信息、在外发数据前判断是否需要脱敏处理,实现数据管线的自动化决策。
游戏实时决策: 根据游戏画面状态为移动、攻击、闪避等连续动作提供按键级别的操作指导,并支持动作游戏、益智游戏与棋盘类游戏等多种类型,展示出模型在实时决策场景下的能力。
3. 应用场景
Agent工具自动审批: 嵌入QwenPaw或自研Agent运行时,对每次工具调用进行自动判断。放行只读操作、拦截覆盖写入等破坏性命令,替代传统的人工逐条审批流程,在保障安全的同时显著提升运行效率。
上下文压缩与记忆筛选: 在上下文压力增大时,模型判断哪些历史消息与工具结果属于低相关内容,决定对其压缩或丢弃,同时保留关键信息。该功能在长会话场景下控制成本、维持响应质量效果明显。
数据处理工作流决策: 在数据进入、清洗、脱敏、交付的各环节做出判断。例如决定清洗与去重的先后顺序、在缺少税额字段时请求补充、在外发前判断是否需要邮箱脱敏,实现数据管线的全流程自动化。
业务流程权限与验收判断: 在Agent执行控制中判断操作是否越权、任务证据是否足以宣布完成、遇到临时故障时是否重试。适用于金融、政务、企业服务等对合规性和操作边界要求严格的行业场景。
游戏与交互环境的实时决策: 根据游戏画面为角色移动、攻击、闪避提供按键级动作指导,也可用于黑白棋、推箱子等需要局面判断的策略类游戏。该场景展示了模型在高频、实时判断任务中的性能表现。
4. 如何使用
在线体验: 访问官网在线体验地址 https://decisionplayground.agentscope.io/ 即可直接试用,无需下载任何模型文件,可以快速感受Piccolo在各类判断任务上的决策效果,适合初步评估和功能验证。
下载模型权重: 从Hugging Face按需选择4B、9B、27B的完整权重或三档GGUF量化版本(BF16、Q8_0、Q4_K_M)。选择GGUF格式时需要注意将每个分片文件下载到同一目录下,确保加载时能够正确拼接。
本地运行环境配置: 从源码安装QwenPaw及其Piccolo兼容的llama.cpp运行时。在QwenPaw界面的Models目录下选择QwenPaw Local → Decision models,下载对应的GGUF文件并点击Start启动,随后在Default models中确认默认决策模型已指向该模型。
启用自动审核功能: 在会话模型菜单中启用Use decision model选项,并在工具审批设置中选择Decision Model Mode。此后Piccolo会对每次工具调用自动进行判断把关,同时保留人工审批作为回退选项。
开启上下文压缩: 启用Context Compaction功能后打开Decision Model Compaction开关。Piccolo会在上下文压力达到阈值时判断哪些工具结果属于低相关可压缩内容,实现动态上下文管理。
API方式接入自研工作流: 参考仓库inference/目录下的参考推理实现和examples/中的最小请求示例,调用原生/v1/systemone端点,按照"状态、问题、候选项"格式发送请求,解析返回的结构化决策与概率结果。
观看演示回放: 克隆GitHub仓库后运行arena/目录下的交互式Arena工具,可以暂停、拖拽并逐条查看《绝区零》战斗等九个存档回放中每次决策的候选概率,深入了解模型的实际判断过程。
5. 优缺点分析
| 优点 |
|---|
| 全尺寸开源且许可证宽松: 4B、9B、27B三档模型连同权重全部以Apache-2.0许可证发布,并提供完整权重与三档GGUF量化格式,覆盖从云端到本地的全场景部署需求,商业使用无法律障碍。 |
| 小尺寸性能突出: 4B版本在JevBench Public达到87.01%、Decision Index 58.00,超过多数竞品9B档水平,契合决策模型高频调用、成本敏感的需求,在低算力环境下也能保证较好的决策质量。 |
| 评测成绩领先: 27B版本在JevBench Public达92.21%、Decision Index 68.59,在团队开展的11模型对比中HarnessJevBench、DataJevBench、JevBench三项均列第一,决策准确率表现稳定。 |
| 决策接口低延迟: 直接读取候选token的logits返回结构化结果与概率,不产生任何生成文本,配合双向注意力与flex_twice输入排布,推理路径优化后天然适合嵌入工作流的高频判断环节。 |
| 阿里生态集成顺畅: 模型托管于ModelScope平台,已并入QwenPaw主线版本,可一键启用工具自动审批与上下文压缩功能,AgentScope框架同源,上手路径最短,与阿里系技术栈无缝衔接。 |
| 全栈工程开放: 递归自改进的数据管线(Agentic Data Engineering、DataJuicer-Sandbox)以及HarnessJevBench、DataJevBench两个场景基准全部开源,社区可以完整复现研究过程并贡献改进方案。 |
6. 同类工具对比
以下将Piccolo与当前市场上其他决策类模型和通用大模型进行多维度对比。
| 对比维度 | Piccolo-27B(AgentScope) | JEV(Autotrust) | DeepSeek-V3 |
|---|---|---|---|
| 核心定位 | 面向Agent与数据工作流的专用决策模型系列 | 开源Jev式决策模型,主打复刻闭源Jev | 通用大语言模型,以文本生成和推理见长 |
| 模型规格 | 4B / 9B / 27B三个尺寸,全谱系覆盖,适配不同算力场景 | 以27B为主,另有VL多模态变体 | 671B MoE架构(激活37B),单尺寸大规模 |
| 开源许可 | Apache-2.0,权重与代码全开放 | 开源权重,具体许可以各仓库为准 | MIT许可证,开源权重,社区生态活跃 |
| 接口形态 | 原生/v1/systemone端点,双向注意力读候选logits,不产生文本 | 兼容Jev决策协议,System 1/2双通道设计 | 标准Chat Completions接口,生成token文本 |
| 决策性能 | JevBench Public 92.21%,Decision Index 68.59 | 六个公开基准平均84.07,与闭源Jev基本持平 | 通用基准表现优异,无专项决策基准成绩 |
| 场景基准 | 自建并开源HarnessJevBench(84.41%)、DataJevBench(82.60%) | 主要依赖通用公开基准,无同等场景化基准 | 依赖通用公开基准,无场景化决策专项基准 |
| 生态集成 | ModelScope托管,已并入QwenPaw主线,一键启用工具审批与上下文压缩 | 独立发布,集成需自行对接 | 开源社区庞大,兼容OpenAI API格式,集成便利 |
| 工程开放度 | RSI数据管线(Agentic Data Engineering、DataJuicer-Sandbox)整体开源 | 以模型权重为主,训练与数据工程细节披露较少 | 训练框架、推理代码开源,技术报告详细 |
选型建议: 对于计划构建智能体应用、特别是需要工具调用审批与上下文压缩能力的开发团队,Piccolo因其Apache-2.0许可证和原生QwenPaw集成特性,提供了从模型权重到工作流编排的完整方案,适合追求自主可控和深度定制的技术团队。
对于已采用OpenAI兼容API架构的企业用户,JEV提供了与闭源Jev基本持平的决策性能,且能以相对标准的接口方式接入现有系统。若企业需要同时兼顾决策能力与通用文本生成需求,并已在阿里云体系内构建应用,Qwen-Max作为闭源商业方案提供了便捷的API调用方式;若追求开源自主可控且算力资源充足,DeepSeek-V3则在通用能力上具备优势,但缺乏Piccolo专门的决策接口和性能优化。
7. 编辑总结
Piccolo是阿里AgentScope团队在智能体决策领域的一次重要技术实践。从技术创新角度看,该模型系列在三个方面做出了有价值的探索:一是决策接口形态的设计——通过双向prompt注意力和直接读取候选token的logits,实现了不产生任何生成文本的纯判断输出,这种接口设计在现有大模型生态中具有明显的差异化;二是统一数据工程方法——将665万条涵盖分类、检索、推理等多种任务的样本统一整理为"状态、问题、候选项、目标分布"的决策格式,并建立13个标注维度、551个预定义取值的语义标签体系,为决策模型的训练数据治理提供了可复用的方法论;三是递归自改进闭环的工程化——由研究Agent驱动错题分析、数据迭代,并借助DataJuicer-Sandbox将数据处理、训练、评测编排为自动化工作流,为模型持续进化提供了一套可运行的机制。
从实用价值角度,Piccolo的4B版本在保持高决策准确率的同时兼顾了成本控制需求,契合决策模型高频调用的产品定位。其与QwenPaw的深度集成、ModelScope平台托管以及Apache-2.0许可证,使得从评估到生产部署的路径较为顺畅。对于正在构建或优化智能体应用的开发团队、需要在数据工作流中嵌入自动化判断的企业用户、以及游戏AI研发人员,Piccolo提供了一套完整的开源解决方案。模型的训练管线、场景基准全部对外开放,也为学术研究和社区协作创造了条件。
从未来发展看,Piccolo所代表的专用决策模型方向——以极低延迟输出结构化决策结果、直接嵌入业务逻辑——是智能体基础设施走向成熟的重要环节。随着Agent应用在金融、政务、医疗等行业的深入落地,高效可靠的决策判断能力将愈发关键。团队将训练数据管线与基准全部开源的做法,也为该技术路线的持续演进奠定了社区基础。
8. 常见问题FAQ
Q:Piccolo与通用大模型(如Qwen、DeepSeek)有什么区别?
A:Piccolo是专用决策模型,不生成文本,而是直接输出结构化决策结果与概率。它输入"状态、问题、候选项",通过读取候选token的logits返回判断结果,延迟远低于通用大模型的文本生成方式。通用大模型定位是广泛的语言理解和生成,Piccolo定位是智能体工作流中的高频判断组件,两者是互补关系而非替代关系,使用场景和目标完全不同。
Q:Piccolo能够在本地部署运行吗?需要什么硬件配置?
A:可以本地部署。4B版本适合消费级显卡和CPU环境,9B版本需要8GB以上显存的GPU,27B版本推荐24GB以上显存(如RTX 3090/4090或A10等专业卡)。除完整权重外,团队还提供BF16、Q8_0、Q4_K_M三档GGUF量化格式,其中Q4_K_M可将资源占用降低约75%,适用于内存资源受限的部署环境。
Q:如何在自己的Agent框架中接入Piccolo?
A:Piccolo提供原生/v1/systemone端点,兼容Jev协议。请求格式为"状态、问题、候选项"三个部分,返回结构化决策与每个候选选项的概率。GitHub仓库的inference/目录包含参考推理实现,examples/目录提供最小请求示例,工程团队可参照这些示例快速集成到自研工作流中。
Q:Piccolo的递归自改进(RSI)机制是自动运行的吗?
A:递归自改进机制由研究Agent驱动,核心信号是逐题KL损失。系统按语义标签切片汇总后,对偏差持续偏高的数据自动复核答案、检索相近材料或定向合成更多条件组合。但完整的RSI管线运行需要一定的工程配置,包括Agentic Data Engineering环境和DataJuicer-Sandbox工作流编排,团队已将该管线整体开源,社区可以复现和参与改进。
Q:Piccolo的处理延迟具体是多少?相比文本生成快了多少?
A:由于Piccolo全程不产生生成文本,直接读取候选token的logits输出决策结果,其推理延迟远低于相同参数规模的通用大模型文本生成。根据团队公布的架构设计,配合flex_twice输入排布优化推理路径,该接口设计天然适合嵌入工作流的高频判断环节。具体延迟数据受硬件影响,建议通过官方在线体验或本地部署实测获得各尺寸模型的端到端延迟指标。
Q:Piccolo支持中文输入吗?对英文和中文的决策效果有差异吗?
A:Piccolo的训练数据覆盖多种任务类型,其中包含中文数据,模型对中文和英文输入均能处理。但作为决策模型,其输出是结构化的候选项选择而非自然语言,因此语言能力主要体现在题面和候选项的理解层面。在中文场景的具体效果建议通过在线体验平台使用中文样例进行实测。
Q:模型权重是否允许用于商业项目?
A:允许。Piccolo系列模型(4B、9B、27B)的代码和权重均以Apache-2.0许可证发布,该许可证允许自由使用、修改和分发,包括商业用途,不要求开源衍生作品。这对企业用户将模型集成到商业产品中提供了明确的法律保障和灵活性。
9. 项目地址
- 项目官网(在线体验):https://decisionplayground.agentscope.io/
- GitHub仓库:https://github.com/agentscope-ai/Piccolo
相关推荐
LoopForge – 腾讯开源的云端 AI 研发协作平台
LoopForge是腾讯开源的一款团队级云端AI研发协作平台,旨在解决多Agent接力交付过程中出现的工程断点问题。不同于传统AI编程助手仅面向单个开发者,LoopForge将任务运行在7×24小时云端沙箱中,用户关闭电脑后任务依然持续执行;产品、设计、研发等角色共用同一个Main Bot会话,上下文自动流转,无需手动复制粘贴。需求经SOP标准流水线推进,编译和测试按退出码客观判定,失败自动附日志...

Muse Ember 评测:Meta 重新定义轻量级模型的效率边界
Muse Ember 是 Meta 于 2026 年中推出的最小参数规模 AI 模型,专为智能体(Agent)高频重复性任务设计。据官方基准测试数据,该模型以约 1/3 于 Claude Haiku 5.5 的单任务成本达到与之持平的综合跑分,并在智能体工作流(AutomationBench-AA)中以 37.8 分大幅领先,位居 Artificial Analysis 效率前沿。其核心配置包括 ...
Claude Fable 5.2 – Anthropic 推出的旗舰级 AI 模型
Claude Fable 5.2是Anthropic推出的旗舰级AI模型,与专攻网络安全的Claude Mythos 5.2同源。该模型以千级Agent集群自主协作能力著称,曾由1000个Agent连续运转8天,从零写出可开机运行的完整操作系统,并在30小时内完成费马大定理的Lean语言形式化证明。相比上代,Claude Fable 5.2生成速度提升30%,API价格降至输入$8、输出$40每百...

ComfyTV – 开源 ComfyUI 插件,本地无限画布媒体工作台
ComfyTV 是一款开源的 ComfyUI 插件,免费且完全在本地运行,能够将 ComfyUI 改造成类似 TapNow、LibTV 的无限画布式媒体工作台。画布上的每个操作都是独立节点,修改任意段落只需重跑该节点,无需整链重算。约 190 个节点覆盖图片生成、视频剪辑、调色、抠像、音频、分镜和图层编辑,并支持 Agent 接入。由于生成能力依赖本地已安装的模型,ComfyTV 适合希望减少节点...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。