
OmniEdu – 面向K-12教学全流程的开源教育多模态模型系列
导读摘要:
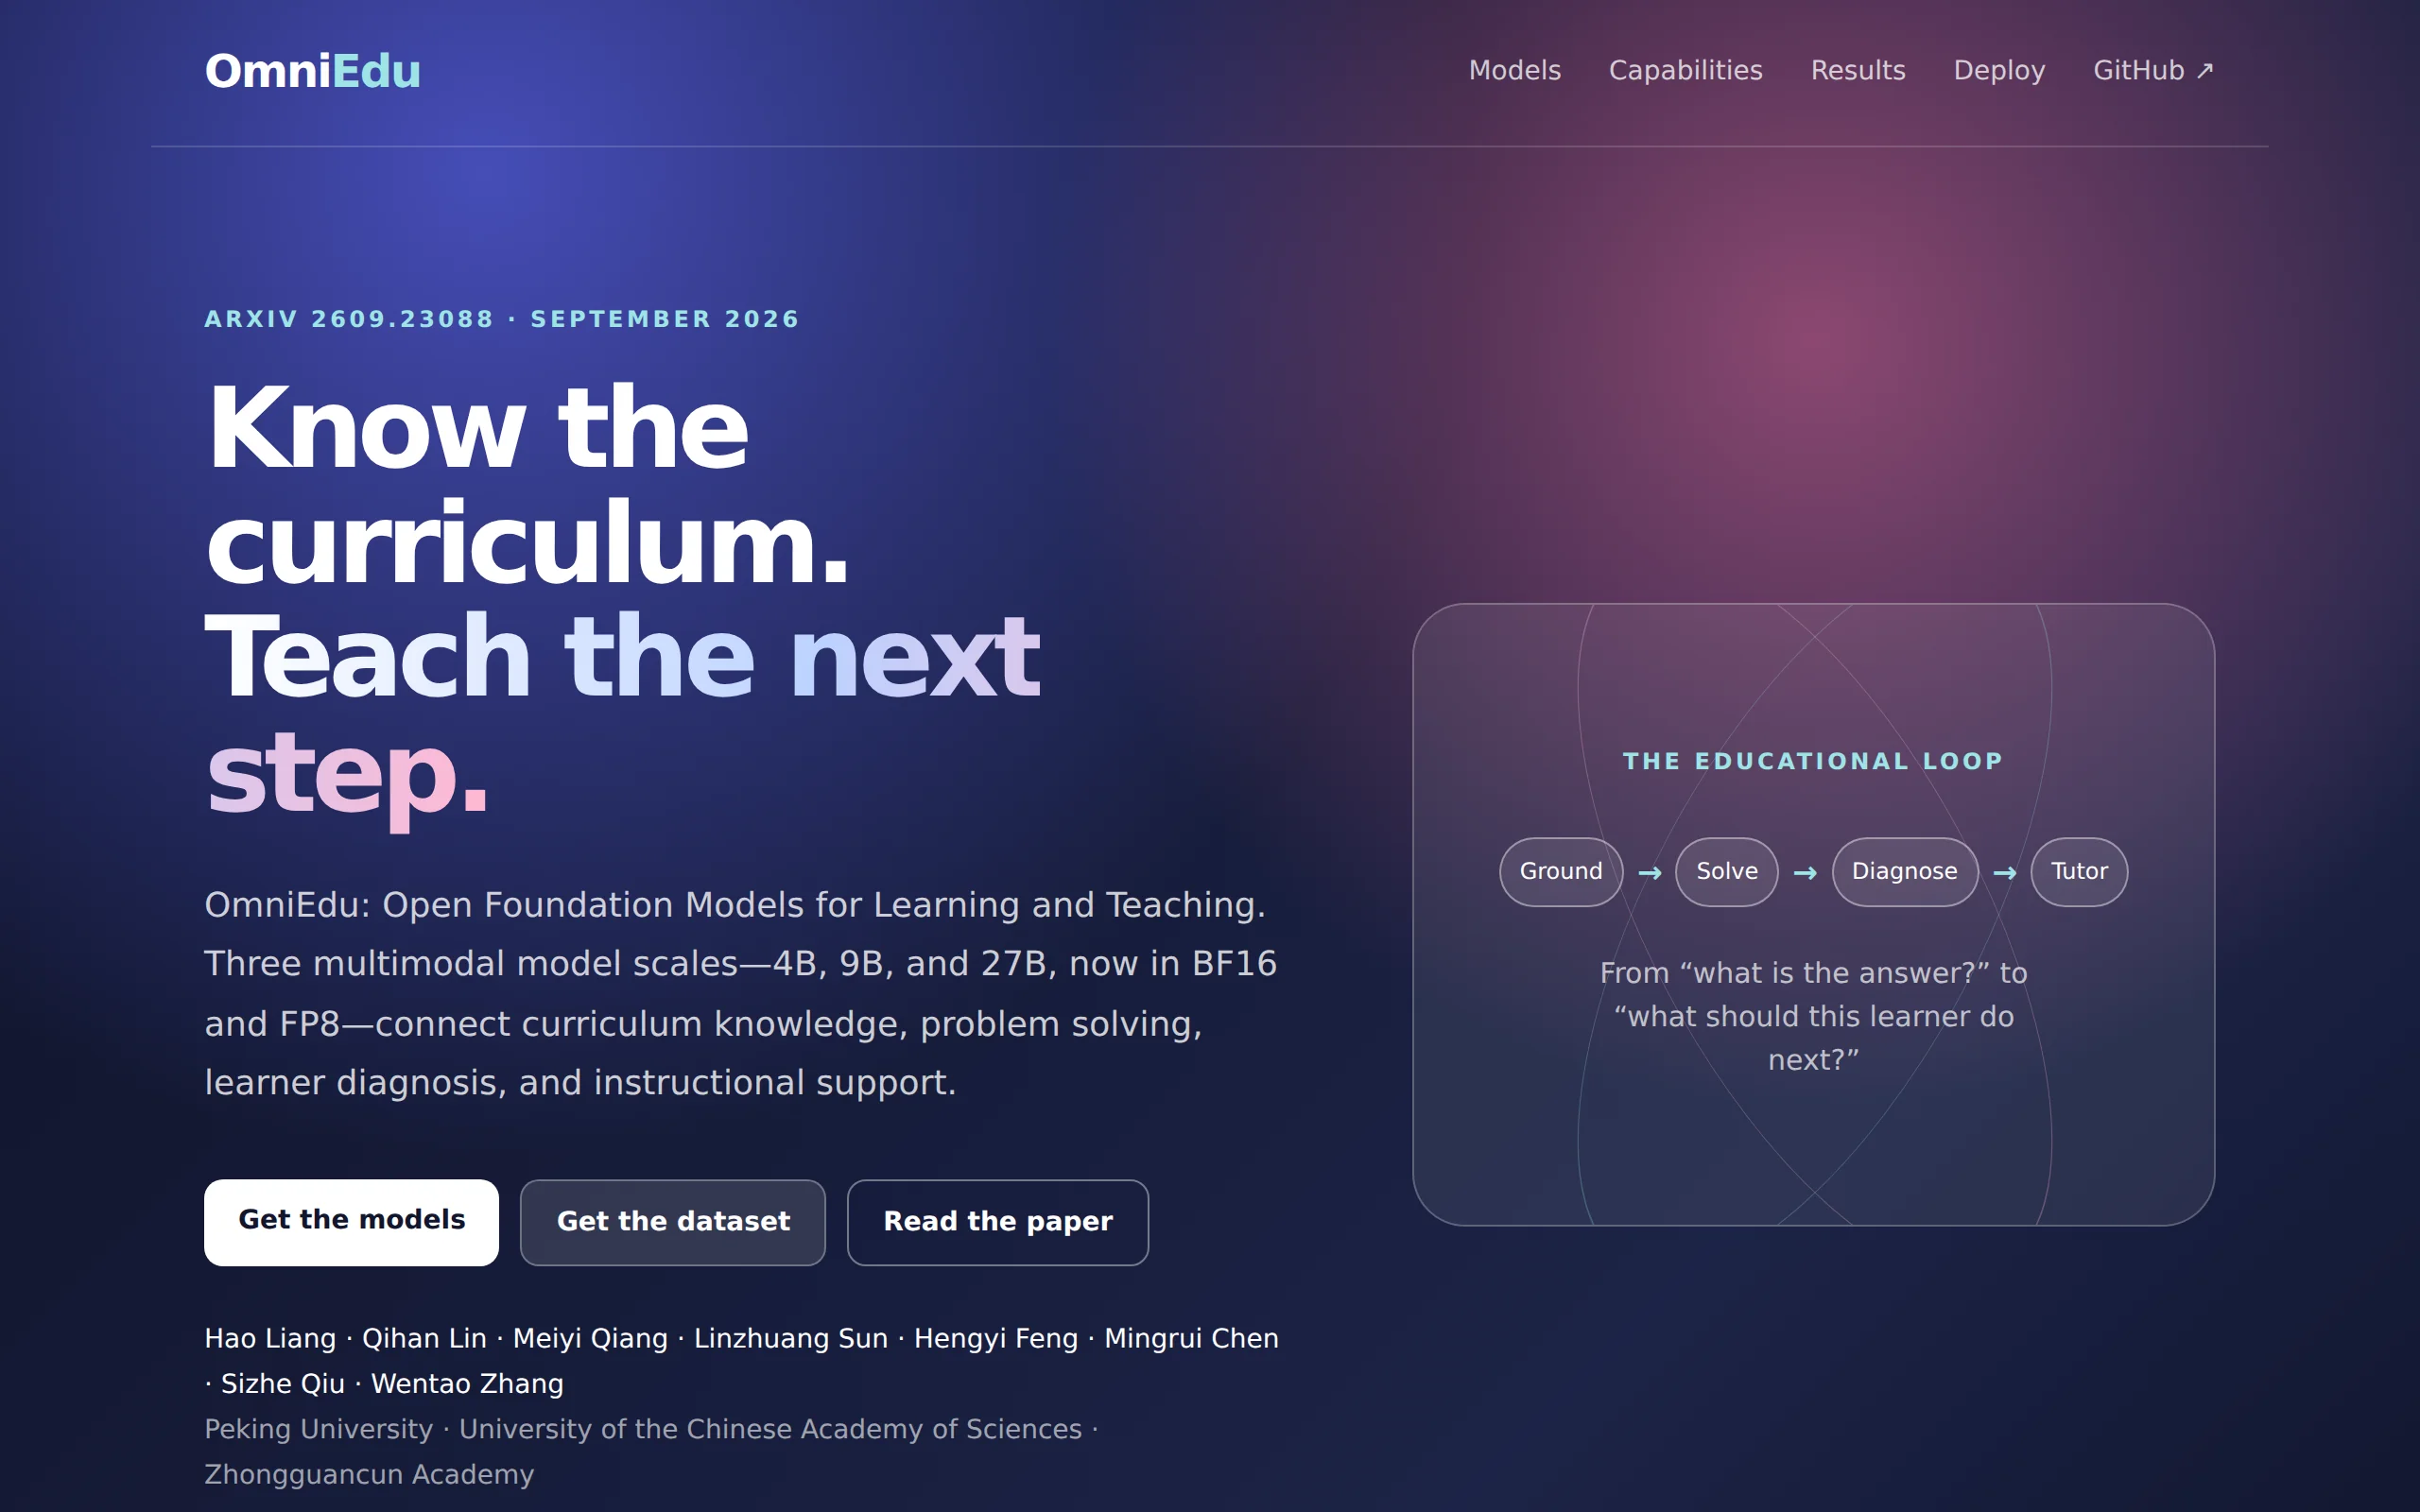
OmniEdu是由北京大学DCAI团队联合中国科学技术大学、中关村学院共同开源的教育多模态模型系列,提供27B、9B、4B三种参数规模。该系列模型以教学能力为核心设计目标,能够解答学科题目、判断知识点在课程中的位置、诊断学生错因,并选择合适的教学动作。团队从约134万条候选数据中精选约6.9万条高质量样本进行训练,使模型在多学科解题、学习诊断与辅导任务上达到SOTA水平,其中4B小模型可部署于普通...
1. OmniEdu是什么
OmniEdu是由北京大学DCAI团队联合中国科学技术大学、中关村学院共同开源的教育多模态模型系列,提供27B、9B、4B三种参数规模。该系列模型以教学能力为核心设计目标,能够解答学科题目、判断知识点在课程中的位置、诊断学生错因,并选择合适的教学动作。团队从约134万条候选数据中精选约6.9万条高质量样本进行训练,使模型在多学科解题、学习诊断与辅导任务上达到SOTA水平,其中4B小模型可部署于普通服务器,有效降低学校引入AI教学助手的硬件门槛。
技术定位与领域: OmniEdu属于教育人工智能与多模态大模型的交叉领域,其独特定位在于覆盖K-12阶段"学习-教学"全流程——从学科解题、课程知识图谱理解,到学生错因诊断与教学策略选择,而非仅提供答案式问答。这一方向在现有开源教育模型中尚属稀缺。
研发背景: 该模型由北京大学DCAI团队主导,联合中国科学技术大学、中关村学院共同研发。团队拥有深厚的大模型训练与数据工程积累,其研发动机源于当前教育模型普遍缺乏"教学行为能力"——模型能解题,却不知道如何诊断学生卡点、如何通过提问引导思考。
核心价值: OmniEdu解决了教育AI从"答题工具"向"教学助手"升级的核心问题。通过任务指令驱动机制,同一模型能够在解题、诊断、辅导等不同教学场景间灵活切换行为模式;配合严格的训练数据筛选与去污染流程,在多项教育评测基准上取得领先成绩。
技术特点: 模型采用20种任务系统指令实现行为切换,训练数据按四类教学能力分类并分配token预算平衡配比。从134万候选样本中经语义审核、去污染、多样性筛选保留约6.9万条,同时支持文本与图像多模态输入,兼顾推理效率与教学效果。
2. 主要功能
学科解题能力: 覆盖数学、科学、阅读理解和写作四大学科领域。模型不仅输出正确答案,还会确保解释与题目条件、推理过程保持一致,避免出现"答案对但过程错"的常见问题。该能力基于训练数据中对解题正确性与推理一致性的双重审核。
课程理解与知识定位: 模型能够识别题目对应的知识点、适用年级、难度等级以及知识点间的前置依赖关系,判断学生在继续学习前需要补充哪些基础内容。这一功能将单道题目映射到课程知识图谱中,为个性化学习路径规划提供支撑。
诊断推理能力: 区别于仅凭题目猜测学生错误原因的做法,OmniEdu基于学生的作答过程和错误答案,定位具体出错步骤、分析理解偏差以及需要补充的知识点。该功能对数学分步计算、阅读理解中的逻辑偏差等场景尤为有效。
教学行动选择: 模型根据诊断结果和教学任务选择合适的回应方式,包括提示、引导式提问、复习前置概念、直接指出错误或进行完整讲解。通过20种任务指令的切换,同一模型能够扮演不同角色,从严格解题到苏格拉底式辅导均可胜任。
多模态输入支持: 模型支持文本与图像混合输入,学生可以将手写解题过程、课本截图或几何图形以图片形式提交,由模型进行图文联合理解后给出诊断与辅导回应。这一能力扩展了模型在真实教学场景中的适用性。
多规模模型适配: 提供4B、9B、27B三种参数规模,并额外提供FP8量化版本。FP8版本下载体积较原始版本缩小37%–44%,其中4B模型可部署于学校普通服务器,27B模型面向高性能计算环境,满足不同预算与算力条件下的部署需求。
教学评测基准支持: 官方工具包内置12个教育评测基准,覆盖K-12解题、高考、竞赛数学、辅导对话、脚手架教学等维度,开发者可通过一条命令对模型进行标准化评估并生成详细报告。
3. 应用场景
个性化学习辅导: 学生做题遇到卡点时,OmniEdu先定位具体出错环节,再通过提示和追问引导学生独立思考,而非直接给出答案。该模式适配自习、课后练习等场景,有助于培养学生的自主推理能力。
错题诊断分析: 教师将学生的作答过程输入模型,系统自动分析错因、定位对应知识漏洞,并生成针对性的补救建议。这一流程大幅减轻教师批改与学情分析负担,使个性化反馈在班级教学中成为可能。
课程对齐内容生成: 教师按指定课程标准和年级要求,让模型生成练习题、分层作业或讲解材料。模型自动标注题目对应的知识点归属与前置关系,帮助教师快速构建与教学进度匹配的课程资源。
课堂互动助教(苏格拉底式教学): 模型扮演课堂助教角色,通过引导式提问推动学生逐步推理,并根据学生的回答证据动态调整教学策略。该场景支持分层教学,让不同水平的学生获得适配难度的引导。
4. 如何使用
环境要求: OmniEdu基于PyTorch与Transformers框架,需要Python 3.8及以上环境。GPU方面,4B模型建议至少8GB显存,9B模型建议16GB以上显存,27B模型建议多卡部署(每卡至少24GB显存)。FP8量化版本可降低显存占用约37%–44%。
安装依赖: 本地运行需执行
pip install -U torch torchvision transformers accelerate safetensors pillow,若使用FP8权重还需额外安装compressed-tensors库。部署服务方式则需安装vLLM推理框架。加载模型: 使用
AutoProcessor和Qwen3_5ForConditionalGeneration.from_pretrained加载模型ID,例如lhpku20010120/Omni-Edu-4B,9B和27B版本替换对应ID即可。首次加载会自动下载模型权重。构造输入与生成: 将学生题目、作答或图片按chat模板组织为messages格式,图片题目需加入
{"type": "image"}项。调用generate方法时必须设置enable_thinking=False,随后用batch_decode解码输出结果。vLLM服务部署(推荐): 执行
vllm serve lhpku20010120/Omni-Edu-4B --max-model-len 32768 --reasoning-parser qwen3 --default-chat-template-kwargs '{"enable_thinking": false}'启动服务。FP8版本改用Omni-Edu-4B-FP8模型ID,多卡环境通过--tensor-parallel-size参数调整并行度。API调用: 服务启动后,通过
curl访问http://localhost:8000/v1/chat/completions,以OpenAI兼容格式发送请求即可获得模型回答,便于集成到现有教学系统中。官方工具包使用: 执行
pip install omniedu安装SDK(评测功能需装omniedu[eval]),通过OmniEdu.from_pretrained("4B", base_url=服务地址)初始化客户端,调用model.chat(text=...)进行对话。评测对比: 使用
omniedu eval --list查看12个教育评测基准列表,运行评测命令即可生成模型在各基准上的表现报告,便于开发者横向对比不同版本的性能差异。
5. 优缺点分析
| 优点 |
|---|
| 任务指令驱动行为切换: 20种系统指令让同一模型能够按任务区分逐步解题、错误诊断、苏格拉底式提问和辅导对话等回应方式,灵活适配多种教学场景。 |
| 训练数据质量管控严格: 从134万候选样本经语义审核、去污染、token配比平衡后精选约6.9万条,每条样本明确标注"学什么"与"怎么教",数据质量在同级教育模型中较为突出。 |
| 教育评测表现领先: 27B版本在K12-Bench、GAOKAO-Bench、MathTutor脚手架等多项教育基准上取得领先成绩,与前沿商用模型对比中60次比较胜出51次,教学能力经过量化验证。 |
| 多规模与量化版本覆盖: 4B、9B、27B三档规模配合FP8量化,下载体积缩小37%–44%,小模型可部署在普通服务器,兼顾性能与部署灵活性。 |
6. 同类工具对比
| 对比维度 | OmniEdu-27B | MuduoLLM(14B) |
|---|---|---|
| 模型定位 | 覆盖K-12学习-教学全流程(解题+课程理解+诊断+辅导) | 以学科解题和课程问答为主 |
| 模型规模 | 27B(另有4B/9B可选) | 14B(单一规格) |
| K12-Bench EM | 63.12% | 48.24% |
| GAOKAO-Bench | 94.87% | 89.66% |
| MathTutor脚手架胜率 | 78.74% | 30.42% |
| 部署方式 | 开源权重,支持本地部署与vLLM服务化 | 开源权重,本地部署 |
| 训练数据规模 | 精选约6.9万条教育样本 | 未公开详细数据 |
| 教学行为训练 | 20种任务指令驱动行为切换,支持诊断与辅导 | 以解题为主,教学行为覆盖有限 |
选型建议: 对于有数据安全要求或需要深度定制教学行为的学校、教育机构,OmniEdu是当前开源方案中功能覆盖较完整的选择。其27B版本在解题准确率和教学行为质量上均有量化优势,4B版本则适合预算有限、仅需基础解题与诊断能力的场景。若团队缺乏GPU资源且对数据外传无顾虑,可考虑商用API方案,但需注意其在教学诊断和脚手架式辅导方面的专项能力不及OmniEdu。
对比MuduoLLM: 两者同属开源教育模型,但OmniEdu在几乎所有教育基准上均显著领先,尤其在MathTutor脚手架胜率(78.74%对30.42%)和TutorBench(59.42%对35.98%)上的差距,反映出OmniEdu在教学行为训练上的投入带来了实质性效果。MuduoLLM的优势在于模型规模较小(14B),对显存要求相对温和,适合作为轻量级解题工具使用。
7. 编辑总结
OmniEdu在技术创新上的核心贡献在于将"教学行为"作为可训练、可评测的模型能力,而非依赖通用大模型的指令遵循能力自然涌现。团队通过任务指令驱动机制、严格的数据筛选流程和token预算平衡策略,使模型能够按教学场景切换行为模式,这一设计思路在开源教育模型中具有明确的差异化价值。从实用角度看,OmniEdu覆盖了从解题、诊断到辅导的完整教学链路,且提供4B到27B的多档规模与FP8量化版本,兼顾了研究机构与一线学校的算力现实。其在MathTutor脚手架胜率从14%提升至78.74%的实验结果,也验证了教学行为可以通过针对性训练获得显著改善。模型适合三类人群使用:教育科技公司的产品研发团队可基于其构建个性化学习系统;一线教师可利用诊断与内容生成功能减轻备课和批改负担;高校研究团队可将其作为教育AI方向的研究基座。OmniEdu的未来发展潜力取决于两个方向:一是训练数据规模的持续扩展,当前约6.9万条精选样本虽质量较高,但覆盖的学科深度和年级广度仍有拓展空间;二是社区生态的建设,更丰富的部署教程和第三方工具将降低其落地门槛。整体而言,OmniEdu为教育AI的开源生态提供了一个功能完整、性能经过验证的参考实现。
8. 常见问题FAQ
Q:OmniEdu与通用大模型(如GPT系列)在教育场景下有何本质区别?
A:通用大模型擅长回答问题,但缺乏系统的教学行为能力。OmniEdu通过20种任务指令驱动行为切换,能够主动诊断学生错因、判断知识点前置关系、选择提示或追问等教学策略,而非仅仅给出答案。其在MathTutor脚手架任务上78.74%的胜率也证明教学行为可以被专门训练并量化提升。
Q:4B版本需要什么硬件配置才能流畅运行?
A:4B版本建议至少8GB显存的GPU,如NVIDIA RTX 3060 12GB或更高型号。若使用FP8量化版本,显存占用可进一步降低约37%–44%。CPU推理虽然可行但速度较慢,不适合实时教学交互场景。官方推荐通过vLLM部署以获取更好的吞吐性能。
Q:为什么生成回答时必须设置 enable_thinking=False?
A:OmniEdu的训练数据基于精简的监督回答设计,不包含冗长的思维链推理过程。设置 enable_thinking=False 可使模型直接输出最终教学回应,避免生成格式与训练分布不一致导致的内容异常。这是官方验证过的推荐配置,用户应遵循该参数设置。
Q:如何评估OmniEdu在不同教学任务上的实际效果?
A:官方工具包提供了12个教育评测基准,涵盖K-12解题(K12-Bench)、高考(GAOKAO-Bench)、数学竞赛(EDUMATH)、辅导对话(TutorBench)、脚手架教学(MathTutor)等维度。安装 omniedu[eval] 后执行 omniedu eval --list 可查看基准列表并生成评测报告。
Q:OmniEdu是否支持中文教学场景?
A:支持。GAOKAO-Bench(中国高考基准)上27B版本达到94.87%的准确率,说明模型对中文题目和国内课程体系有较好的理解能力。训练数据包含中文教育样本,模型能够用中文进行解题、诊断和辅导对话。
Q:FP8量化版本与原始版本在效果上有何差异?
A:FP8版本将权重压缩至8位浮点格式,下载体积缩小37%–44%,显存占用相应降低。官方未公布FP8与原始版本在全部基准上的详细对比,但量化技术通常会在极端复杂任务上带来小幅精度损失,建议在关键教学场景中优先使用原始版本,在资源受限环境中使用FP8版本。
9. 项目地址
- 项目官网:https://haolpku.github.io/Omni-Edu/
- GitHub仓库:https://github.com/haolpku/Omni-Edu
- HuggingFace模型库:https://huggingface.co/datasets/lhpku20010120/Omni-Edu
- arXiv技术论文:https://arxiv.org/pdf/2609.23088
相关推荐
MiniMax H3-Image – MiniMax 开源的图像生成模型
MiniMax H3-Image 是 MiniMax 官方开源的图像生成模型,其底层基于 MiniMax 自研的 H3 多模态基础模型构建,完整支持文生图、图像参考与图像编辑三大核心任务。凭借模型架构层面的预训练积累与后训练阶段的强化学习优化,H3-Image 能够在约 10 秒内生成 4096×4096 分辨率、约 1600 万像素的 4K 级图像,生成结果在细节丰富度和真实感方面表现突出。模型...

Muse Ember 评测:Meta 重新定义轻量级模型的效率边界
Muse Ember 是 Meta 于 2026 年中推出的最小参数规模 AI 模型,专为智能体(Agent)高频重复性任务设计。据官方基准测试数据,该模型以约 1/3 于 Claude Haiku 5.5 的单任务成本达到与之持平的综合跑分,并在智能体工作流(AutomationBench-AA)中以 37.8 分大幅领先,位居 Artificial Analysis 效率前沿。其核心配置包括 ...
Sophon-Realtime v1 深度评测:开源全双工语音对话模型的技术突破与工程实践
Sophon-Realtime v1 是由 AI降临派(Adventists AI)开源的全双工语音对话模型,基于 32B 参数规模设计,实现了边听边判断话轮、随时可被打断、理解语气与副语言信息、并以带感情的声音进行回应的完整对话能力。该模型在语音评测基准 VoiceBench 上取得 82.8 分,位列开源全双工模型第一,与 GPT-4o-mini-Audio 持平。项目提供 Tag(表现力强)...
Apollo World – 百度 Apollo 推出的全模态世界模型,赋能自动驾驶闭环仿真与数据飞轮
Apollo World是百度Apollo推出的面向物理AI的智能体驱动全模态世界模型。与传统仿真工具不同,该系统基于真实数据构建虚拟城市,其中车辆、行人及非机动车均为具备自主决策能力的AI智能体,而非遵循固定脚本的静态道具。模型能够实时生成相机画面与激光雷达点云等多模态观测数据,与无人驾驶车辆形成感知、决策、行动的闭环交互。Apollo World支持从任意起点到终点的完整出行任务,已直接投入萝...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。