
PP-OCRv6 – 百度飞桨 PaddleOCR 开源的第六代 OCR 模型
导读摘要:
PP-OCRv6 是百度飞桨 PaddleOCR 团队推出的第六代开源 OCR 模型,首次以三档规格(Tiny 1.5M、Small 7.7M、Medium 34.5M)覆盖从浏览器端到服务器的全算力平台。相比上一代,检测精度提升 4.9%,识别精度提升 5.1%,其中 Medium 档在 Intel Xeon CPU 上端到端推理仅需 1.40 秒,速度达到 v5_server 的 5.2 倍;...
1. PP-OCRv6是什么
PP-OCRv6 是百度飞桨 PaddleOCR 团队推出的第六代开源 OCR 模型,首次以三档规格(Tiny 1.5M、Small 7.7M、Medium 34.5M)覆盖从浏览器端到服务器的全算力平台。相比上一代,检测精度提升 4.9%,识别精度提升 5.1%,其中 Medium 档在 Intel Xeon CPU 上端到端推理仅需 1.40 秒,速度达到 v5_server 的 5.2 倍;Tiny 档在浏览器端单图预测低至 97ms,实现了极轻量场景下的实时 OCR 能力。单模型支持语言从 4 种扩展至 50 种,并新增电路板、数码管、CAD 图纸、喷码点阵字符等工业场景专项优化,成为当前开源 OCR 领域在轻量、精度、鲁棒性三方面均衡性最强的模型之一。
技术定位与领域: PP-OCRv6 属于计算机视觉与自然语言处理的交叉领域——光学字符识别(OCR),具体聚焦于端到端文本检测与识别。其独特定位在于通过统一架构(MetaFormer 主干 + RepLKFPN 特征金字塔 + LightSVTR 轻量识别头)实现检测与识别的深度融合,并以三档参数规模适配从移动端到服务器的全场景部署,填补了极轻量级高精度 OCR 模型的市场空白。
研发背景: 百度飞桨 PaddleOCR 团队长期深耕 OCR 技术,此前已连续推出五代开源模型,积累了丰富的工业落地经验。PP-OCRv6 的研发动机源于实际部署中常见的算力瓶颈(浏览器端、嵌入式设备)、多语言混合文档处理需求以及工业场景(如电路板丝印、数码管读数)的精度不足。团队基于 LCNetV4 高效骨干、RepLKFPN 大核卷积特征融合以及 LightSVTR 轻量级 Transformer 识别器,在保持极低参数量的同时实现了代际精度跨越。
核心价值: 解决了传统 OCR 模型“精度-速度-轻量”不可兼得的难题。PP-OCRv6 以 34.5M 参数(Medium)在检测 Hmean 86.2%、识别准确率 83.2% 上超越 Qwen3-VL-235B、GPT-5.5 等百亿级视觉语言模型,同时保持极低幻觉率(忠实还原率 93.2%),避免了大模型常见的“篡改式”输出。此外,三档模型统一接口、自动下载权重、多后端推理支持(OpenVINO/ONNX/TensorRT)大幅降低了部署门槛。
技术特点: 采用 MetaFormer 统一架构实现检测与识别共享特征提取器,减少冗余计算;通过多尺寸训练策略和边缘扰动增强,使检测多尺寸预测一致性方差仅 5.19%(较 v5 降低 35%),识别边缘尺寸扰动一致性提升 20.5%,具备极高鲁棒性;支持 50 种语言单模型识别,无需切换模型即可处理中、英、日及 46 种拉丁语系混合文档。
2. 主要功能
三档模型灵活部署: 提供 Tiny(1.5M)、Small(7.7M)、Medium(34.5M)三种规格,分别适配浏览器端、嵌入式设备到服务器,按需选择开箱即用。Tiny 在纯浏览器前端单图预测低至 97ms,Medium 在 CPU 上端到端仅 1.40s,实现了极低算力到高精度场景的无缝覆盖。
高精度文本检测与识别: 端到端完成文字区域定位与内容识别,检测 Hmean 达 86.2%,识别准确率达 83.2%,较上一代实现代际跨越式提升。其中 Medium 档以 34.5M 参数超越百亿级视觉语言模型,在精度上展现出轻量模型的巨大优势。
50 种语言单模型覆盖: 单模型同时支持中文、英文、日文及 46 种拉丁语系语言,无需切换模型即可处理多语言混合文档。这一特性对于跨境电商、多语言说明书、国际化内容审核等场景尤为重要,显著简化了多语言 OCR 系统的维护成本。
工业场景专项增强: 新增电路板、数码管、CAD 图纸、喷码点阵字符、轮胎印刷等复杂工业场景的检测与识别能力。通过针对性的数据增强和模型训练,PP-OCRv6 在这些场景下的识别准确率较通用模型提升 10% 以上。
极速推理与低延迟: Tiny 档在纯浏览器前端单图预测低至 97ms;Medium 在 Intel Xeon CPU 上端到端仅 1.40 秒,速度为前代 server 模型的 5.2 倍。这一性能得益于 MetaFormer 统一架构和轻量级识别头 LightSVTR 的设计,大幅减少了计算冗余。
高鲁棒性稳定输出: 检测多尺寸预测一致性方差仅 5.19%(较 v5 降低 35%),识别边缘尺寸扰动一致性较 v5 提升 20.5%。模型对输入分辨率变化、裁剪边界偏移具有强抗干扰能力,确保在实际应用中(如扫描文档边缘裁剪)仍能稳定输出。
多后端与私有化部署: 支持 OpenVINO、ONNX Runtime、TensorRT 等推理后端,可在内网、离线及安全敏感环境中私有化部署。同时提供 C++ 推理接口,满足工业级低延迟需求。
结构化文档解析: 结合 PP-StructureV3,可将复杂 PDF 和图片转换为 Markdown 或 JSON 格式,输出细粒度的文本坐标与版面层级信息。该功能对于文档数字化、档案管理、数据录入等场景具有极高的实用价值。
3. 如何使用
环境要求与前置条件: 需要安装 Python 3.8+ 和 PaddleOCR 3.7.0+ 版本。推荐使用 pip 安装:
pip install paddleocr。若需 GPU 加速,请预先安装 CUDA 11.2+ 和 cuDNN 8.2+,并确保 PaddlePaddle GPU 版本已正确安装。系统支持 Linux、Windows 和 macOS。命令行快速调用: 安装完成后,打开终端执行以下命令即可对单张图片进行 OCR:
paddleocr ocr -i image.png --text_detection_model_name PP-OCRv6_medium_det --text_recognition_model_name PP-OCRv6_medium_rec首次运行时会自动从 HuggingFace 或 ModelScope 下载对应权重。如需使用 Tiny 或 Small 档,只需替换 model_name 为
PP-OCRv6_tiny_det/PP-OCRv6_small_det等即可。Python API 集成: 在代码中导入 PaddleOCR 并初始化:
from paddleocr import PaddleOCR ocr = PaddleOCR(text_detection_model_name="PP-OCRv6_medium_det", text_recognition_model_name="PP-OCRv6_small_rec") result = ocr.ocr("image.png") print(result)result为包含文本内容、置信度及坐标的列表。支持批量图片处理,只需传入图片列表即可。浏览器端前端部署: 选用 Tiny 档(1.5M)模型,通过 ONNX Runtime Web 或 OpenVINO 前端推理,在纯浏览器环境中实现单图 97ms 的极速预测。具体步骤为:将 Tiny 模型导出为 ONNX 格式,加载到前端页面,使用
ort.InferenceSession进行推理。无需后端服务器,适合在线文档扫描、即时文字提取等场景。多后端推理加速: 在生产环境中,可通过设置
--backend openvino或--backend tensorrt切换推理引擎。例如:paddleocr ocr -i image.png --backend openvino使用 TensorRT 时需预先安装 TensorRT 并配置环境变量,可显著提升 GPU 推理速度。
结构化文档解析: 安装 PP-StructureV3 模块(
pip install paddleocr-structure),然后调用:from paddleocr import PPStructure engine = PPStructure() result = engine("document.pdf") # result 为 Markdown 或 JSON 格式的结构化输出支持 PDF 和图片输入,输出包含文本内容、坐标位置及版面层级信息。
最佳实践与注意事项: 对于多语言文档,建议使用 Medium 档以获得最佳识别精度;对于移动端或浏览器,务必使用 Tiny 档。首次使用模型下载可能较慢,建议提前从 ModelScope 集合页下载到本地。若需离线部署,可将模型文件放置于指定目录,并通过
--model_dir参数指定路径。
4. 优缺点分析
| 优点 |
|---|
| 精度与轻量兼得: Medium 档以 34.5M 参数在检测 Hmean 86.2%、识别准确率 83.2% 上超越百亿级视觉语言模型,实现了极低参数量的高精度 OCR。 |
| 全算力平台覆盖: Tiny(1.5M)、Small(7.7M)、Medium(34.5M)三档模型从浏览器端到服务器无缝适配,统一接口便于按需切换。 |
| 极低幻觉率: 对原始文本(包括故意拼写错误)的忠实还原率达 93.2%,远高于通用大模型,避免了“幻觉式”篡改,适合金融、医疗等敏感场景。 |
| 推理速度极快: Medium 在 Intel Xeon CPU 上端到端仅 1.40s,Tiny 浏览器端 97ms,速度优势显著。 |
| 多后端与私有化部署: 支持 OpenVINO、ONNX Runtime、TensorRT 等后端,可在内网离线环境部署,满足数据安全要求。 |
5. 同类工具对比
| 对比维度 | PP-OCRv6 | EasyOCR | MMOCR |
|---|---|---|---|
| 核心架构 | 统一 MetaFormer(LCNetV4 + RepLKFPN + LightSVTR) | CRAFT/DB 检测 + CRNN 识别 | 模块化组合(DB/PSENet/FCENet + CRNN/SAR/NRTR) |
| 模型大小 | 1.5M–34.5M(极轻量) | 检测约 10M+,识别按语言累计 50M+ | 单模型 10M–100M+,可灵活配置 |
| 支持语言 | 50 种(中、英、日 + 46 种拉丁语系) | 80+ 种(包含非拉丁语系) | 依赖所选模型,需自行扩展 |
| 中文场景优化 | 深度优化竖排、古籍、拼音标注 | 一般水平,中文精度弱于 PP-OCR | 支持但需自行调优 |
| 工业场景 | 内置电路板、数码管、CAD、点阵字符等 | 通用场景为主,无工业专项 | 通用场景为主,无工业专项 |
| CPU 推理速度 | 极快:Tiny 浏览器 97ms,Medium CPU 1.40s | 中等,通常秒级 | 中等,通常秒级 |
| 浏览器部署 | 原生支持(Tiny 档 ONNX/Web) | 不支持原生浏览器推理 | 不支持 |
| 开源协议 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
选型建议: 如果部署环境为浏览器端或移动端,且对延迟要求极高(<100ms),PP-OCRv6 Tiny 档是唯一可用的选择。如果需要处理大量非拉丁语系语言(如阿拉伯语、泰语),EasyOCR 的语言覆盖更广,但中文和工业场景精度不如 PP-OCRv6。MMOCR 适合需要自定义检测与识别模型组合的学术研究场景,但部署复杂度较高。Tesseract OCR 虽然历史悠久、语言支持最多,但在速度和精度上已明显落后,仅适合对速度无要求的离线简单文档处理。
6. 编辑点评
PP-OCRv6 的发布标志着开源 OCR 领域进入了一个新的阶段——轻量模型在精度上可以超越百亿级视觉语言模型。这种“以小博大”的能力并非偶然:MetaFormer 统一架构将检测与识别的特征提取器合并,避免了传统两阶段模型的信息冗余;RepLKFPN 大核卷积有效扩大了感受野,提升了小文字和密集文本的检测能力;LightSVTR 轻量级识别头在保持 Transformer 序列建模优势的同时大幅减少了参数量。这些技术创新的组合使得 34.5M 参数的 Medium 模型在检测 Hmean 86.2% 上超越了 GPT-5.5 等巨无霸模型,同时保持了极低的幻觉率——这对于金融票据、医疗处方等对准确性要求极高的场景至关重要。
从实用价值看,三档模型的设计真正实现了“一套代码,全场景适配”。开发者只需替换模型名称即可在浏览器(Tiny)、嵌入式设备(Small)、服务器(Medium)之间无缝切换,无需修改任何业务逻辑。此外,50 种语言单模型覆盖、结构化文档解析、多后端推理支持等功能,使得 PP-OCRv6 成为当前开源 OCR 工具中综合实力最强的选择。
适用人群定位明确:前端开发者可借助 Tiny 档快速实现浏览器端 OCR;后端工程师可利用 Medium 档高精度处理文档数字化;工业质检团队可直接使用内置的工业场景模型进行自动化识别。对于学术研究者,PP-OCRv6 的轻量架构也提供了研究高效视觉特征融合的良好基准。
未来发展潜力方面,PP-OCRv6 展示了轻量模型在 OCR 领域的巨大潜力。未来若能将非拉丁语系(如阿拉伯语、泰语)纳入单模型支持,并进一步完善工业场景的专项微调文档,其应用边界将进一步拓展。此外,与 PP-StructureV3 的结合已经为文档理解 pipeline 奠定了基础,后续若能融入表格识别、公式识别等能力,将形成完整的文档智能处理方案。
7. 应用场景
移动端与边缘设备实时识别: Tiny 档(1.5M)可在手机、IoT 设备、嵌入式终端上实现毫秒级 OCR,适合离线扫描、快递面单识别、仓库条码读取等低功耗场景。模型大小仅 1.5M,可轻松集成到移动端应用中,无需联网即可运行。
浏览器端前端集成: 在纯网页环境中通过 ONNX Runtime Web 部署 Tiny 档,单图预测低至 97ms,无需后端服务器即可实现用户上传图片的即时文字提取。适用于在线文档扫描、图片转文字工具、表单自动填写等场景。
文档数字化与档案管理: 身份证、驾驶证、营业执照、发票、单据、合同等证件票据的批量结构化提取。结合 PP-StructureV3 输出 JSON/Markdown 格式,可直接导入数据库或业务系统,大幅提升档案处理效率。
金融与医疗数据录入: 凭借极低幻觉率(93.2% 忠实还原),精准识别票据、病历、处方、保单等对准确性要求极高的敏感文本。在金融风控、医疗信息系统中,避免因 OCR 错误导致的合规风险。
工业质检与自动化: 新增电路板丝印、数码管读数、CAD 图纸标注、喷码点阵字符、轮胎印刷、工业铭牌等复杂工业场景的自动化检测与识别。可在产线中集成,实现产品标签自动读取、质量追溯码识别等功能。
多语言国际化处理: 单模型覆盖 50 种语言,适用于跨境电商平台的多语言商品描述提取、外贸单据自动录入、多语言说明书内容审核、翻译预处理等场景。无需切换模型即可处理混合语言文档。
8. 常见问题FAQ
Q:PP-OCRv6 是否支持 GPU 加速?如何配置?
A:支持。安装 PaddleOCR 时选择 GPU 版本(pip install paddlepaddle-gpu),并确保 CUDA 11.2+ 和 cuDNN 8.2+ 已正确安装。在命令行或 API 中无需额外配置,框架会自动检测 GPU 并启用加速。
Q:Tiny 档在浏览器端如何部署?需要哪些依赖?
A:需要将 Tiny 模型导出为 ONNX 格式(官方提供预导出 ONNX 文件),然后在浏览器中使用 ONNX Runtime Web 库加载。无需后端服务器,仅需前端 JavaScript 环境。具体步骤可参考 PaddleOCR 官方文档中的“Web 部署”章节。
Q:PP-OCRv6 能否识别手写文字?
A:PP-OCRv6 主要针对印刷体优化,对手写文字的识别精度有限。如需识别手写,建议使用专门的 PaddleOCR 手写识别模型(如 PP-OCRv3_hand),或使用 PP-OCRv6 配合自定义手写数据集进行微调。
Q:如何将 PP-OCRv6 集成到自己的项目中?
A:推荐使用 Python API,只需安装 paddleocr 包并导入 PaddleOCR 类即可。对于 C++ 项目,PaddleOCR 提供了 C++ 推理接口,可通过 ONNX Runtime 或 Paddle Inference 加载模型。详细集成指南见官方 GitHub 仓库的“部署”章节。
Q:PP-OCRv6 支持哪些语言?如何添加新语言?
A:官方支持中文、英文、日文及 46 种拉丁语系语言(法语、德语、西班牙语等)。如需添加新语言(如泰语、阿拉伯语),需收集该语言的标注数据,使用 PaddleOCR 的训练工具进行微调。官方提供了训练脚本和示例数据格式。
Q:PP-OCRv6 相比 PP-OCRv5 有哪些主要改进?
A:主要改进包括:①检测精度提升 4.9%,识别精度提升 5.1%;②推理速度提升 5.2 倍(Medium vs v5_server);③三档模型覆盖全算力平台;④语言支持从 4 种扩展至 50 种;⑤新增工业场景专项优化;⑥鲁棒性大幅提升(检测一致性方差降低 35%)。
Q:PP-OCRv6 是否支持 PDF 文档直接输入?
A:原生不支持 PDF 输入,但可通过 PP-StructureV3 模块处理 PDF。PP-StructureV3 会自动将 PDF 页面转为图片,然后调用 PP-OCRv6 进行 OCR,最终输出结构化结果。建议使用 PPStructure 类而非直接调用 PaddleOCR。
9. 项目地址
- 项目官网: https://paddleocr.com
- ModelScope 模型集合页: https://modelscope.cn/collections/PaddlePaddle/PP-OCRv6
- GitHub 仓库: https://github.com/PaddlePaddle/PaddleOCR
相关推荐
MOSS-Image – 模思智能联合OpenMOSS开源的文生图模型
MOSS-Image是模思智能与OpenMOSS团队联合开源的文生图模型,其核心由5B参数的单流扩散Transformer(DiT)主干构成,配合冻结的Qwen3.5-9B文本编码器与FLUX.2 VAE,权重采用Apache-2.0协议发布。该模型在训练阶段剔除AI生成图像以降低"AI味",并针对中英文密集文本渲染、JSON Layout/Bounding Box结构化布局控制以及最长4096 ...
Claude Sonnet 5.5 – Anthropic 推出的最新 AI 模型
Claude Sonnet 5.5 是 Anthropic 推出的 Claude 5.5 系列第二款模型,距旗舰 Claude Opus 5.5 发布仅隔 6 天,是 Claude Sonnet 5 的全面升级版。该模型定位为 Opus 5.5 的互补与平替,专注于处理范围明确的日常任务,在 Terminal-Bench 4.0 上取得 70.6% 的成绩,多数基准逼近旗舰水平,擅长日常编程、修复...
Ok Work – 百度推出的 AI 随身办公工具
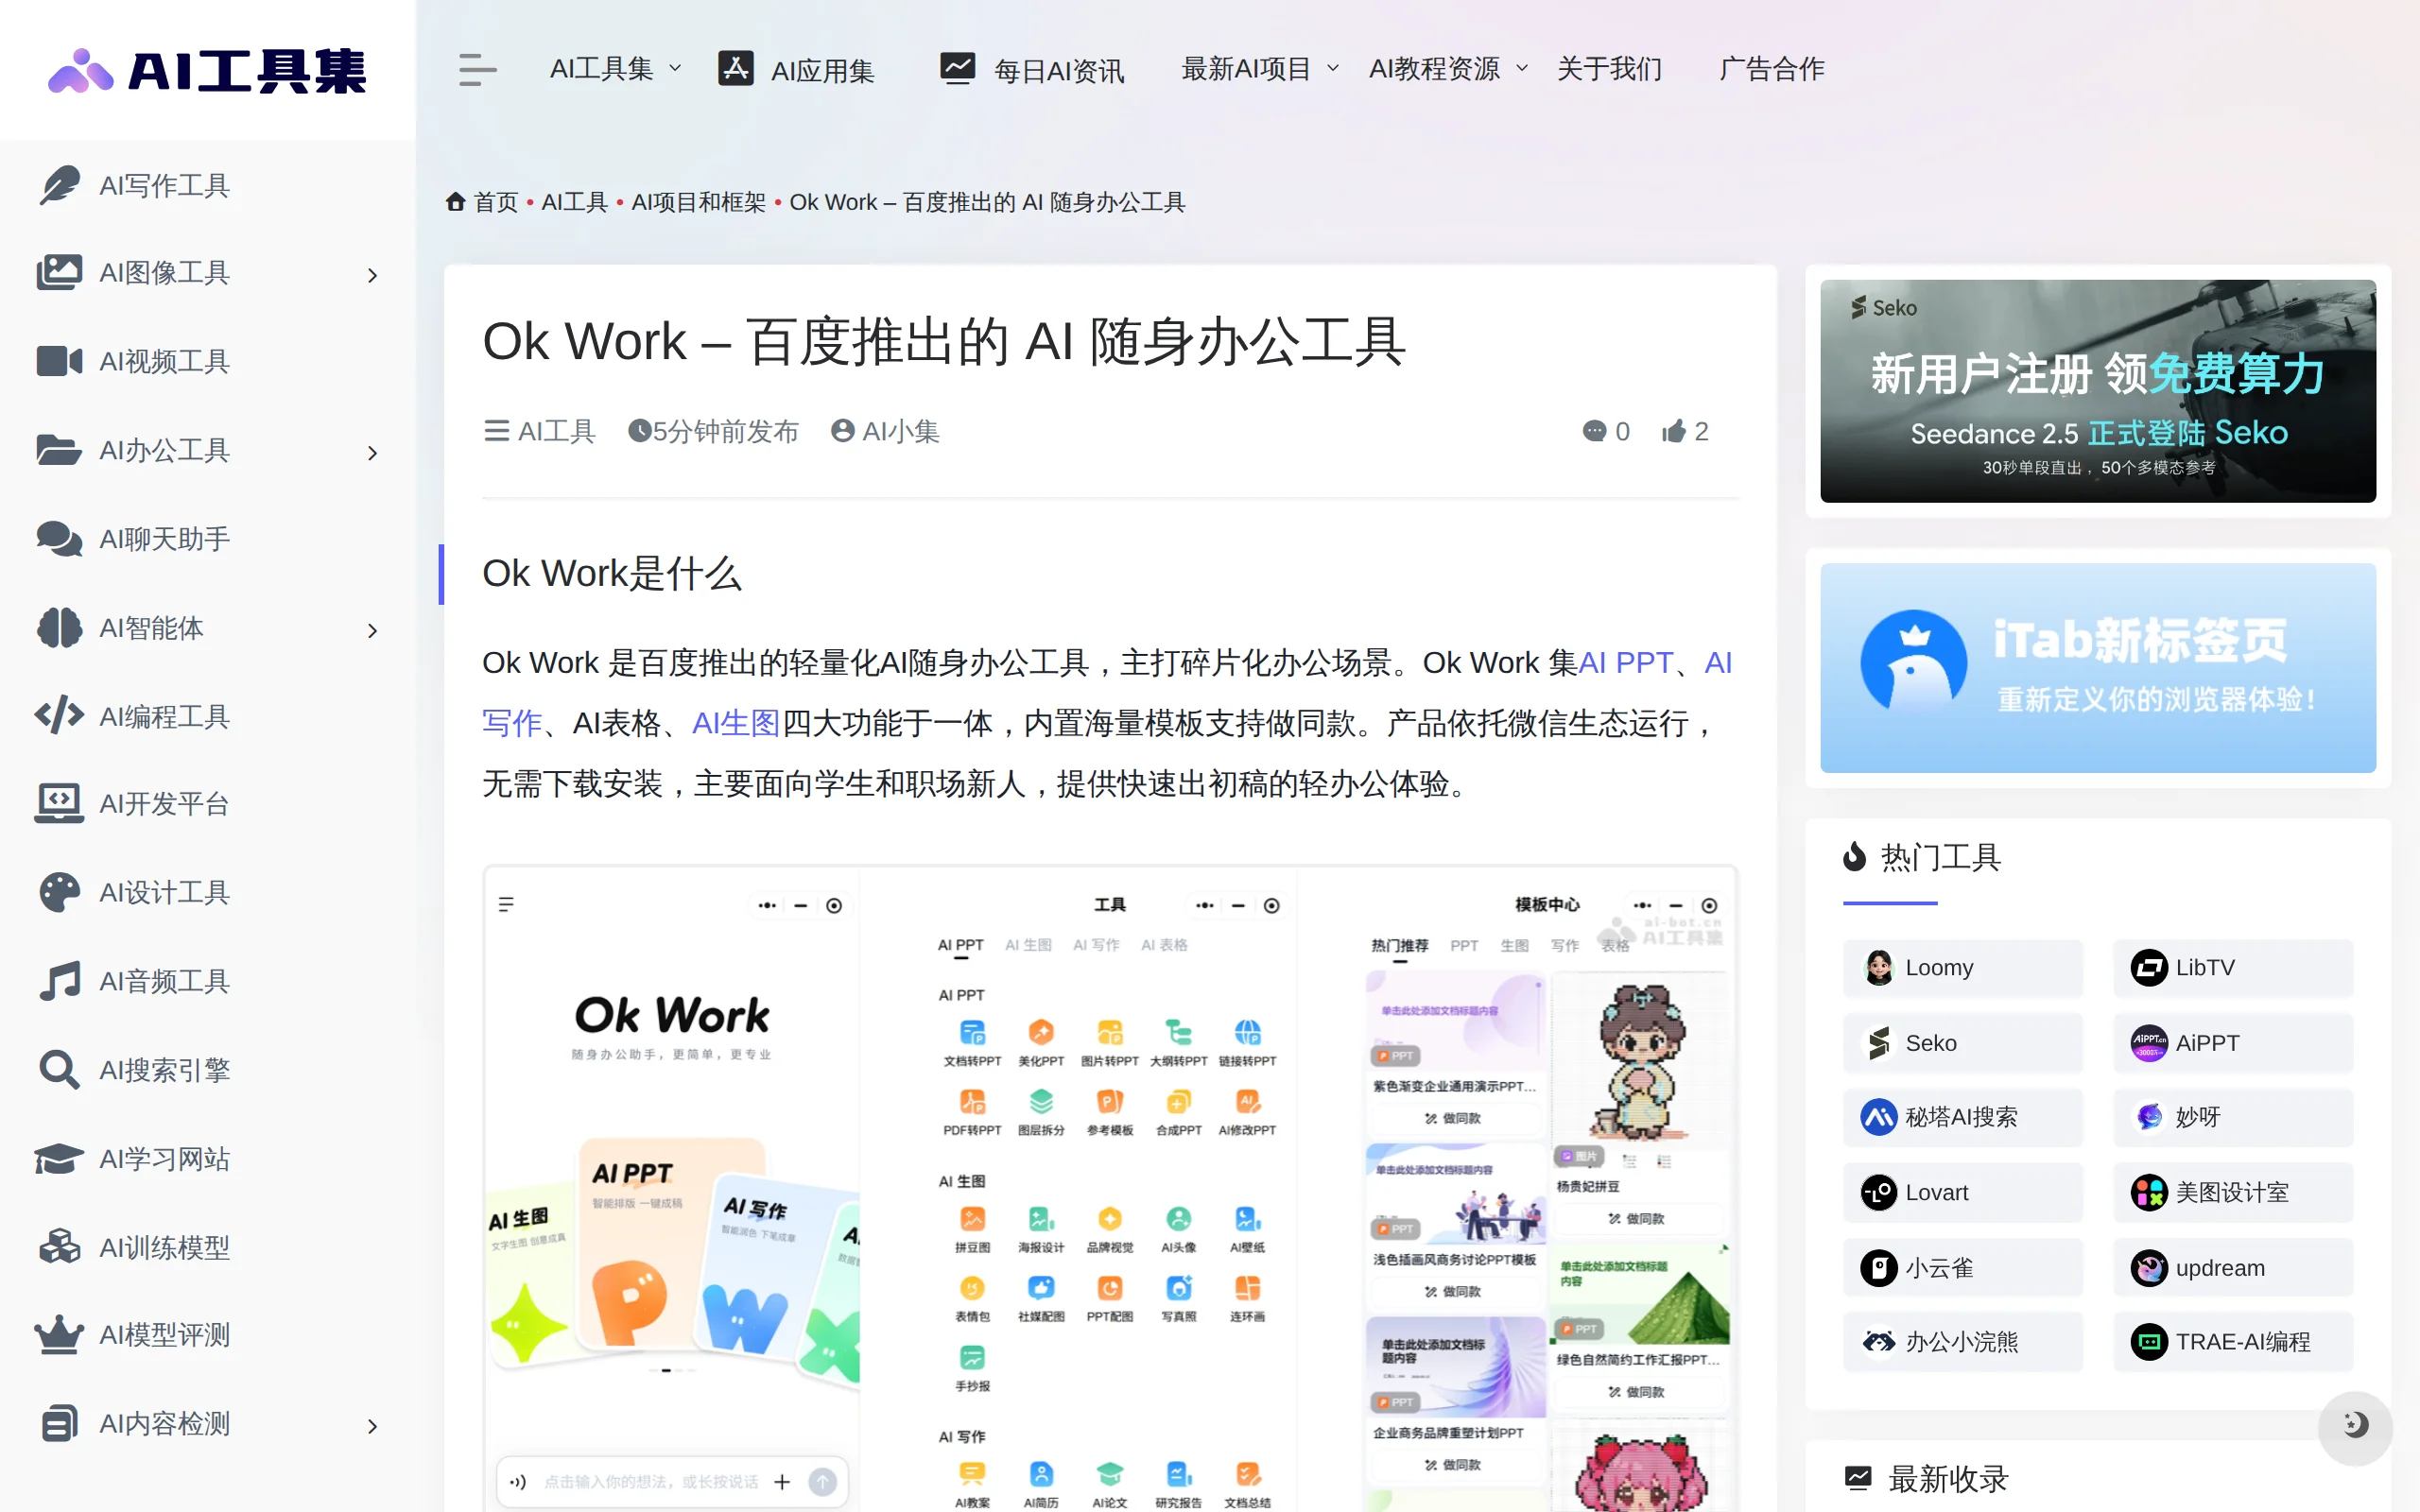
Ok Work是百度推出的轻量化AI随身办公工具,以微信小程序形态运行,面向学生与职场新人,聚焦碎片化办公场景。产品将AI PPT、AI写作、AI表格、AI生图四大核心能力整合于同一对话界面,内置海量模板并支持"做同款"快速套用,无需下载安装即可完成从内容生成、文档转换到视觉设计的完整轻办公流程。依托文心大模型的底层能力,Ok Work将复杂的AI能力拆解为颗粒度精细的具体小工具,以极低的上手门槛...
TeleOCR – 中国电信星辰实验室开源的文档解析模型深度评测
TeleOCR 是中国电信星辰实验室开源的文档解析模型,采用约 1.2B 参数的轻量级视觉语言架构,在单一框架内统一处理数字文档与相机拍摄文档,可将文字、版面、表格、公式和科学图表解析为 Markdown、JSON 等结构化结果。该模型在 OmniDocBench v1.6 榜单中登顶,同时获得 PureDocBench 榜首和 ICDAR-2026 科学图解析挑战赛冠军,支持本地 GPU 部署,...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。