
SeFi-Image – 开源的文本到图像模型,基于语义优先扩散

导读摘要:
SeFi-Image是一种基于语义优先扩散架构的开源文本到图像生成模型,提供1B、2B、5B三种参数规格。该模型通过将高层语义结构与纹理细节分离,并引入时序偏移机制,使语义流提前一个时间步开始去噪,从而为纹理生成提供清晰的结构锚点。5B模型仅需125K A800 GPU小时即可完成训练,在GenEval、LongTextBench、CVTG-2K和OneIG等多项基准测试中表现强劲,支持场景合成、...
1. SeFi-Image是什么
SeFi-Image是一种基于语义优先扩散架构的开源文本到图像生成模型,提供1B、2B、5B三种参数规格。该模型通过将高层语义结构与纹理细节分离,并引入时序偏移机制,使语义流提前一个时间步开始去噪,从而为纹理生成提供清晰的结构锚点。5B模型仅需125K A800 GPU小时即可完成训练,在GenEval、LongTextBench、CVTG-2K和OneIG等多项基准测试中表现强劲,支持场景合成、富文本排版、动漫角色、风格多样性及人像生成等多样化任务。
技术定位与领域: SeFi-Image属于计算机视觉与自然语言处理交叉领域的文本到图像生成模型。其独特之处在于采用语义优先扩散架构,将传统的单一扩散过程拆分为语义流和纹理流两条独立轨迹,并通过时序偏移实现异步去噪,从而在复杂场景合成和文本渲染等需要精确结构控制的任务中展现出明显优势。该模型定位于填补现有扩散模型在高层语义引导方面的空白,为生成式AI提供更可控的结构化生成方案。
研发背景: 该模型由研究团队(项目作者等)开发,旨在克服当前主流扩散模型在语义结构控制上的系统性不足。现有模型在处理复杂组合关系、多物体布局以及嵌入长文本时,常出现语义混淆、物体错位或文字模糊等问题。SeFi-Image通过显式分离高层语义与低层纹理,为这些痛点提供了一种端到端的解决方案。研发动机源于对图像生成中“先结构后细节”这一人类创作逻辑的模拟,力求在机器生成中复现类似的层次化构建过程。
核心价值: SeFi-Image的核心价值在于解决了文本到图像生成中结构控制不精确的长期难题,尤其是在需要同时协调多个物体、空间关系或嵌入可读文字的复杂场景中。其语义优先机制使得生成图像在几何布局、物体遮挡关系和文字排版上的准确度显著提升,同时不牺牲纹理细节的丰富性。此外,极低的训练成本(5B模型仅125K GPU小时)大幅降低了高质量图像生成模型的研发门槛,使得更多研究团队和中小型企业能够基于此架构进行二次开发。
技术特点: 核心技术包括语义-纹理解耦架构、时序偏移机制和三阶段生成流程。语义流和纹理流各自拥有独立的去噪轨迹,时序偏移确保语义结构先于纹理形成,从而为后续纹理生成提供稳定的结构锚点。三阶段流程涵盖语义初始化、异步联合去噪和纹理精修补全,在提升纹理重建保真度的同时,通过异步机制平衡了重建与生成之间的矛盾。这一架构使得模型在复杂语义组合和长文本渲染任务上实现了质的飞跃。
2. 主要功能
文本到图像生成: 用户输入自然语言描述,模型即可生成对应的高质量图像。支持复杂场景描述、物体关系、风格属性及文字嵌入等多种指令,生成结果在结构准确性和视觉质量上均达到行业领先水平。该功能基于语义优先扩散,确保语义理解准确映射到图像布局。
多规格模型选择: 提供1B、2B、5B三种参数规模,适配不同计算资源和质量需求。1B模型适合快速原型验证和低显存环境(如消费级显卡),5B模型追求最佳生成质量与结构控制能力。用户可根据任务复杂度灵活切换,实现效率与效果的平衡。
语义优先扩散机制: 核心创新功能,将语义结构与纹理细节分离生成。通过时序偏移,语义流提前一个时间步开始去噪,为纹理流提供清晰的结构锚点。这使得模型在复杂空间关系、多物体组合和文字排版上具有显著优势,减少语义混淆和结构错乱。
长文本渲染能力: 支持中英文长文本提示,在LongTextBench基准上取得0.978分,显著领先同类竞品。能够生成包含大量文字的海报、菜单、标签等商业素材,文字清晰可读且排版合理。该功能对广告设计和品牌物料制作具有直接实用价值。
多领域生成支持: 覆盖场景合成、富文本排版、动漫角色、风格化艺术及人像摄影等多种领域。模型在风格多样性上表现突出,可生成插画、水墨、毛绒玩具、贴纸、素描等艺术风格,满足创作者在不同视觉场景下的需求。
高效的训练与推理: 5B模型仅用125K A800 GPU小时完成训练,相比同类模型大幅降低算力成本。推理时语义优先架构通过结构化引导减少无效计算,在保证生成质量的同时提升采样速度。该特性使得模型在资源受限的环境下仍能高效运行。
精准结构控制: 语义优先机制使模型能精确控制物体空间关系、遮挡顺序和文字嵌入位置。在CVTG-2K字符级视觉文本生成测试中达到0.895准确率,生成的海报和标签具有高度可读性,显著优于常规扩散模型。
多基准领先表现: 在GenEval(0.88)、OneIG-EN(0.5606)等多项权威基准中均排名第一,展现出全面的生成能力。该功能验证了模型在通用图像生成、文本渲染和风格多样性上的综合实力,为用户提供了可靠的性能保障。
3. 如何使用
环境要求: 建议使用NVIDIA A100或同等性能的GPU,5B模型需要至少40GB显存;2B模型推荐RTX 4090(24GB);1B模型可在RTX 3060(12GB)上运行。操作系统推荐Linux(Ubuntu 20.04+),需安装Python 3.8及以上版本、PyTorch 2.0+、CUDA 11.8+以及相关深度学习依赖库。
获取资源: 访问项目官网(sefi-web)获取论文和代码链接,或直接访问GitHub仓库下载推理源码。模型权重文件需从HuggingFace模型库(SeFi-Image)下载,根据需求选择1B、2B或5B规格的检查点文件,建议验证文件完整性。
配置环境: 创建Python虚拟环境,使用pip安装依赖包,包括diffusers、transformers、accelerate、safetensors等。根据模型规格调整配置文件,设置采样步数(默认50步)、引导比例(建议7.5)和输出分辨率。首次运行可能需要下载缓存组件。
加载模型: 使用官方提供的加载脚本(如load_model.py)初始化模型,指定模型路径和规格参数。支持从本地路径或HuggingFace自动下载。加载完成后可通过打印模型结构确认权重正确加载。
输入提示: 编写文本提示词,可包含场景描述、风格指令、文字内容等。支持中英文混合输入,长文本提示建议使用逗号或句号分隔语义单元。示例:“一只穿着西装的猫,坐在办公室桌前,桌上放着一杯咖啡,背景是城市夜景,海报风格”。
执行生成: 运行推理脚本(如python inference.py --prompt "..." --model_path ./sefi-5b)。模型自动执行语义优先扩散流程,先进行语义初始化,再异步联合去噪,最后纹理精修补全。可通过调整--num_inference_steps控制生成质量与速度。
输出结果: 生成图像默认保存为PNG格式,支持自定义输出目录和文件名。可通过参数设置输出分辨率(如1024x1024),支持批量生成多个提示词。建议使用--seed参数固定随机种子以便复现结果。
注意事项: 使用5B模型时务必确保显存充足;长文本提示不宜超过512个字符;首次推理可能需要较长时间加载模型;建议使用官方推荐的采样参数组合(引导比例7.5,步数50)获得最佳效果。若显存不足,可启用CPU卸载或降低分辨率。
4. 优缺点分析
| 优点 |
|---|
| 精准结构控制: 语义优先机制使模型能精确控制物体空间关系和文字布局,减少语义混淆,生成结果几何结构清晰,在复杂组合场景中表现突出。 |
| 训练成本低: 5B模型仅用125K A800 GPU小时完成训练,相比同类模型(如SD3 Medium)大幅降低算力需求,资源效率突出,适合研究机构。 |
| 长文本渲染领先: 在LongTextBench上取得0.978分,显著优于Qwen-Image(0.945)等竞品,适合广告海报等文字密集型场景,文字清晰可读。 |
| 多基准表现优异: 在GenEval(0.88)、CVTG-2K(0.895)、OneIG-EN(0.5606)等多项基准中排名第一,综合生成能力全面,验证了架构的有效性。 |
5. 同类工具对比
| 对比维度 | SeFi-Image-5B | Qwen-Image |
|---|---|---|
| 核心架构 | 语义优先扩散,语义流与纹理流解耦,引入时序偏移机制 | 常规扩散或自回归架构,未明确采用语义-纹理分离 |
| GenEval得分 | 0.88(第一) | 0.87 |
| LongTextBench | 0.978(第一) | 0.945 |
| CVTG-2K得分 | 0.895(第一) | 0.829 |
| 开源协议 | 开源(具体协议待确认) | 开源(Apache 2.0) |
| 社区生态 | 新兴,社区规模较小,资源有限 | 阿里云支持,社区中等,中文资源丰富 |
| 训练成本 | 125K A800 GPU小时(5B) | 未公开 |
选型建议: 对于需要精确结构控制和长文本渲染的用户,SeFi-Image是最佳选择,其在GenEval、LongTextBench等多个基准上的领先表现证明了其在复杂场景合成和文字嵌入方面的独特优势。尤其适合广告设计、动漫创作等对布局和文字可读性要求高的应用场景。但需注意其硬件门槛较高,且社区生态尚在成长中,适合有技术能力的团队进行深度集成。
对于追求成熟生态和广泛社区支持的用户,Stable Diffusion 3 Medium是更稳妥的选择。其庞大的社区提供了丰富的LoRA、ControlNet等扩展资源,且对消费级显卡的适配更好。虽然在某些基准上不及SeFi-Image,但在通用生成任务和易用性上具备优势。对于中文场景优先的用户,Qwen-Image在中文基准上略胜一筹,且背靠阿里云生态,部署和集成便利性较高,适合国内企业和开发者使用。
6. 编辑总结
SeFi-Image在技术创新上展现了鲜明的特色。语义-纹理解耦架构与时序偏移机制并非简单的增量改进,而是对扩散模型生成流程的重新设计。通过将高层语义引导前置,模型在复杂组合和长文本渲染任务中取得了可量化的显著提升,这为后续的结构可控生成研究提供了新的范式。从实用价值来看,SeFi-Image在广告海报、动漫角色、风格化艺术等场景中具有直接的应用潜力,其低训练成本特性使得更多团队能够基于此架构进行定制化开发,降低了高质量图像生成模型的研发门槛。该模型主要面向具备深度学习基础的研究人员、AI应用开发者以及需要高质量视觉素材的设计团队。对于追求最新技术成果的学术机构和技术领先型企业,SeFi-Image是一个值得深入研究的基座模型。未来发展方面,随着社区生态的逐步完善和更多下游扩展的涌现,SeFi-Image有望在文本到图像生成领域占据重要位置,尤其是在需要精确结构控制的垂直场景中,其优势将进一步放大。但当前仍需解决硬件门槛和文档完善度等落地障碍,以扩大用户基础。
7. 应用场景
广告海报设计: 在广告与海报设计领域,SeFi-Image能生成包含清晰可读文字的品牌海报、产品菜单和商品标签。其长文本渲染能力确保文字准确嵌入图像,语义优先架构保证排版布局合理,可大幅提升设计效率,减少后期文字修正工作。
动漫角色创作: 对于动漫与角色创作,模型支持生成动漫角色、奇幻场景以及全身或特写等多种构图形式。语义结构控制使得角色姿态、多人互动和场景组合更加协调,创作者可通过文本提示快速迭代角色设计,加速概念艺术创作流程。
自然场景生成: 在自然场景与景观生成方面,SeFi-Image可创作天气、城市、动物及自由宽高比的风景图像。模型对复杂场景的组合能力优于常规扩散模型,能够同时处理多个物体和空间关系,生成具有真实感的自然环境图像。
艺术风格创作: 模型支持插画、水墨、毛绒玩具、贴纸、素描等多种艺术风格,适用于风格化视觉内容创作。用户可通过文本提示轻松切换风格,无需额外训练,适合社交媒体内容、产品包装和艺术实验等场景。
人像摄影辅助: 在人像与摄影辅助场景中,SeFi-Image能生成具有多样光照、姿态和材质的人像及环境肖像。语义优先机制确保人物结构准确,面部特征和肢体比例自然,可用于模特样片生成、摄影构图参考等商业用途。
8. 常见问题FAQ
Q:SeFi-Image与Stable Diffusion相比有什么核心优势?
A:SeFi-Image的核心优势在于语义优先扩散架构,能够更精确地控制物体空间关系和文字布局,尤其在长文本渲染和复杂场景合成上表现突出。Stable Diffusion在社区生态和插件丰富度上更成熟,但在结构控制精度上不及SeFi-Image。
Q:运行SeFi-Image需要什么样的硬件配置?
A:1B模型可在消费级显卡(如RTX 3060 12GB)上运行,2B模型推荐RTX 4090 24GB,5B模型则需要NVIDIA A100 40GB或以上。建议使用Linux系统以获得最佳性能,显存不足时可启用CPU卸载或降低分辨率。
Q:SeFi-Image是否支持中文输入?
A:支持中文和英文输入。模型在中文长文本渲染上表现良好,但在OneIG-ZH基准上略低于Qwen-Image,中文场景仍有优化空间。建议使用中英文混合提示以获得更稳定的效果。
Q:模型权重是否开源?是否可以商用?
A:模型权重和代码已在GitHub和HuggingFace开源,具体许可证需查看项目仓库中的LICENSE文件。目前项目未明确限制商用,建议商用前仔细阅读协议条款,确认是否符合使用要求。
Q:如何快速上手SeFi-Image?
A:首先从GitHub下载代码和模型权重,安装依赖后运行官方示例脚本。官方提供了简单的推理代码,用户只需修改提示词即可生成图像。详细文档可参考项目官网和arXiv论文,社区讨论可在GitHub Issues中查阅。
Q:SeFi-Image的训练数据是什么?
A:具体训练数据集未公开,但模型在多个公开基准上表现优异,表明训练数据覆盖了多样化的场景和风格。用户可参考论文了解数据构建方法和预处理流程,以便进行针对性的微调或适配。
Q:SeFi-Image支持哪些输出分辨率?
A:模型支持常见的正方形和矩形分辨率,如512x512、1024x1024、1024x768等。推荐使用1024x1024以获得最佳质量,输出分辨率可通过配置文件调整,但需注意显存占用会随分辨率增加。
9. 项目地址
- 项目官网:https://jmliu206.github.io/sefi-web/
- GitHub仓库:https://github.com/jmliu206/SeFi-Image
- HuggingFace模型库:https://huggingface.co/SeFi-Image
- arXiv技术论文:https://arxiv.org/pdf/2606.22568
相关推荐
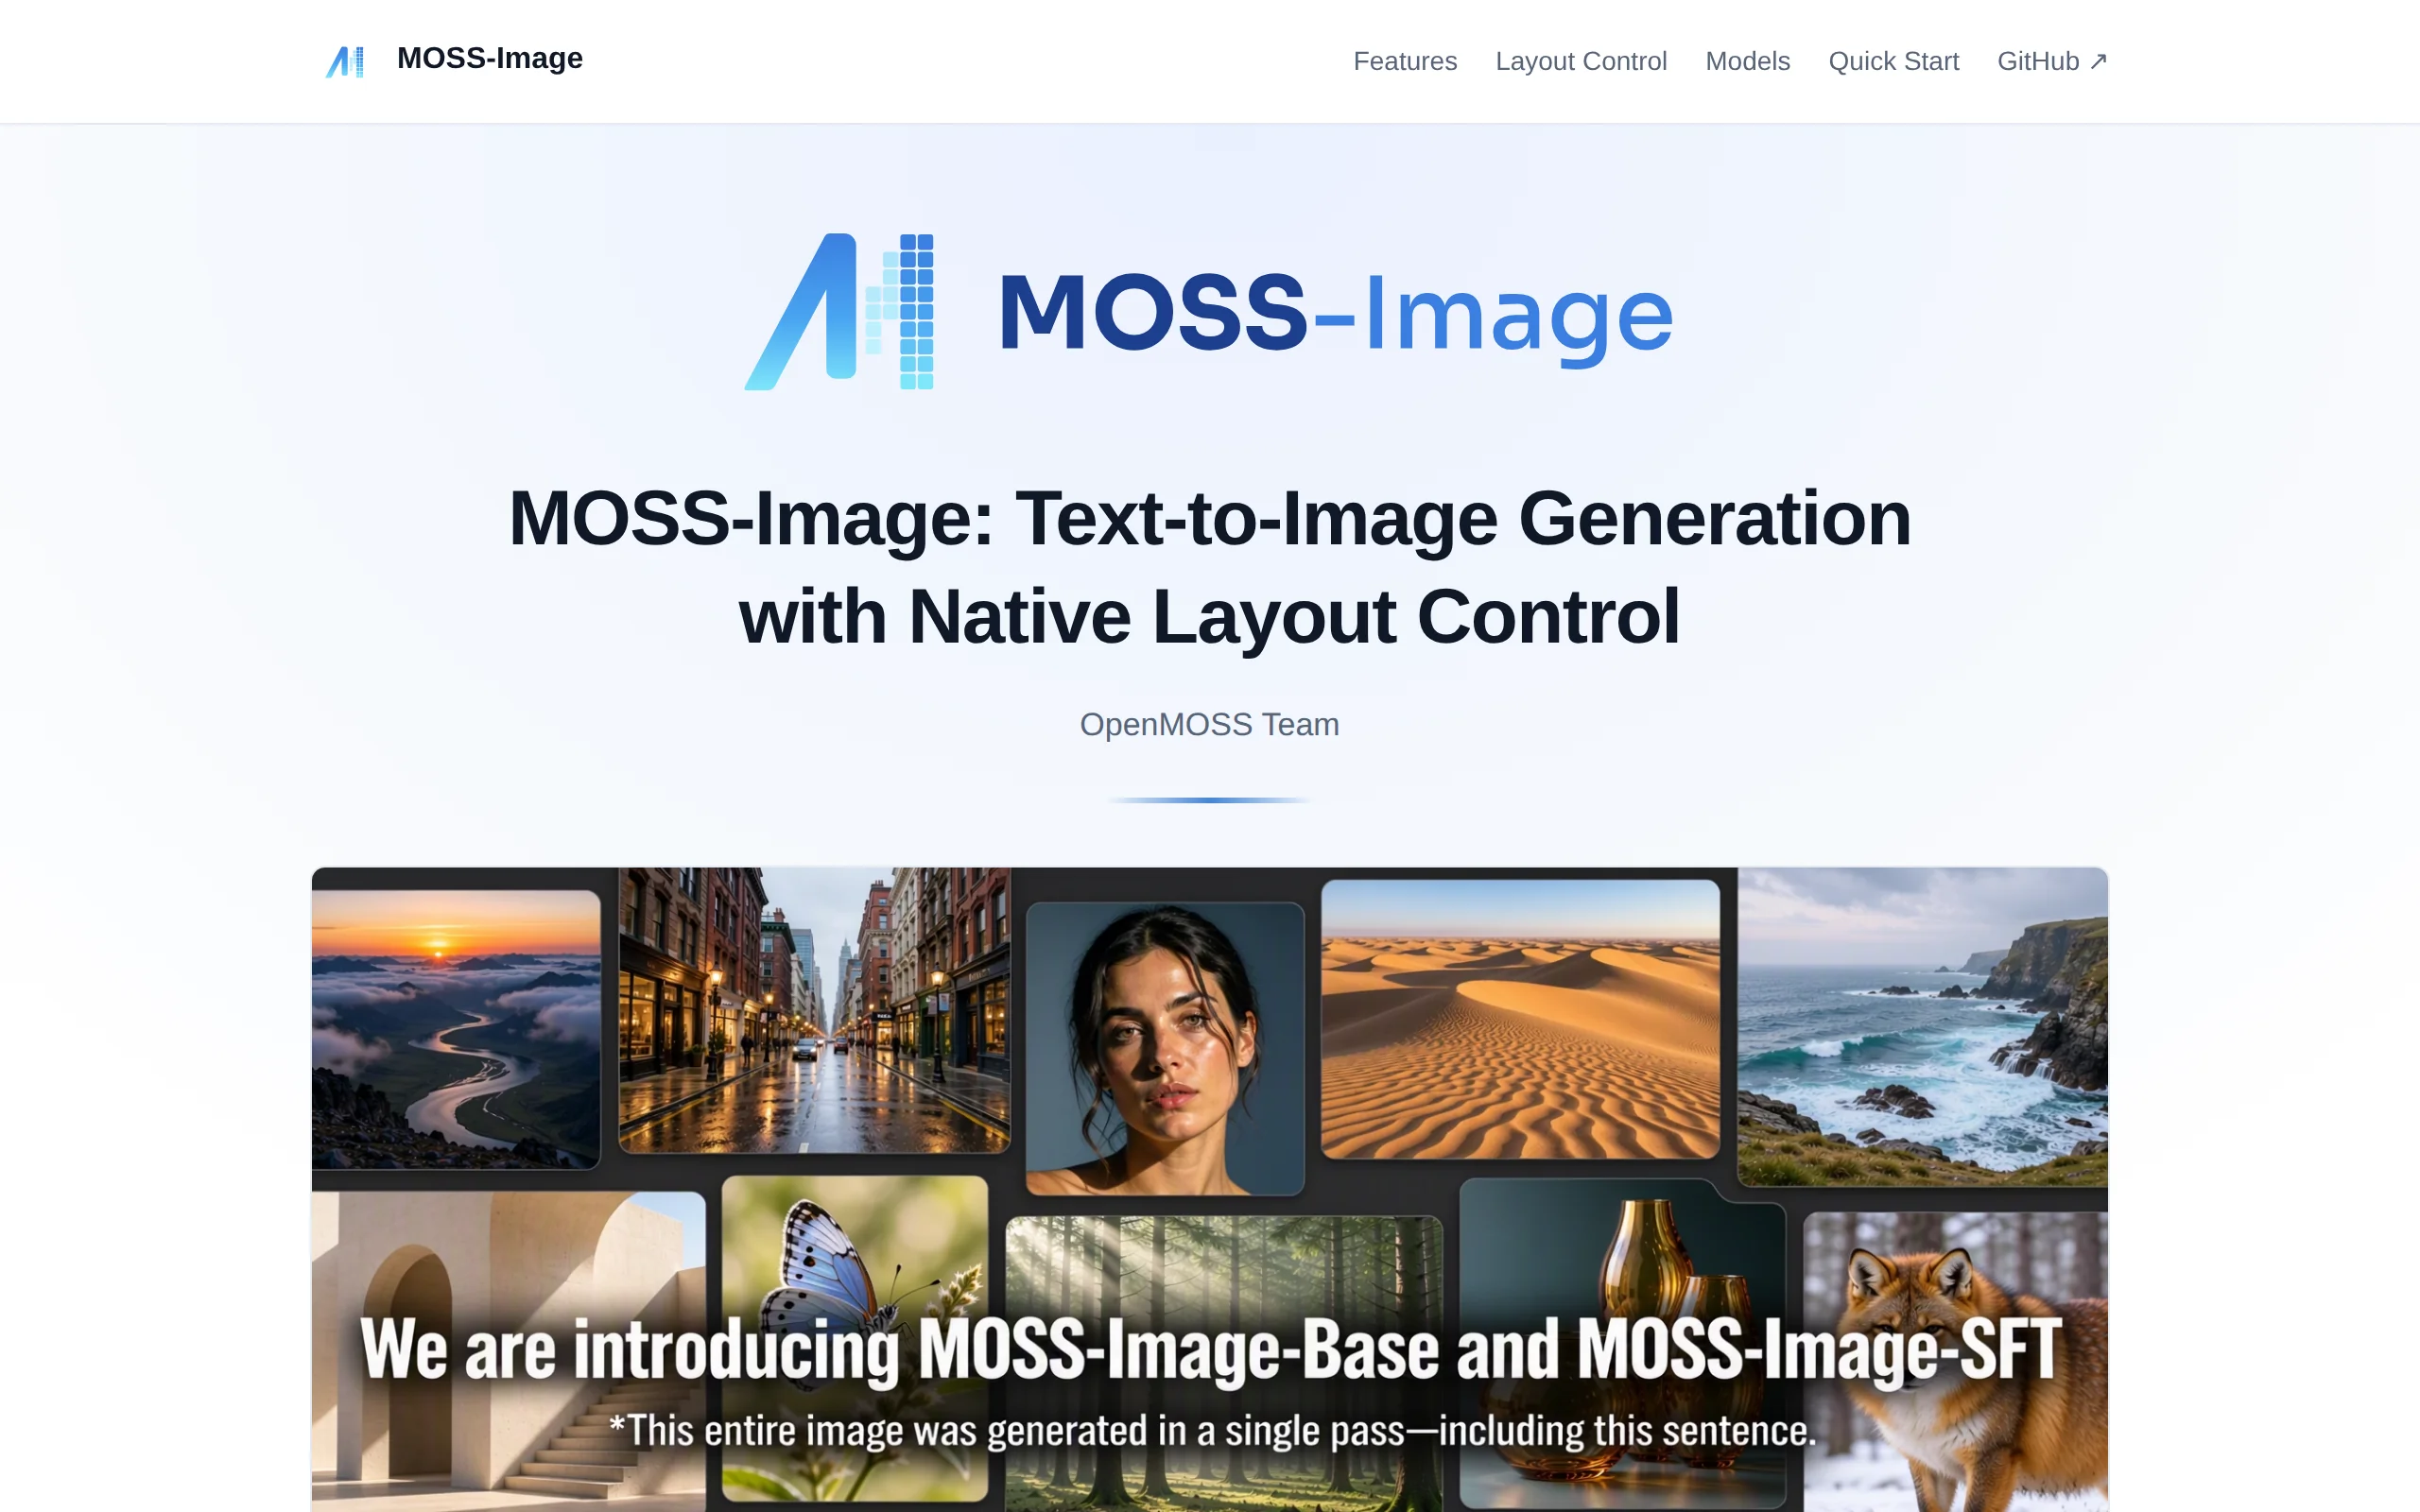
MOSS-Image – 模思智能联合OpenMOSS开源的文生图模型
MOSS-Image是模思智能与OpenMOSS团队联合开源的文生图模型,其核心由5B参数的单流扩散Transformer(DiT)主干构成,配合冻结的Qwen3.5-9B文本编码器与FLUX.2 VAE,权重采用Apache-2.0协议发布。该模型在训练阶段剔除AI生成图像以降低"AI味",并针对中英文密集文本渲染、JSON Layout/Bounding Box结构化布局控制以及最长4096 ...
FLUX 3 Max – fal 与 Black Forest Labs 推出的视频生成模型深度评测
FLUX 3 Max 是由 fal Research 与 Black Forest Labs 联合推出的后训练视频生成模型,基于 BFL 自研的 FLUX 3 多模态基础模型,支持文生视频、图生视频与关键帧插值三种工作流,可生成 5–20 秒、最高 1080p 分辨率且自带原生音频的视频内容。该模型主打极致推理速度与成本效率,10 秒成片约 12 秒完成生成,官方宣称在同画质条件下比 Seedan...
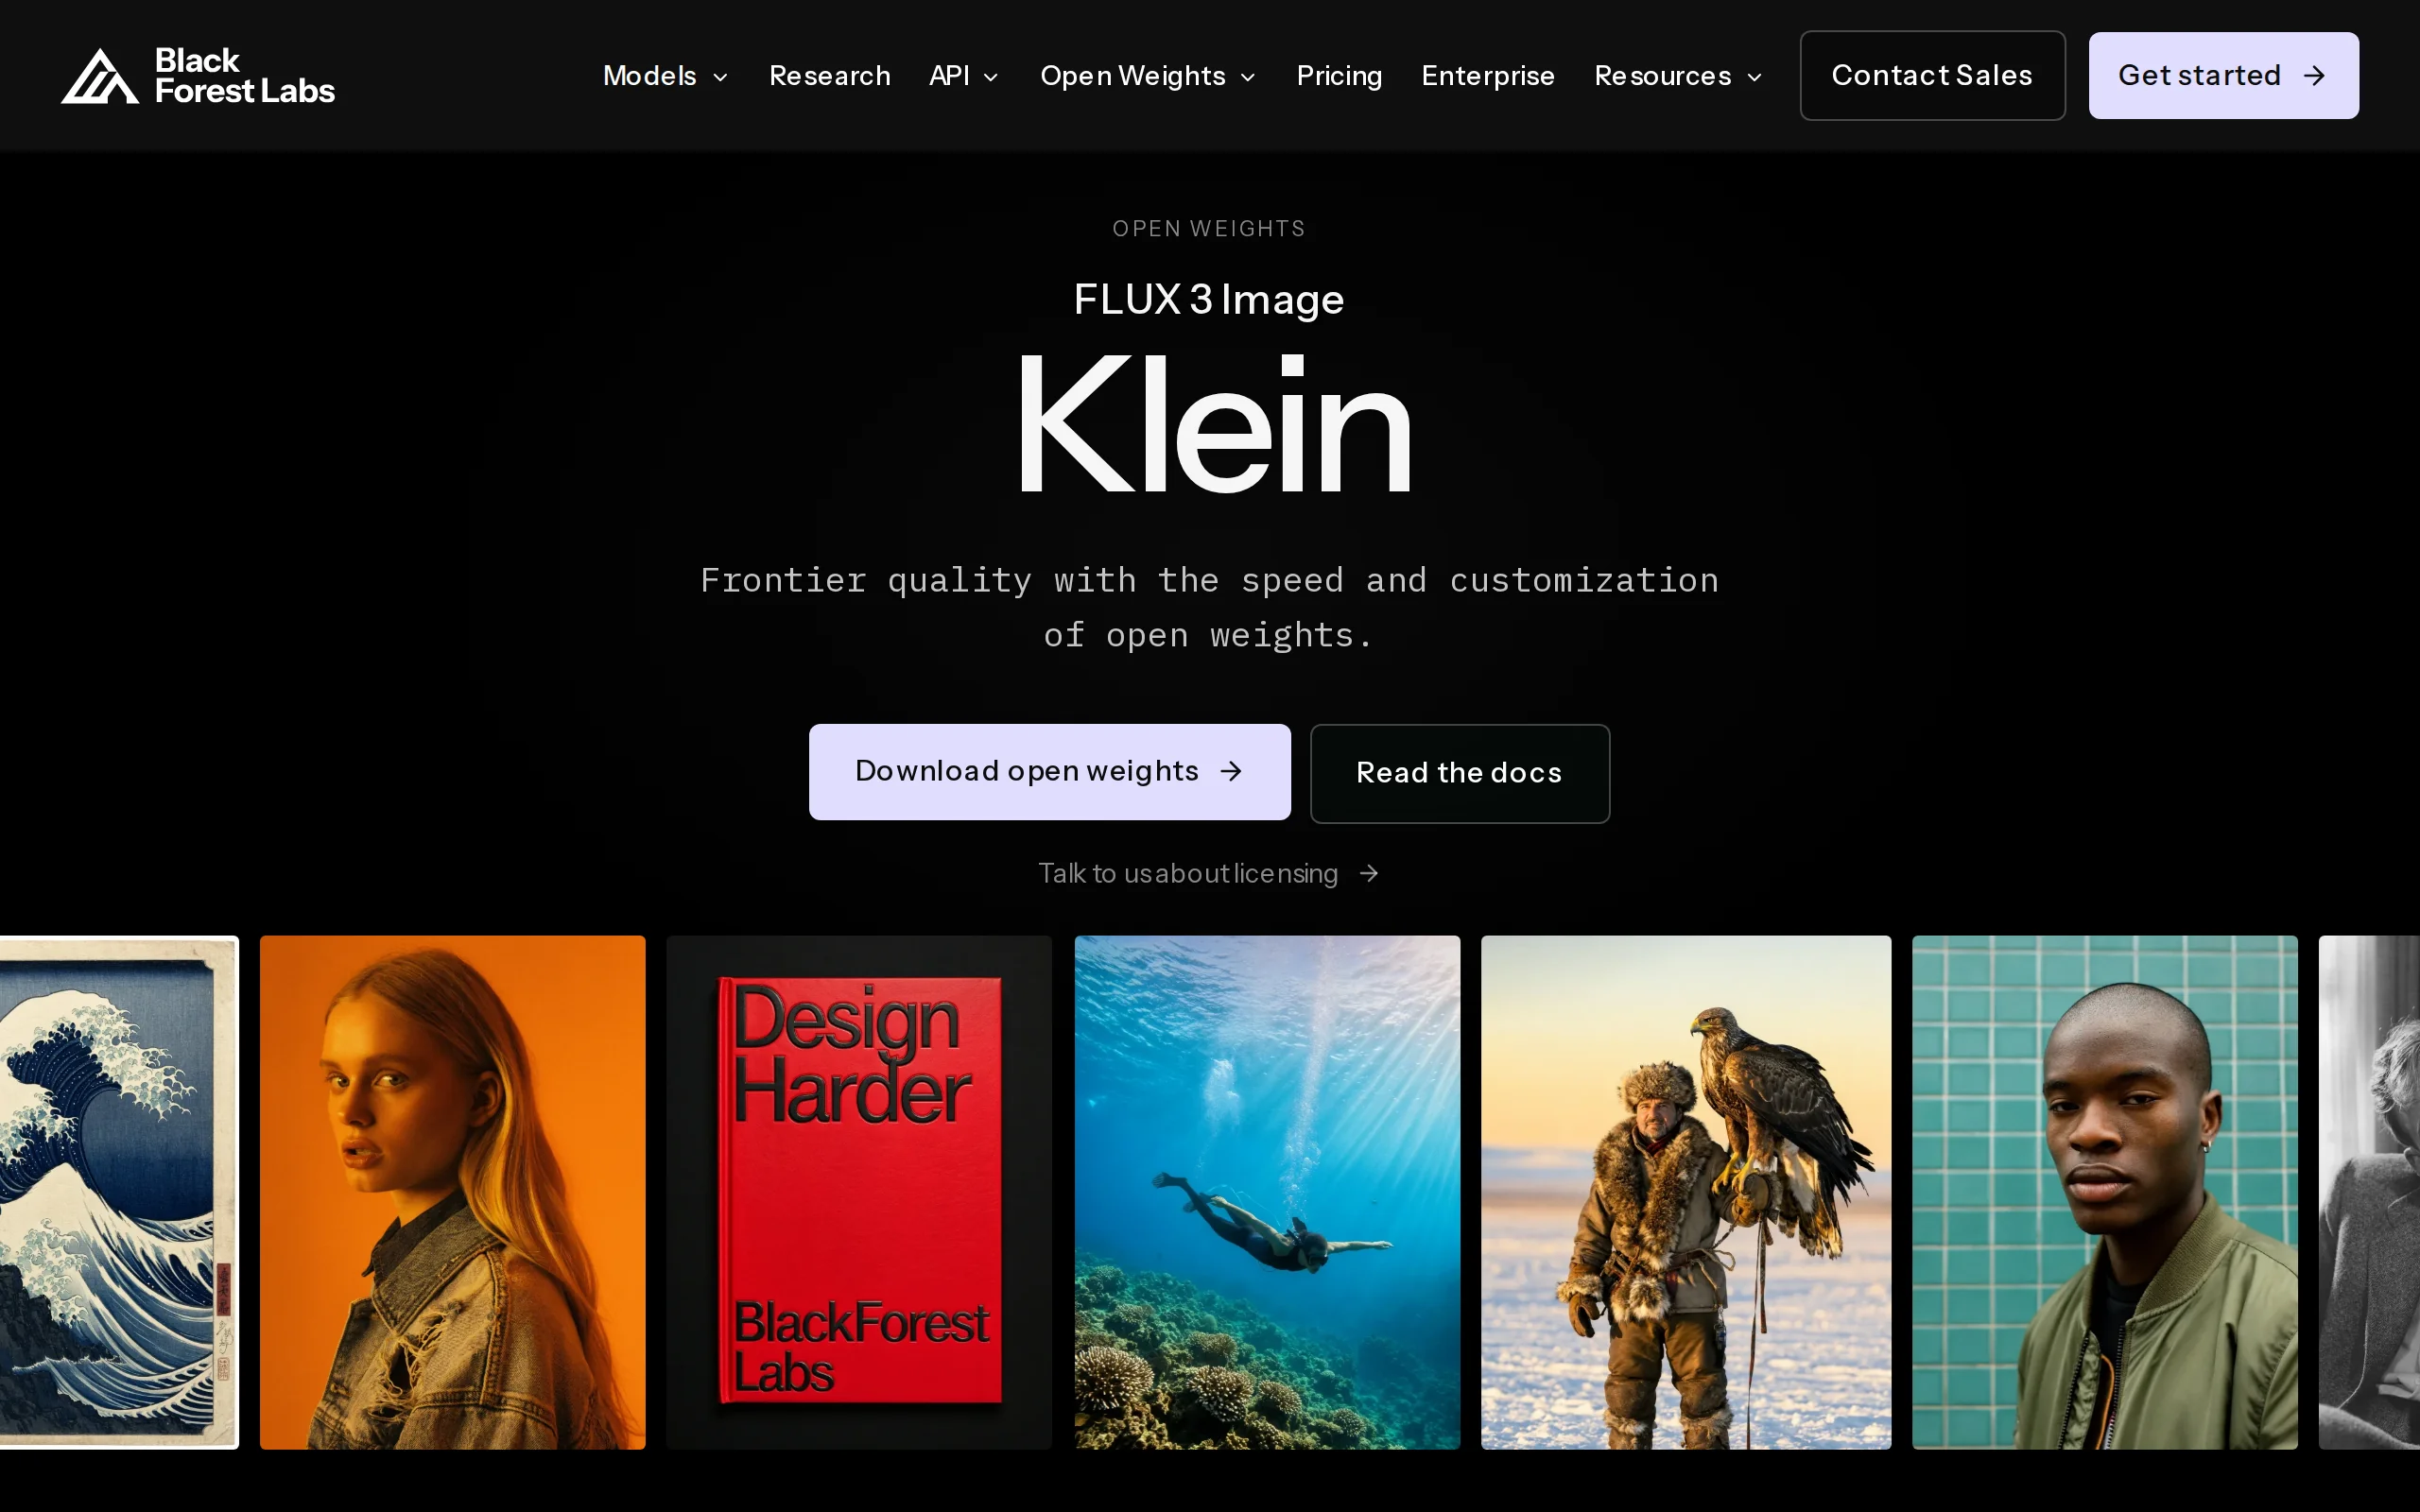
FLUX 3 Image Klein – Black Forest Labs 开源的AI图像模型
FLUX 3 Image Klein 是由 Black Forest Labs 开源的 AI 图像生成模型,以仅 5.6B 参数的轻量级体量实现了此前需要数十亿参数乃至闭源大模型才能达成的能力。该模型同时支持文生图、指令式图编辑以及最多 10 张参考图的多图生成,具备原生 4K 输出、像素级精确编辑和坐标框布局控制等差异化功能。官方内部盲测显示,其在中文生图、编辑、多参考三项任务中均排名第一,超越...
DMAD – 字节联合德州农工开源的扩散模型少步蒸馏技术
DMAD(Distribution Matching as Adversarial Distillation)是由字节跳动与德州农工大学联合开源的少步蒸馏框架,核心目标是显著加速扩散模型的生成过程。该方法通过训练二分类判别器直接学习目标分布与学生分布之间的差异,省去传统蒸馏方法中辅助扩散模型的依赖,在ImageNet-64数据集上实现了FID低至1.04的一步生成效果,并将50步教师模型高效压缩为...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。