
SpatialClaw – 英伟达联合 KAIST 推出的免训练空间推理框架
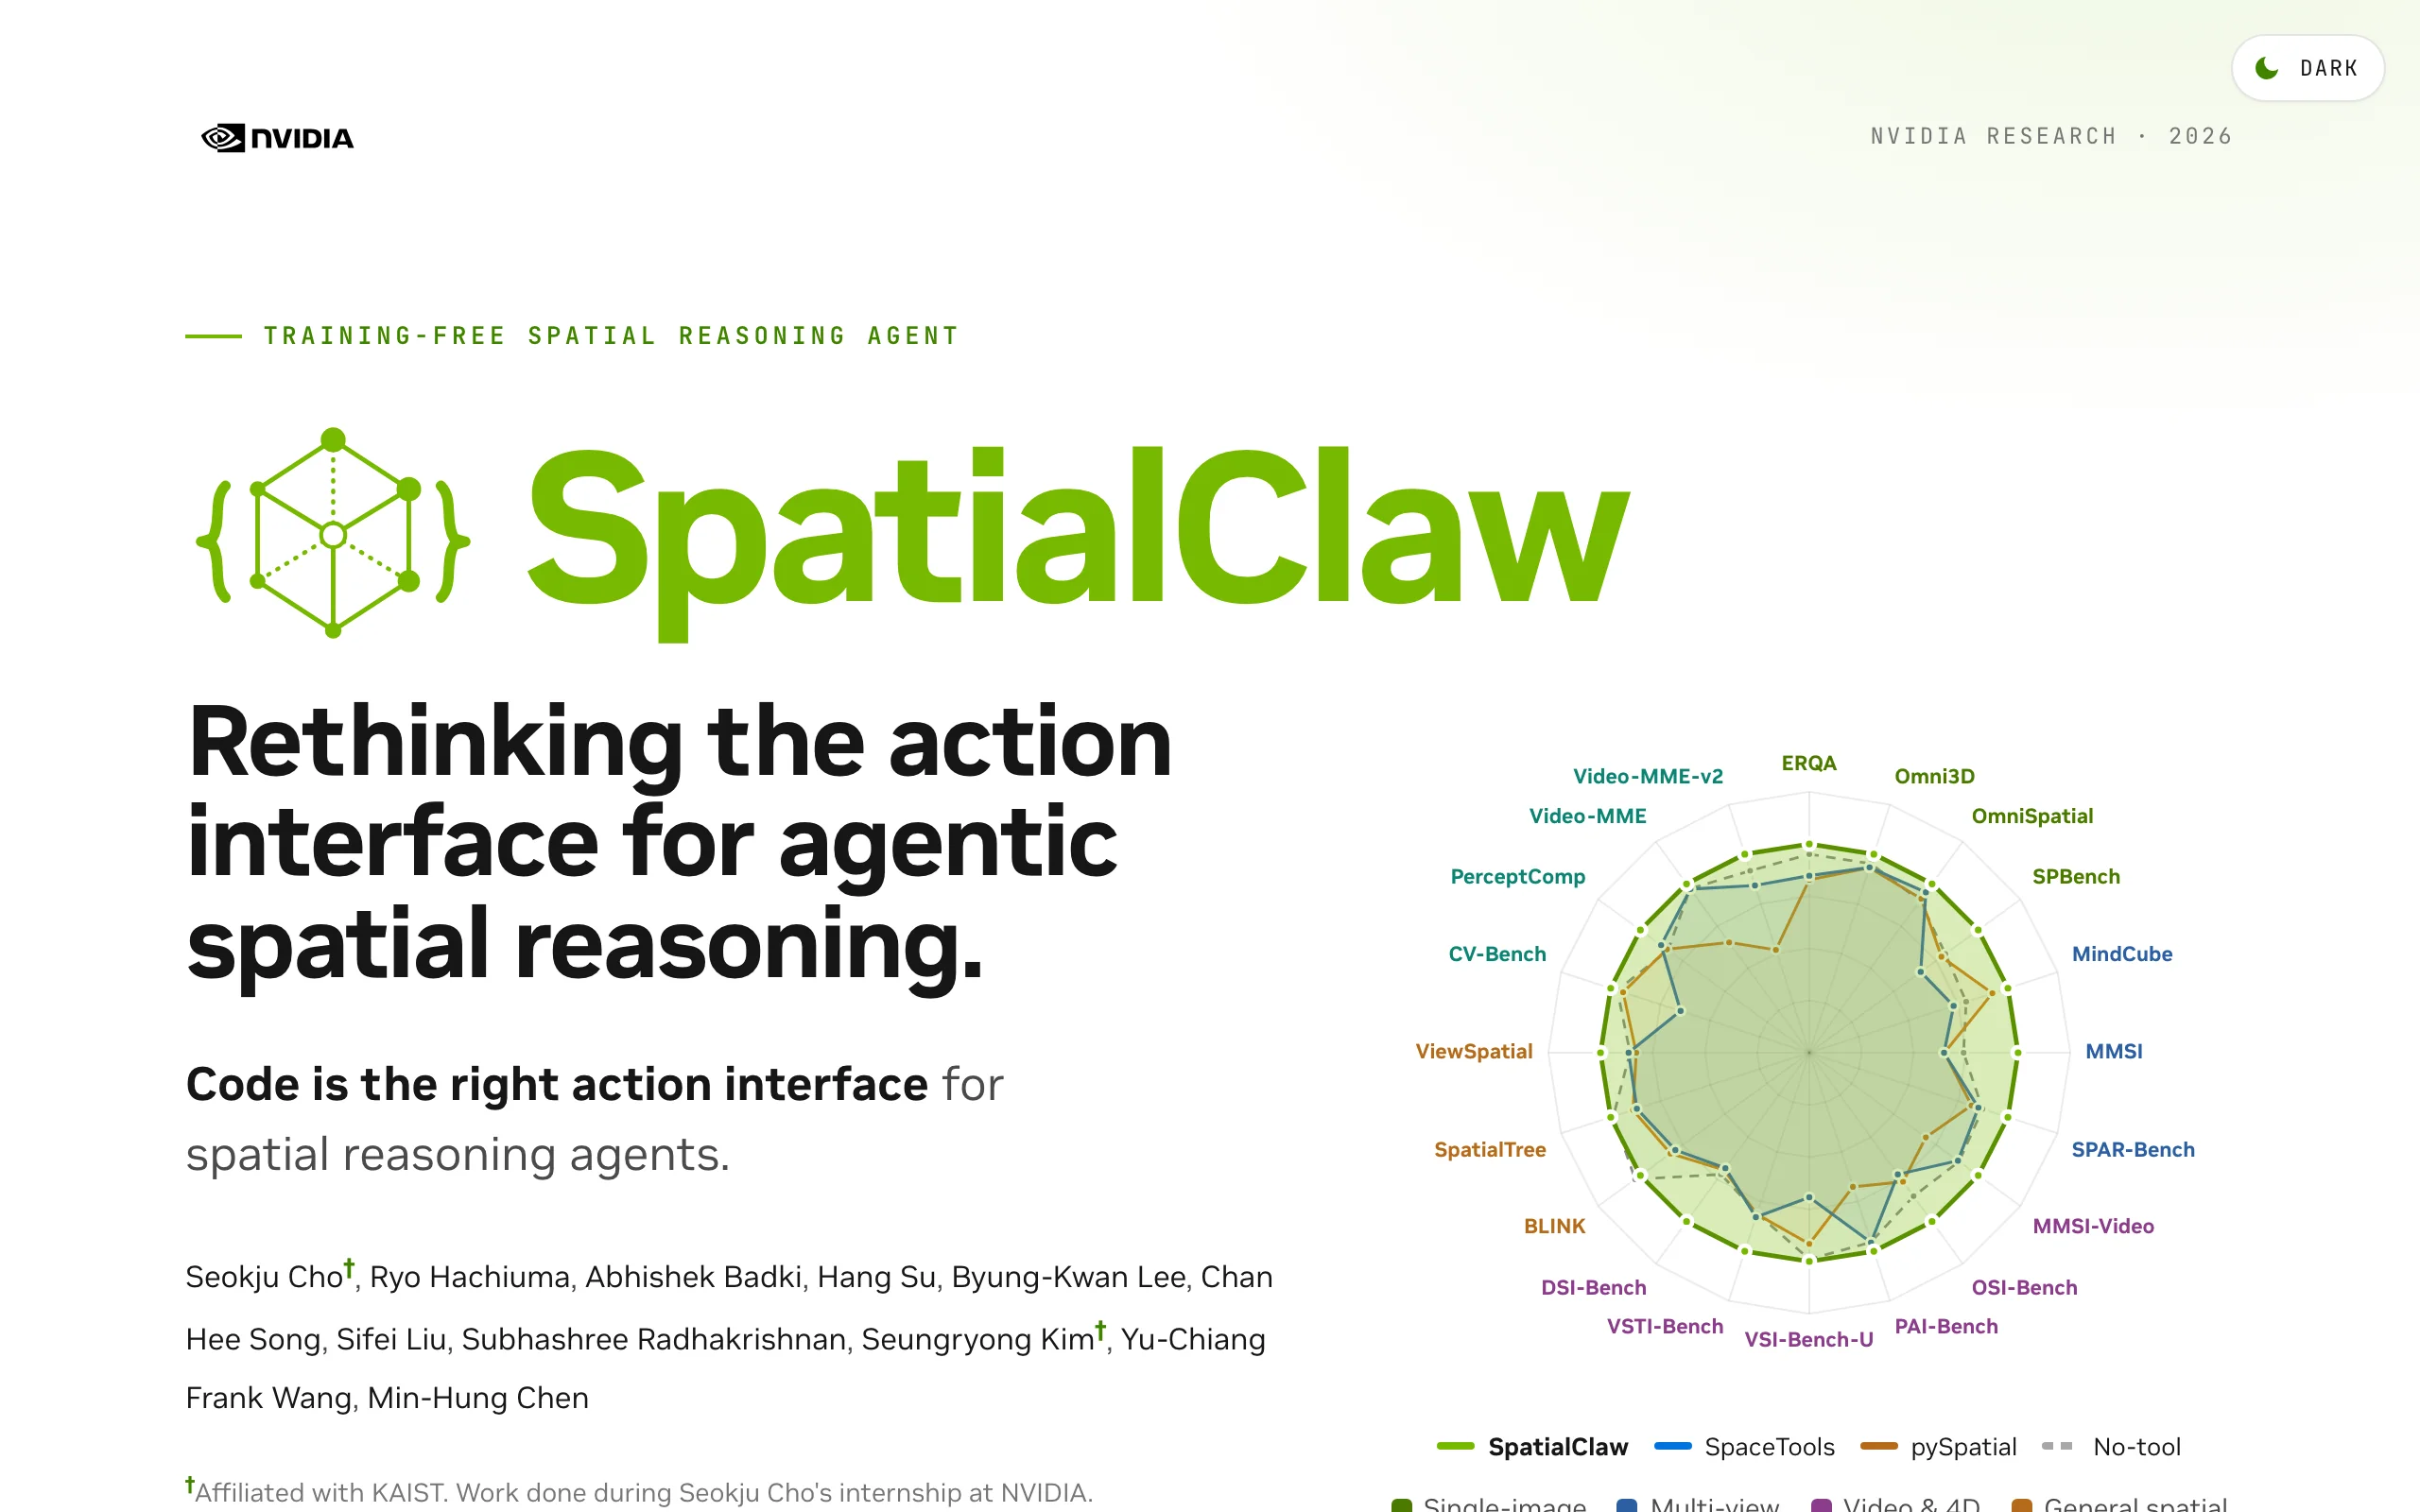
导读摘要:
SpatialClaw 是 NVIDIA Research 与韩国科学技术院(KAIST)联合推出的免训练空间推理智能体框架,通过“代码即动作”机制在持久化 Python 内核中迭代执行复杂 3D/4D 空间推理任务。该框架在 20 项空间推理基准上平均准确率达 59.9%,超越此前最优方法 SpaceTools 11.2 个百分点,并在动态 4D 任务(如 DSI-Bench 和 MindCub...
1. SpatialClaw是什么
SpatialClaw 是 NVIDIA Research 与韩国科学技术院(KAIST)联合推出的免训练空间推理智能体框架,通过“代码即动作”机制在持久化 Python 内核中迭代执行复杂 3D/4D 空间推理任务。该框架在 20 项空间推理基准上平均准确率达 59.9%,超越此前最优方法 SpaceTools 11.2 个百分点,并在动态 4D 任务(如 DSI-Bench 和 MindCube)上分别提升 17.6 和 15.3 个百分点。SpatialClaw 无需任何微调即可直接部署,同一套系统提示词与工具集可运行在 Qwen3.5/3.6、Gemma4 等 6 个不同骨干视觉语言模型(VLM)上,覆盖从 26B 到 397B 的参数规模。
技术定位与领域: SpatialClaw 属于多模态智能体与空间推理交叉领域,专注于让 VLM 通过代码生成自主完成 3D 场景重建、度量距离计算、空间关系判断等复杂任务。与传统结构化工具调用范式不同,它采用持久化 Jupyter 内核中的 Python 代码执行作为动作空间,突破了预定义 JSON 接口的表达能力限制,实现了任意复杂几何计算逻辑的自由编排。
研发背景: 该框架由 NVIDIA Research 与 KAIST 联合开发,依托 NVIDIA 在 GPU 计算、视觉基础模型(如 Depth Anything 3、SAM 3)以及 KAIST 在智能体系统方面的深厚积累。研发动机源于现有 VLM 在空间推理任务上表现不足,且依赖微调或特定基准适配,难以泛化到动态时序场景。SpatialClaw 通过免训练、代码级推理循环,旨在为机器人、AR/VR、自动驾驶等需要精确空间理解的应用提供即插即用的解决方案。
核心价值: SpatialClaw 解决了两个核心问题:一是 VLM 在 3D/4D 空间推理中缺乏灵活的计算表达能力,无法通过预定义工具完成复杂几何运算;二是现有方法需要针对特定模型或任务进行微调,部署成本高且泛化性差。该框架通过持久化内核中的 Python 代码生成与迭代执行,使 VLM 能够自主组合深度估计、分割掩码、NumPy/SciPy 计算等模块,同时 AST 安全校验机制确保执行安全,真正实现了“免训练、即插即用”的空间推理能力。
技术特点: 核心技术包括五阶段智能体循环(规划→代码生成→AST 校验→执行与反馈→迭代修正)、持久化 Jupyter 内核状态保持、以及多模态感知工具(Depth Anything 3、SAM 3)的 Python 模块化集成。AST 安全校验通过抽象语法树静态分析拦截危险调用,仅允许白名单内的感知工具与数学库执行,在保证灵活性的同时控制资源占用上限。
2. 主要功能
代码即动作接口: 将传统结构化工具调用(如固定 JSON 格式)替换为 Python 代码生成。VLM 在持久化 Jupyter 内核中逐单元格编写、执行和修正代码,动作空间不再受限于预定义格式,可表达任意复杂的空间计算逻辑,例如通过 NumPy 进行点云变换、通过 SciPy 计算几何距离等。
五阶段智能体循环: 系统依次执行规划(分析任务需求)、代码生成(基于规划编写 Python 代码)、AST 安全校验(静态分析拦截危险调用)、执行与反馈组装(运行代码并捕获输出与可视化结果)、答案提交或迭代修正。执行后的变量状态与 matplotlib 可视化图像作为多模态反馈回传 VLM,驱动下一步代码修正,形成闭环推理。
多模态感知集成: 原生支持 Depth Anything 3(深度估计)、SAM 3(分割掩码)等视觉基础模型,以 Python 模块形式暴露。VLM 通过代码自由编排深度估计、分割掩码生成与 NumPy/SciPy 几何计算,实现模块化组合,例如先提取掩码再计算物体间距离。
完全免训练部署: 同一套系统提示词与工具集可直接运行在 Qwen3.5/3.6、Gemma4 等 6 个骨干 VLM 上,覆盖 26B 至 397B 参数规模。无需任何基准或模型专属微调,降低部署门槛与算力成本,并支持跨模型通用性。
动态 4D 推理支持: 覆盖单图、多视图、视频与 4D 时序场景的空间关系理解与度量计算。通过持久化内核中的变量状态累积,VLM 可以跨时间步维护场景记忆,在 DSI-Bench 和 MindCube 等动态任务上分别提升 17.6 和 15.3 个百分点。
AST 安全校验: 通过抽象语法树静态分析拦截危险调用(如文件 I/O、系统命令),仅允许白名单内的感知工具与数学库执行。同时控制资源占用上限(如 CPU 时间、内存使用),防止恶意代码执行并确保内核状态稳定,为生产环境部署提供安全保障。
多模态反馈机制: 执行后的 matplotlib 输出(如 3D 散点图、深度图可视化)被捕获为图像反馈,连同变量状态(如 NumPy 数组中的距离值)一同回传 VLM。这使得模型能够“看到”计算过程并据此调整代码逻辑,实现类似人类调试的迭代纠错能力。
3. 如何使用
环境准备: 克隆 GitHub 仓库(`git clone (链接待官方发布后更新) Jupyter 内核、Depth Anything 3、SAM 3 等感知工具。推荐使用 Python 3.10+ 环境,并配置 CUDA 12.1 以上版本以加速 GPU 推理。
模型接入: 选择支持的 VLM 作为推理骨干,如 Qwen3.5/3.6(推荐 72B 以上版本)或 Gemma4(27B 及以上)。通过 Hugging Face Transformers 或 vLLM 加载模型,确保模型权重与 SpatialClaw 的提示词模板兼容。首次使用需下载模型权重,建议使用高速磁盘(如 NVMe SSD)以缩短加载时间。
任务输入: 提交包含空间推理问题的数据,支持单张图像(JPEG/PNG)、多视图图像序列(按时间或视角排序)、视频文件(MP4 格式)或 4D 时序数据(如 RGB-D 视频流)。问题描述以自然语言形式输入,例如“计算图像中两个物体的距离”或“判断视频中行人与车辆是否会发生碰撞”。
智能体循环启动: 运行主脚本(如
python run_agent.py --input data/sample.mp4 --question "测量物体A与物体B的欧氏距离")。系统自动执行五阶段循环:规划阶段 VLM 分析任务并生成代码大纲,代码生成阶段编写具体 Python 代码,AST 校验阶段检查安全性,执行阶段运行代码并捕获输出,反馈阶段将结果与可视化图像回传 VLM。若答案不满足置信度阈值,循环自动迭代。结果获取: 从内核变量状态(如
distance变量)与可视化输出(如 matplotlib 绘制的距离标注图)中提取最终空间推理答案。结果以 JSON 格式输出,包含数值答案、可视化图像路径以及执行日志。用户也可通过 Jupyter Notebook 交互式查看中间变量。
注意事项: 建议在 NVIDIA A100 或 H100 GPU 上运行,消费级显卡(如 RTX 4090)在 72B 以上模型上推理延迟较高。首次运行需下载 Depth Anything 3 和 SAM 3 权重(约 10 GB),确保网络稳定。AST 校验默认开启,若需调试可临时关闭(但不推荐生产环境使用)。对于视频任务,建议预处理为固定帧率(如 30 fps)以控制内存占用。
4. 优缺点分析
| 优点 |
|---|
| 免训练即插即用: 无需任何微调或基准适配,同一套提示词可在 6 个不同 VLM 上直接运行,大幅降低部署门槛与算力成本,尤其适合快速原型验证。 |
| 代码动作灵活性: Python 代码表达力远超固定 JSON 工具调用,可完成任意复杂几何计算(如点云配准、仿射变换),实现传统结构化接口无法触及的推理深度。 |
| 显著性能领先: 在 20 项基准上平均准确率 59.9%,超越此前最优方法 11.2 个百分点,尤其在动态 4D 任务上提升幅度达 17.6 和 15.3 个百分点,验证了代码级推理的有效性。 |
| 跨模型通用性: 同一架构在 26B 至 397B 参数规模的 6 个不同 VLM 上均取得一致增益,说明框架设计不依赖特定模型架构,具有良好的泛化潜力。 |
5. 同类工具对比
| 维度 | SpatialClaw | SpaceTools | VisProg |
|---|---|---|---|
| 核心架构 | 五阶段代码生成循环 + 持久化 Jupyter 内核 | 结构化工具调用(固定 JSON 格式) | 基于语言模型的程序合成(自然语言到代码) |
| 动作接口 | Python 代码(自由组合感知工具与数学库) | 预定义 JSON 工具调用(有限动作空间) | 自然语言指令 + 预定义视觉程序模块 |
| 训练需求 | 完全免训练,同一提示词通用 | 需要针对特定基准微调 | 需要针对视觉程序数据集微调 |
| 支持模态 | 单图、多视图、视频、4D 时序 | 单图、多视图(动态 4D 能力有限) | 单图、多视图(无视频支持) |
| 迭代纠错 | 支持代码级自主修正(错误回传 VLM) | 工具调用出错后需人工干预 | 有限纠错(仅重新生成指令) |
| 动态 4D 性能 | DSI-Bench +17.6, MindCube +15.3 | 动态任务表现较弱 | 不支持时序场景 |
| 开源协议 | 开源(项目页面显示为公开仓库) | 未公开 | 开源 |
选型建议: 对于需要高精度动态 4D 空间推理(如机器人导航、自动驾驶感知)的用户,SpatialClaw 凭借代码级迭代纠错和持久化状态管理是最优选择,尤其适合部署在 NVIDIA A100/H100 集群上。若算力有限且任务仅涉及静态单图或简单多视图场景,SpaceTools 或 VisProg 可能更轻量,但需注意它们缺乏时序推理能力。对于仅需端到端答案而不依赖中间计算步骤的简单空间问答,LLaVA-NeXT-Interleave 等纯多模态模型可快速使用,但准确率远低于 SpatialClaw(平均低约 11 个百分点)。建议在工业级部署中优先考虑 SpatialClaw,并配备足够的 GPU 资源;学术研究中可将其作为基线框架,探索代码生成与 VLM 结合的更多可能性。
6. 编辑点评
SpatialClaw 在技术创新性上值得高度肯定。它将“代码即动作”范式引入空间推理领域,通过持久化 Jupyter 内核和五阶段智能体循环,突破了传统结构化工具调用的表达天花板。这一设计不仅提升了任务准确率(平均 59.9%),更重要的是为 VLM 提供了可编程的、可迭代修正的推理环境,使模型能够像人类程序员一样调试自己的计算过程。从实用价值看,免训练部署和跨模型通用性显著降低了落地门槛:同一套提示词可适配 6 个不同 VLM,覆盖从 26B 到 397B 的参数规模,这意味着企业无需为每个模型重新开发工具链,只需切换骨干网络即可获得一致增益。尤其值得关注的是动态 4D 任务上的性能提升(DSI-Bench +17.6, MindCube +15.3),这直接关系到机器人、自动驾驶等对时序理解要求极高的场景。适用人群包括:机器人算法工程师(用于抓取路径规划)、AR/VR 开发者(用于空间布局自动生成)、自动驾驶感知团队(用于多摄像头 3D 重建)以及学术研究者(作为空间推理智能体的基线框架)。未来发展潜力巨大:一方面,随着 VLM 代码生成能力的提升(如 Qwen3.6 系列),SpatialClaw 的推理准确率有望进一步突破 70%;另一方面,框架可扩展到更多感知工具(如 3D 点云处理库 Open3D),甚至支持多模态智能体协作。唯一扣分项是硬件要求较高,但考虑到其目标场景(工业级空间推理),这一限制可以接受。
7. 应用场景
机器人导航与抓取: 为移动机器人和机械臂提供精确的物体公制距离测量与空间关系判断。例如,机器人通过单目相机拍摄工作台,SpatialClaw 自动调用 Depth Anything 3 估计深度,结合 SAM 3 分割出目标物体,计算抓取点坐标与障碍物距离,辅助路径规划与抓取姿态决策。
AR/VR 室内布局: 自动识别家具、门窗等元素的相对位置与尺寸,生成合理的室内摆放方案并实时叠加于虚拟空间。用户拍摄房间照片后,SpatialClaw 通过多视图深度重建生成 3D 点云,计算家具间的欧氏距离与碰撞检测,输出布局建议,可用于智能家居设计或虚拟样板间。
自动驾驶感知: 融合多摄像头输入进行 3D 场景重建,理解道路元素的空间拓扑关系以支持决策规划。例如,处理车辆周围 4 个鱼眼摄像头视频流,SpatialClaw 持续维护场景中行人、车辆、路沿的位置状态,判断是否会发生碰撞,并输出安全距离数值。
建筑安全巡检: 基于多视角图像分析工地结构的空间合规性,检测脚手架间距、防护栏高度等安全指标。巡检人员使用无人机拍摄工地视频,SpatialClaw 逐帧提取脚手架立柱位置,计算间距并与安全标准对比,自动标记违规区域。
工业精密测量: 通过多视图深度估计对零部件进行非接触式三维尺寸测量与形位公差检测。例如,拍摄机械零件的 6 个角度图像,SpatialClaw 重建其 3D 模型,调用 NumPy 计算关键尺寸(如孔径、轴径),并与 CAD 图纸对比,输出偏差报告。
8. 常见问题FAQ
Q:SpatialClaw 是否支持中文输入?
A:目前框架的提示词模板和工具接口基于英文设计,但 VLM 骨干网络(如 Qwen3.5/3.6 支持中文)可接受中文自然语言问题。建议使用中文时确保 VLM 的中文能力足够,同时注意感知工具(Depth Anything 3、SAM 3)的输出与语言无关,仅依赖图像,因此中文输入不影响核心空间推理性能。
Q:部署 SpatialClaw 需要多少显存?
A:视所选 VLM 模型大小而定。以 Qwen3.5-72B 为例,使用 FP16 推理约需 144 GB 显存,推荐使用 2×A100-80GB 或 1×H100-80GB。若采用 4-bit 量化(如 AWQ),显存需求可降至约 36 GB,此时可在单张 RTX 4090(24 GB)上运行,但推理速度会下降。建议生产环境至少配备 80 GB 显存。
Q:如何自定义感知工具?
A:在 tools/ 目录下添加新的 Python 模块,继承基类并实现 process(image) 方法即可。例如集成 Open3D 点云处理库,需将其包装为模块并注册到白名单中,同时更新 AST 校验规则。框架会自动将新工具暴露给 VLM 的代码生成环境。
Q:SpatialClaw 能否用于实时推理(如 30 fps 视频流)?
A:目前框架的迭代循环设计(平均每个问题需 3–5 轮代码生成与执行)导致单帧处理延迟约 2–5 秒,不适合实时流处理。建议用于离线视频分析或关键帧推理。若需实时性,可考虑简化循环(如减少迭代次数)或使用更小的 VLM(如 Qwen3.5-14B),但准确率会下降。
Q:代码生成的安全风险如何控制?
A:AST 校验模块会静态分析生成的 Python 代码,仅允许白名单内的函数调用(如 numpy.linalg.norm、scipy.spatial.distance),拦截所有文件 I/O、网络请求、系统命令等危险操作。同时设置 CPU 时间上限(默认 30 秒)和内存上限(默认 4 GB),超出后自动终止执行并返回错误信息。
Q:SpatialClaw 与其他代码生成智能体(如 CodeAct)有何区别?
A:CodeAct 等通用代码智能体主要面向编程任务(如软件开发),而 SpatialClaw 专门针对空间推理优化,内置深度估计、分割等感知工具,并设计了五阶段循环来利用可视化反馈(matplotlib 图像)驱动迭代修正。此外,SpatialClaw 的 AST 校验更严格,专注于几何计算安全,而非通用代码执行安全。
9. 项目地址
- 项目官网: https://spatialclaw.github.io/
- GitHub 仓库: https://github.com/NVlabs/SpatialClaw
- arXiv 技术论文: https://spatialclaw.github.io/static/pdfs/spatialclaw.pdf
相关 AI 模型文章
Beam – Reflection AI 开源的首款大语言模型:501B稀疏MoE架构的工程力作
Beam是Reflection AI推出的首款开源大语言模型,采用501B参数的稀疏MoE架构,每个token仅激活23B参数,支持100万token上下文窗口,预训练消耗23.8T token。该模型在软件工程任务上达到GLM-5.2同级水平,其训练过程堪称重工业级别的算力展示:预训练阶段使用6,144张GB300 GPU在不到四周内完成,随后动用10,500张GB300进行为期四周、超1亿次r...
Poppy – Sierra 联合 Meta 等推出的开放协议草案
Poppy(Personal Agent Protocol)是由 Sierra 联合 Meta 及多家企业共同推出的开放协议草案,旨在解决个人 AI Agent 访问企业服务时的身份识别与授权问题。该协议通过标准化的发现机制、分级权限控制和基于 OAuth 的授权流程,在"Agent 冒充用户"与"企业全面封禁代理"两个极端之间建立了中间方案。目前已有 Stripe、Shopify、Walmart...
VeriLoop E2 – 清华大学开源的 27B 后训练模型
VeriLoop E2 是清华大学深圳国际研究生院机器人实验室开源的 27B 后训练模型,基于 Qwen3.8-27B 底座,面向代码、数学与物理推理场景。该模型采用 Apache-2.0 协议发布权重与分词器,原生支持 262,144 tokens 的上下文窗口。其核心创新在于 VGR(VeriLoop-Governed Recurrence)机制,将"模型提案"与"外部验证/持久化"彻底分离,...
Microsoft-Decision-1:微软推出的新一代快速决策AI模型深度评测
Microsoft-Decision-1是微软推出的一款专为结构化决策任务设计的快速决策AI模型,能够从预设选项中筛选出最优解,并为每个备选答案赋予概率评分,供下游应用判断执行、重试或转人工。该模型基于开源Qwen3.5-9B架构构建,在36项基准测试中准确率均位列第一,推理速度达到GPT-6 Sol的35倍,输入成本仅为每百万tokens 0.042美元且输出免费,已在Microsoft Fou...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。