
VidMuse – Sand.ai 推出的 AI 音乐视频 Agent
导读摘要:
VidMuse 是由 Sand.ai 推出的 AI 音乐视频 Agent,旨在将音乐创作与视频生成深度融合。用户只需上传 Suno 链接或本地 MP3 文件,即可自动生成 30–60 秒的高质量音乐视频。其 2.0 版本基于“Video as Code”理念,从固定 Workflow 升级为开放 Agent 框架,能够自主调度计算资源、动态组织分镜与叙事逻辑,目标是成为用户可长期信赖的数字制片团队...
1. VidMuse是什么
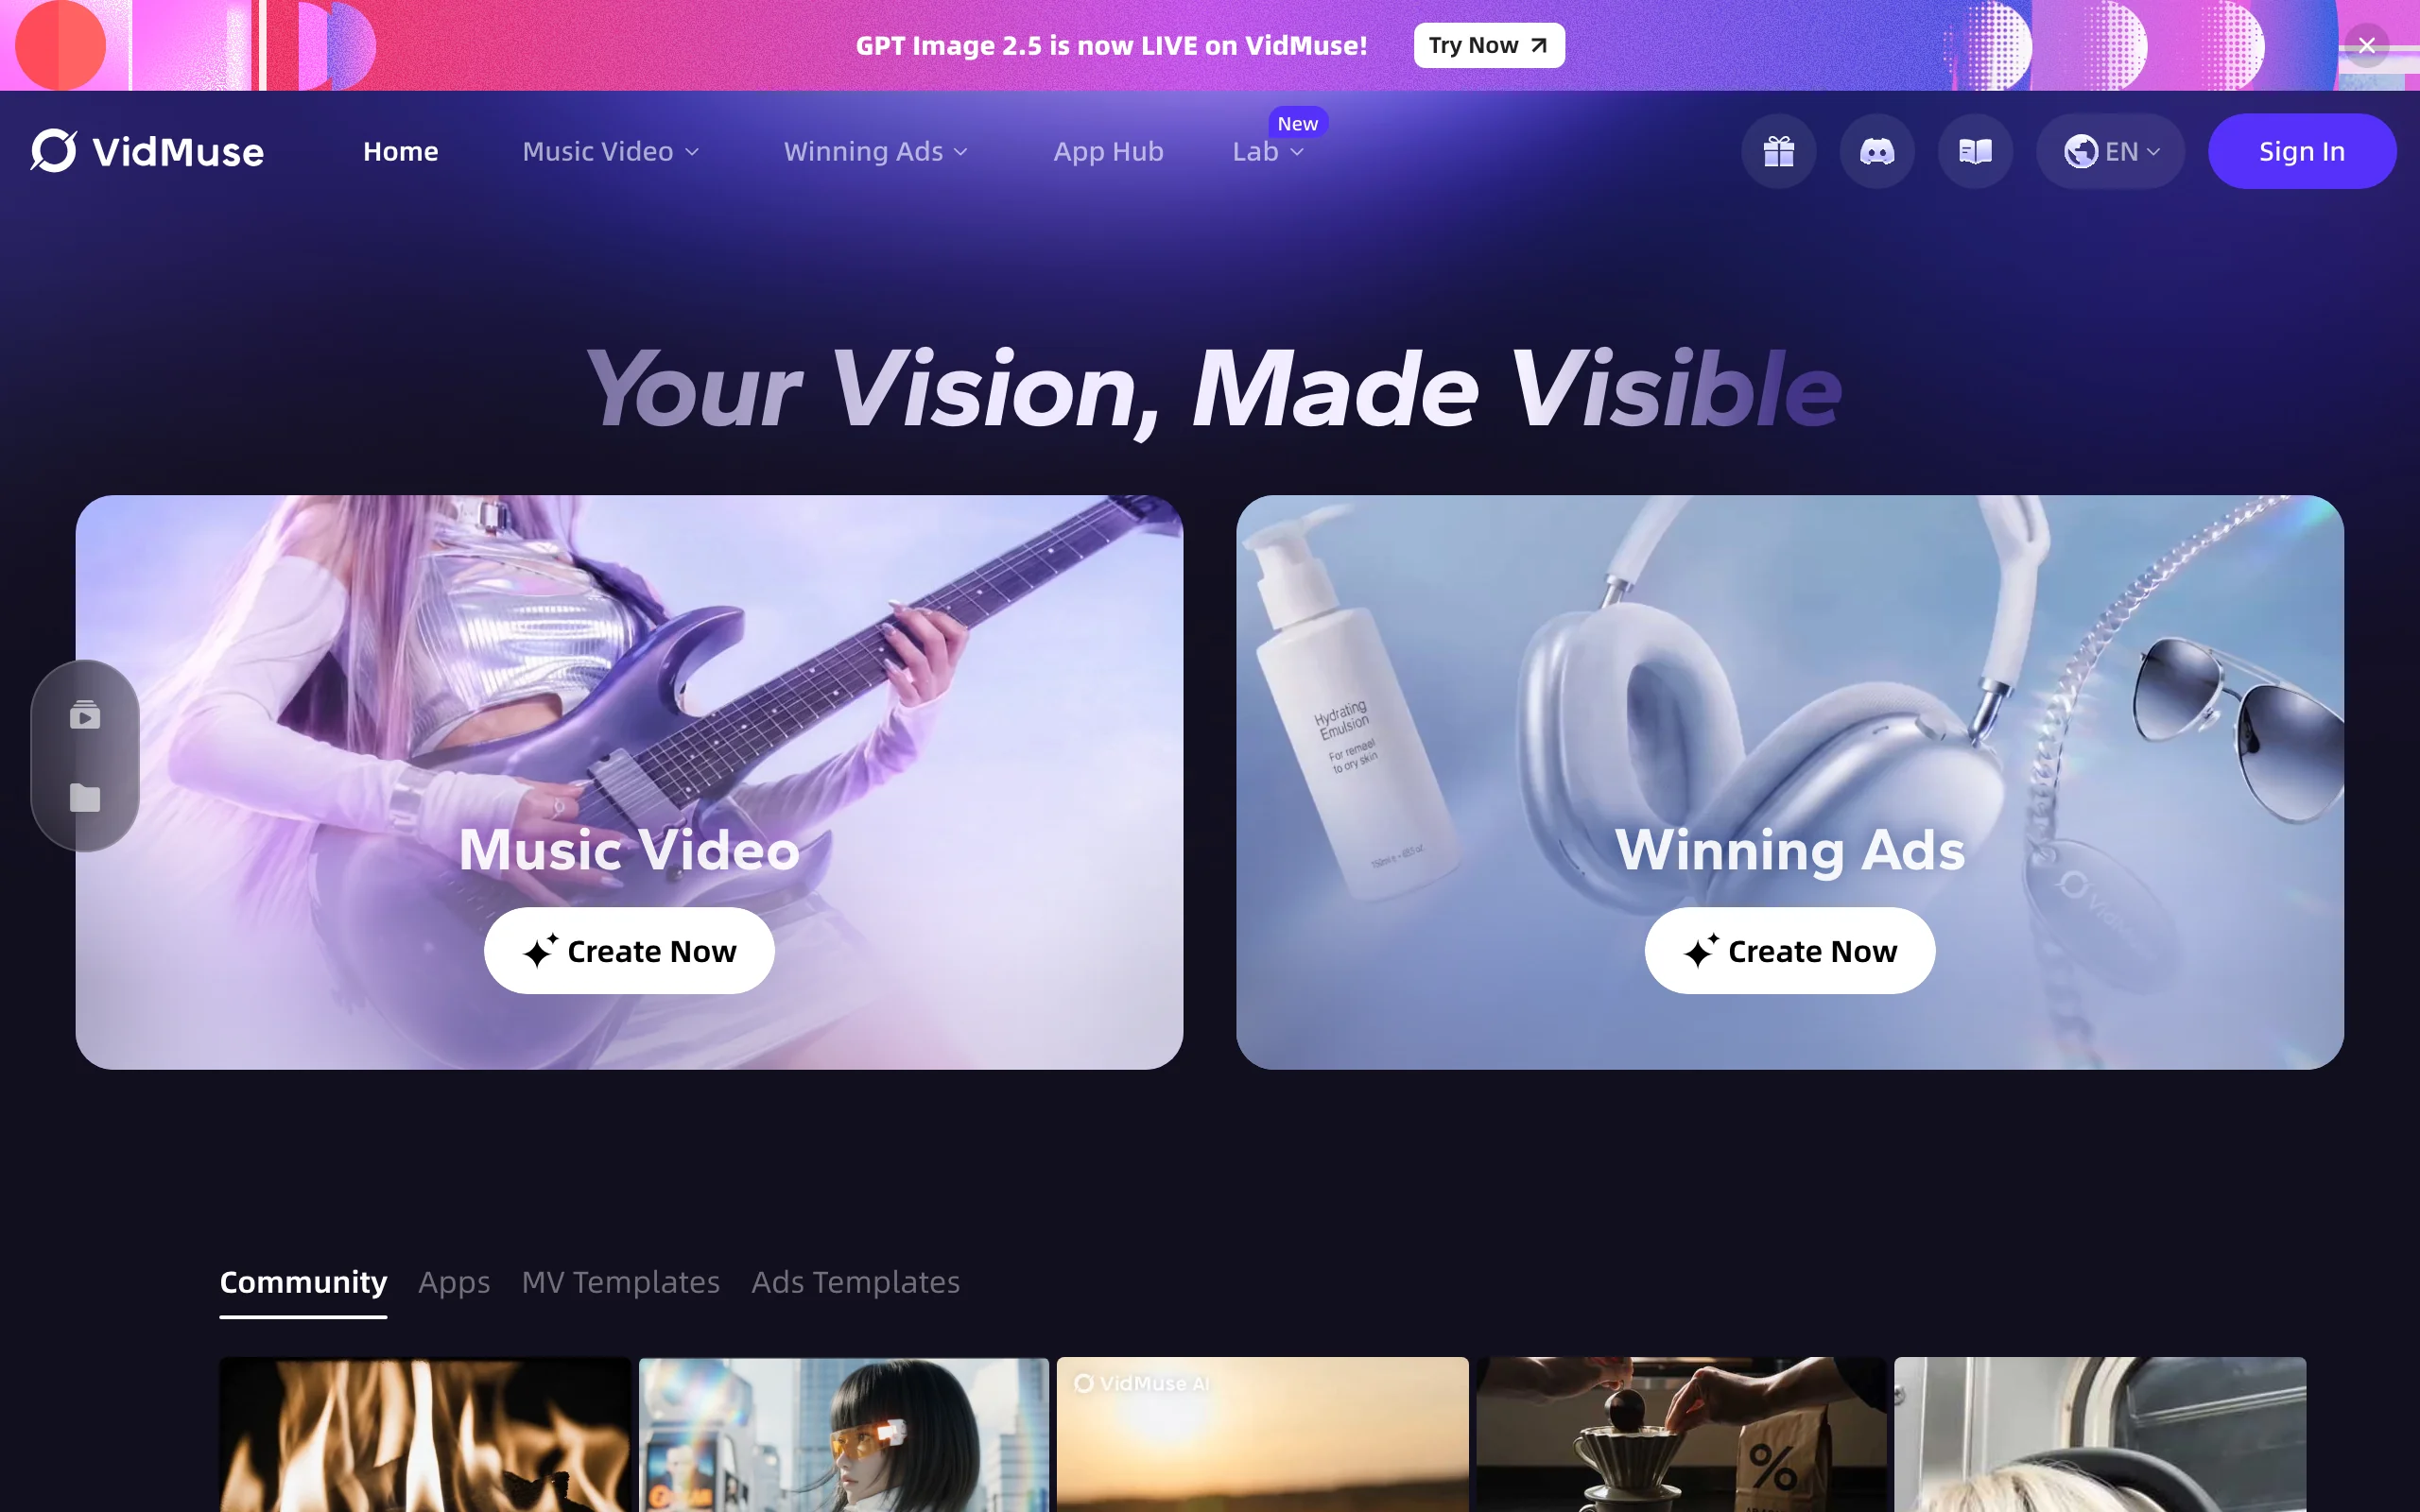
VidMuse 是由 Sand.ai 推出的 AI 音乐视频 Agent,旨在将音乐创作与视频生成深度融合。用户只需上传 Suno 链接或本地 MP3 文件,即可自动生成 30–60 秒的高质量音乐视频。其 2.0 版本基于“Video as Code”理念,从固定 Workflow 升级为开放 Agent 框架,能够自主调度计算资源、动态组织分镜与叙事逻辑,目标是成为用户可长期信赖的数字制片团队。该工具通过音频优先的创作链路,彻底改变了传统“画面+配乐”的视频制作模式,为音乐人、内容创作者和品牌方提供了一条从音乐到视频的自动化通路。
技术定位与领域: VidMuse 属于 AIGC(AI 生成内容)领域中的音乐视频生成赛道,专注于将音频信号转化为视觉叙事。其独特定位在于,它不是简单的“配图工具”,而是一个能够自主理解音乐节奏、情绪与结构,并据此生成完整分镜脚本和视频画面的 Agent 系统。与传统的 AI 视频生成工具相比,VidMuse 将音乐作为核心驱动,而非后期添加的配乐,这使得生成的视频在节奏、情感和叙事上天然与音乐同步。
研发背景: VidMuse 由 Sand.ai 团队开发,该团队在 AI 音乐和视频生成领域拥有深厚的技术积累。研发动机源于一个核心洞察:音乐人(尤其是 Suno/Udio 用户)对视频化表达有着强烈的需求,但传统视频制作工具门槛高、流程复杂。Sand.ai 通过将视频生成能力封装为 Agent,降低了从音乐到视频的创作门槛,同时通过产品与模型的双轮驱动策略,在快速迭代产品功能的同时,持续优化底层模型的生成效果和成本结构。
核心价值: VidMuse 解决了音乐创作者“有歌无片”的核心痛点。传统上,音乐人需要跨工具完成节奏分析、分镜设计、画面生成和剪辑合成,流程冗长且专业门槛高。VidMuse 通过 Agent 自主调度,将这一系列步骤自动化,用户只需上传音乐并设定风格,即可获得成品级音乐视频。其“从工具到乙方”的定位升级,意味着用户不再需要学习复杂的视频编辑软件,而是直接委托一个“数字制片团队”完成创作,大幅降低了时间成本和技能门槛。
技术特点: VidMuse 的核心技术优势在于其开放 Agent 框架和长期记忆(Memory)机制。Agent 能够自主理解用户需求,动态调整创作流程,而非依赖预设的固定工作流。长期记忆功能则记录了用户的风格偏好和创作历史,在后续创作中持续复用,形成用户与 Agent 之间的信任关系。此外,音画同出技术和多镜头叙事能力,确保了生成的视频在节奏对齐和空间真实感上达到较高水准。
2. 主要功能
音乐驱动生成: 这是 VidMuse 的核心功能,支持 Suno 链接或本地 MP3 文件输入。AI 自动分析音乐的节奏、情绪与结构(如主歌、副歌、桥段),并据此生成与之匹配的画面序列。与传统“先画面后配乐”的逻辑不同,音乐在此作为视频的骨架,确保每一帧的切换、镜头的运动都与节拍和旋律变化精准同步。
多风格视频模式: 内置 Story MV、Abstract MV、Performance MV、Viral Shorts 等模板,覆盖从叙事性音乐视频到抽象视觉艺术、从表演剪辑到短视频裂变等多种创作场景。用户无需手动设计分镜,只需选择模板并输入风格描述,Agent 即可自动适配音乐类型和创作目标,生成符合预期风格的视频。
音画同步与多镜头叙事: 支持音画同出技术,能够实现口型、动作与节拍的精准对齐,避免常见的音画不同步问题。同时,通过多镜头切换(如全景、中景、特写)构建空间真实感,增强视频的视觉层次和叙事张力。这一能力在生成表演型 MV 时尤为重要,能够模拟真实拍摄中的多机位剪辑效果。
开放 Agent 框架: VidMuse 2.0 不再依赖预设的 Workflow,而是采用 Agent 自主调度模式。Agent 能够理解用户输入的提示词,动态决策所需的计算资源、模型调用和流程编排。这意味着用户的每次创作都可能触发不同的内部处理路径,从而适应多样化的创作需求,而非被固定流程所限制。
长期记忆(Memory): 系统能够记录用户的风格偏好、历史创作参数和反馈数据,在后续创作中持续复用。例如,如果用户多次选择“赛博朋克”风格,Agent 会在新创作中优先考虑该风格,并自动调整画面色调、镜头运动和特效参数。这一机制减少了重复配置的工作量,并逐步形成个性化创作助手。
迭代导出与积分管理: 用户预览成片后,可通过反复 prompt 调整分镜、画面细节和节奏,无需全部推翻重来。满意后一键导出最终视频。积分系统(新用户赠 1000 积分)用于控制创作消耗,积分不足时可通过订阅或加油包续费,为高频用户提供了灵活的付费选项。
3. 如何使用
注册账号与积分获取: 访问官网 https://vidmuse.ai/ 完成注册。新用户可获赠 1000 积分,用于首次创作体验。建议注册后先了解积分消耗规则,避免中途积分不足导致创作中断。目前无需复杂的硬件环境,所有计算在云端完成,用户只需稳定的网络连接。
上传音乐作为驱动核心: 进入创作界面,选择「Music」模式。这里有两种输入方式:粘贴 Suno 歌曲链接(需确保链接可公开访问),或上传本地 MP3 文件。系统会自动解析音频文件的节奏、情绪曲线和结构段落。注意:上传文件的时长建议在 30–60 秒范围内,超出此范围可能导致生成失败或质量下降。
设定风格与视频参数: 输入画面风格描述(如“赛博朋克城市夜景,霓虹灯闪烁”),并选择视频比例(如 16:9、9:16、1:1)和分辨率(如 720p、1080p)。风格描述的详细程度直接影响生成质量,建议至少包含色调、场景类型和情绪关键词。模板选择(如 Story MV、Abstract MV)可在此步骤一并设定。
一键生成与预览: 点击 Create 按钮,Agent 自动开始工作,包括音乐节奏分析、分镜脚本生成、画面渲染与剪辑合成。生成时间取决于音乐时长和分辨率,通常为 1–5 分钟。预览成片后,可通过 prompt 调整分镜细节(如“第一镜头改为特写”),无需重新生成整个视频。
迭代优化与导出: 预览阶段可反复调整 prompt,直到满意为止。每次修改后,Agent 仅重绘受影响的片段,而非全量重新生成,这显著提升了迭代效率。最终导出时,系统提供多种格式(如 MP4、MOV),并支持直接分享至 TikTok、YouTube 等平台。积分不足时,系统会提示续费,可通过订阅月卡或购买加油包补充。
4. 优缺点分析
| 优点 |
|---|
| 音频优先的创作链路: 以音乐为骨架驱动视频生成,从根本上解决了音画同步问题,比传统“画面+配乐”模式更贴合 AI 原生创作习惯,生成的视频节奏感强、情绪表达准确。 |
| 开放 Agent 框架: 从固定 Workflow 升级为自主调度 Agent,能够动态理解用户需求并调整创作流程,灵活性远超预设模板工具,适合多样化的创作场景。 |
| 长期记忆机制: 记录用户偏好并在后续创作中复用,逐步形成个性化创作助手,减少了重复配置的工作量,是建立用户粘性的关键技术特性。 |
| 高付费意愿用户群: 核心用户为 Suno/Udio/Spotify 音乐人,已有强烈创作意愿与付费能力,注册到付费转化率达 5%–7%,商业模式已验证可行。 |
| 从工具到乙方的定位升级: 用完整制片团队形态交付,用户无需跨工具穿梭,降低了学习门槛和操作复杂度,适合非专业视频制作者。 |
5. 同类工具对比
| 维度 | VidMuse | 立刻MV | Pika |
|---|---|---|---|
| 核心定位 | 音乐视频 Agent,定位“数字制片团队”,以音乐为驱动核心 | 一站式 AI 音乐视频创作工具,定位“故事板叙事 MV 生成器” | 通用 AI 视频生成平台,支持文本/图像/视频到视频 |
| 输入起点 | Suno 链接 / MP3 文件,音乐为唯一驱动 | 在线 AI 生成音乐 / 本地音频导入,支持 LRC 歌词文件 | 文本/图像/视频片段 |
| 生成逻辑 | 开放 Agent 自主调度,基于“Video as Code”动态组织分镜与资源 | 故事板模式:先理解整首歌情绪弧线与叙事节奏,再生成完整分镜方案 | 逐帧生成,用户通过 prompt 控制画面内容 |
| 视频能力 | 音画同出、多镜头叙事、动态画面生成,支持 30–60 秒 | 1.1 版本引入 AI 视频生成模块,支持本地视频素材混剪,动态画面输出 | 支持 4K 分辨率,运动流畅度较高,但音画同步需后期手动调整 |
| 分镜调整 | Agent 自主迭代,用户可反复 prompt 调整,无需全量重新生成 | 单镜头独立调整,无需全部推翻重来,支持故事板修改 | 需重新生成片段,不支持单镜头独立编辑 |
| 字幕/歌词 | 内置音乐节奏分析,Agent 自动对齐,但跨语言支持待完善 | 在线字幕识别 + LRC 文件直接导入,时间轴精准匹配,支持多语言 | 无原生字幕功能,需后期添加 |
| 封面生成 | 未明确提及 | 随 MV 流程同步生成封面,一键发布至平台 | 不支持 |
选型建议: 对于 Suno/Udio 音乐人而言,VidMuse 是首选,因为它以音乐为唯一驱动,Agent 自动完成从分析到渲染的全流程,无需额外学习视频编辑技能。如果用户需要精确控制歌词字幕的时间轴和叙事节奏,立刻MV 的故事板模式和 LRC 支持更具优势,尤其适合制作歌词 MV 或剧情型音乐视频。对于需要通用视频生成能力的创作者(如广告、短视频),Pika 和 Runway 提供了更广泛的输入方式和更高的分辨率支持,但需自行处理音画同步问题。总体而言,VidMuse 在音乐视频垂直场景中体验最优,而竞品在通用性和编辑灵活性上更胜一筹。
6. 编辑点评
VidMuse 在 AI 音乐视频生成领域展现出了显著的技术创新性。其“音频优先”的创作链路从根本上改变了传统视频生成的范式——不再将音乐视为后期添加的配乐,而是将其作为视觉叙事的骨架。这种设计不仅解决了长期困扰 AI 视频生成的音画同步问题,还更贴合音乐人“先有歌后有片”的自然创作习惯。开放 Agent 框架的引入,使得 VidMuse 从固定 Workflow 工具升级为具备自主调度能力的智能体,这在同类产品中尚属首次,体现了 Sand.ai 对 AI Agent 发展趋势的敏锐把握。
从实用价值来看,VidMuse 显著降低了音乐视频的制作门槛。传统上,制作一支专业级别的 MV 需要编剧、导演、摄影师、剪辑师等多角色协作,成本高昂且周期漫长。VidMuse 将这一流程压缩为“上传音乐→设定风格→一键生成”三个步骤,对独立音乐人、短视频创作者和中小品牌而言,是一种极具性价比的解决方案。其长期记忆机制进一步增强了工具的实用性,用户无需每次创作都重复配置,Agent 会逐步学习并适配个人偏好。
适用人群方面,VidMuse 的核心用户是 Suno/Udio 等 AI 音乐平台的活跃创作者,他们已有强烈的视频化需求且具备付费意愿。此外,传统独立音乐人、MCN 机构、广告代理商和短视频内容生产者也能从中受益。对于专业视频制作者而言,VidMuse 的自动化程度可能限制了创意自由度,但可作为快速原型生成工具使用。
未来发展潜力上,VidMuse 有望通过 Agent 框架的持续进化,实现更复杂的叙事结构(如多段落音乐视频)和更精细的风格控制。长期记忆机制若能结合用户反馈数据进行强化学习,将形成难以复制的个性化创作壁垒。然而,跨语言支持、视频时长限制和积分透明度等问题仍需解决,否则可能影响非英语用户和重度创作者的体验。
7. 应用场景
AI 音乐人推广: Suno/Udio 创作者可将歌曲一键转为 MV,发布至 TikTok、YouTube、Instagram 获取流量。Agent 自动生成的画面与音乐节奏同步,适合短视频平台的算法推荐机制,提升歌曲的传播效率和曝光量。
独立音乐人视觉化: 传统音乐人(如吉他手、歌手)可低成本制作专辑预告、单曲视觉与演出背景视频。无需租赁拍摄场地或雇佣剪辑师,只需上传 demo 音频并设定风格,即可获得专业级视频素材,用于社交媒体宣发。
广告与品牌传播: 品牌方可利用洗脑旋律+强记忆点画面生成病毒式广告短片。例如,上传一首定制广告歌,Agent 自动生成包含产品特写、品牌 logo 和情绪化场景的视频,放大信息传递效率,适合快消品、电商品牌的短视频营销。
个人纪念与情绪表达: 用户上传私人照片与原创歌曲(或授权音乐),生成家庭纪念、生日祝福、情感宣泄等个性化视频。Agent 可根据音乐的情绪曲线(如欢快、忧伤)自动匹配照片的切换节奏和滤镜效果,适合非专业用户制作纪念视频。
短视频内容生产: MCN 机构、电商卖家可批量生成带货音乐视频。例如,上传产品介绍音频,Agent 自动生成包含产品展示、使用场景和优惠信息的视频,替代传统实拍环节,大幅降低内容生产成本,适合高频更新的短视频账号。
8. 常见问题FAQ
Q:VidMuse 生成的视频最长支持多少秒?
A:目前 VidMuse 支持生成 30–60 秒的音乐视频。若需要更长的视频(如完整歌曲),建议将歌曲分段上传,分别生成后使用剪辑软件拼接,或等待官方未来版本对时长限制的更新。
Q:上传的音乐文件必须来自 Suno 吗?
A:不必须。VidMuse 同时支持 Suno 歌曲链接和本地 MP3 文件上传。但注意,上传的 MP3 文件需确保已获得版权授权,避免侵权风险。Suno 链接方式更适合 AI 音乐平台用户直接转化。
Q:生成的视频可以商用吗?
A:视频的商用权限取决于输入音乐的版权状态。若音乐为原创或已获得授权,生成的视频可用于商业用途。VidMuse 本身不提供音乐版权,用户需自行确保音乐素材的合法性。官方建议用户使用 Suno 生成的原创音乐或自有版权的音频。
Q:如何控制视频的分镜和画面风格?
A:用户在设定阶段输入画面风格描述(如“赛博朋克城市夜景”),Agent 会根据描述自动生成分镜。预览后,用户可通过 prompt 调整特定镜头(如“第一镜头改为特写”),无需重新生成整个视频。建议风格描述尽量具体,包含色调、场景类型和情绪关键词。
Q:积分消耗规则是怎样的?
A:新用户获赠 1000 积分,每次生成视频会消耗一定积分,具体消耗量取决于视频时长、分辨率和复杂度(如多镜头切换)。目前官网未公示详细的积分消耗公式,建议用户在创作前预览积分预估消耗,避免中途积分不足。积分可通过订阅月卡或购买加油包补充。
Q:VidMuse 支持中文歌曲吗?
A:支持上传中文 MP3 文件,但歌词对齐和节奏分析的准确度可能低于英文歌曲。目前 VidMuse 主要针对英文歌曲优化,中文歌曲的音画同步效果可能不如英文理想。官方表示正在优化多语言支持,未来版本将提升中文体验。
9. 项目地址
- 产品官网: https://vidmuse.ai/ (注册、创作、积分管理)
相关 AI 模型文章
Beam – Reflection AI 开源的首款大语言模型:501B稀疏MoE架构的工程力作
Beam是Reflection AI推出的首款开源大语言模型,采用501B参数的稀疏MoE架构,每个token仅激活23B参数,支持100万token上下文窗口,预训练消耗23.8T token。该模型在软件工程任务上达到GLM-5.2同级水平,其训练过程堪称重工业级别的算力展示:预训练阶段使用6,144张GB300 GPU在不到四周内完成,随后动用10,500张GB300进行为期四周、超1亿次r...
Poppy – Sierra 联合 Meta 等推出的开放协议草案
Poppy(Personal Agent Protocol)是由 Sierra 联合 Meta 及多家企业共同推出的开放协议草案,旨在解决个人 AI Agent 访问企业服务时的身份识别与授权问题。该协议通过标准化的发现机制、分级权限控制和基于 OAuth 的授权流程,在"Agent 冒充用户"与"企业全面封禁代理"两个极端之间建立了中间方案。目前已有 Stripe、Shopify、Walmart...
VeriLoop E2 – 清华大学开源的 27B 后训练模型
VeriLoop E2 是清华大学深圳国际研究生院机器人实验室开源的 27B 后训练模型,基于 Qwen3.8-27B 底座,面向代码、数学与物理推理场景。该模型采用 Apache-2.0 协议发布权重与分词器,原生支持 262,144 tokens 的上下文窗口。其核心创新在于 VGR(VeriLoop-Governed Recurrence)机制,将"模型提案"与"外部验证/持久化"彻底分离,...
Microsoft-Decision-1:微软推出的新一代快速决策AI模型深度评测
Microsoft-Decision-1是微软推出的一款专为结构化决策任务设计的快速决策AI模型,能够从预设选项中筛选出最优解,并为每个备选答案赋予概率评分,供下游应用判断执行、重试或转人工。该模型基于开源Qwen3.5-9B架构构建,在36项基准测试中准确率均位列第一,推理速度达到GPT-6 Sol的35倍,输入成本仅为每百万tokens 0.042美元且输出免费,已在Microsoft Fou...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。