AI 模型库:热门大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:向量与RAG
共 23 篇文章 · 清除标签
OXR:SoMark 开源的 1.3B 文档解析模型,面向 Agent 的智能文档理解新选择
OXR 是守扣科技 SoMark 开源的 1.3B 参数文档解析模型,专注于将 PDF 与文档图片解析为 Agent 友好的 Markdown/JSON 结构化数据。该模型能够识别文字、表格、公式、化学方程式/结构式、代码块等 13 类文档元素,并输出版面坐标与阅读顺序信息。OXR 在后训练阶段引入 RSI(Recursive Self-Improvement)自我改进闭环,在 OmniDocBe...
DeepSeek Super-agent 深度评测:从被动对话到持续在线协作者的架构跃迁
Super-agent 是由 DeepSeek Harness 团队推出的持续在线 Agent 系统架构。该架构通过双层设计、事件驱动机制、异步多信道交互、存算分离以及 Watchdog 异常自愈能力,实现了连续、高效、主动、持久四个核心特征:跨 IM/GitHub 无缝推进同一任务、并行处理多项工作、主动观察环境事件并自主推进、异常自动恢复。配套开源 MIT 原型 dsh-superagent-...
MemT 1.0 – 记忆张量开源的业内首个记忆原生基座模型
MemT 1.0是记忆张量(MemTensor)团队推出的业内首个记忆原生(Memory-Native)基座模型,已全面开源。该模型摒弃了传统大语言模型依赖外部检索或重复注入历史文本的方式,而是将历史信息编码为可持续更新的内部记忆状态,使模型能够在推理计算过程中直接读写记忆。MemT 1.0包含Flash(288B参数/17B激活)和Nano(36B参数/3B激活)两个版本,在11项记忆基准上位列...
Hy Memory 2.0 – 腾讯混元开源的智能体记忆框架
Hy Memory 2.0 是腾讯混元开源的智能体记忆框架,采用"模型 + 框架 + 应用"三层架构:专为记忆训练的 Hy-Memory-30A3B 模型、支持聊天/工作/代码三类记忆的 SDK,以及可连接 10 种 AI 工具的本地记忆管理应用 MemHub。该框架能够跨对话、跨工具沉淀和同步个人记忆,使 Agent 具备连续、完整的长期记忆能力,已在腾讯自选股、腾讯新闻等核心业务中落地验证。
LFM2.5-24B-A2B – Liquid AI 开源的端侧推理模型
LFM2.5-24B-A2B 是 Liquid AI 推出的开源权重推理模型,隶属 LFM2.5 系列旗舰产品。该模型采用 40 层混合专家(MoE)架构,总参数量达 24B,但每个 token 仅激活 2.45B 参数,支持 131K 上下文窗口与 16 种语言。LFM2.5-24B-A2B 在回答前会生成显式思维链(CoT),专为端侧 Agent 场景优化,其 LiveClaw 得分达 48....
OpenViking – 字节开源的 AI Agent 上下文数据库
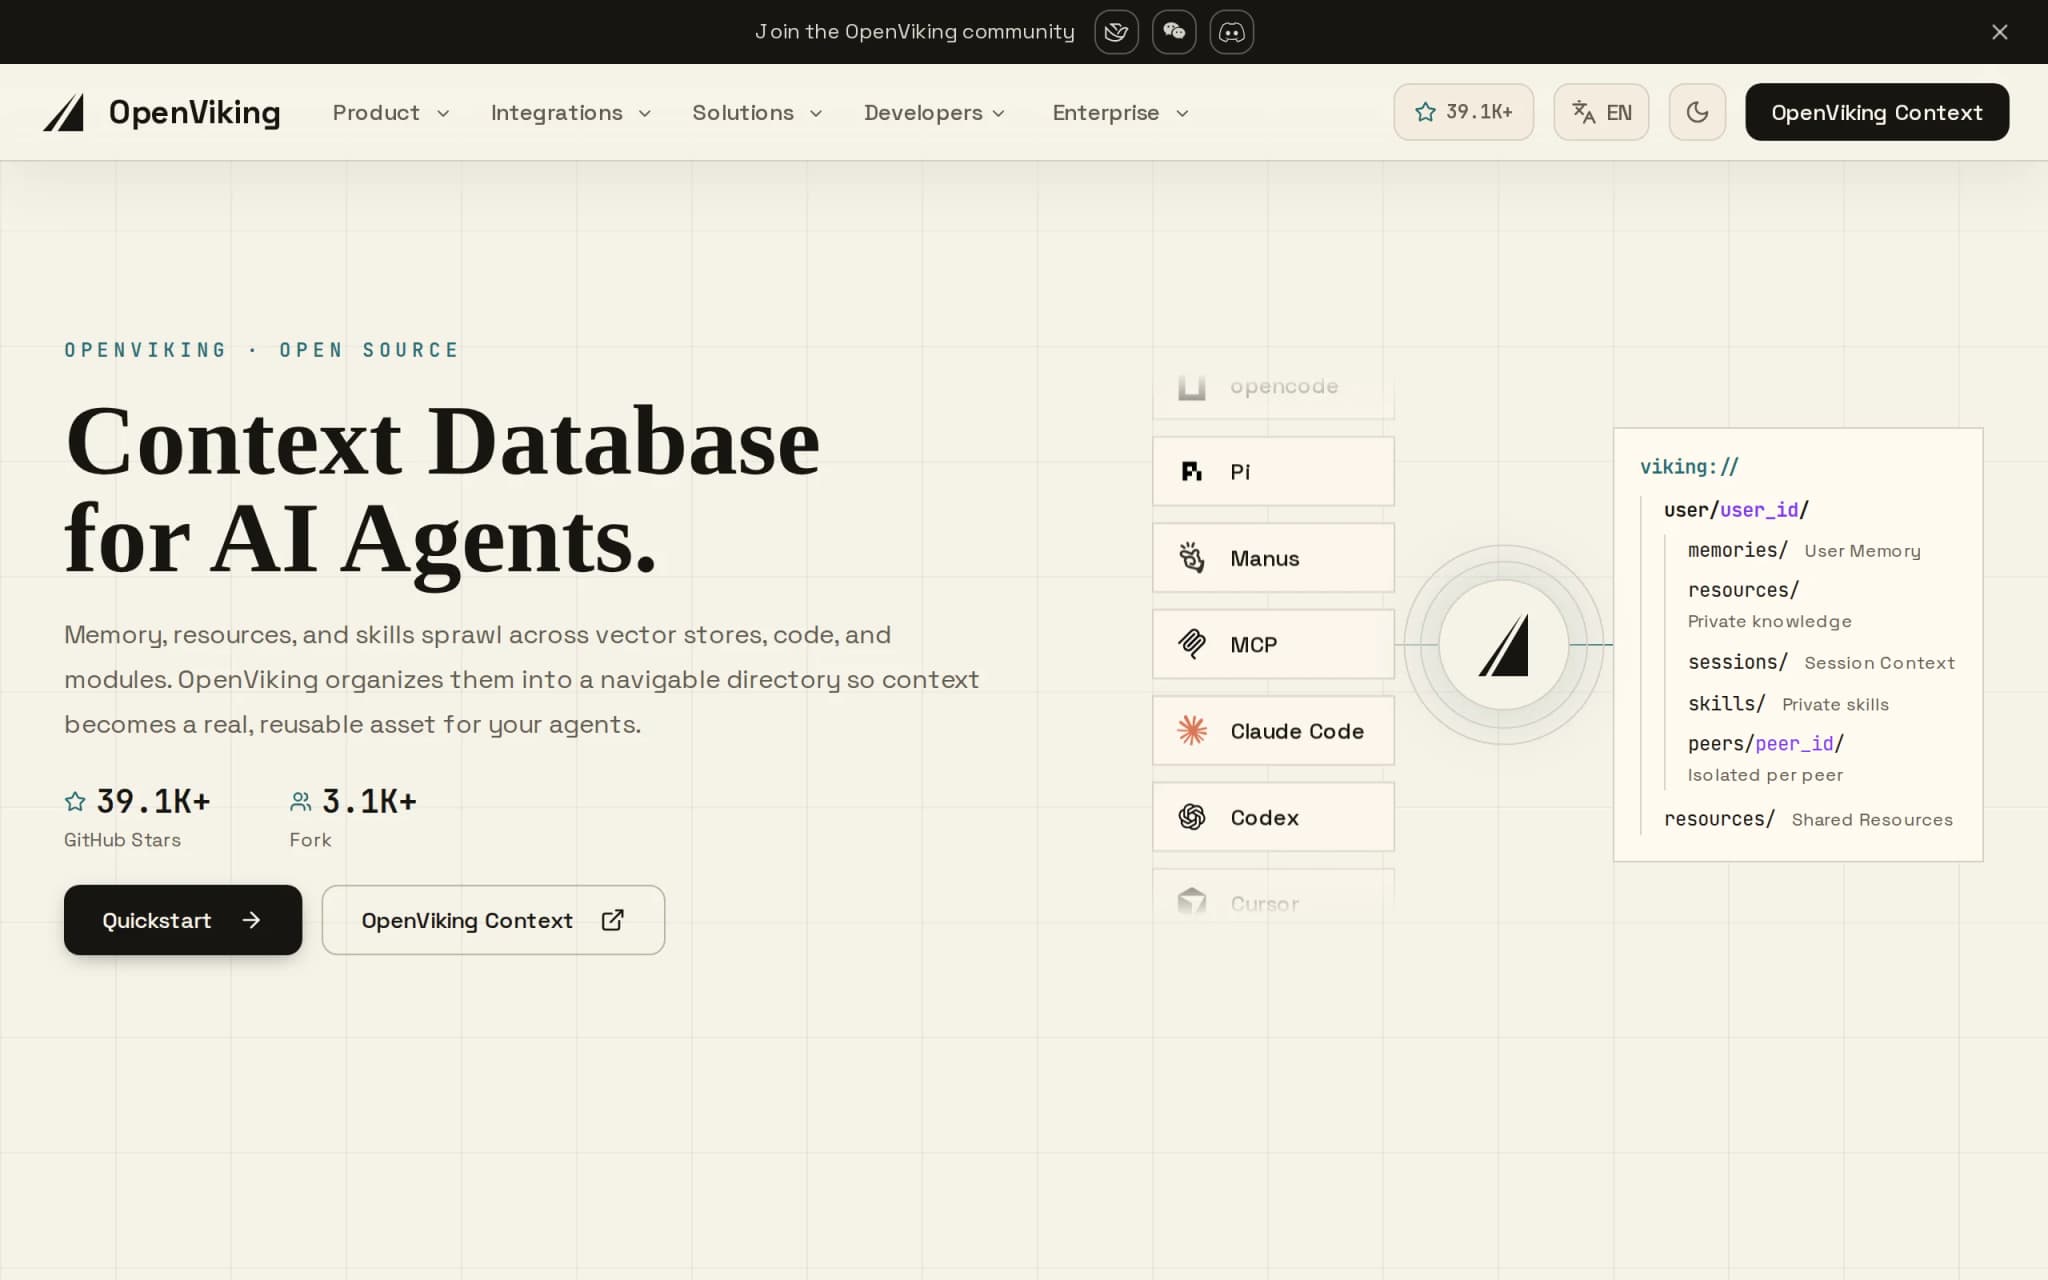
OpenViking是由字节跳动火山引擎开源的一款AI Agent上下文数据库,其核心思路是将Agent的记忆、知识RAG和技能统一组织在自定义的`viking://`虚拟文件系统中。Agent可以通过`ls`、`tree`、`find`、`grep`等命令像操作文件一样浏览和检索上下文,告别传统“text in, embeddings out”的黑盒模式。借助L0摘要、L1概览、L2详情三层渐进...
大模型 RAG 技术解析:从基础流程到高级检索架构与评估优化
我想把 RAG(Retrieval Augmented Generation,检索增强生成)从基础到进阶讲清楚,因为它已经成为目前大模型应用落地最热门的方案。如果你正在把大模型接入实际业务,很快会发现通用模型根本不够用——知识过时、回答幻觉、数据安全这三大痛点几乎无法回避。这篇文章适合两类读者:一类是刚接触 RAG、想理解整体流程和核心概念的开发者;另一类是已经搭过简单 RAG 系统、想在检索质量
zg(zvec-grep)- Zvec AI 开源的本地优先统一检索基础工具
zg(zvec-grep)是 Zvec AI 开源的本地优先统一检索基础工具,面向开发者与 AI Agent 设计。该工具将 ripgrep 的精确匹配能力、BM25 词法检索与向量语义检索整合为单一检索链路,有效解决自然语言意图与代码或文档实际表述之间的词汇鸿沟,实现从模糊探索到精确定位的完整检索流程。文件扫描、Embedding 生成、索引构建与检索查询默认全部在本地设备完成,内置轻量端侧模型...
FireRedAudio – FireRedTeam 推出的通用音频语言模型
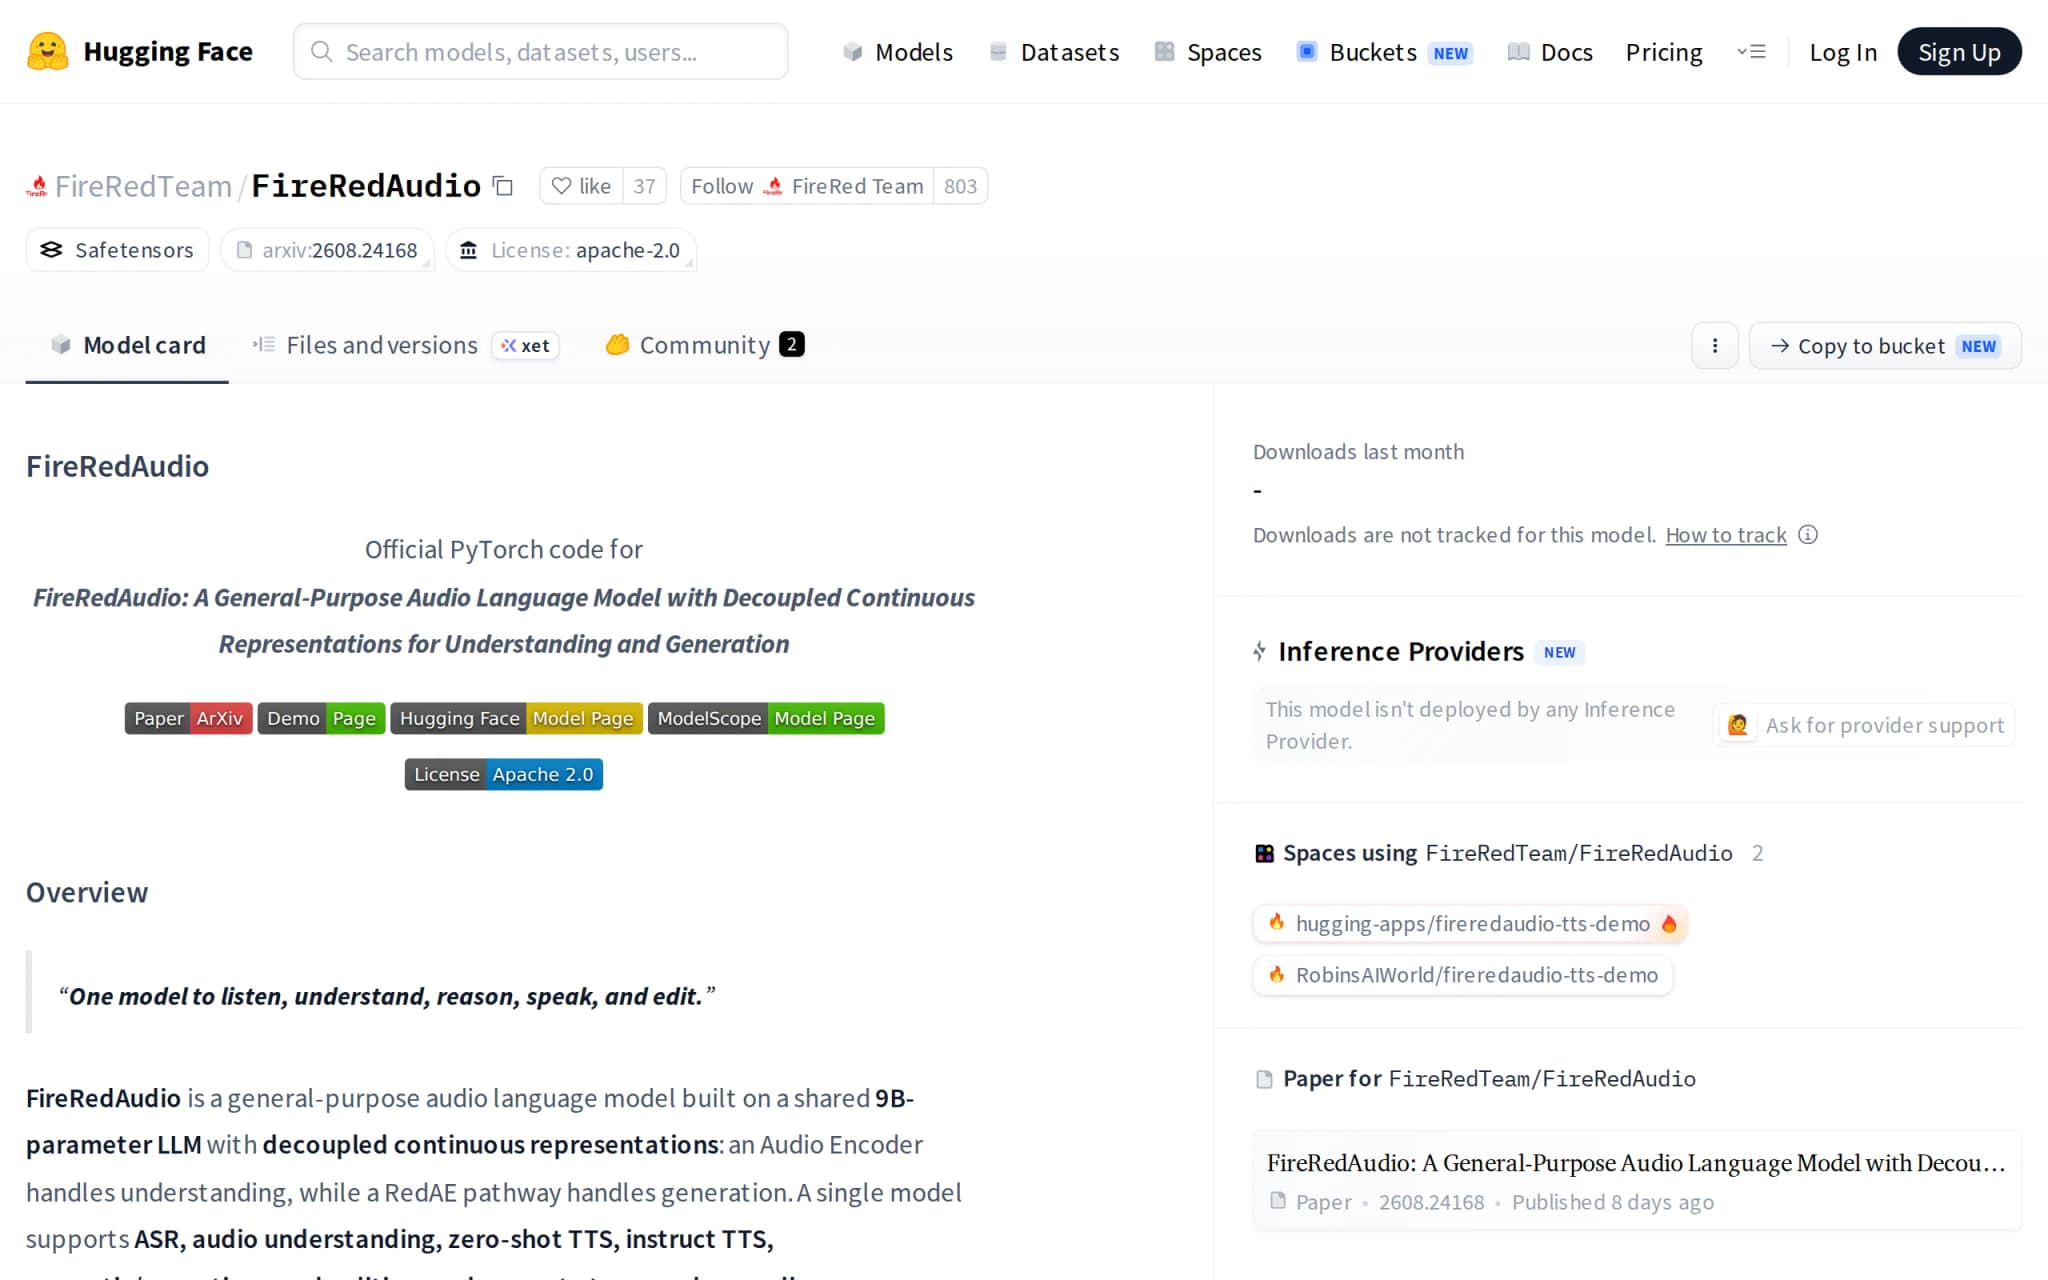
FireRedAudio 是 FireRedTeam 推出的通用音频语言模型,代码、权重和论文都已公开。它用一个共享的 9B 自回归 LLM 做推理主干。理解与生成走解耦的连续表征:Audio Encoder 负责理解,RedAE 与 flow-matching DiT 负责生成。
MyContext – 阿里千问办公开源的Agent上下文基础设施深度评测
MyContext是阿里云千问办公团队推出的开源Agent上下文基础设施,采用本地优先架构,能够将钉钉、飞书等即时通讯工具、文档及会议系统中的多源工作数据,自动加工为持续更新、可回溯的专属工作档案。该档案涵盖职责范围、协作关系与工作结论,遇到矛盾信息时通过语义分析判断合并或覆盖,无法确定时交由用户确认。基于该档案可构建个性化Agent,实现工作信息查询与拟人化自动回复,补齐了Agent在办公场景中...