AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:推理模型
共 54 篇文章 · 清除标签
DeepSeek Super-agent 深度评测:从被动对话到持续在线协作者的架构跃迁
Super-agent 是由 DeepSeek Harness 团队推出的持续在线 Agent 系统架构。该架构通过双层设计、事件驱动机制、异步多信道交互、存算分离以及 Watchdog 异常自愈能力,实现了连续、高效、主动、持久四个核心特征:跨 IM/GitHub 无缝推进同一任务、并行处理多项工作、主动观察环境事件并自主推进、异常自动恢复。配套开源 MIT 原型 dsh-superagent-...
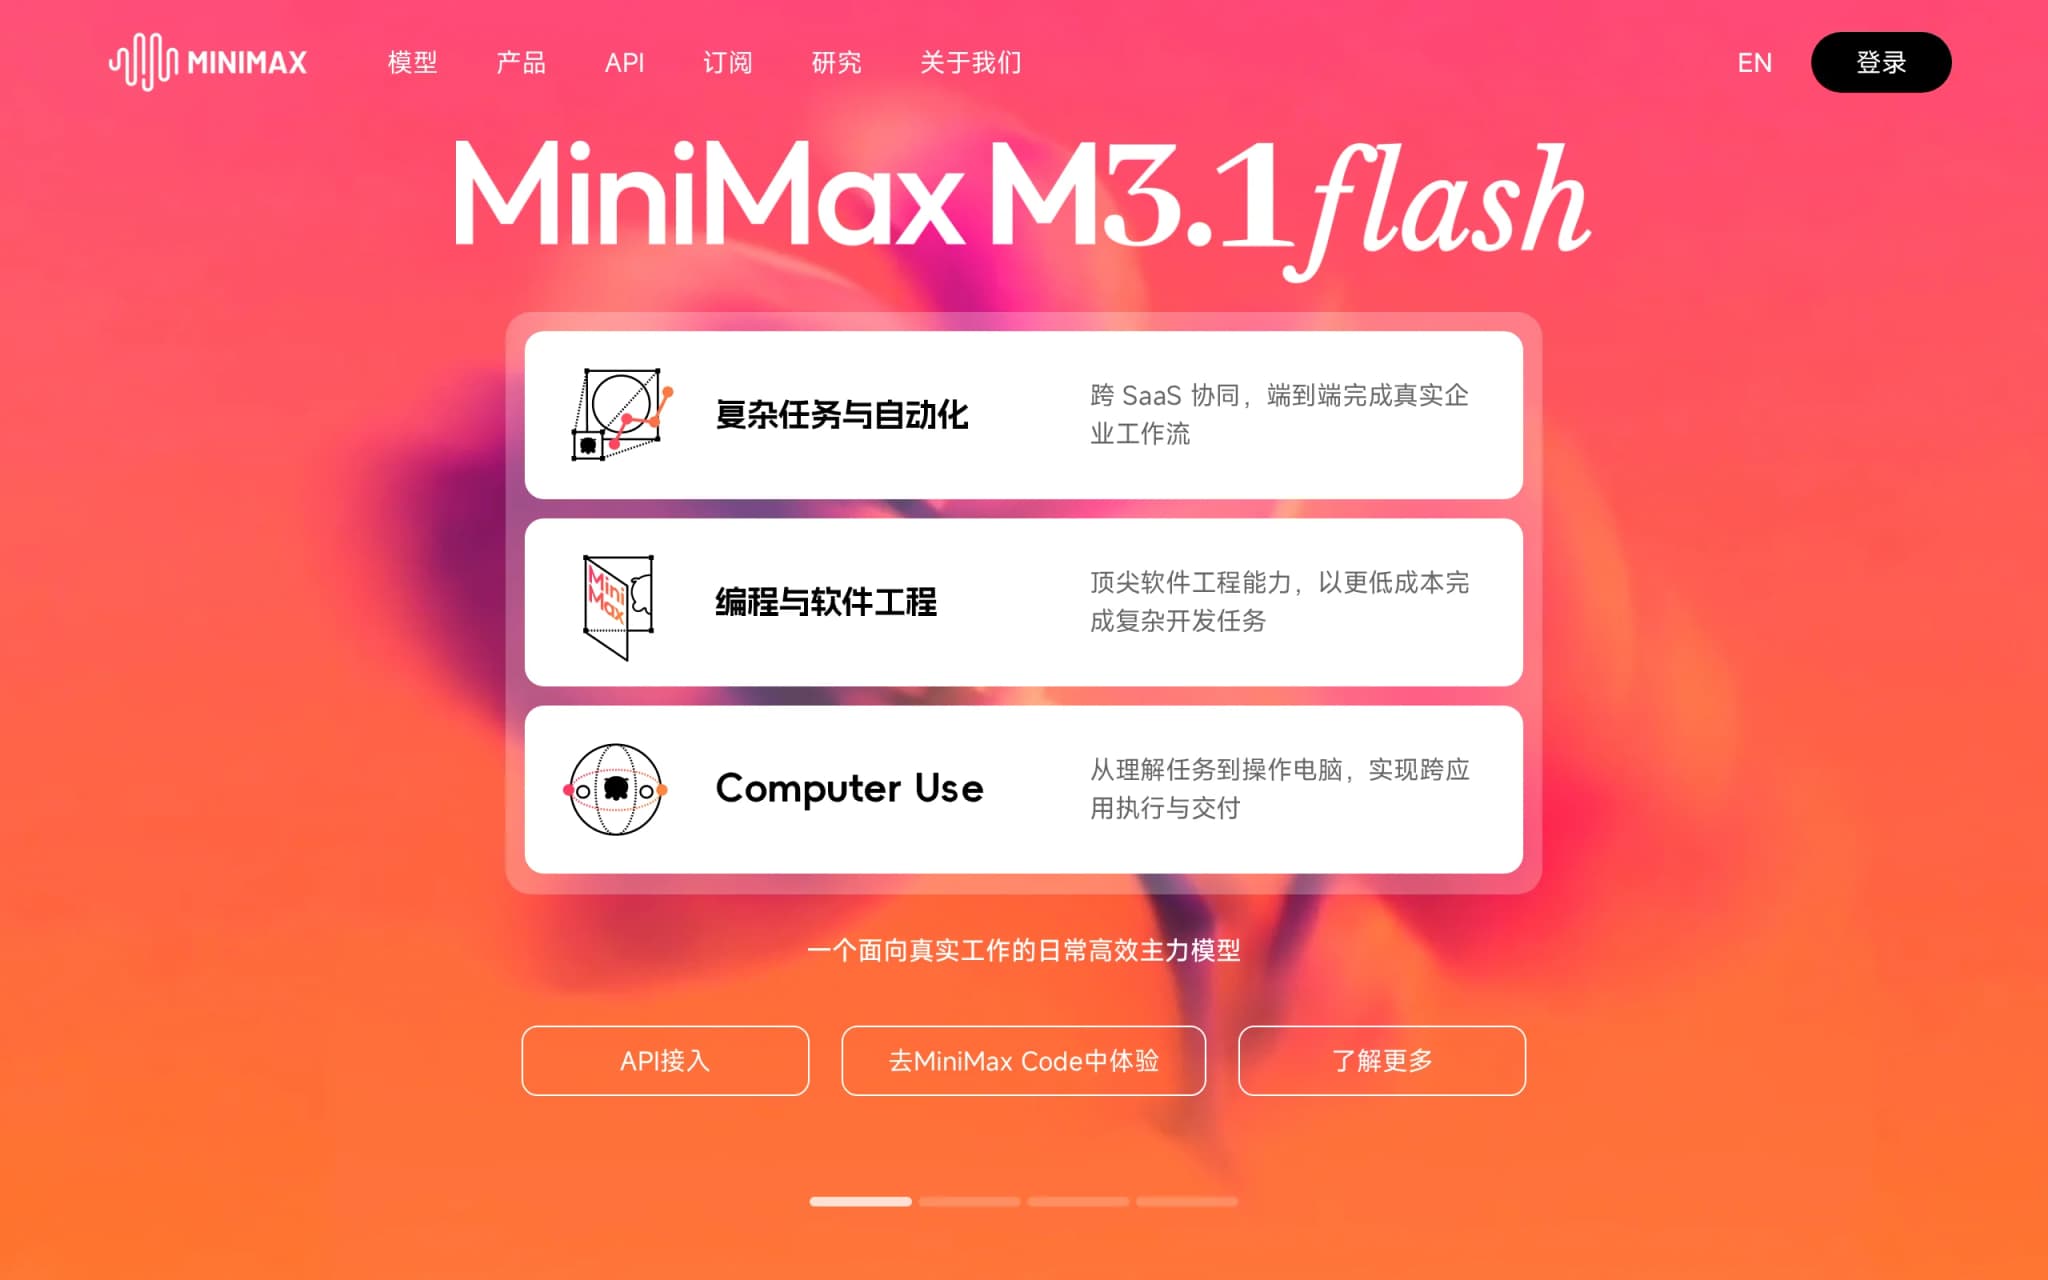
MiniMax M3.1 Flash – MiniMax 推出的一代 Flash 模型
MiniMax M3.1 Flash是MiniMax于2026年推出的新一代Flash系列模型,以匿名“Space Bunny”身份在各大评测基准中亮相,训练数据量超过200T Token。该模型在Agentic任务、编程、Computer Use及网络安全四大领域均展现出色表现,DeepSWE v1.1得分73.7%、OSWorld V2得分61.7、CyberGym得分82%,已全面上线Min...
DeepSeek-V4.1-Flash-1017评测:轻量级模型的性能-成本双重优化实践
DeepSeek-V4.1-Flash-1017是DeepSeek推出的轻量级模型迭代版本,网页端、APP与API已同步切换。新版本通过自反馈强化学习训练,大幅提升游戏开发、3D建模等编程能力,可零基础上手完整项目。同时缩短任务时长与输出长度,实现性能与成本的双重优化,适配DeepSeek Harness、CodeBuddy等框架。
LFM2.5-24B-A2B – Liquid AI 开源的端侧推理模型
LFM2.5-24B-A2B 是 Liquid AI 推出的开源权重推理模型,隶属 LFM2.5 系列旗舰产品。该模型采用 40 层混合专家(MoE)架构,总参数量达 24B,但每个 token 仅激活 2.45B 参数,支持 131K 上下文窗口与 16 种语言。LFM2.5-24B-A2B 在回答前会生成显式思维链(CoT),专为端侧 Agent 场景优化,其 LiveClaw 得分达 48....
MiniCPM-V 4.7 评测:端侧 MoE 多模态大模型的开源里程碑
MiniCPM-V 4.7 是面壁智能联合 OpenBMB 社区开源的端侧多模态大模型系列,包含 35B-A3B(MoE 架构)与 1B 两个版本。旗舰版 35B-A3B 是全球首个可在手机端无损流畅运行的开源 MoE 多模态模型,通过前瞻专家调度(LES)技术,仅需约 3GB 内存即可在 iPhone 上实现 13+ tokens/s 的实时生成速度,并在 34 项权威基准测试中全面领先同档位模...
GLM-Legal – 智谱推出的法律专用大模型
GLM-Legal是智谱AI推出的法律专用大模型,基于轻量级基座GLM-5.3-Flash,通过法律领域中间训练与强化学习后训练打造。该模型覆盖阅读材料、提取事实、分析法律关系、制定建议、生成专业文件的完整工作流,支持合同审查、证据分析、法律研究、合规规划等任务。在官方评测中,Harvey LAB全项通过率达19.2%,LegalBench与PLawBench表现持平前沿闭源模型,展示了小参数规模...
VeriLoop E2 – 清华大学开源的 27B 后训练模型
VeriLoop E2 是清华大学深圳国际研究生院机器人实验室开源的 27B 后训练模型,基于 Qwen3.8-27B 底座,面向代码、数学与物理推理场景。该模型采用 Apache-2.0 协议发布权重与分词器,原生支持 262,144 tokens 的上下文窗口。其核心创新在于 VGR(VeriLoop-Governed Recurrence)机制,将"模型提案"与"外部验证/持久化"彻底分离,...
SemIf – 开源的 AI 决策模型,复现 Jev 语义决策模式
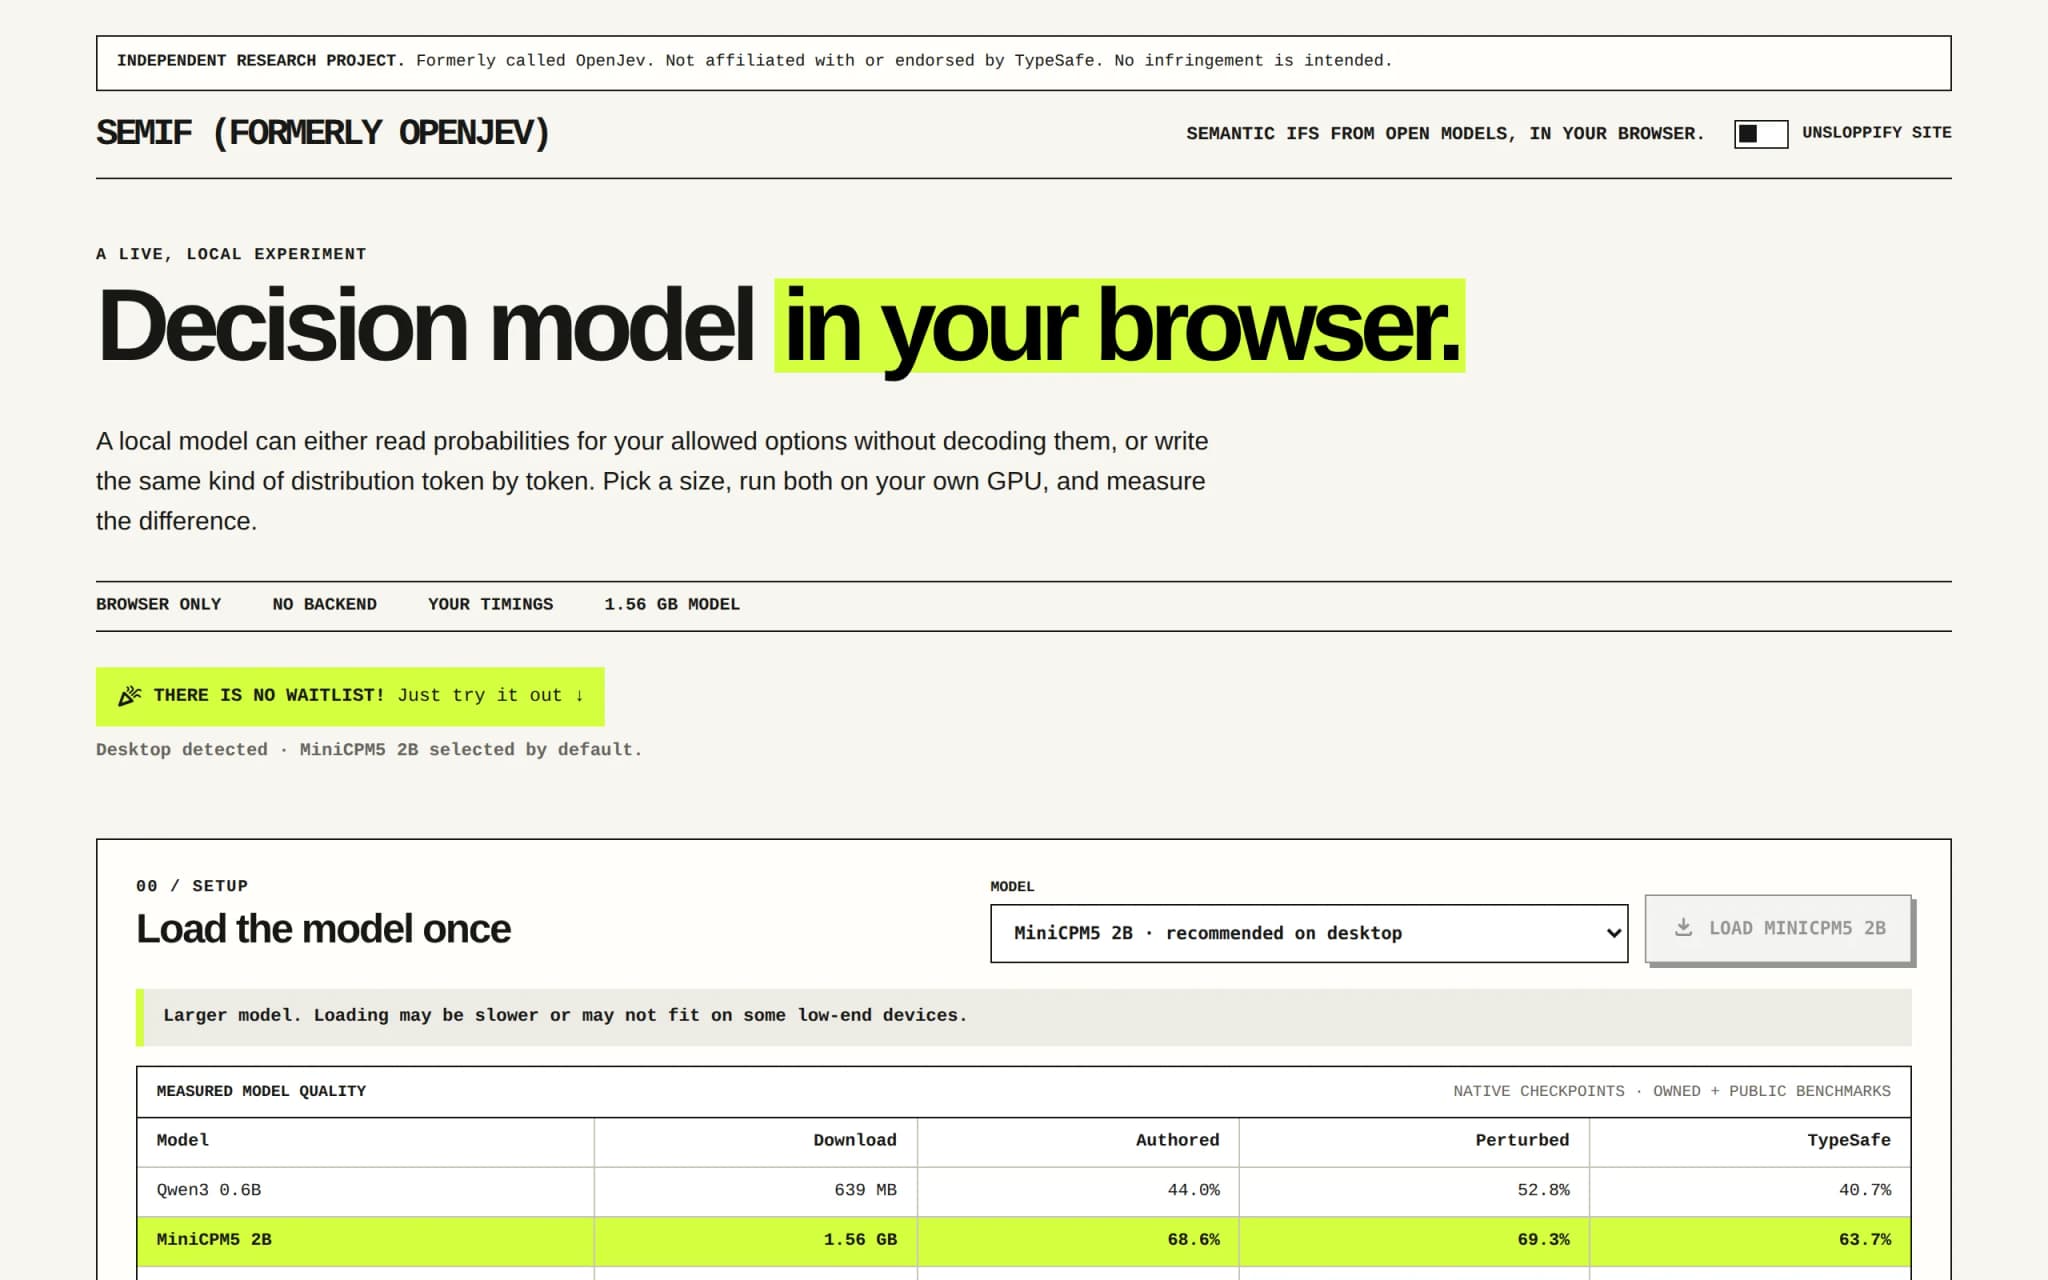
SemIf(原 OpenJev)是一个开源的 AI 决策模型,旨在通过开源手段复现 TypeSafe 闭源服务 Jev 的语义决策接口模式。该模型采用单次前向传播机制,直接读取候选选项对应的 logits 进行打分,由服务端构造结构化结果,从而规避了传统自回归生成后再解析文本的复杂流程。在多个问题共享相同状态时,SemIf 还可复用前缀计算,吞吐量提升近一个数量级。该模型在单张 RTX 3090 ...
Index-Translate – B站开源的多语言翻译模型家族
Index-Translate是B站(哔哩哔哩)Index LLM团队开源的多语言翻译模型家族,基于Qwen3.5底座构建,采用Apache-2.0协议开放权重。该家族文本模型覆盖150种语言互译,提供2B、9B、35B-A3B三种参数规模,支持术语统一、格式保留、指定字段翻译等指令约束。除文本翻译外,家族还包含Index-Echo语音翻译、Index-Homura音节可控翻译、Index-Nat...
GPT-6.1 Sol – OpenAI 推出的新一代主力模型
GPT-6.1 Sol是OpenAI于2026年推出的新一代主力模型,作为GPT-6 Sol的升级版本,以GPT-6 Astra旗舰五分之一的Token价格实现接近后者的智能水平。该模型聚焦智能体编程、电脑操作和专业工作三类高消耗场景,在DeepSWE v1.1真实代码库工程任务上追平Astra,在OSWorld 2.0电脑操作评测中仅落后2.1个百分点,同时将缓存输入价格压至每百万Token仅0...