AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:视频AI
共 117 篇文章 · 清除标签
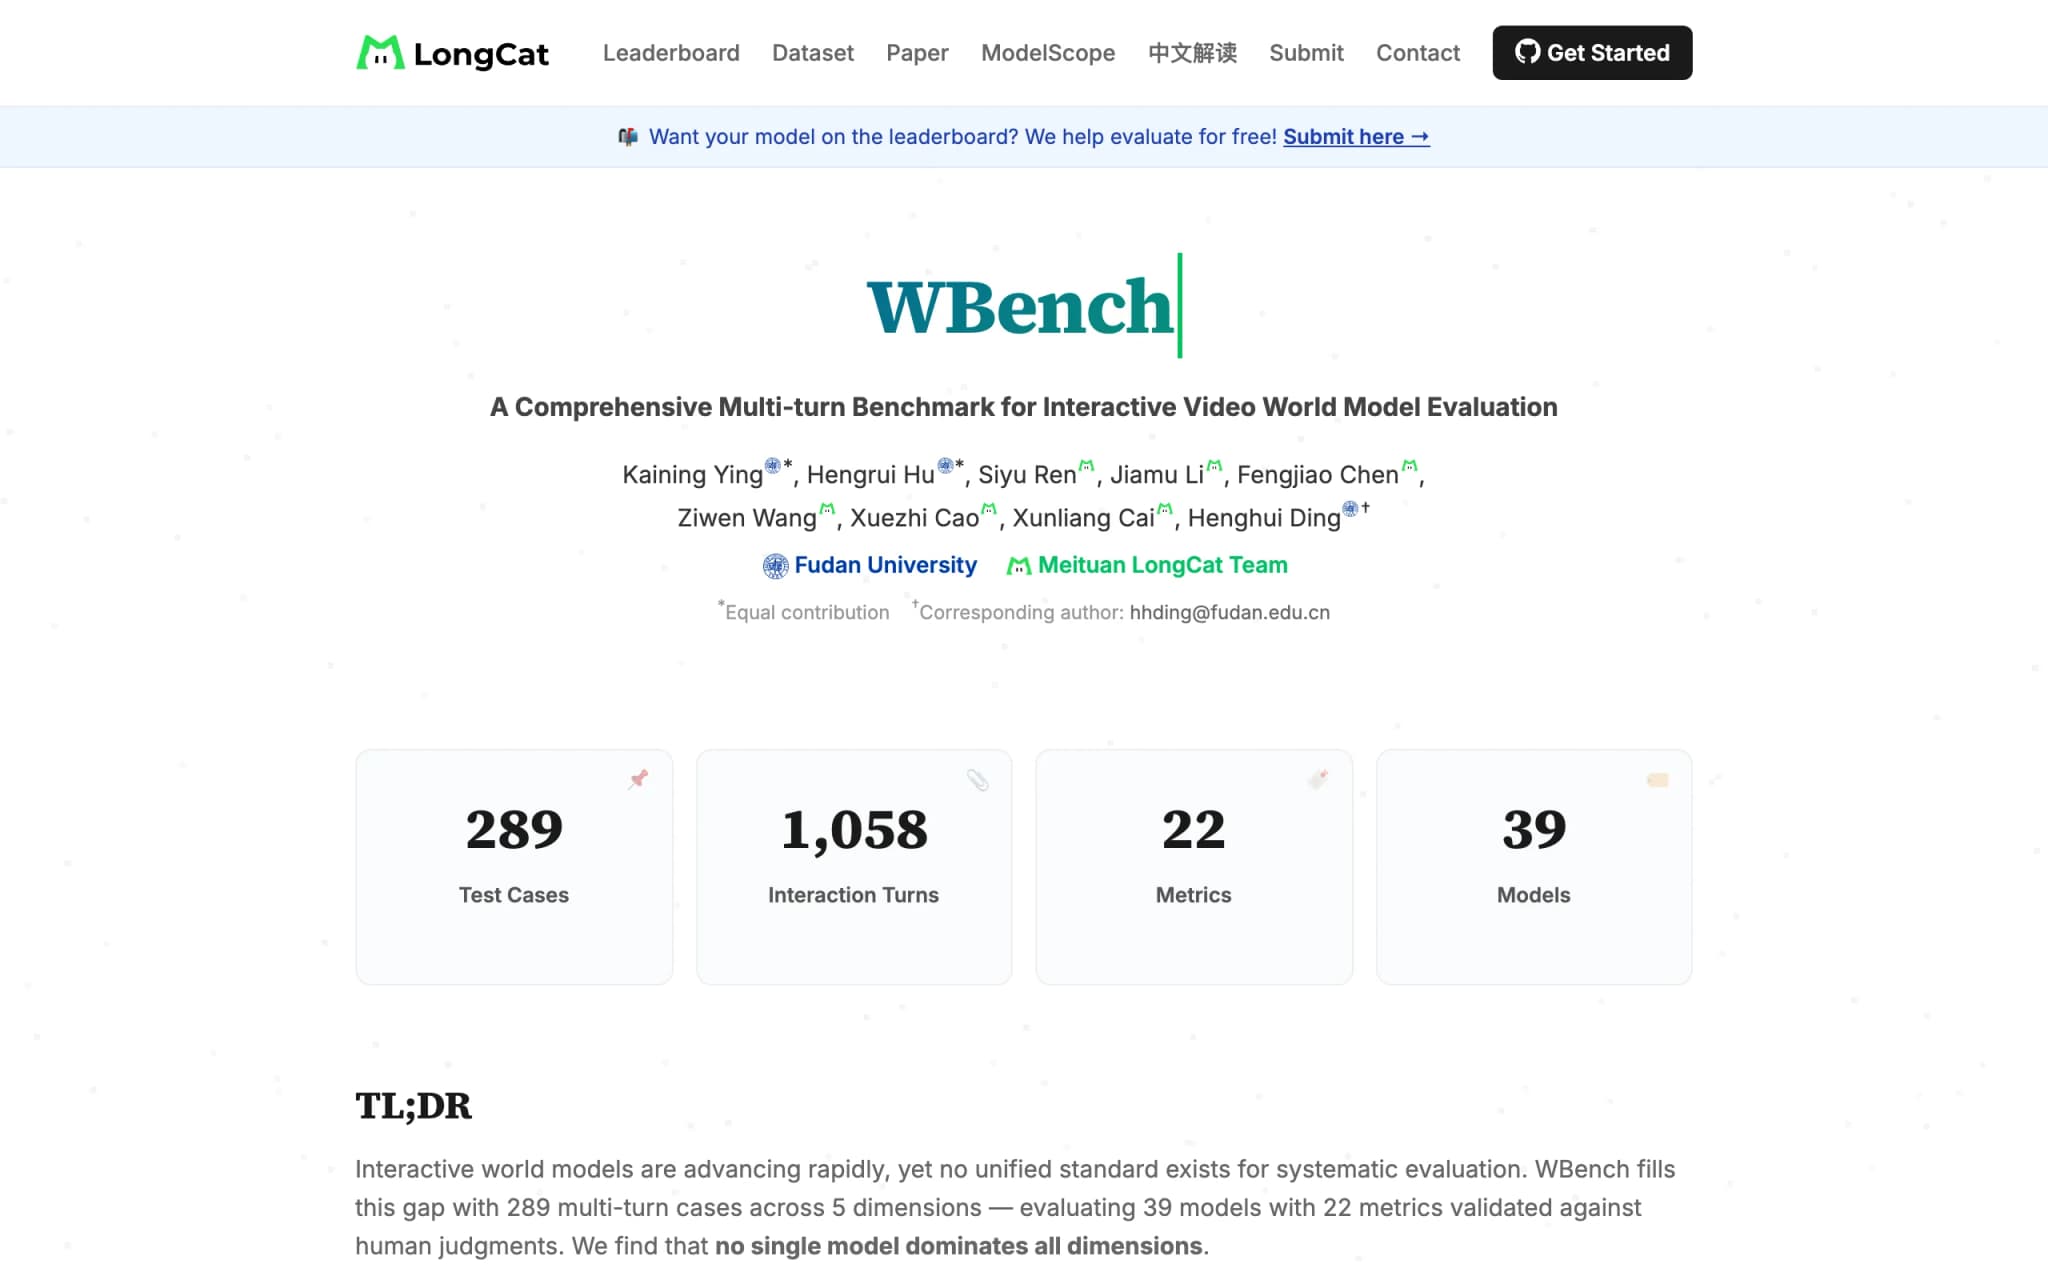
WBench – 美团推出的交互式视频世界模型多轮评测基准
WBench是由美团LongCat团队推出的首个系统性多轮评测基准,专为交互式视频世界模型设计。该基准包含289个测试案例和1058个交互轮次,覆盖自然、城市、室内、工作区、幻想、运动共6类场景与写实、动漫、卡通、油画、水墨、扁平、素描7种艺术风格。WBench通过统一交互接口对20个前沿模型进行标准化评估,精准定位模型从被动观看到主动交互的能力边界,揭示当前世界模型在多轮交互、导航控制和视角切换...
html-video – Open Design 团队开源的 HTML 版剪映
html-video是Open Design团队(nexu.io)开源的HTML版剪映,基于hyperframes框架构建。该工具让智能体通过编写HTML即可生成世界级水准的产品宣传、知识解说等视频内容,内置20多套顶级模板,支持分页编辑、多尺寸导出与Minimax AI配音配乐,无需API Key即可完全本地运行。其核心理念是用HTML/CSS替代传统视频工程,将视频制作的门槛从专业软件操作降低...
Toonflow – 开源的一站式 AI 短剧创作工具
Toonflow 是一款基于多 Agent 协作架构的开源一站式 AI 短剧创作工具,致力于将小说或创意文本自动转化为结构化剧本、智能分镜、角色视觉素材和动画视频,实现从文字到成片的全流程 AI 自动化生产。该工具采用三层 Agent 体系(决策层、执行层、监督层),通过 Vercel AI SDK 和 Socket.IO 实现实时并行协作,并内置基于 ONNX 向量检索的持久化记忆系统,确保跨场...
Bernini – 字节跳动开源的统一视频生成与编辑框架
Bernini是字节跳动开源的一套统一视频生成与编辑框架,采用“多模态大语言模型(MLLM)语义规划 + Diffusion Transformer(DiT)视觉渲染”的两阶段解耦架构。该框架先由MLLM理解文本指令、参考图像或视频素材,在ViT嵌入空间中预测目标语义表示(语义草图),再交由DiT在VAE潜在空间中执行流匹配去噪,生成高质量视频帧。Bernini支持文本生成视频、图像生成视频、环境...
Dubbing v2 – ElevenLabs 推出的 AI 配音模型
Dubbing v2是ElevenLabs在AI配音领域的最新力作,一个集语音识别、神经机器翻译、语音克隆与合成于一体的端到端多语言配音平台。它能够将视频或音频内容自动翻译并配音成29种语言,同时高度保留原始说话人的音色、情感和语调,彻底颠覆了传统配音行业高成本、低效率的工作模式。该模型通过双工作流设计(快速自动配音与精细项目编辑),兼顾了内容创作者对效率和质量的双重需求,为全球内容本地化提供了一...

Cosmos 3 – 英伟达开源的全模态物理 AI 基础大模型
Cosmos 3 是英伟达推出的全球首款全开源、全模态物理 AI 基础大模型,采用创新的混合 Transformer 架构,原生融合视觉推理、世界生成与动作预测能力。该模型能够统一处理并生成文本、图像、视频、环境音效及动作轨迹等多种模态内容,在物理仿真精度上达到了业界领先水平。英伟达同步发起 Cosmos Coalition 联盟,联合 Runway、Black Forest Labs 等顶尖 A...
Gamma-World – 英伟达推出的多智能体世界模型
Gamma-World是NVIDIA研究团队推出的多智能体世界模型,旨在解决多个智能体在同一个模拟世界中平等交互、全局一致的难题。该模型创新性地采用单纯形旋转编码(Simplex Rotation Encoding)保证智能体身份对称,配合稀疏枢纽注意力(Sparse Hub Attention)将多智能体间的通信复杂度从平方级降至线性级,从而实现实时、可扩展的多视角视频生成。Gamma-Worl...
MiniMax M3 – MiniMax 推出的一代 AI 模型
MiniMax M3是MiniMax公司推出的新一代AI模型,采用创新的MSA稀疏注意力架构与MoE混合专家结构,在编程、Agent与长文本处理领域展现出领先性能。该模型总参数量196B,但每次推理仅激活约11B参数,支持高达100万tokens的超长上下文,处理效率较传统模型提升20倍。在SWE-Bench Pro等权威评测中,M3的编程能力已超越GPT-5.5等主流模型,同时原生支持图像与视频...
ControlFoley – 小米开源的可控视频音效生成模型
ControlFoley是由小米研究院开源的可控视频音效生成模型,旨在解决视频到音频(V2A)领域长期存在的可控性难题。该模型统一支持三类视频配音任务:文本引导配音(TV2A)、文本控制配音(TC-V2A)和参考音频控制配音(AC-V2A),通过自研的时空音视频编码器CAV-MAE-ST、时间-音色解耦机制与模态鲁棒训练策略,实现了语义对齐、时间同步与音质的全面提升。在VGGSound-Test、...
Keye-VL-2.0-30B-A3B – 快手开源的自研多模态大模型
Keye-VL-2.0-30B-A3B是快手自主研发并完全开源的多模态大语言模型,基于30B参数规模(采用MoE架构,实际激活参数约3B),首次将DeepSeek Sparse Attention(DSA)稀疏注意力机制引入多模态理解领域。模型支持256K超长上下文窗口,能够对小时级视频进行几乎无损的端到端时序推理,在TimeLens基准测试的多项视频理解指标上超越Gemini-2.5-Pro和G...