
AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:多模态
共 194 篇文章 · 清除标签
虎牙VAM 1.0 – 虎牙推出的实时多模态数字人基础模型
虎牙VAM 1.0(Vivid Avatar Model)是虎牙公司推出的基于DiT(Diffusion Transformer)架构的实时多模态数字人基础模型。该模型能够在仅提供一张照片的条件下,生成可说话、唱歌、跳舞的AI数字人,并以480×832分辨率、28帧流式输出实现7×24小时实时直播互动。VAM 1.0支持全双工对话、即时打断、弹幕回复与多角色策略游戏,在真实感、身份保持与推理速度上...
Wan-Streamer – 阿里开源的实时全双工多模态基础模型
Wan-Streamer 是阿里达摩院开源的端到端实时全双工多模态基础模型,通过统一因果 Transformer 架构将文本、音频、视频的输入输出 token 整合为同一条因果序列,实现亚秒级实时双向视频交互,模型响应延迟仅 200ms,端到端总延迟 550ms,稳定输出 25FPS 同步音视频。该模型摒弃了传统多模块拼接方案(ASR+LLM+TTS+渲染),以单一模型完成感知、理解与生成的全流程...
Xiaomi Miloco 2.0 – 小米开源的全屋智能 AI 方案
Xiaomi Miloco 2.0 是小米基于自研 MiMo-V2.5-Pro 大模型推出的开源全屋智能 AI 方案,通过 OpenClaw 框架以 Agent 形式接入,实现多模态感知、主动智能、持续任务与家庭记忆四大核心能力。该方案旨在将智能家居从传统的被动执行角色,进化为能够主动理解家庭环境与成员需求的智能管家,同时确保原始数据本地保存,隐私安全可控。
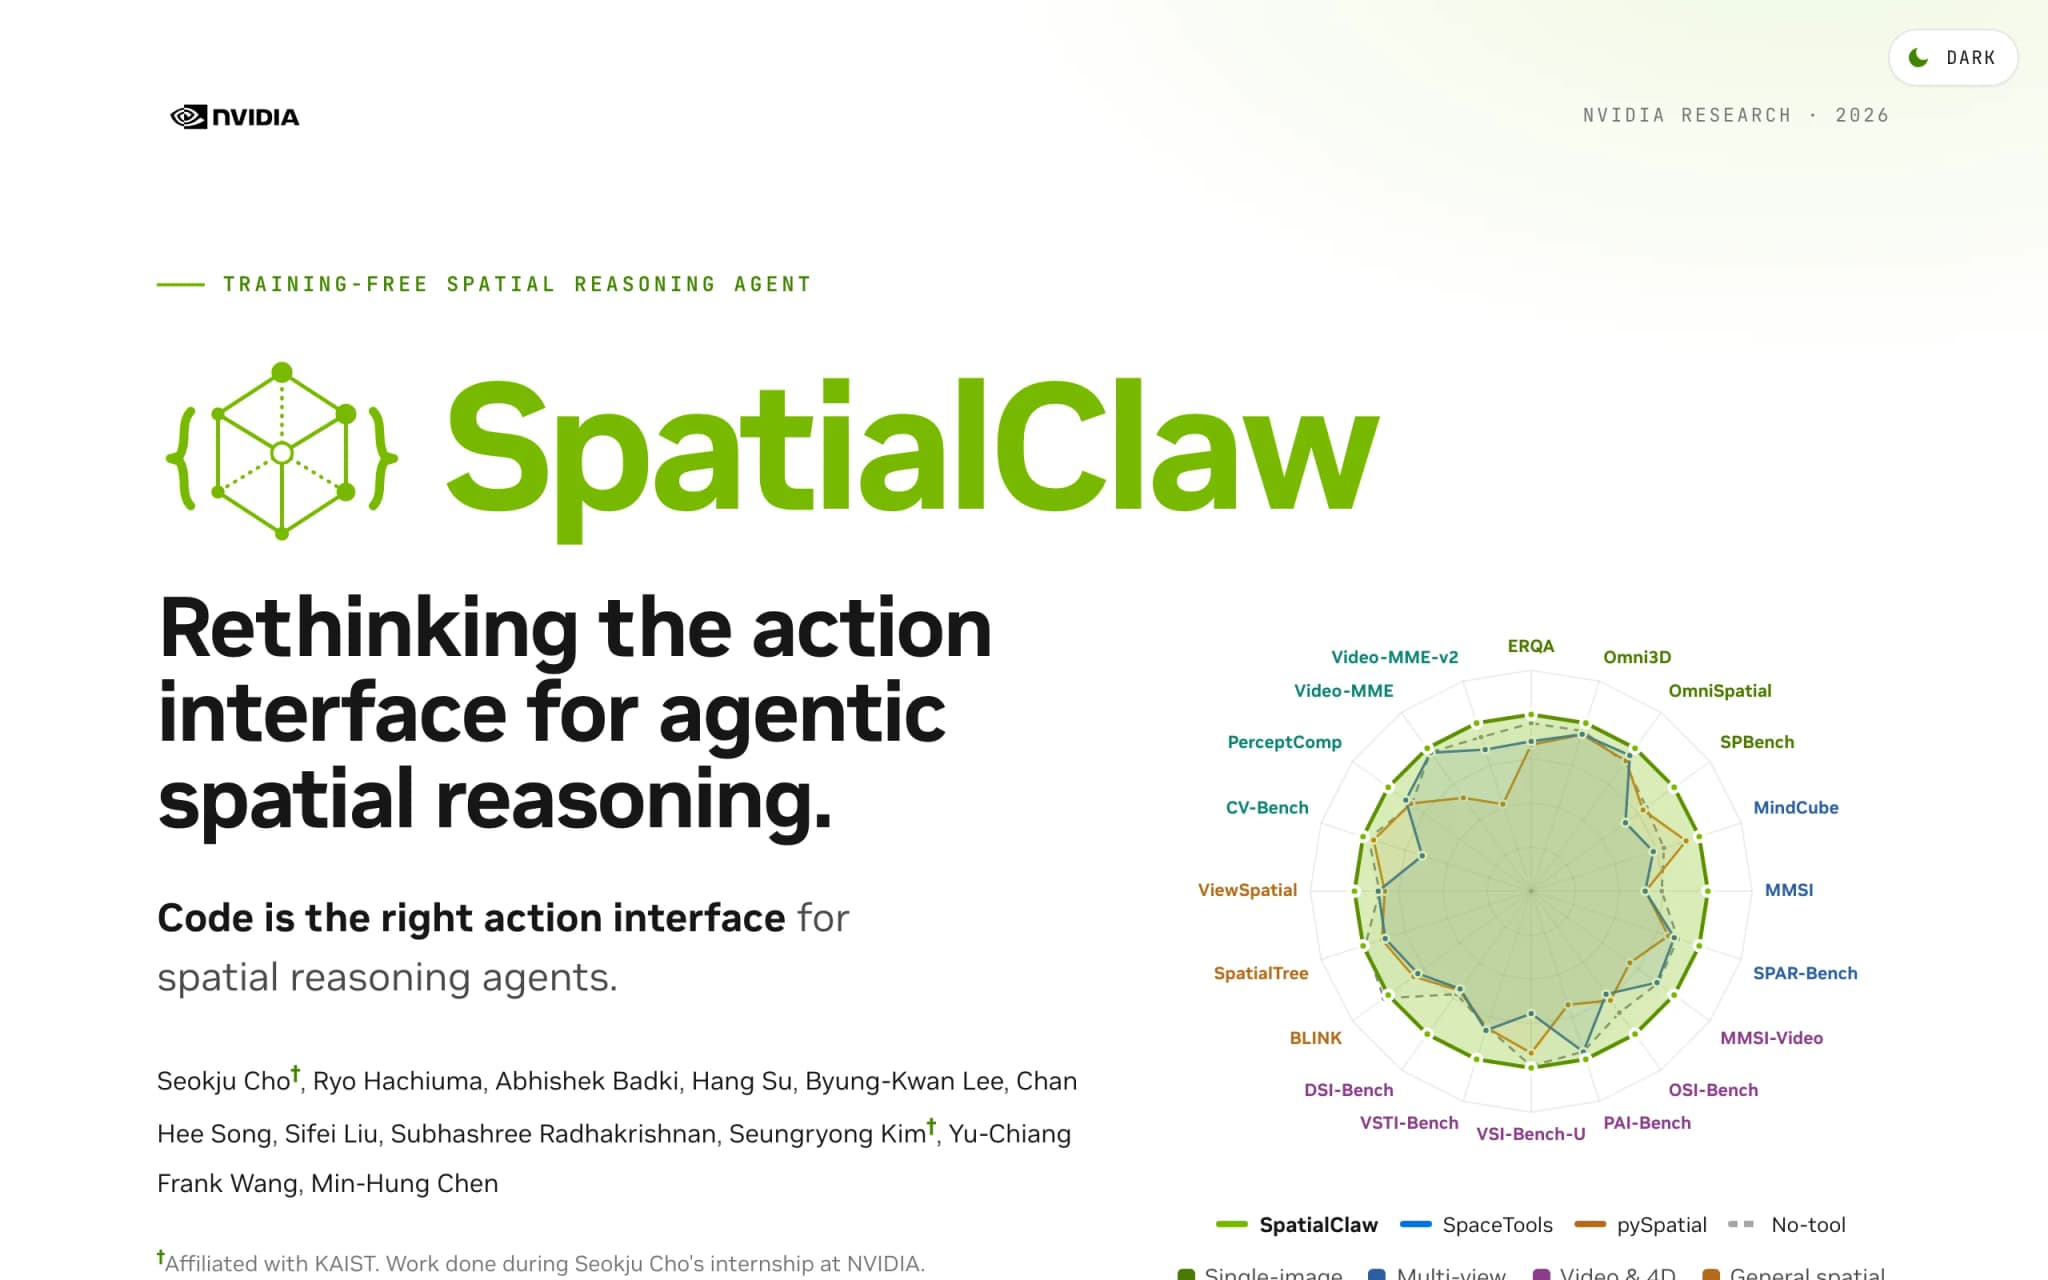
SpatialClaw – 英伟达联合 KAIST 推出的免训练空间推理框架
SpatialClaw 是 NVIDIA Research 与韩国科学技术院(KAIST)联合推出的免训练空间推理智能体框架,通过“代码即动作”机制在持久化 Python 内核中迭代执行复杂 3D/4D 空间推理任务。该框架在 20 项空间推理基准上平均准确率达 59.9%,超越此前最优方法 SpaceTools 11.2 个百分点,并在动态 4D 任务(如 DSI-Bench 和 MindCub...
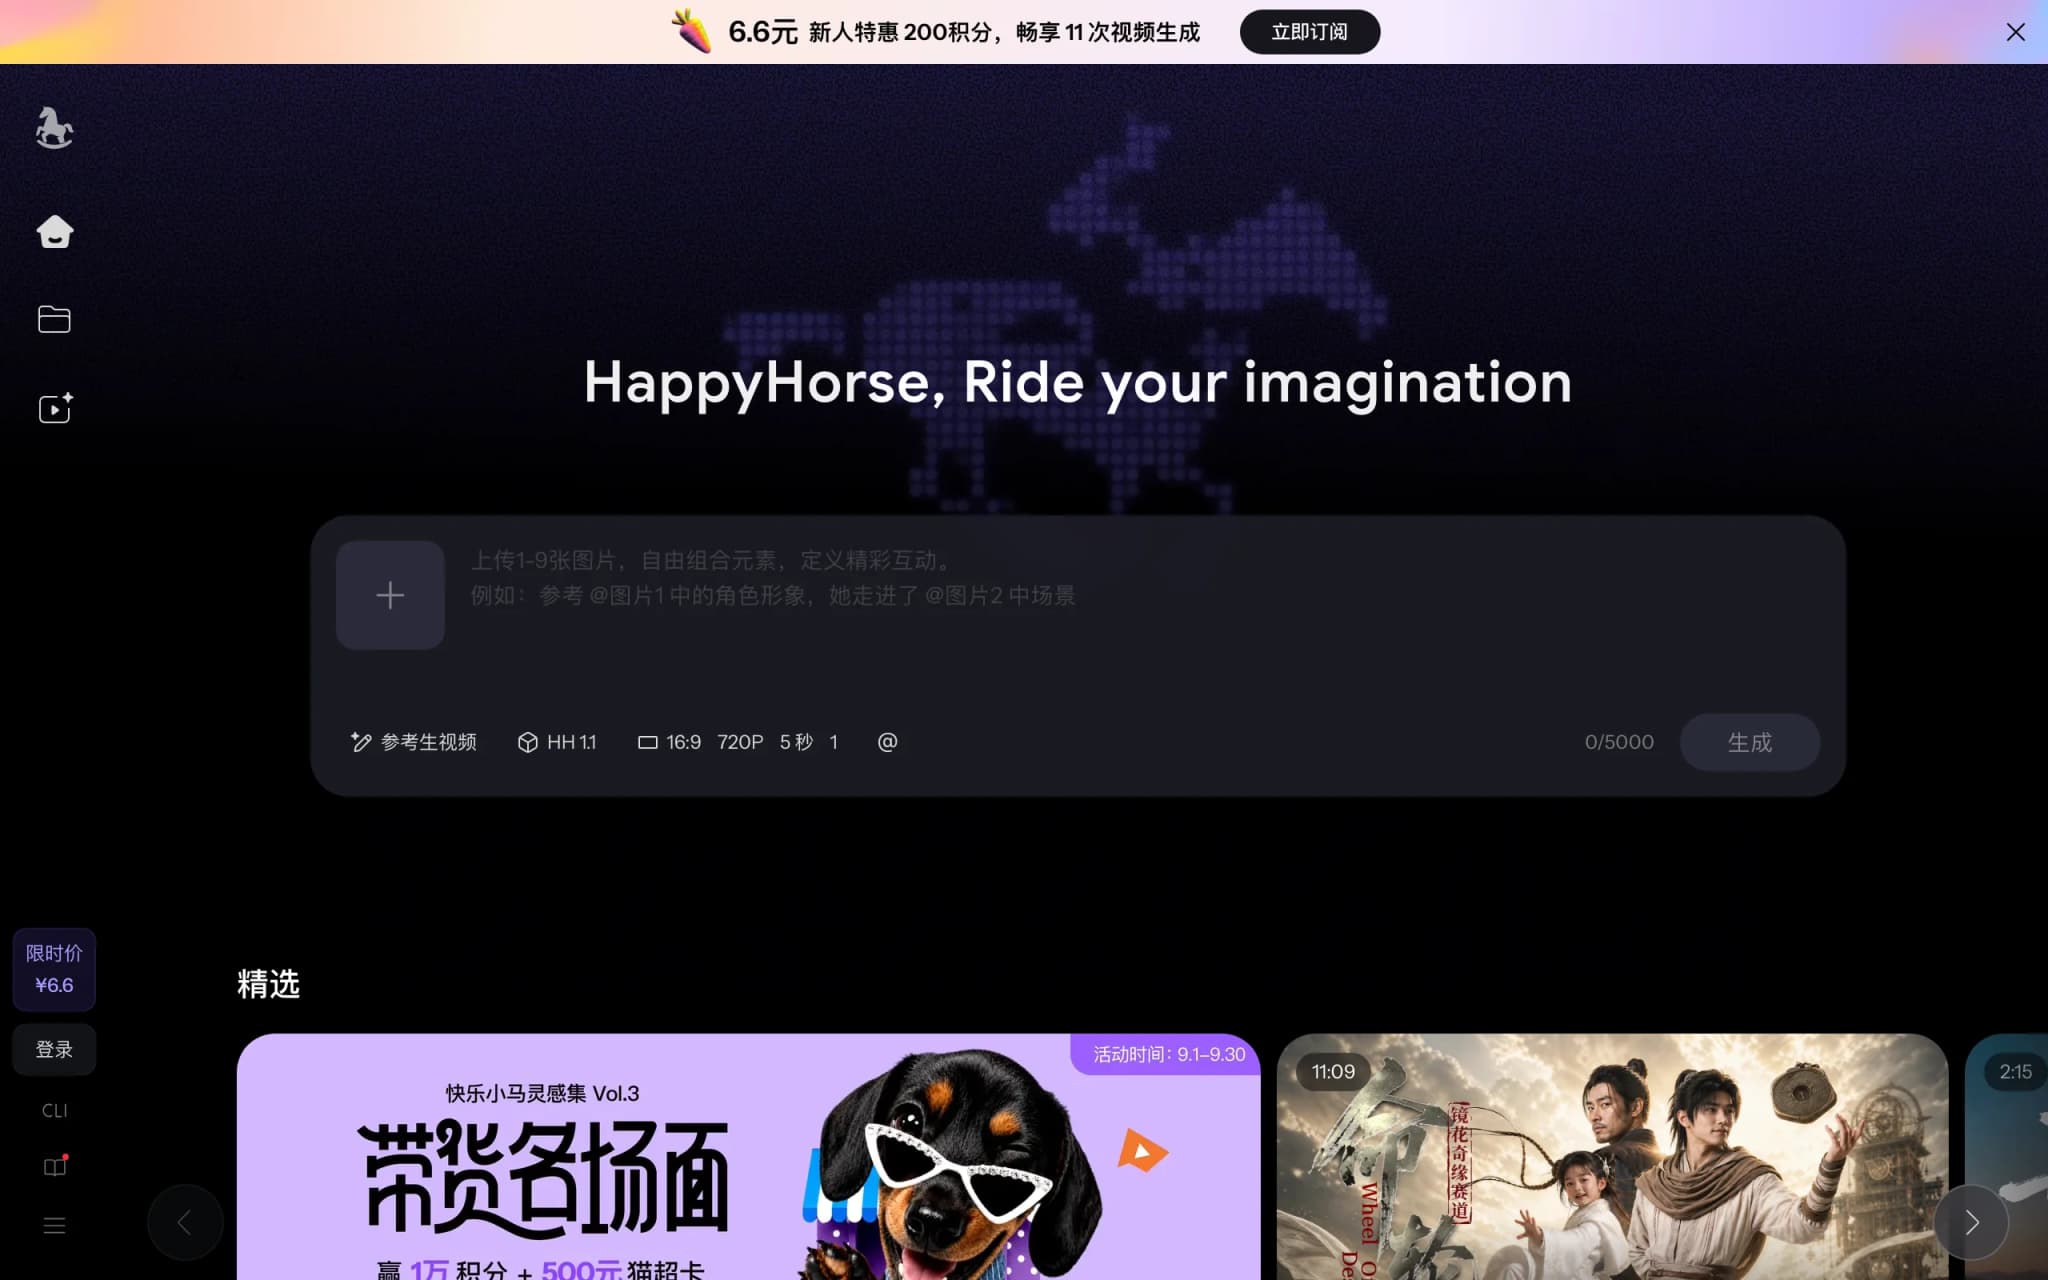
HappyHorse 1.1 – 阿里推出的升级版AI视频生成模型
HappyHorse 1.1是阿里巴巴集团旗下堆友平台最新发布的AI视频生成模型升级版本,在1.0基础上围绕动态表现力、主体一致性、指令遵循、视觉质感和音频能力五大维度实现了系统性升级。该模型延续统一单流Transformer架构,支持文本到视频、图像到视频两种输入方式,单次生成时长3至15秒,输出分辨率涵盖720p与1080p,并支持自由宽高比。其核心技术亮点包括DMD-2蒸馏加速将推理步数压缩...
AudioX-Turbo – Noiz AI 联合清华推出的音频生成框架
AudioX-Turbo 是 Noiz AI 联合香港科技大学、清华大学共同推出的一款统一高效音频生成框架。该框架基于 2.7B 参数的多模态扩散 Transformer 架构,支持文本、视频、音频任意组合输入,能够生成高质量的音效与音乐片段。通过分布匹配蒸馏(DMD)与对抗蒸馏技术,模型将推理步数从传统的 50–200 步压缩至仅 4 步,在单张 RTX 4090 上生成 10 秒音频仅需 0....
Boogu-Image-0.1 – Boogu开源的统一图像生成与编辑模型
Boogu-Image-0.1是Boogu团队开源的统一图像生成与编辑模型家族,在同一架构下同时支持文生图、指令式图像编辑及中英双语文本渲染三大核心任务。家族包含Base、Edit和Turbo三个变体,其中Edit变体拥有10B参数,Turbo变体通过蒸馏技术实现3-4步极速推理。在自建的Boogu Arena千级提示词ELO评测中,该系列位列所有参评开源与闭源系统前排,并在Qwen-Image-...
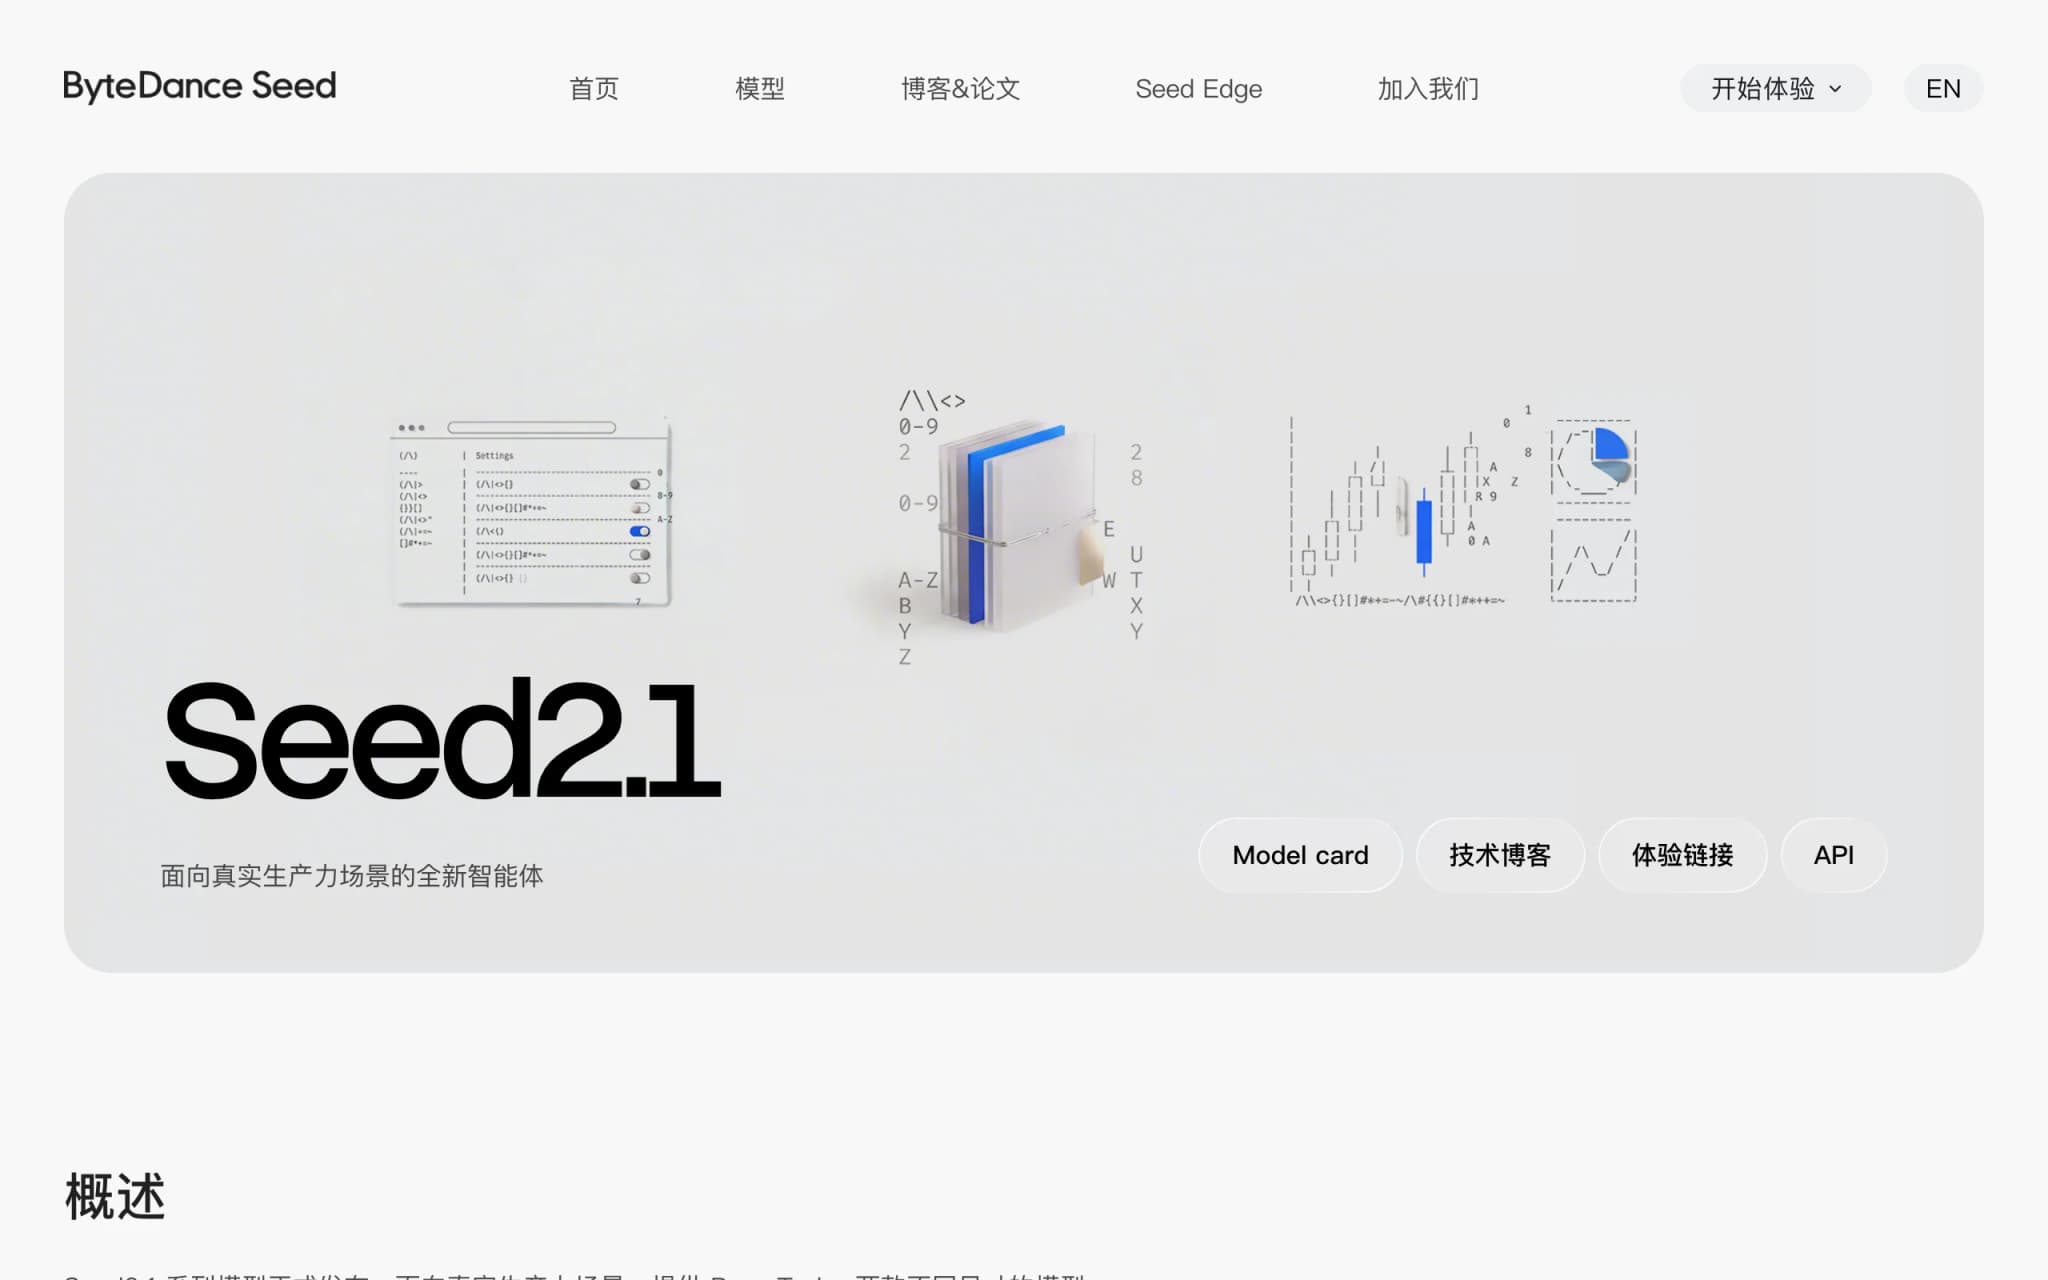
豆包2.1 – 字节跳动推出的全智能体模型系列
豆包2.1(Seed 2.1)是字节跳动 Seed 团队推出的面向真实生产力场景的全智能体模型系列,包含 Pro 与 Turbo 两个版本。该系列以解决日常生活、专业工作和前沿探索中的复杂需求为目标,在通用 Agent 能力、代码工程端到端交付和多模态理解三大维度实现显著提升,强调在实际工作流中的稳定交付。模型支持 128K 长上下文、小时级视频分析、跨端 GUI 操作,并通过深度思考架构与缓存复...
Seedance 2.5 – 字节跳动推出的最视频生成模型
Seedance 2.5 是字节跳动旗下豆包视频生成模型系列的最新旗舰版本,于2026年6月23日在火山引擎FORCE原动力大会上正式发布。作为Seedance 2.0的重大升级,该模型实现了三大全球突破:单段原生视频直出长达30秒、支持50个全模态参考素材联合输入、以及更可控的局部视频编辑能力。这些突破使Seedance 2.5从UGC玩具级工具迈向了专业影视与商业广告级应用,重新定义了AI视频...
Unlimited-OCR – 百度开源的端到端长文档 OCR 模型
Unlimited-OCR是百度推出的端到端长文档OCR模型,通过创新的Reference Sliding Window Attention(R-SWA)机制将解码器KV cache从线性增长压缩为常数,实现单次前向转录数十页文档而无需逐页循环。模型基于3B总参、500M激活的MoE架构,在OmniDocBench v1.6上以93.92%总分取得端到端SOTA,推理速度达5580 TPS,代码与...