AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:AI评测
共 72 篇文章 · 清除标签
Naive-N0.5-Flash:NaiveAI 开源的 309B MoE 大模型,专为 AI 研发而生
Naive-N0.5-Flash 是 NaiveAI 开源的首个 MoE 大模型,定位编程与 AI 研发场景。该模型基于小米 MiMo-V2.5 基模改造,采用 309B MoE 架构,引入 SWA+DSA 混合稀疏注意力机制,原生支持 1M 上下文且全网络不含任何全注意力层。模型由 AI 深度参与研发,配套推理系统 NaiveRT 单流解码峰值达 2,122 tokens/s,在 PaperBe...
APUS-OpenJev-v1:APUS AI Lab 开源的端侧决策大模型深度评测
APUS-OpenJev-v1 是 APUS AI Lab 开源的端侧 System 1 决策大模型系列,与 TypeSafe AI 的闭源 Jev 模型定位同类,提供 4B、9B 和 35B-A3B 三种权重规格,可在浏览器自动化、表单填写、流程路由等任务中快速选择下一步操作。模型首创 `effort="low/high"` 动态计算深度机制:low 模式仅运行 16 层并结合候选感知投影,速度...

Nano Banana 2.1:Google DeepMind 图像生成与对话式编辑模型深度评测
Nano Banana 2.1(模型 ID:gemini-nano-banana-2.1)是 Google DeepMind 于 2026 年 10 月 6 日正式发布的第二代图像生成与对话式编辑模型,隶属于 Gemini 3 系列,底层架构基于 Gemini 3.6 Flash。该模型深度融合了原生多模态推理、1M token 长上下文与知识 grounding 能力,支持 1K/2K/4K 分...
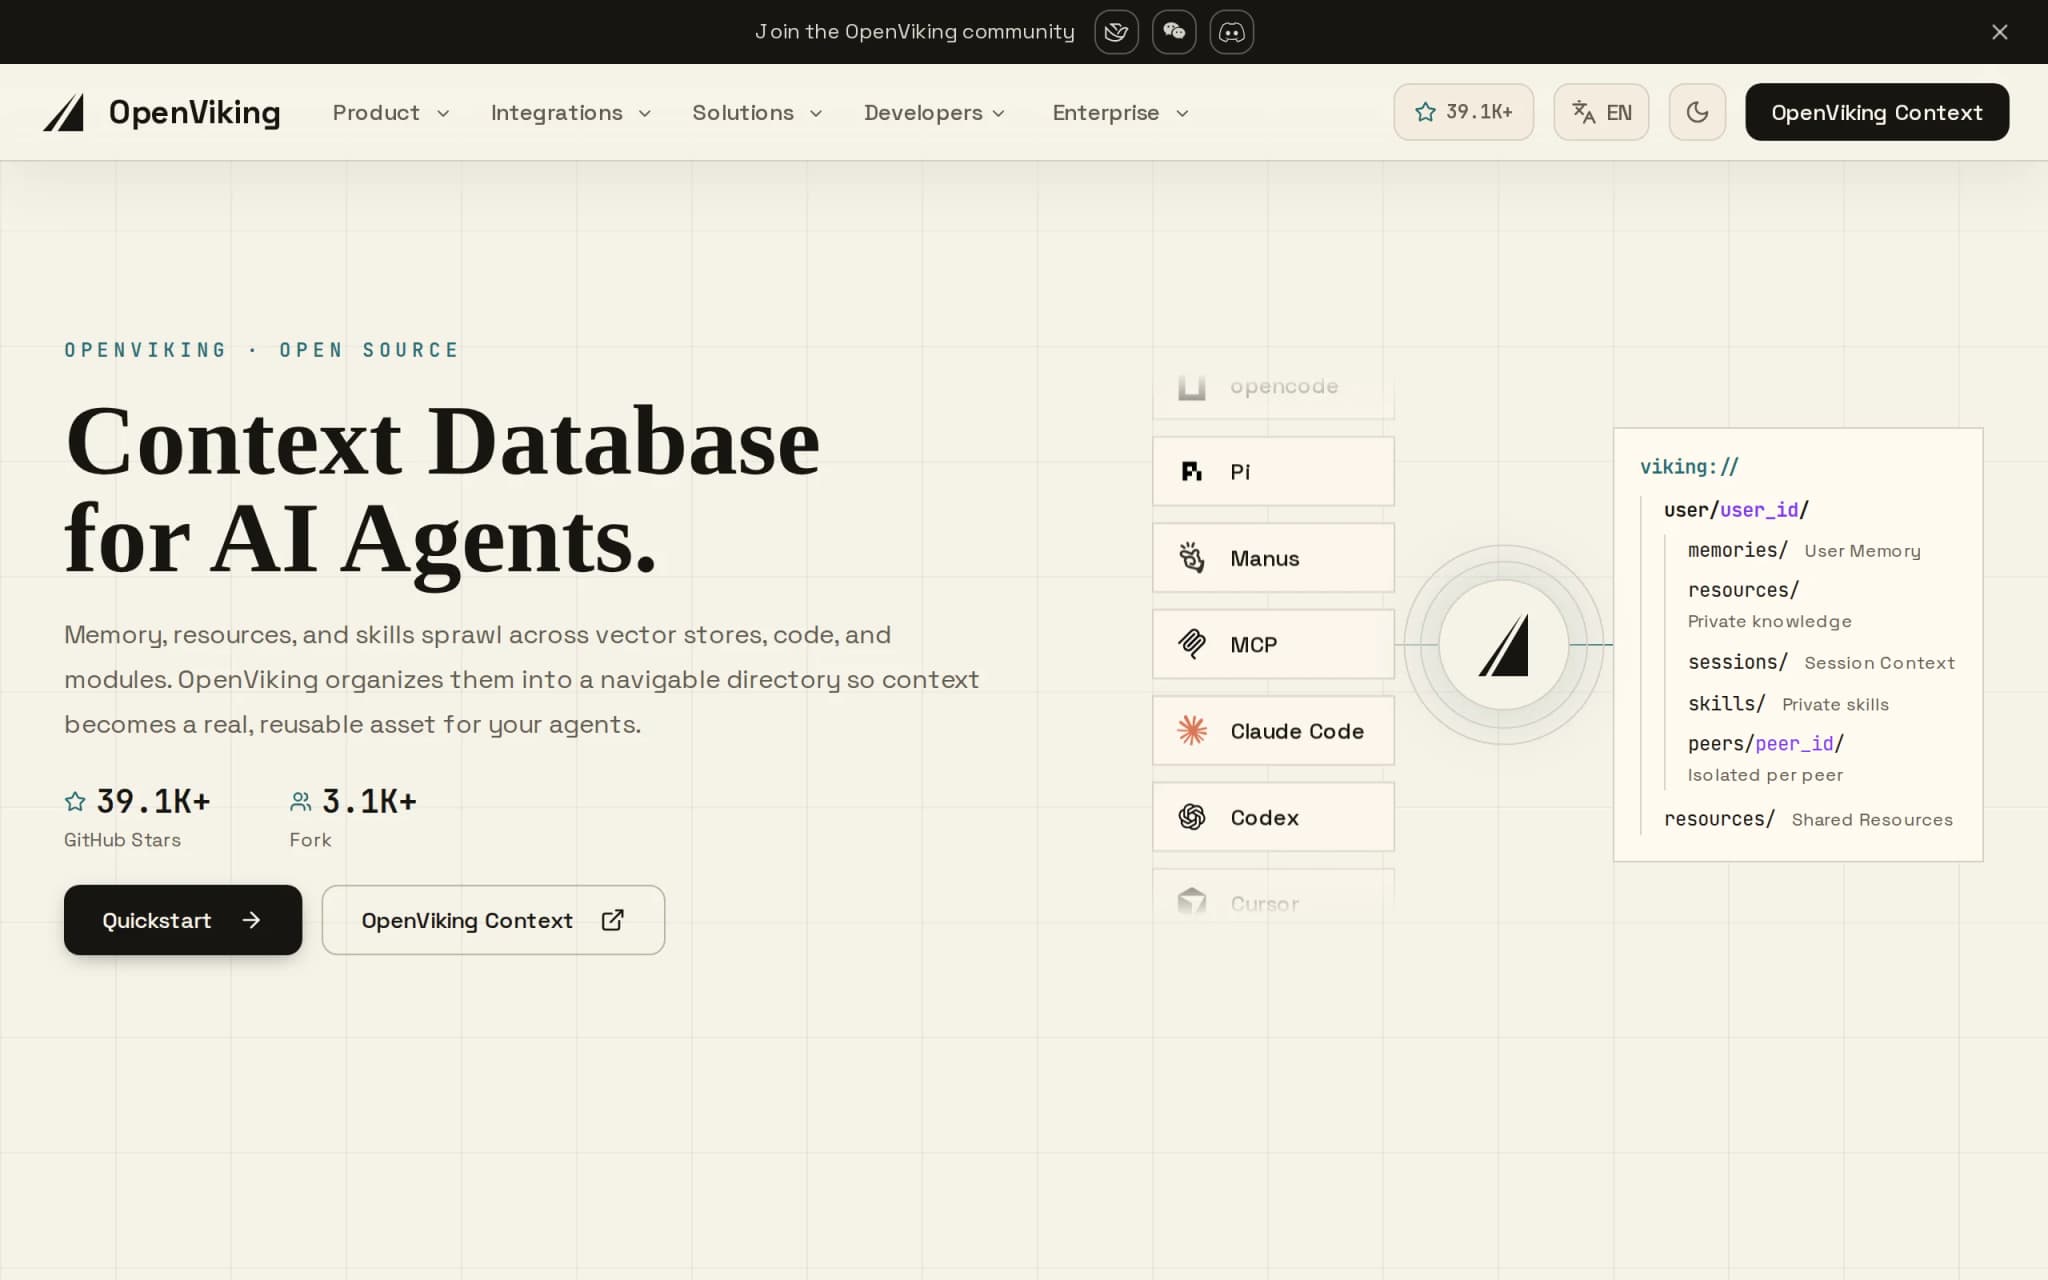
OpenViking – 字节开源的 AI Agent 上下文数据库
OpenViking是由字节跳动火山引擎开源的一款AI Agent上下文数据库,其核心思路是将Agent的记忆、知识RAG和技能统一组织在自定义的`viking://`虚拟文件系统中。Agent可以通过`ls`、`tree`、`find`、`grep`等命令像操作文件一样浏览和检索上下文,告别传统“text in, embeddings out”的黑盒模式。借助L0摘要、L1概览、L2详情三层渐进...
讯飞Spark-ASR-2.0深度评测:非自回归架构下的语音识别新范式
Spark-ASR-2.0是科大讯飞基于星火语音基座大模型Spark-Audio推出的最新一代语音识别大模型。该模型延续了Spark-ASR-1.0的非自回归并行解码范式,并创新性地引入LLM增强的自回归识别机制,通过"非自回归+LLM增强自回归"协同架构,在中英文混合、方言、专业术语、高噪声小音量等复杂场景下实现了识别效果的显著提升,同时推理成本相较上一代仅增加10%。模型已率先在讯飞输入法中上...
HappyOyster 1.0 — 阿里推出的实时生成式开放世界模型深度评测
HappyOyster 1.0是阿里巴巴ATH创新事业部推出的实时生成式开放世界模型系列,定位为世界模拟器范式下的新一代交互式生成模型。该系列包含Adventure与Directing两款模型,前者可基于文本或图像输入实时生成可自由探索的开放世界,支持实时移动、镜头控制与持续交互;后者可通过文本指令实时驱动角色、剧情与镜头演绎。模型已上架阿里云百炼平台,开发者无需邀测即可通过API直接调用,单次世...
YuE2:港科大与 M-A-P 联合开源的符号规划式音乐生成模型深度评测
YuE2是由香港科技大学与多模态艺术计划团队联合研发的开源音乐生成模型,其核心设计理念是在文本/音频条件与最终波形之间引入一层显式的符号乐谱规划,以ABC记谱法呈现旋律与和弦。该模型采用约36亿参数的混合Transformer架构,能够依据歌词和风格提示先生成可编辑的乐谱,再将其渲染为48kHz完整歌曲,将音乐创作从不可控的黑盒生成转变为白盒可控的作曲过程。在WildSongBench基准测试中,...
EchoWM – 京东开源的交互式视听世界模型
EchoWM是京东探索研究院开源的交互式视听世界模型,延续JoyAI-Echo的原生音视频生成能力,让用户以第一/第三人称视角在AI生成的世界中实时移动探索,画面、空间关系与环境音、语音持续同步且长时间不跑偏。模型采用统一相机意图接口与世界数据引擎训练,WBench导航评测平均分81.7位列第一。
PixRestore – 香港理工联合OPPO推出的统一图像修复模型深度评测
PixRestore 是由香港理工大学与 OPPO 研究院联合推出的统一图像修复模型,其核心创新在于直接在像素空间执行 Flow Matching,彻底摒弃了传统方案中 VAE 编码器带来的高频细节损失问题。该模型采用 DINO 驱动的自适应层特征路由机制,仅凭 53.7M 参数的轻量级架构即可高效处理超分辨率、去噪、去模糊、去雨、去雾、去雪、雨滴去除与低光照增强等 8 种退化任务,单步推理仅需 ...
MAI-Image-2.6-Flash:微软面向生产场景的高速图像生成模型深度评测
MAI-Image-2.6-Flash 是微软推出的高速图像生成模型,与旗舰版 MAI-Image-2.6 形成互补定位,专攻低延迟、高吞吐的生产级应用场景。该模型基于 Flow Matching 扩散架构,拥有 200 亿非嵌入参数和 32K Token 上下文窗口,生成速度比 GPT-Image-2-Medium 快约 2.8 倍,GPU 效率提升 72%,同时保持接近旗舰版的视觉质量。模型支...