AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:AI评测
共 72 篇文章 · 清除标签
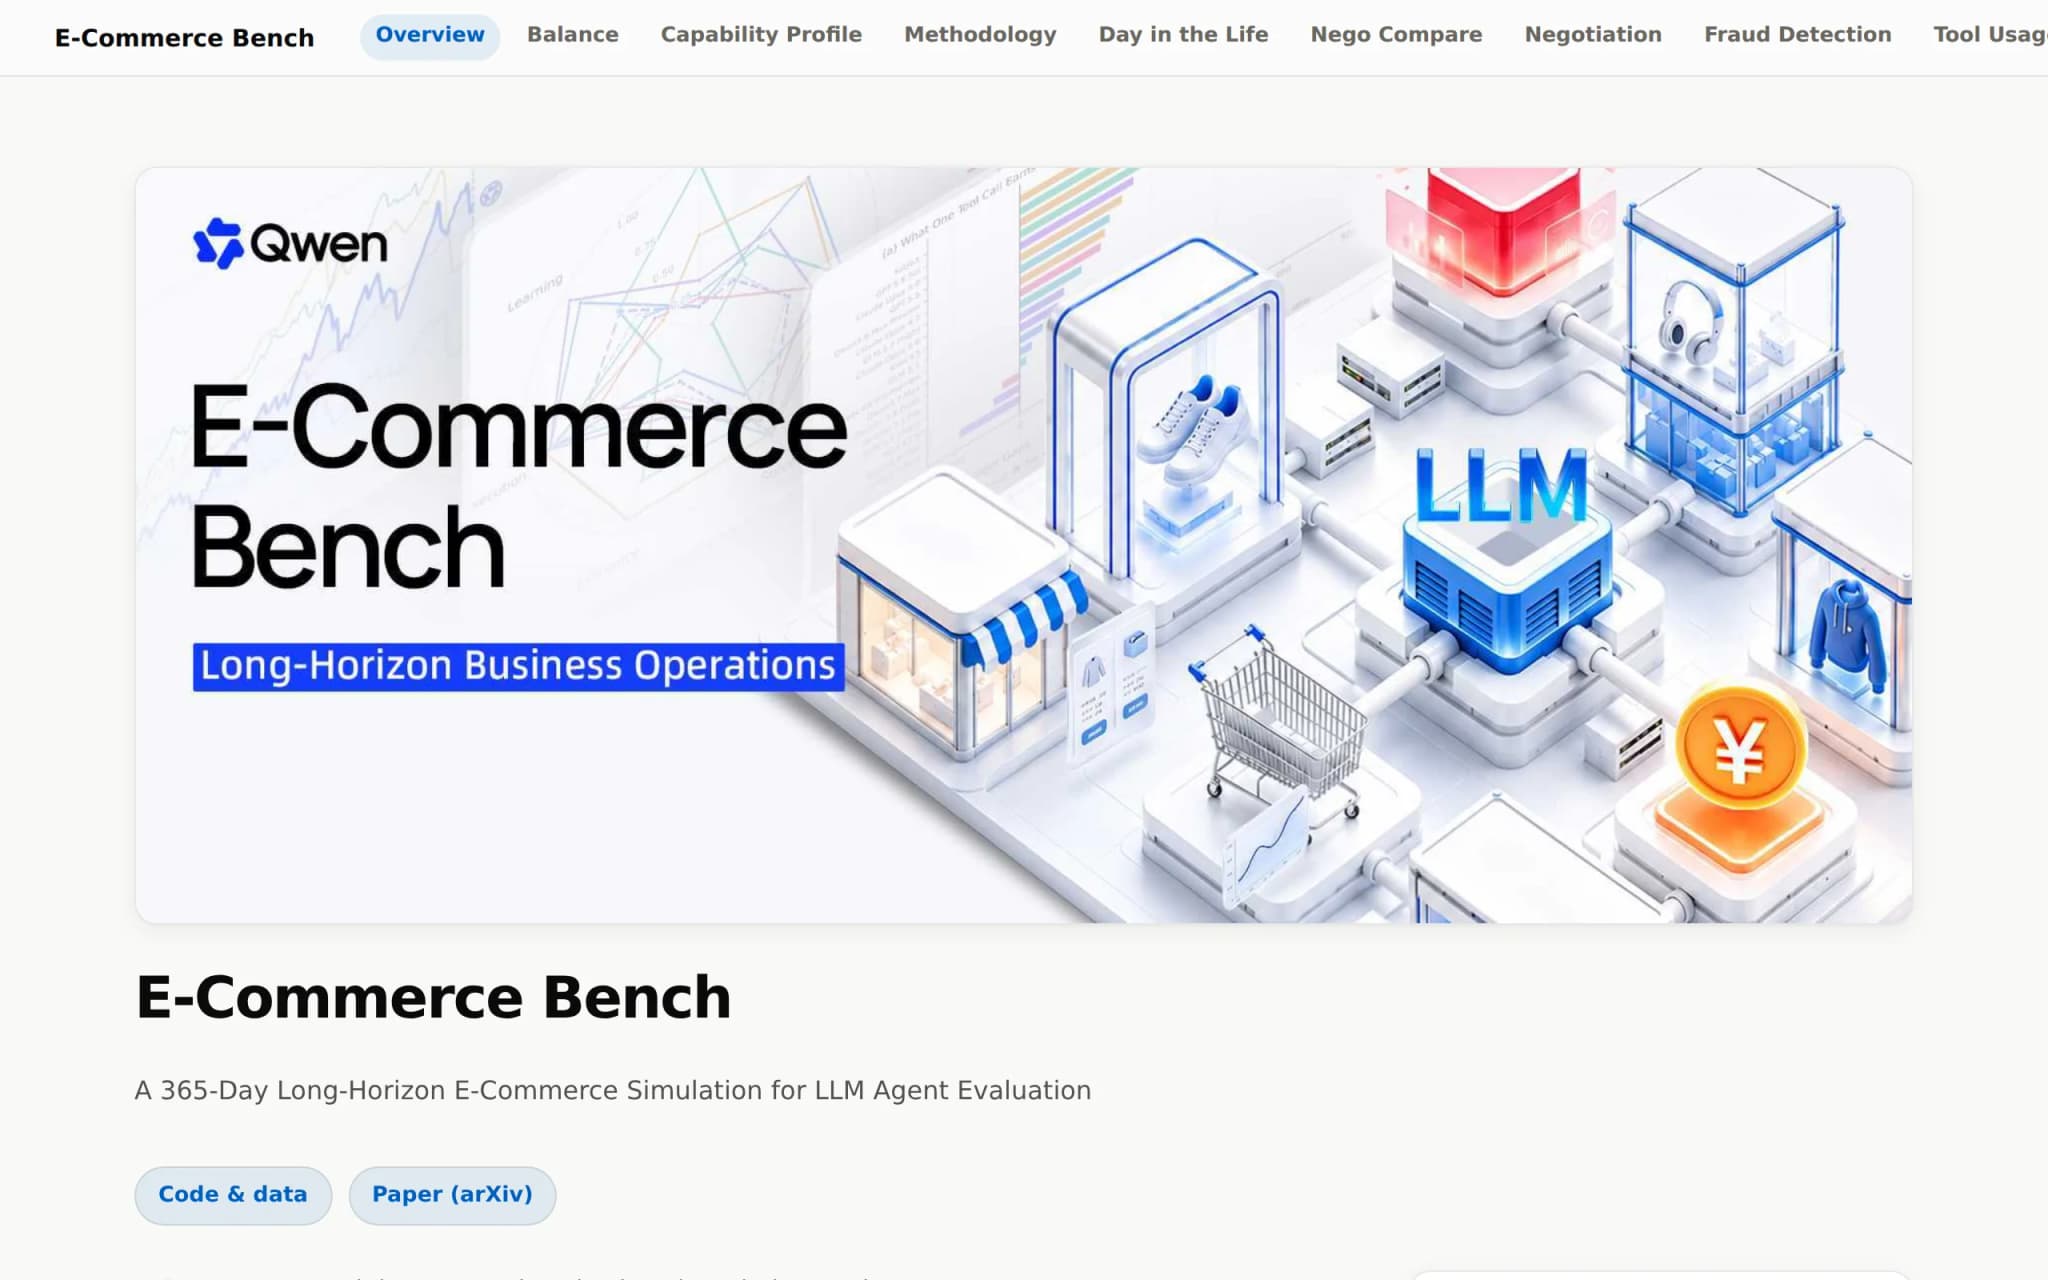
E-Commerce Bench:千问联合淘天开源的长程电商经营评测基准
E-Commerce Bench 是阿里通义千问联合淘天集团开源的长程电商经营评测基准。该基准让 LLM Agent 以 10 万元本金在模拟真实市场中持续经营网店 365 天,涵盖选品、供应商谈判、定价、库存与现金流管理全链路。环境基于真实平台脱敏数据构建,包含 576 家供应商(含 152 家欺诈方)、8 场促销活动及 10 个市场突发事件,通过确定性内核确保实验可复现性,从盈利、谈判、反欺诈...
MiniMax H3 Max:MiniMax 与 fal.ai 联合发布的实时视频生成模型
MiniMax H3 Max 是 MiniMax 与 fal.ai 联合发布的实时视频生成模型,核心卖点是速度:5 秒 768p 视频不到 3 秒出片,同时生成音频。直播团队和批量内容生产团队可以把它放进工作流;但 768p 上限和 15 秒时长意味着影视级制作不在射程内。
Hy-MT2-1.8B评测:腾讯混元端侧翻译大模型的极致量化实践
Hy-MT2-1.8B是腾讯混元推出的端侧翻译大模型,以仅1.8B的参数量支持33个语种的双向互译,翻译质量在FLORES-200等基准上超越微软、豆包等商业API。模型通过2-bit(574MB)与1.25-bit(440MB)两档极致量化方案,可在手机、PC端本地流畅运行,并已落地哔哩哔哩直播弹幕实时翻译场景,实现了低成本、高隐私的端侧高质量翻译能力。

Gemini 3.5 Transcribe 深度评测:谷歌新一代语音转文本模型的技术解析与应用展望
Gemini 3.5 Transcribe 是 Google 推出的最新语音转文本(Speech-to-Text)模型,基于 Gemini 3.5 统一多模态架构构建,支持实时流式转录与预录音频处理两种核心模式。前者通过 Live API 实现亚秒级延迟的双向连续语音交互,后者通过 Interactions API 提供带说话人归属与词级时间戳的高精度离线转写。模型支持 85 种以上语言的自动识别...
Breeze TTS 2 – BreezeBlue推出的一代语音合成模型深度评测
Breeze TTS 2是BreezeBlue推出的新一代语音合成模型,支持通过自然语言零样本设计角色音色,并以自然语言指令精准控制情绪、语速、口音等表演细节。模型侧首字节延迟低至40ms,在Voice Design、Voice Direction和Latency三项权威评测中均位列全球第一,支持50余种语言,面向虚拟主播、游戏NPC、有声内容与AI Agent等实时交互场景提供端到端的语音生成能...
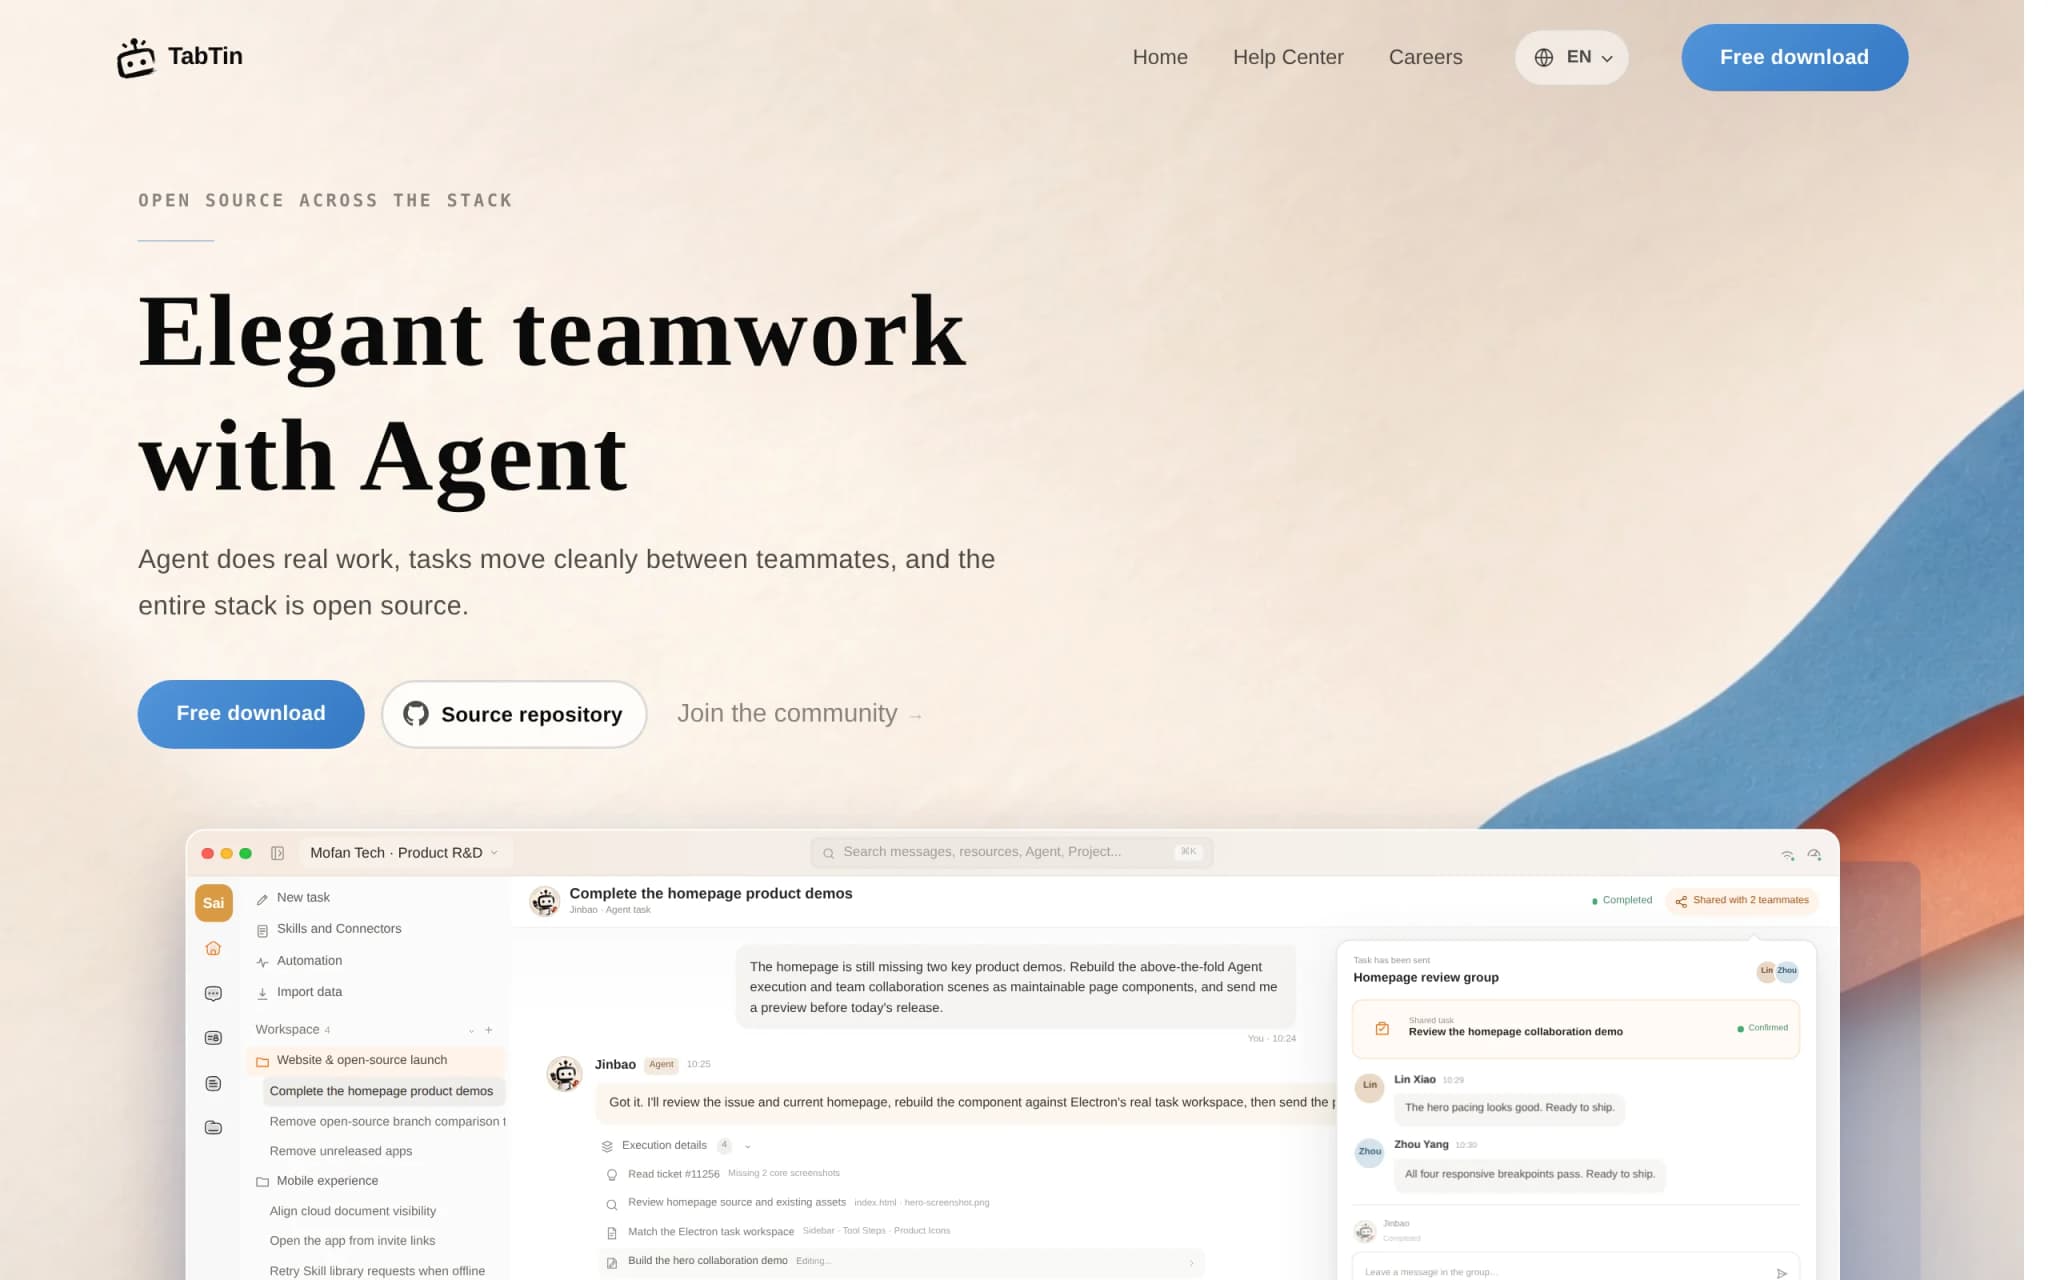
TabTin – 开源的全栈 AI Agent 团队协作平台深度评测
TabTin是一个全栈开源的AI Agent团队协作平台,旨在让智能体真正融入团队工作流。任务可在桌面端发起、手机端查看、服务器端由Agent执行,并能携带完整上下文交接给同事。平台支持人与Agent在同一文档中实时协作,交付结果须经人工验收,解决了Agent写代码快但团队重复理解上下文的痛点。
CoinVE-200K – 腾讯开源的大规模组合指令视频编辑数据集
CoinVE-200K是由腾讯视频智创团队开源的大规模组合指令视频编辑数据集,包含20万组1080p高清视频编辑样本对,每组样本携带2-5条原子编辑指令,覆盖添加、移除、修改、风格化等操作类型,视频最长可达201帧。项目同步开源了22B参数的CoinVE-Edit编辑模型与CoinVE-Bench评测基准,构建了从数据、模型到评测标准的完整闭环,填补了组合指令视频编辑领域在数据、模型与评测标准上的...
LLM-as-a-Verifier深度评测:斯坦福联合英伟达开源的通用验证框架
LLM-as-a-Verifier是斯坦福大学、UC伯克利与NVIDIA研究院联合开源的通用验证框架。该框架无需额外训练或标注数据,通过利用LLM评分Token的完整logits分布计算连续细粒度分数,替代传统离散评分机制。框架支持在评分粒度、重复评估、准则分解三个维度上扩展验证能力,可同时输出测试时候选筛选、Agent进度跟踪与强化学习密集奖励三类信号,在Terminal-Bench、SWE-B...
Lumos NexCore – 鹿明机器人推出的具身智能进化引擎
Lumos NexCore 是鹿明机器人(Lumos Robotics)推出的具身智能进化引擎,定位为面向产业落地的技能基础设施。该平台将数据资产、模型训练、评测验证、技能管理和机器人运营整合为统一服务,使机器人技能从手工作坊式开发转变为可训练、复用、持续迭代的资产,实现像云服务一样被调用和验证,推动具身智能从单点 Demo 走向规模化产业应用。
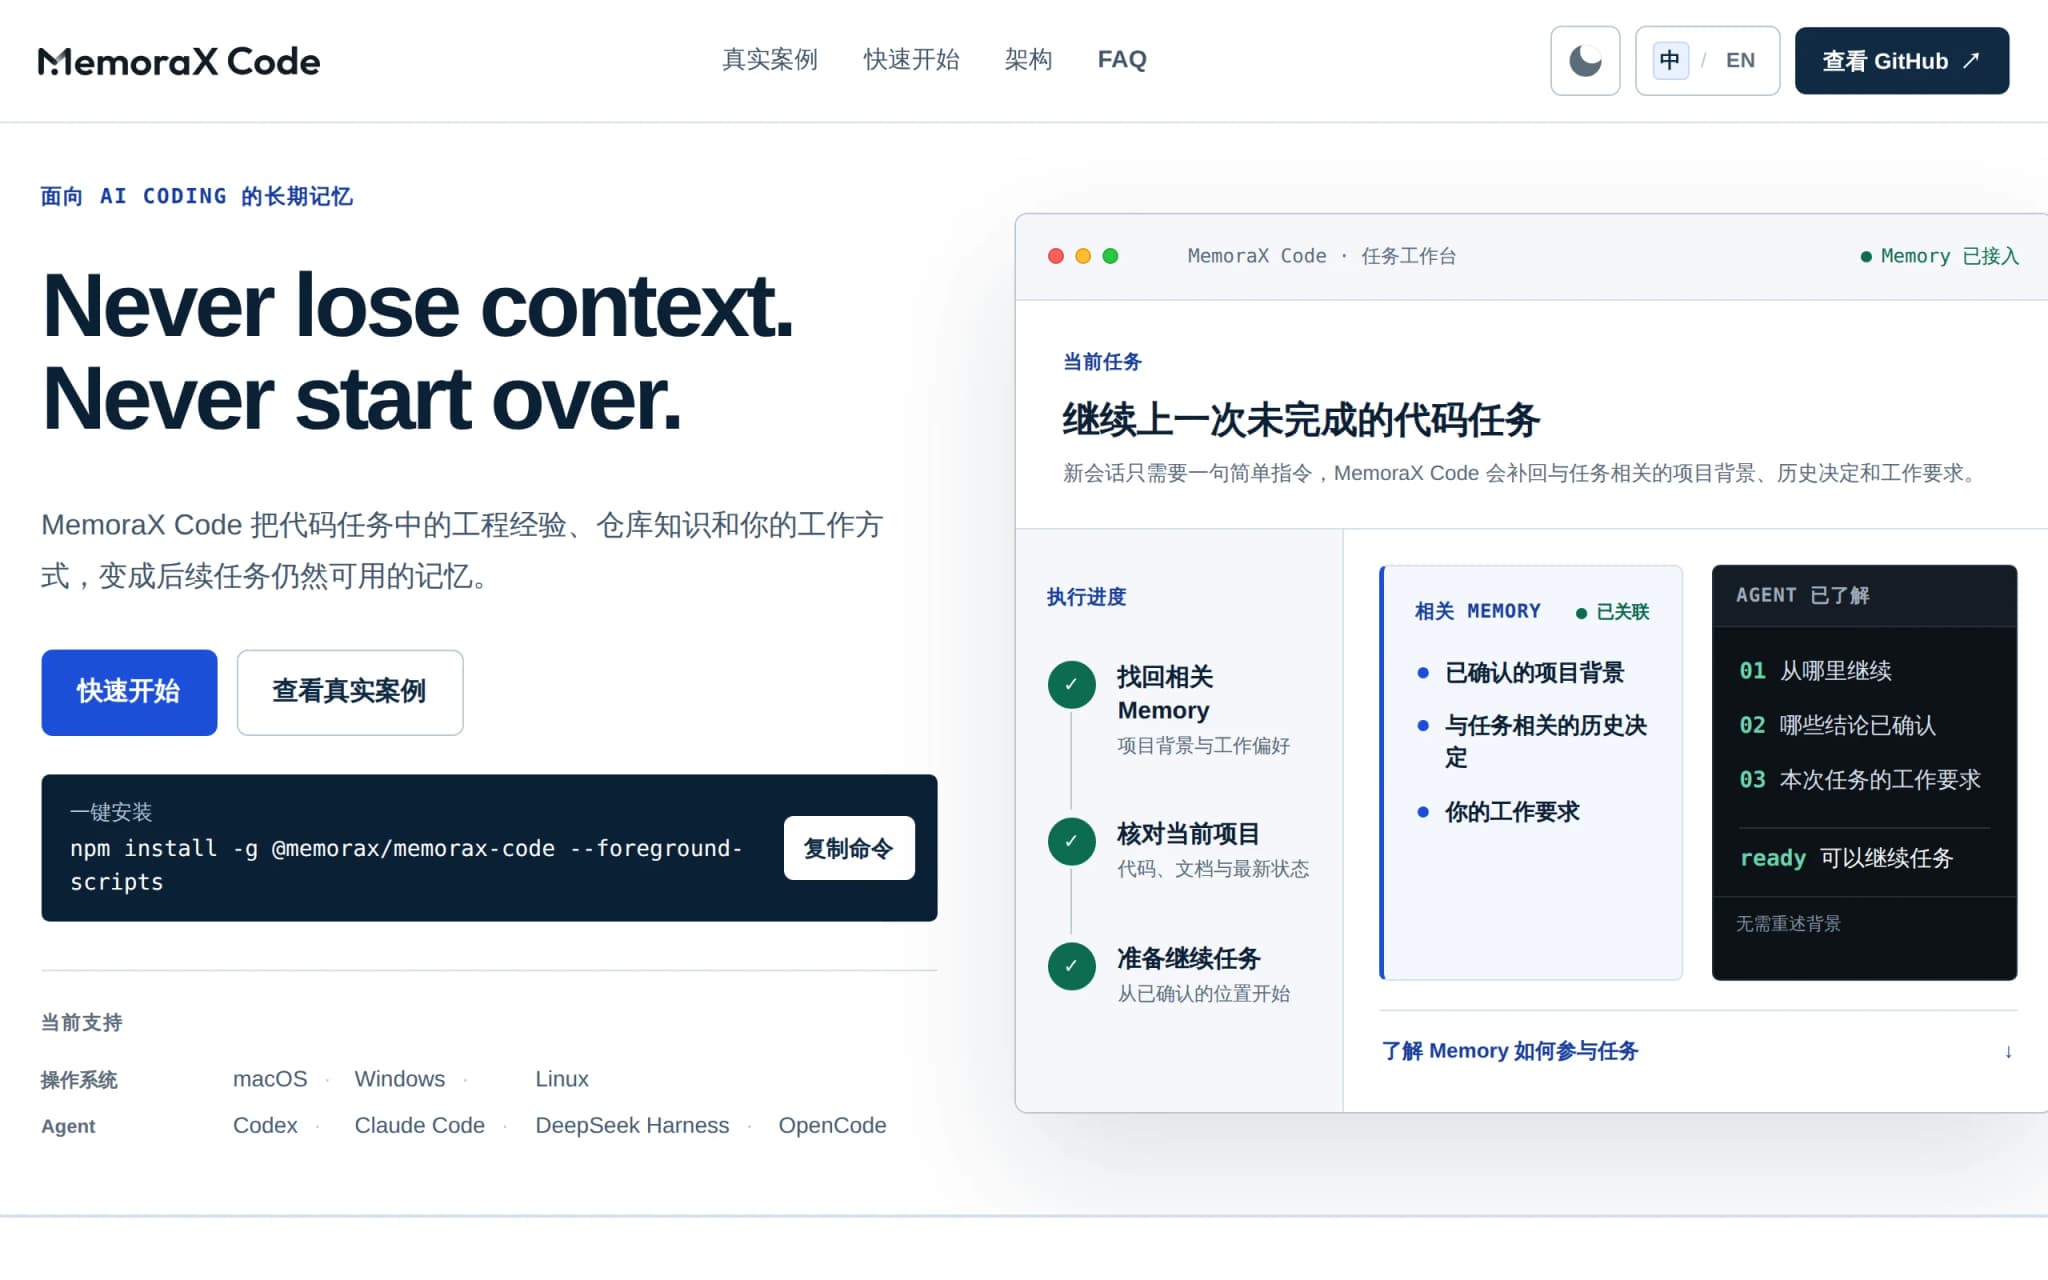
MemoraX Code – 专为 Coding Agent 设计的长期记忆系统
MemoraX Code 是由 MemoraX AI 团队开发的专为 Coding Agent 设计的长期记忆系统,旨在解决代码智能体每次新对话都需要重新理解项目上下文的根本性痛点。该系统通过本地代码仓分析与云端长期记忆相结合的双存储架构,实现跨 Agent、跨对话、跨终端的项目经验持续积累,并能够自动从历史编码轨迹中提炼结构化、可复用的工程经验(Procedure Memory),以 Skill...