AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:具身智能
共 39 篇文章 · 清除标签
StaffDeck – 面壁智能等开源的企业级数字员工平台
StaffDeck是由面壁智能联合东北大学-面壁智能数据智能联合实验室、清华大学THUNLP实验室、OpenBMB与AI9Stars共同开源的企业级数字员工全流程构建与管理平台。该平台突破传统AI助手定位,将Agent视为具备岗位、工号、SOP、知识库与绩效档案的正式员工,通过状态机驱动的流程引擎、结构化知识库与反馈迭代闭环,实现从对话工具到可履职、能沉淀经验的数字劳动力的进化,为企业提供规范化、...
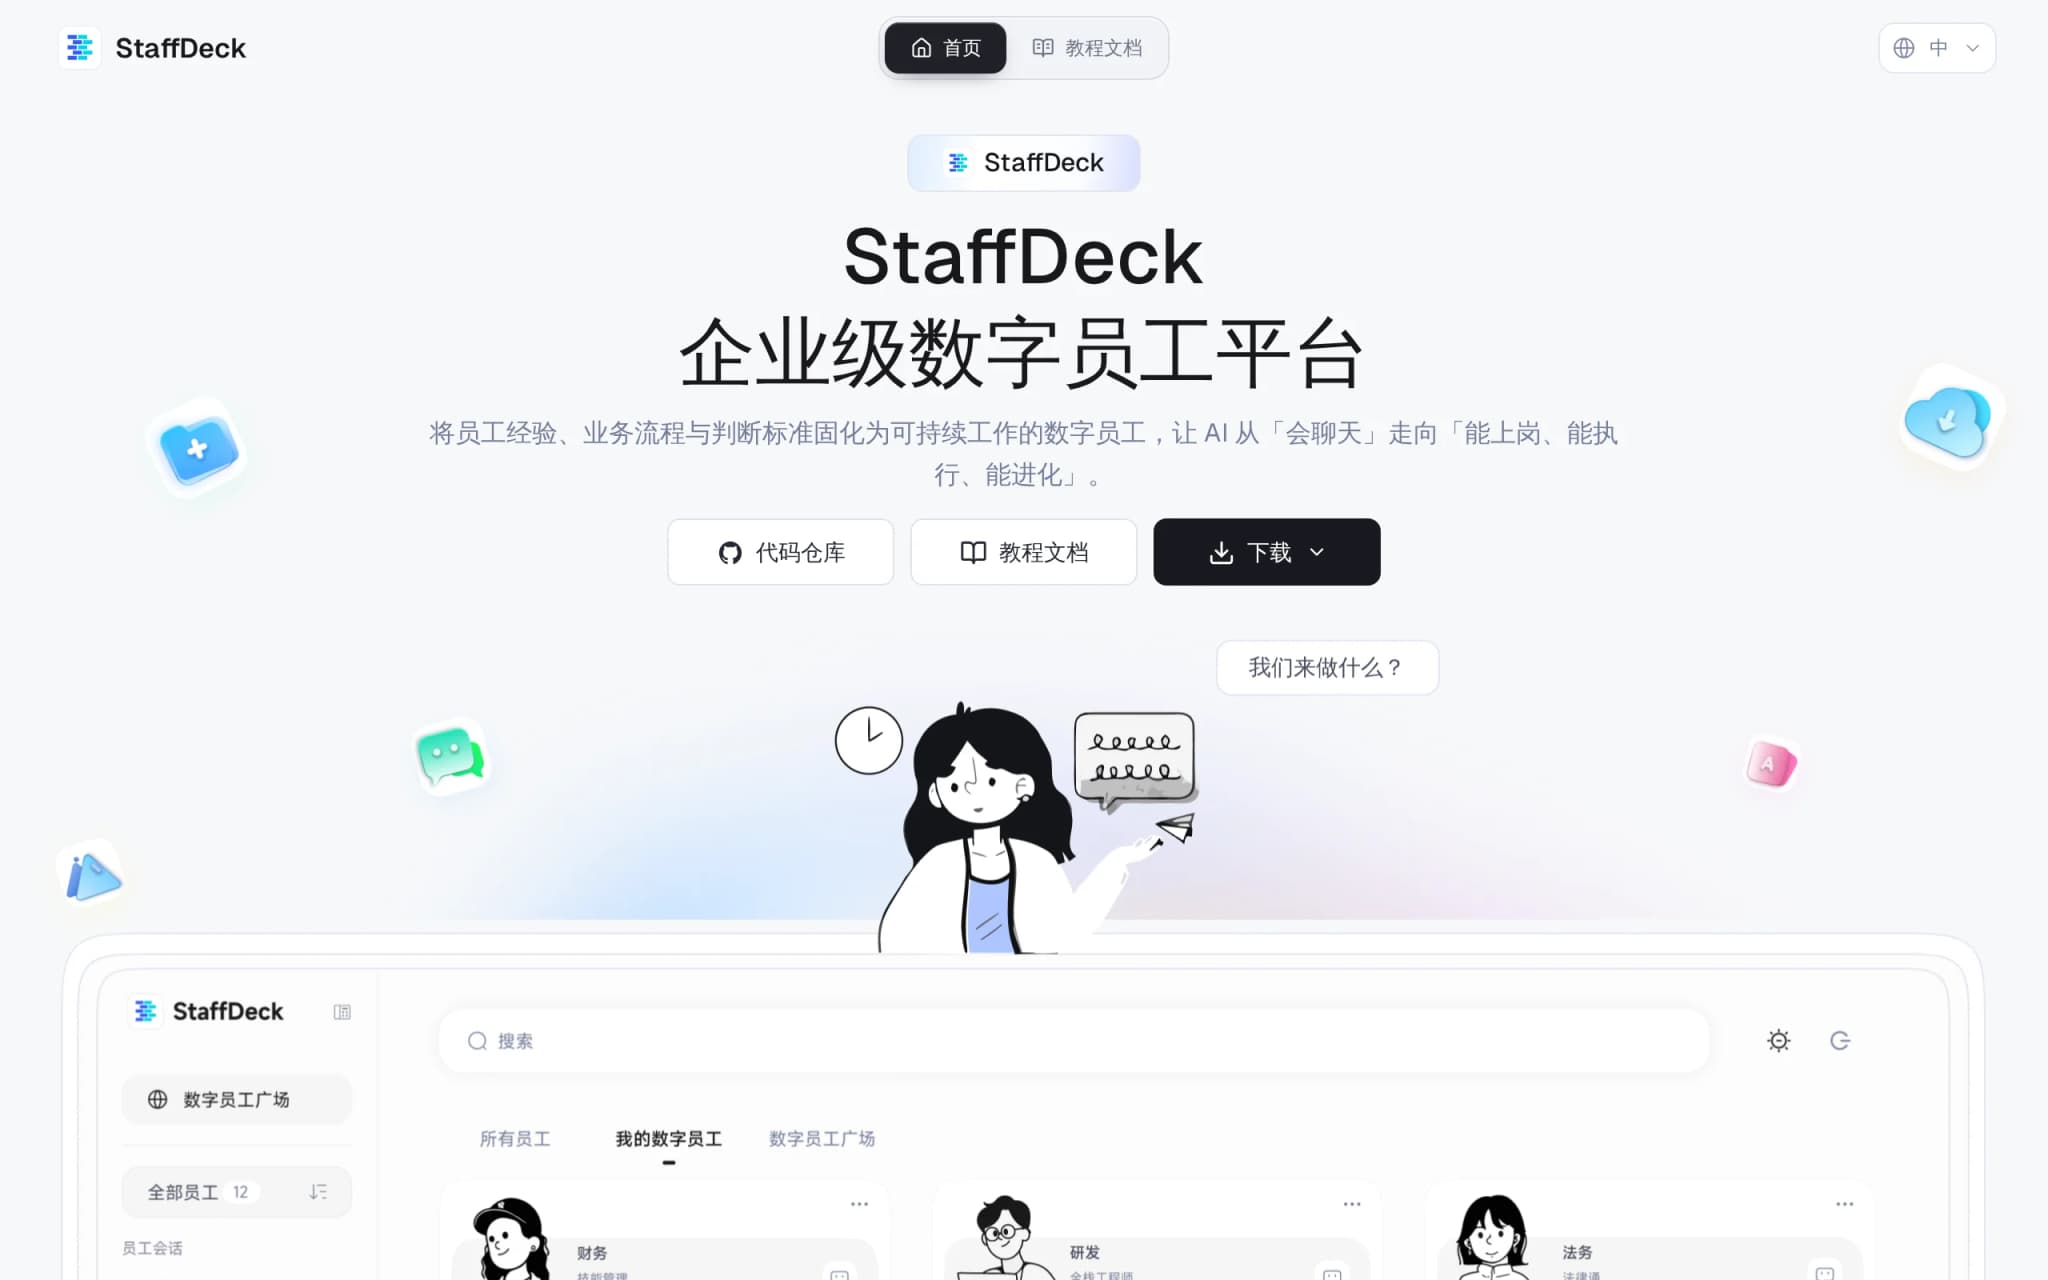
MoWorld – 魔芯科技推出的全球首个高帧率交互式世界模型
MoWorld 是由魔芯科技推出的全球首个高帧率交互式世界模型,基于纯国产华为昇腾 NPU 全栈优化,实现了最高 50 FPS 的实时推理能力,推理成本较传统 GPU 部署降低 70%。该模型采用 14B 参数的混合专家(MoE)架构,支持精确相机轨迹控制与 4D 空间感知,能够生成长时程、空间一致的大尺度场景视频,覆盖城市、室内、驾驶等复杂环境。MoWorld 的推出标志着世界模型从非实时生成迈...
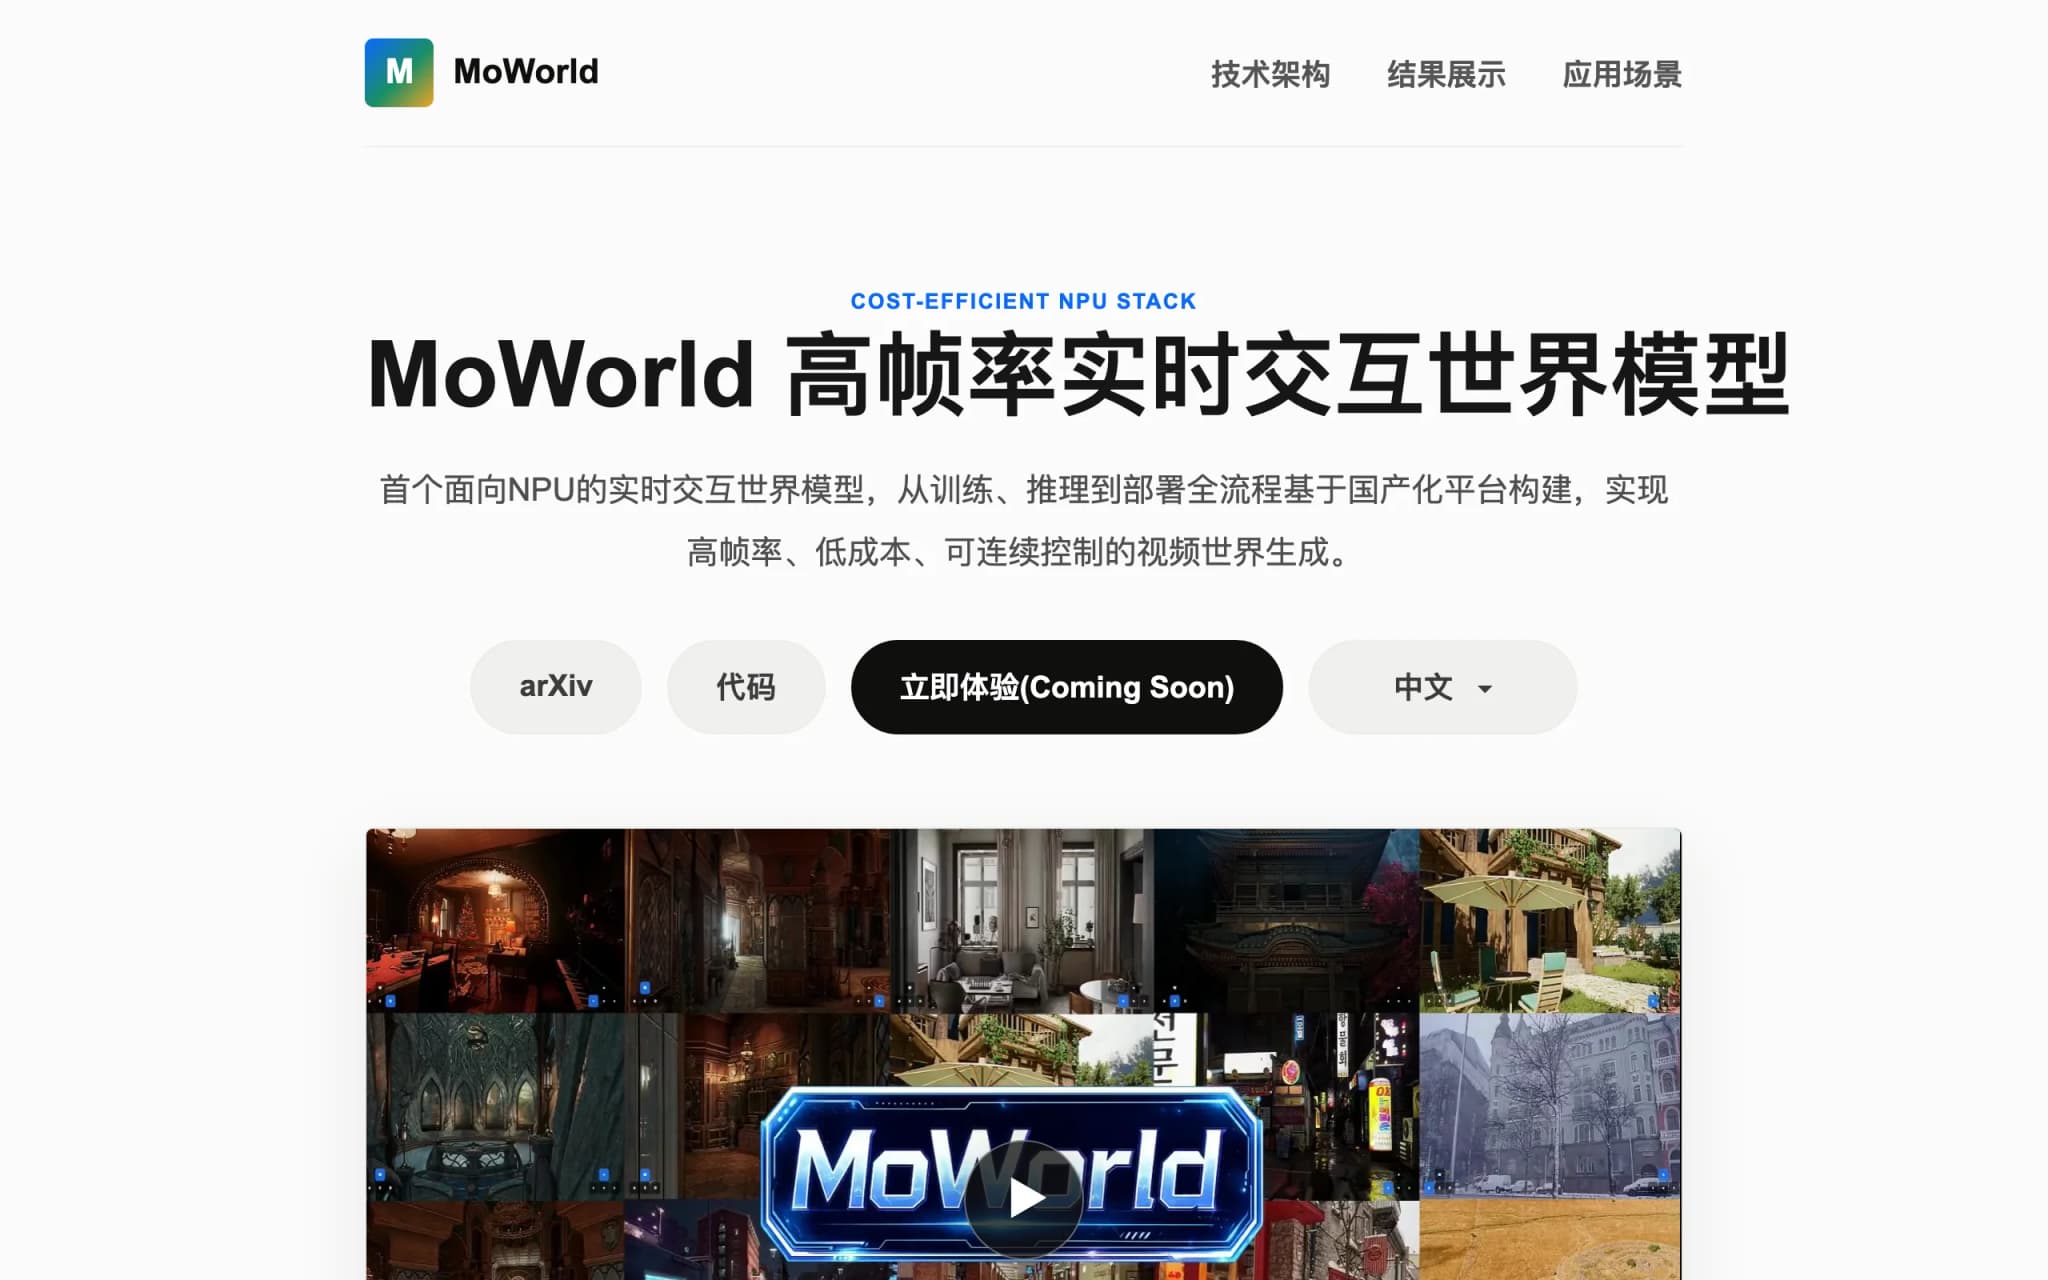
LingBot-Vision – 蚂蚁灵波科技开源的通用视觉基座模型
LingBot-Depth 2.0 – 蚂蚁灵波科技推出的深度补全模型
LingBot-Depth 2.0是蚂蚁灵波科技推出的面向真实场景的深度补全模型,同步开源了视觉基座模型LingBot-Vision。该模型采用“基座模型+任务头”的两级协同架构,通过显式边界结构预训练,实现了对玻璃、镜面等透明/反光物体的高精度三维重建。训练数据从上一代的300万扩充至1.5亿,在16项深度补全基准测评中斩获12项第一,室内大面积深度缺失场景的RMSE误差从0.132降至0.06...
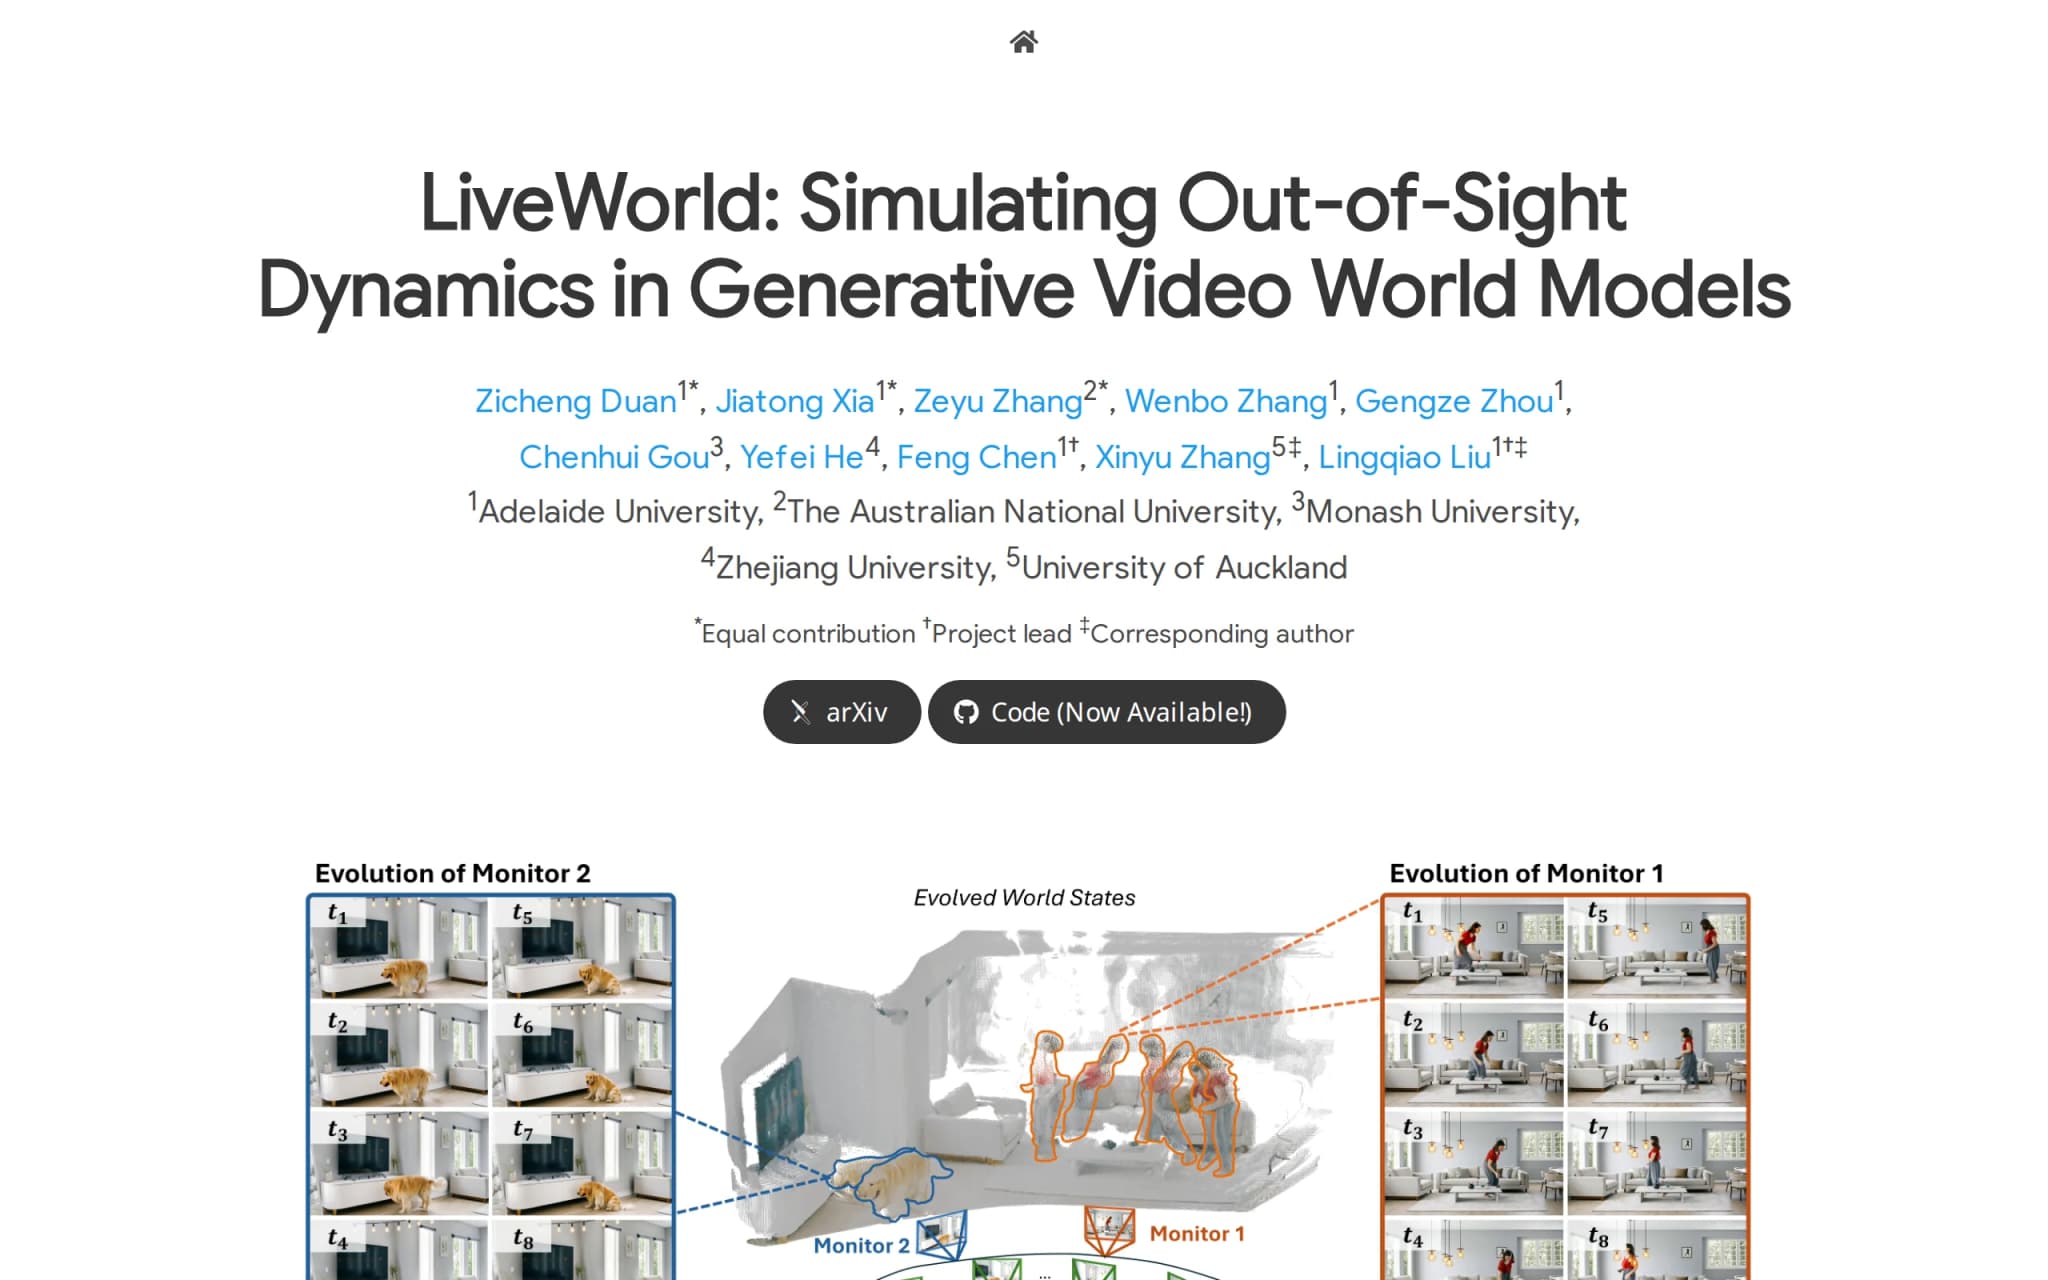
LiveWorld – 阿德莱德大学等推出的生成式视频世界模型
LiveWorld是由阿德莱德大学、澳大利亚国立大学等机构联合推出的生成式视频世界模型,核心解决视野外动态问题——当物体离开相机视野后,传统模型会将其状态冻结,而LiveWorld通过显式解耦世界演化与观察渲染,让动态实体在不可见时仍能持续推进,实现真正的4D世界模拟。该模型将世界状态表示为静态3D背景与动态4D实体的结构化近似,而非直接预测2D帧,从而在长时序、多视角场景下保持几何一致性与事件逻...
LocateAnything – 英伟达推出的视觉语言定位模型
LocateAnything是英伟达(NVIDIA)推出的视觉语言定位模型,基于并行框解码(PBD)技术,用户输入自然语言即可在图像中精准框选目标。该模型以3B参数量实现了多目标检测、GUI元素定位、OCR文本检测和点级指向等多样化任务,在单张H100 GPU上推理速度达到12.7 BPS(边界框每秒),较Qwen3-VL快约10倍,在LVIS、M6Doc、ScreenSpot-Pro、DocLa...
BrowserBC – Einsia AI 旗下开源的浏览器操作轨迹生成 Skill
BrowserBC 是 Einsia AI 旗下 Navers Lab 发布的开源项目,其核心目标是将人类在浏览器中的操作轨迹转化为可复用的自然语言技能(Skill),使 Web Agent 能够“克隆”人类操作经验,更高效地完成同类任务。用户只需在浏览器中执行一次完整的任务流程,系统便能自动将这段操作序列蒸馏成一份结构化的“技能卡”,之后任意模型均可依据该技能卡复现操作,实现“做一次、复用无数次...
ACE-Ego – 大晓机器人联合港中文开源的具身操作 VLA 模型
ACE-Ego是由大晓机器人联合香港中文大学MMLab共同开发的开源一脑多型具身操作VLA模型。该模型以6.0K+小时人类第一视角视频为核心进行预训练,通过相机空间动作与形态条件编码,使同一模型可适配不同机器人本体。在RoboCasa GR1 TableTop基准上以72.8%刷新SOTA,能稳定完成塑料袋打包、鞋盒装鞋等复杂零售操作,大幅降低多本体部署成本。

Qwen-Robot Suite – 阿里通义推出的物理世界基础模型套件
Qwen-Robot Suite 是阿里通义实验室推出的面向物理世界智能的基础模型套件,由 Qwen-RobotNav(导航)、Qwen-RobotManip(操作)与 Qwen-RobotWorld(世界模型)三大核心模型组成。该套件通过语言优先接口将视觉语言表示空间桥接至物理动作空间,实现跨本体、跨场景的统一训练与推理,使通用大模型能作为上层规划器,动态调用底层物理工具完成长程任务闭环。这一架...
SCAIL-2 – 智谱联合清华开源的角色动画模型
SCAIL-2是由智谱AI联合清华大学刘永进教授课题组开源的影视级角色动画框架第二代。基于扩散变换器(DiT)架构,采用端到端训练直接实现高质量动画迁移,无需传统姿态估计中间环节,避免骨架图歧义。支持动画生成与角色替换双模式,通过SAM3掩码增强实现精准匹配。能驱动人体,可处理动物、手绘角色等非人体目标,支持多人物交互,为影视、游戏、虚拟偶像等领域提供高效动画解决方案。