
AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:大语言模型
共 117 篇文章 · 清除标签
Kev – 开源的 Jev 风格决策模型家族,可自训练、自部署
Kev是由Cognition工程副总裁Jared Palmer开源发布的决策模型家族,基于Qwen3.5/Qwen3.8底座构建,提供0.8B至27B多档参数规模。与传统大语言模型不同,Kev不生成自然语言文本,而是接收状态文本与结构化问题,通过单次前向传播直接输出校准后的概率分布,支持是/否判定、选项路由和等级打分三类决策原语,API兼容TypeSafe System One。该项目的核心价值在...
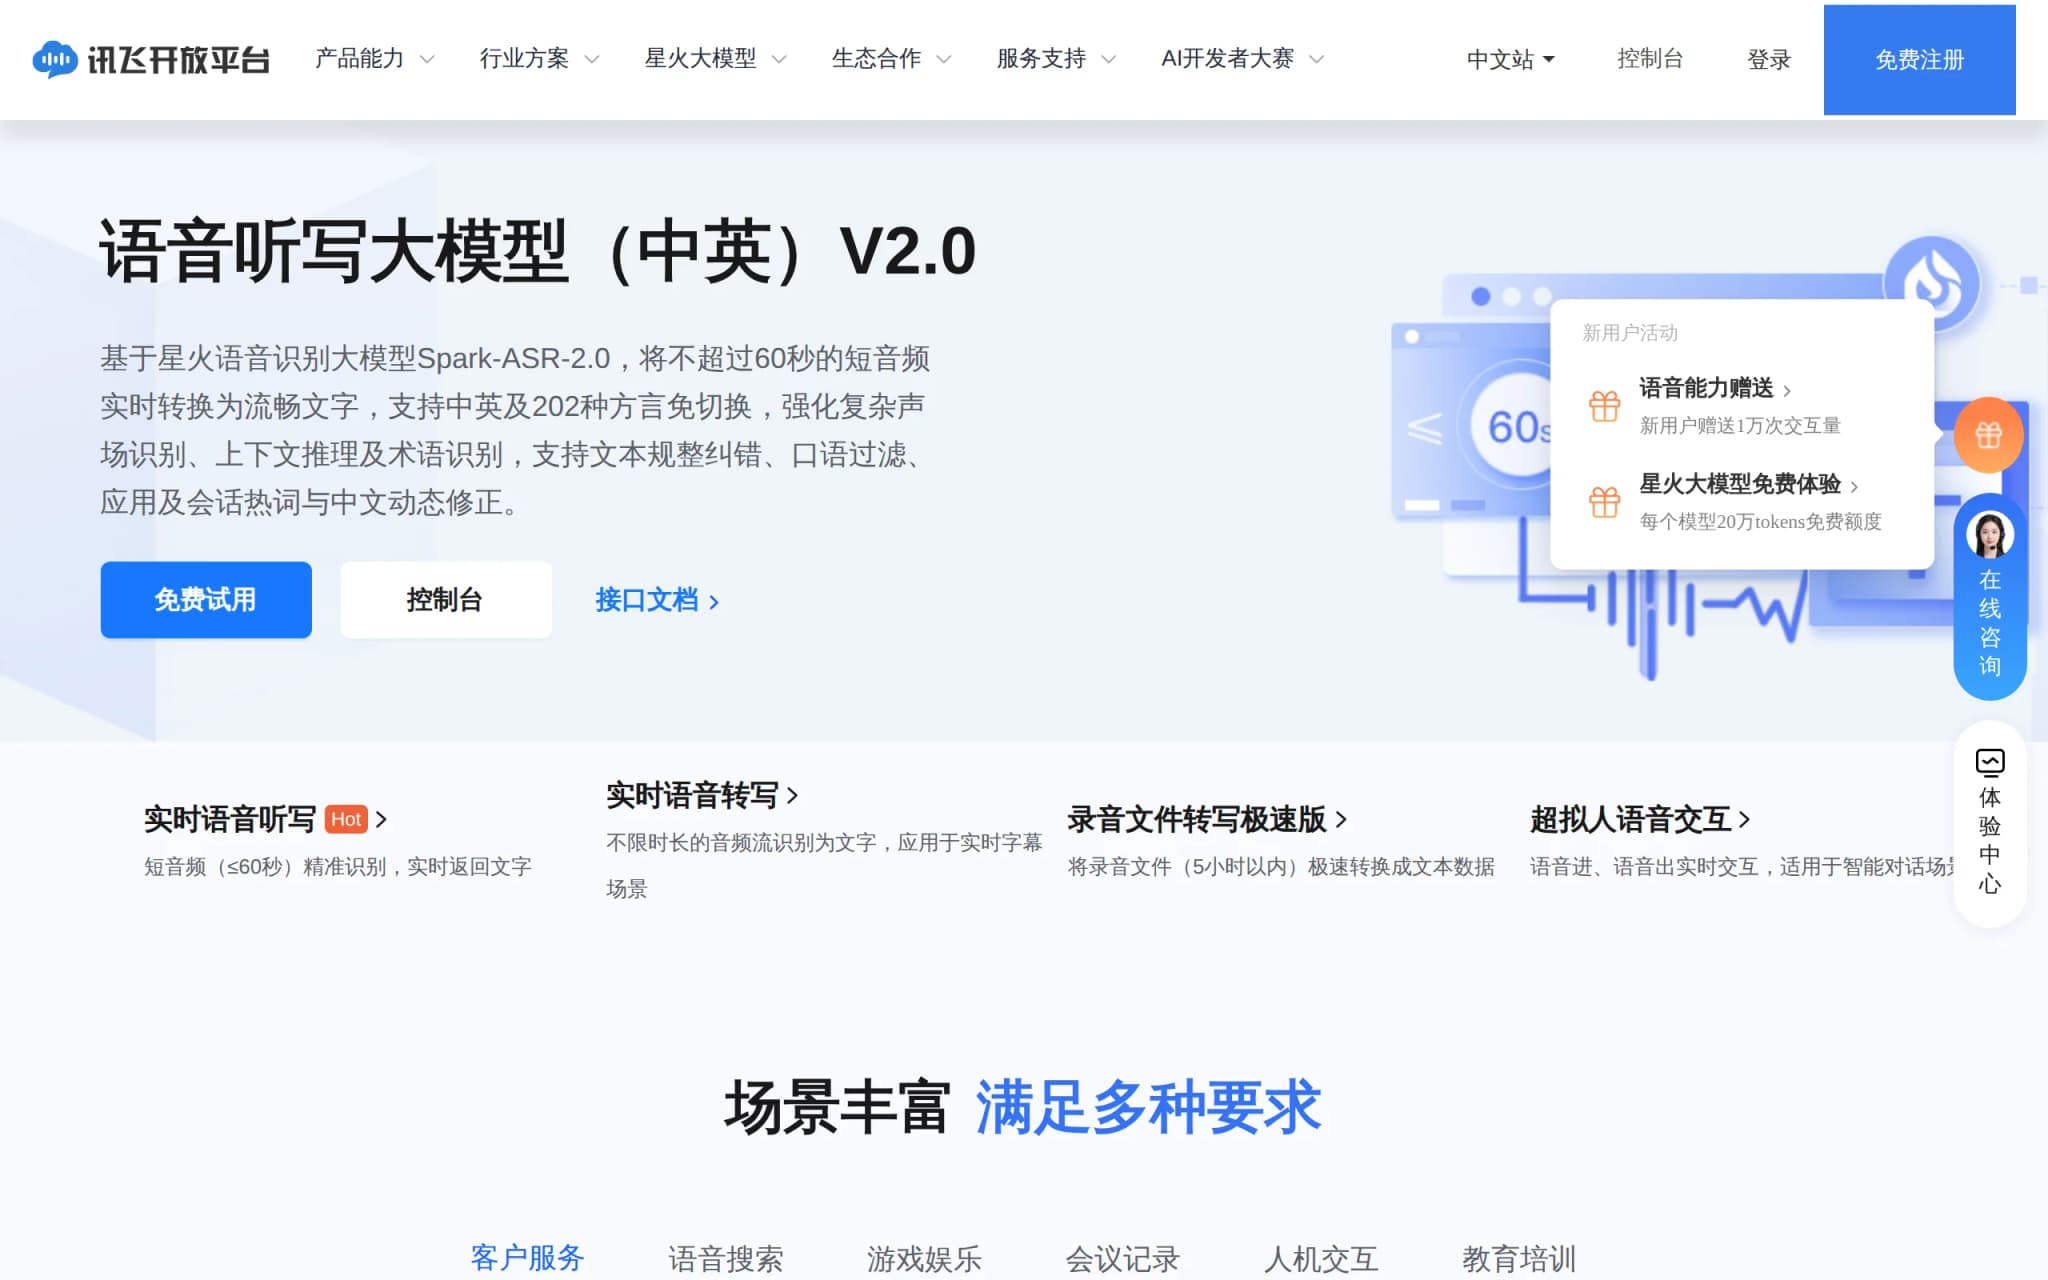
讯飞Spark-ASR-2.0深度评测:非自回归架构下的语音识别新范式
Spark-ASR-2.0是科大讯飞基于星火语音基座大模型Spark-Audio推出的最新一代语音识别大模型。该模型延续了Spark-ASR-1.0的非自回归并行解码范式,并创新性地引入LLM增强的自回归识别机制,通过"非自回归+LLM增强自回归"协同架构,在中英文混合、方言、专业术语、高噪声小音量等复杂场景下实现了识别效果的显著提升,同时推理成本相较上一代仅增加10%。模型已率先在讯飞输入法中上...
Step Code – 阶跃星辰开源的终端编程智能体深度评测
Step Code 是阶跃星辰推出的开源终端编程智能体,采用 MIT License 许可,允许开发者在终端环境中直接完成代码编写、调试、执行与交付的完整工作流。该智能体在 Terminal Bench 2.1 评测中以 80.9% 的通过率并列第一,且 Token 消耗为并列者中最低;在自建 Multi-Frame 长程基准中同样排名第一。Step Code 内置 StepPage 一键发布静态...
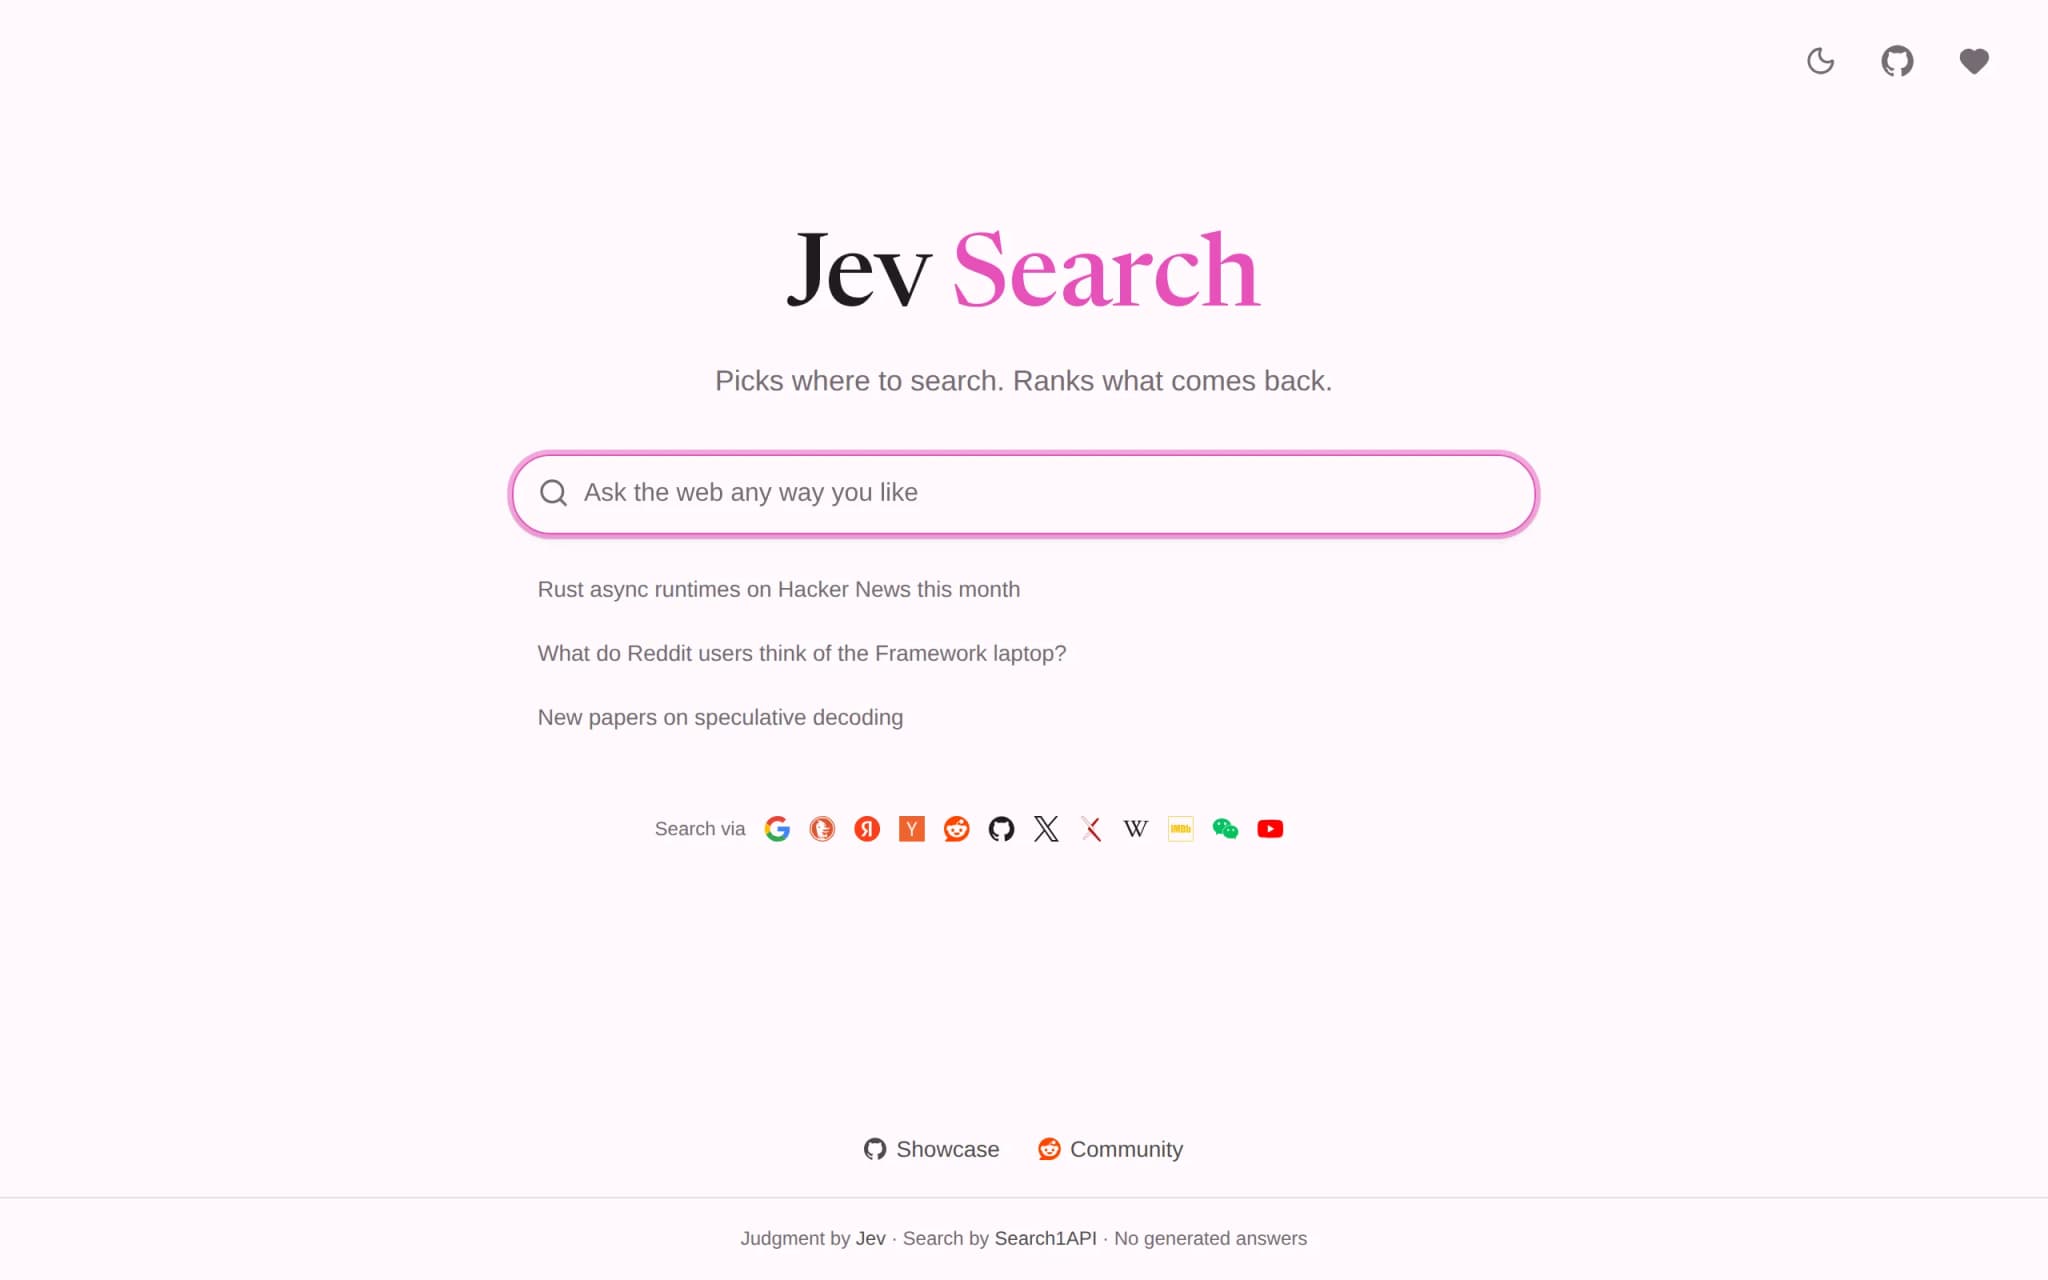
Jev Search:开源 AI 搜索引擎,基于 Jev 模型实现意图解析与多引擎聚合
Jev Search 是由 Search1API 团队开源的一款 AI 搜索引擎前端,其核心在于调用 TypeSafe 团队推出的 Jev 结构化决策模型,实现对用户自然语言提问的意图解析、搜索来源选择、时间范围限定与查询词自动生成。在 Jev 模型完成查询规划后,系统通过 Search1API 同时并行调用 Google、Reddit、Hacker News、arXiv 等 12 个搜索与内容引...
Laya – 开源的非自回归 AI 决策模型,Jev 开源平替
Laya 是一个基于双向编码器架构的开源非自回归 AI 决策模型,由 ConvAI Innovations 团队研发。与主流大语言模型不同,Laya 不进行文本生成,而是基于 ModernBERT/mmBERT 双向编码器,对一段输入状态加一组类型化问题仅执行一次前向传播,约 33ms 即可输出结构化决策结果与校准概率。模型内置语言路由机制,支持 100+ 语言的自动识别与分发。相比闭源模型 Je...
WebCraftBench – 腾讯联合清华推出的AI网页生成评测基准
WebCraftBench 是腾讯混元联合清华大学、北京大学推出的 AI 网页生成评测基准,旨在解决"AI 生成的网页应用质量如何客观评估"这一行业难题。该基准创新性地采用代码插桩与覆盖率引导的智能体探索机制,让 AI 智能体通过 Playwright 实际操作系统生成的网页应用,自动发现功能并测试边界情况,再通过状态抽象将交互记录转化为状态转移图,从美观度、易用性、需求符合度三个维度分别打分。基...
Spark-Audio-1.0-Preview – 科大讯飞推出的全国产语音基座大模型
Spark-Audio-1.0-Preview是科大讯飞推出的全国产语音基座大模型,采用0.65B音频编码器与30B-A3B MoE语言模型架构,基于1300万小时音频及大量文本数据在纯国产算力集群上训练完成。该模型能够直接解析语音中的语义、情绪与场景信息,支持99种语言和202种方言的识别,以及语音转写、翻译、说话人识别、情感分析、音频问答等多种任务,在高噪声、小音量等复杂场景中表现出领先优势,...
YuE2:港科大与 M-A-P 联合开源的符号规划式音乐生成模型深度评测
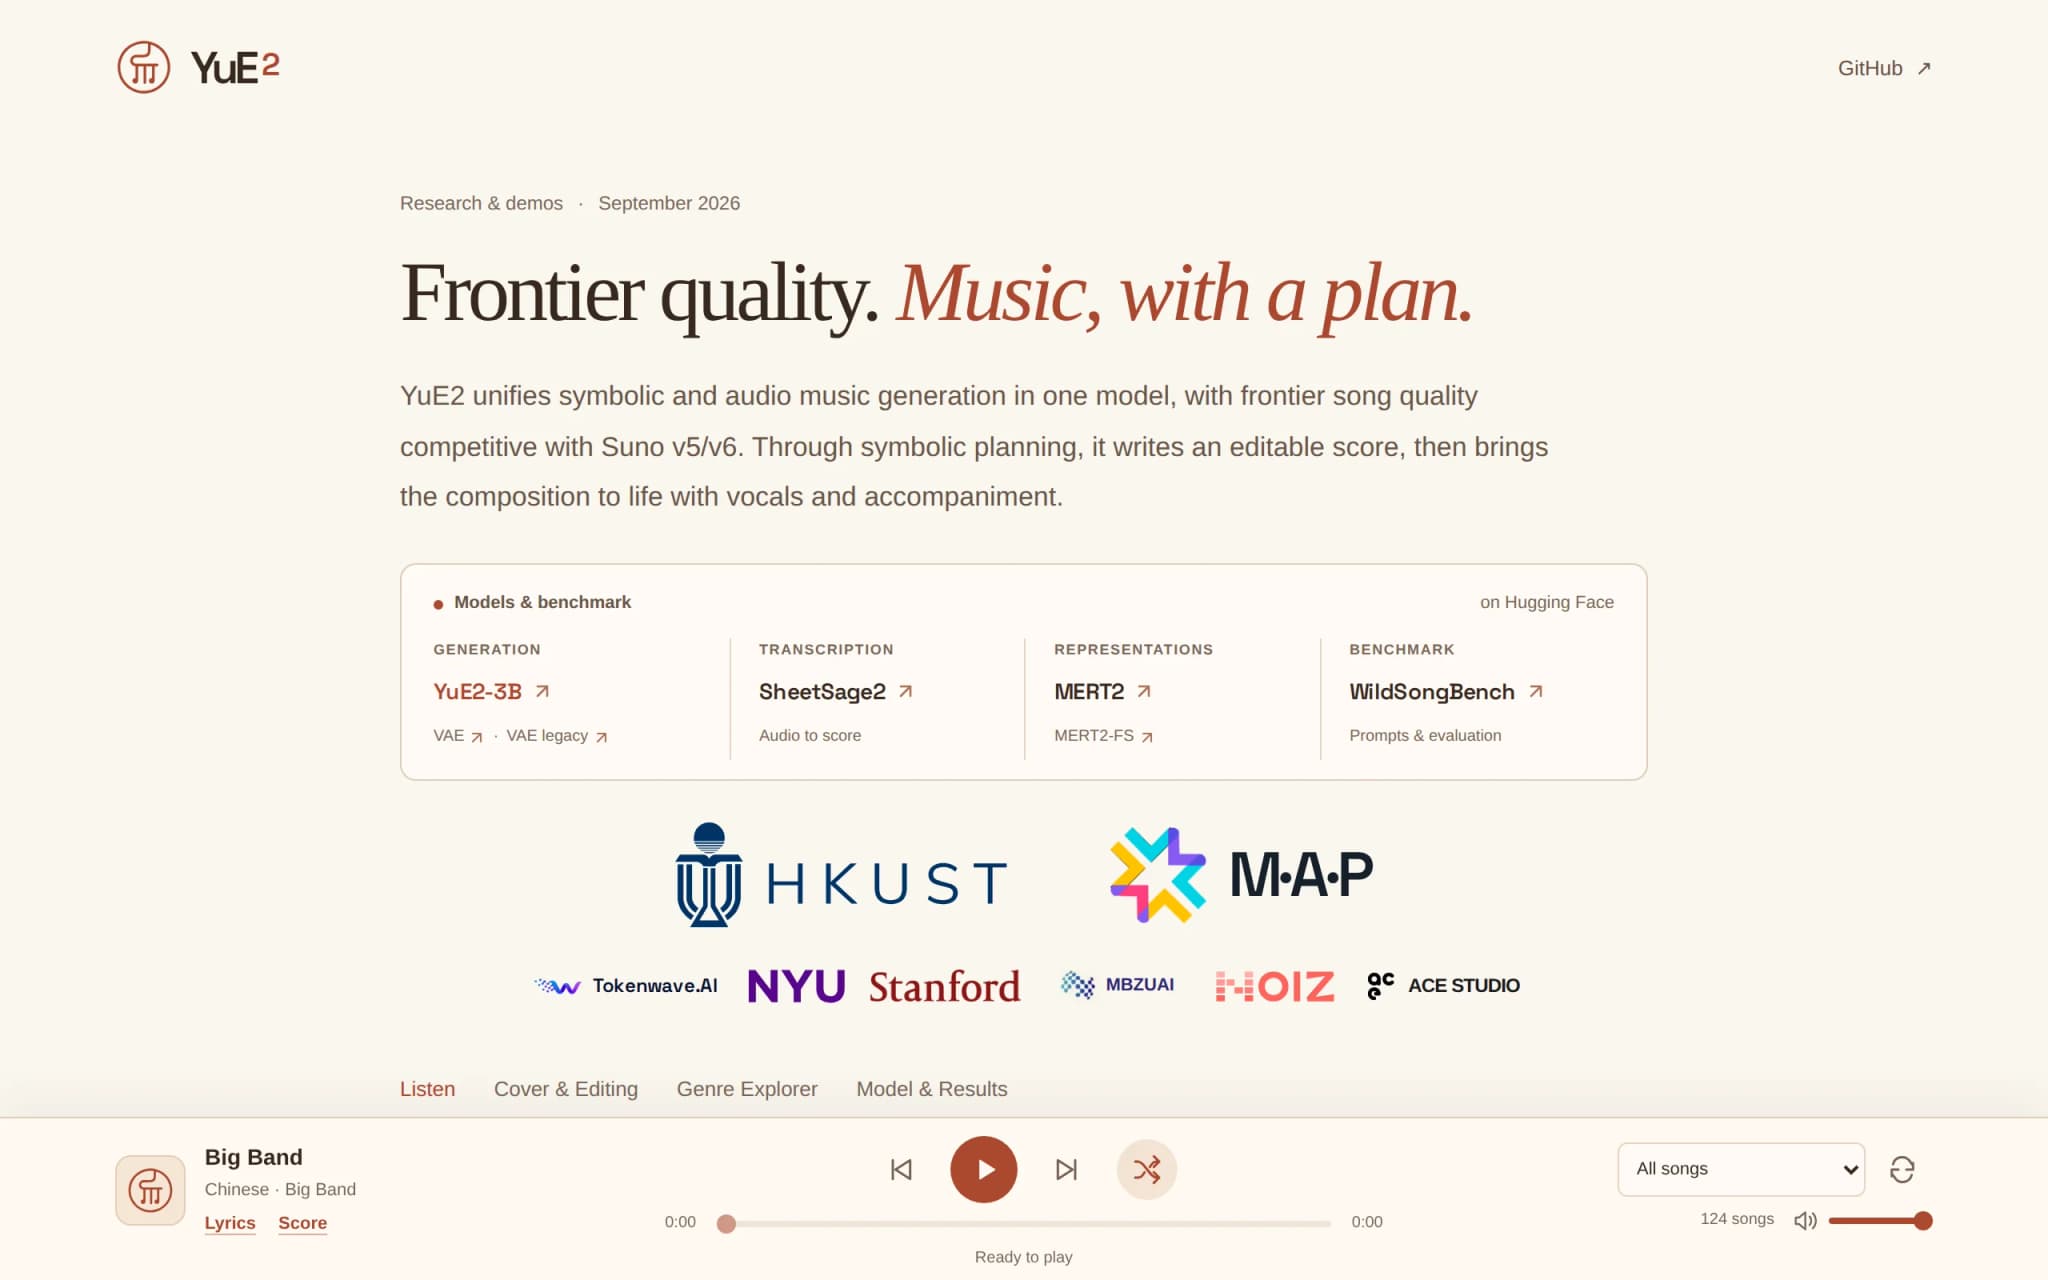
YuE2是由香港科技大学与多模态艺术计划团队联合研发的开源音乐生成模型,其核心设计理念是在文本/音频条件与最终波形之间引入一层显式的符号乐谱规划,以ABC记谱法呈现旋律与和弦。该模型采用约36亿参数的混合Transformer架构,能够依据歌词和风格提示先生成可编辑的乐谱,再将其渲染为48kHz完整歌曲,将音乐创作从不可控的黑盒生成转变为白盒可控的作曲过程。在WildSongBench基准测试中,...
ABot-Earth 0.7 – 高德推出的全球首个 3D 原生城市世界模型
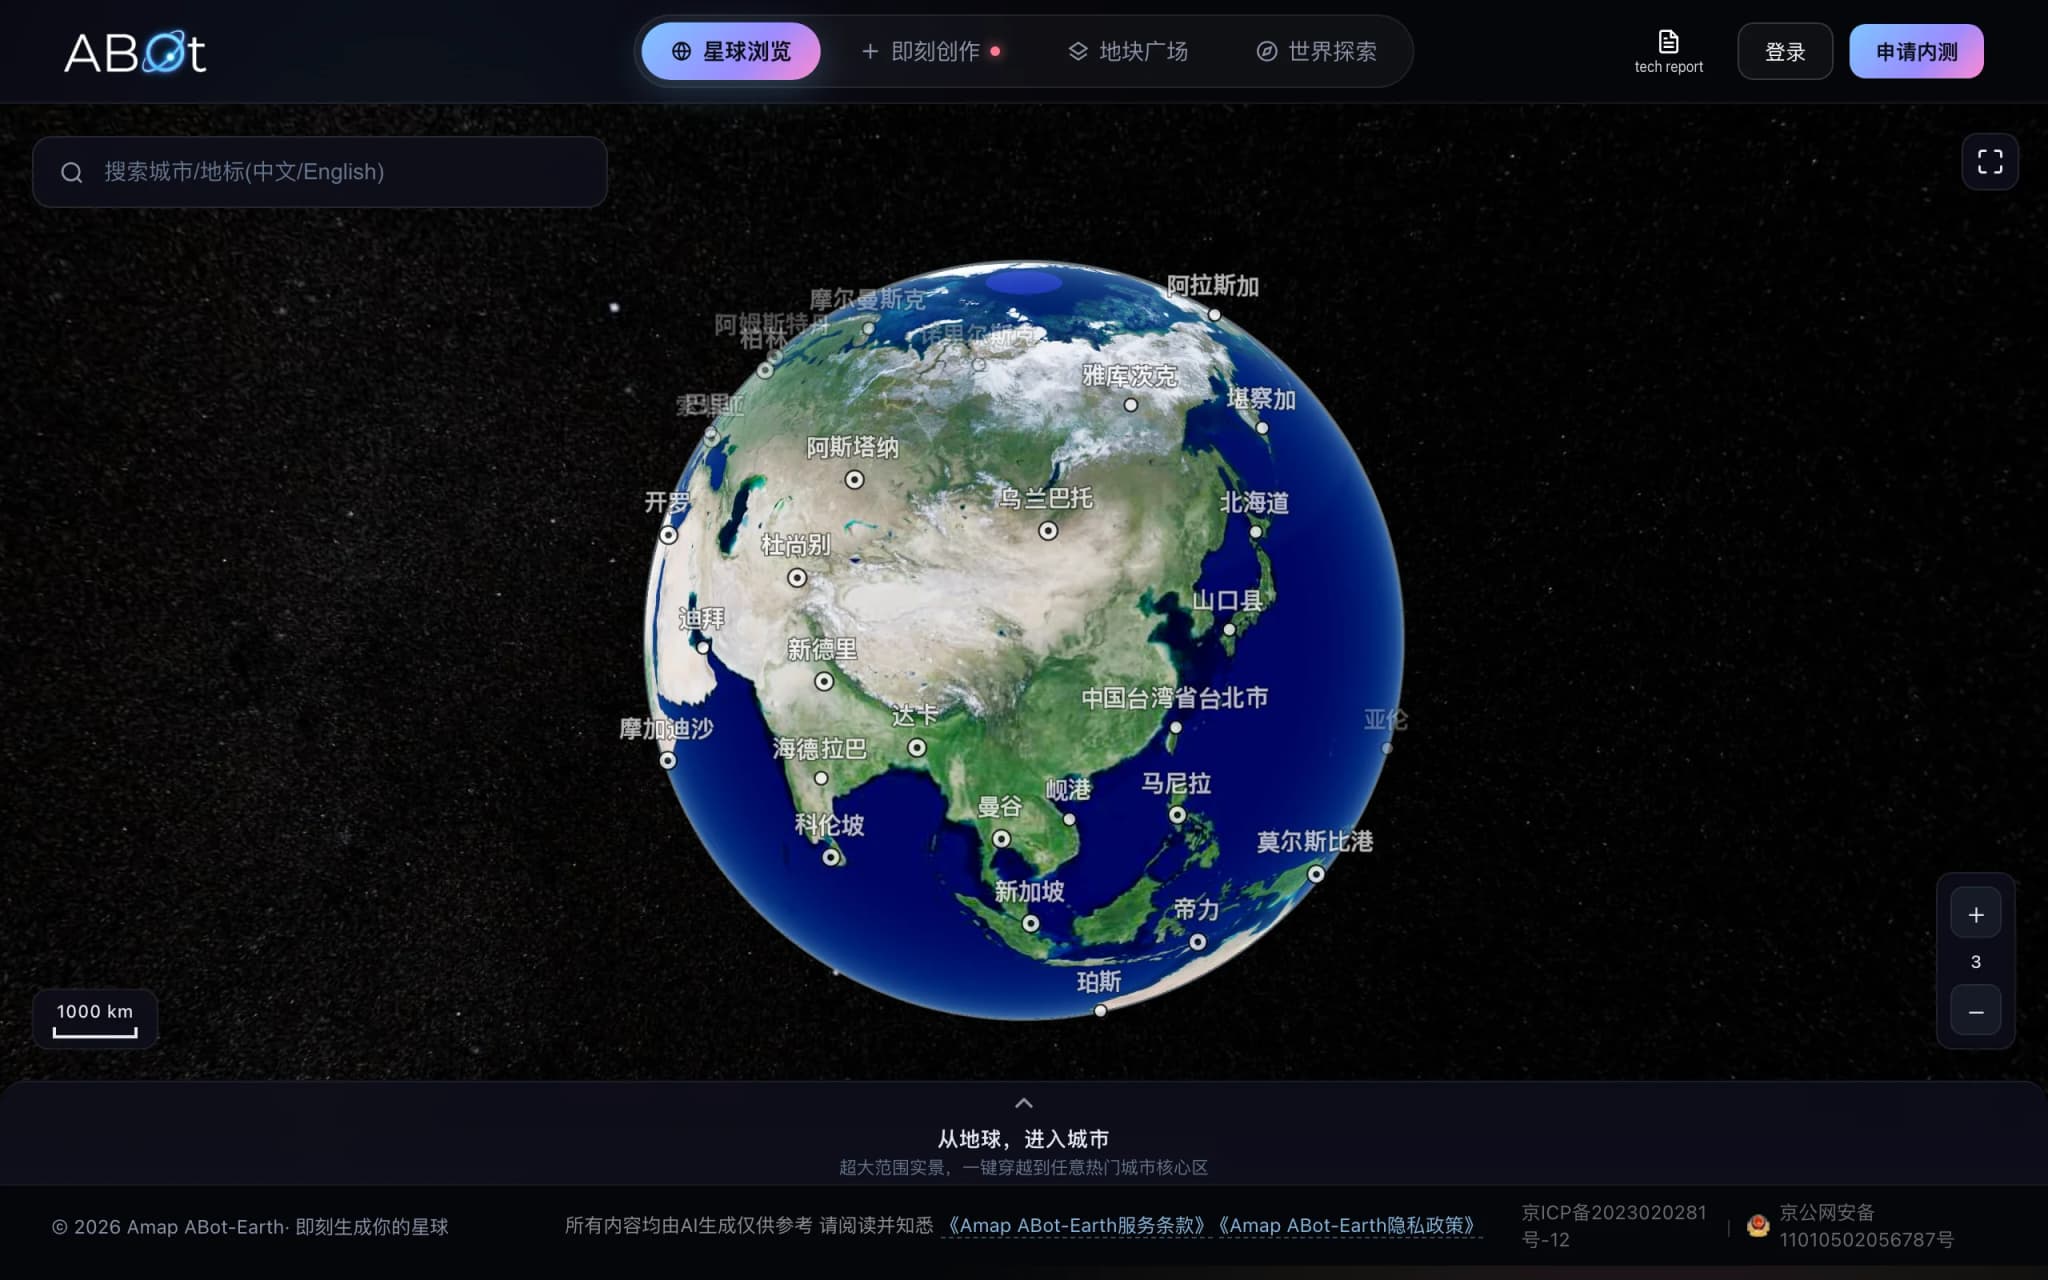
ABot-Earth 0.7是高德地图推出的全球首个3D原生城市世界模型,其核心创新在于采用3D原生技术架构,涵盖空间与时间信息的时空数据训练模型,使之建立对三维空间的原生理解。该模型支持用户输入一张卫星图或一段文字,在消费级GPU上仅需10分钟即可生成公里级3D城市,效率较传统模式提升约1000倍。模型覆盖196+国家和地区,支持从星球到街景的全尺寸连续生成,用户可自由漫游、实时交互,已作为高德...
大模型 RAG 技术解析:从基础流程到高级检索架构与评估优化
我想把 RAG(Retrieval Augmented Generation,检索增强生成)从基础到进阶讲清楚,因为它已经成为目前大模型应用落地最热门的方案。如果你正在把大模型接入实际业务,很快会发现通用模型根本不够用——知识过时、回答幻觉、数据安全这三大痛点几乎无法回避。这篇文章适合两类读者:一类是刚接触 RAG、想理解整体流程和核心概念的开发者;另一类是已经搭过简单 RAG 系统、想在检索质量