AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:视频AI
共 117 篇文章 · 清除标签
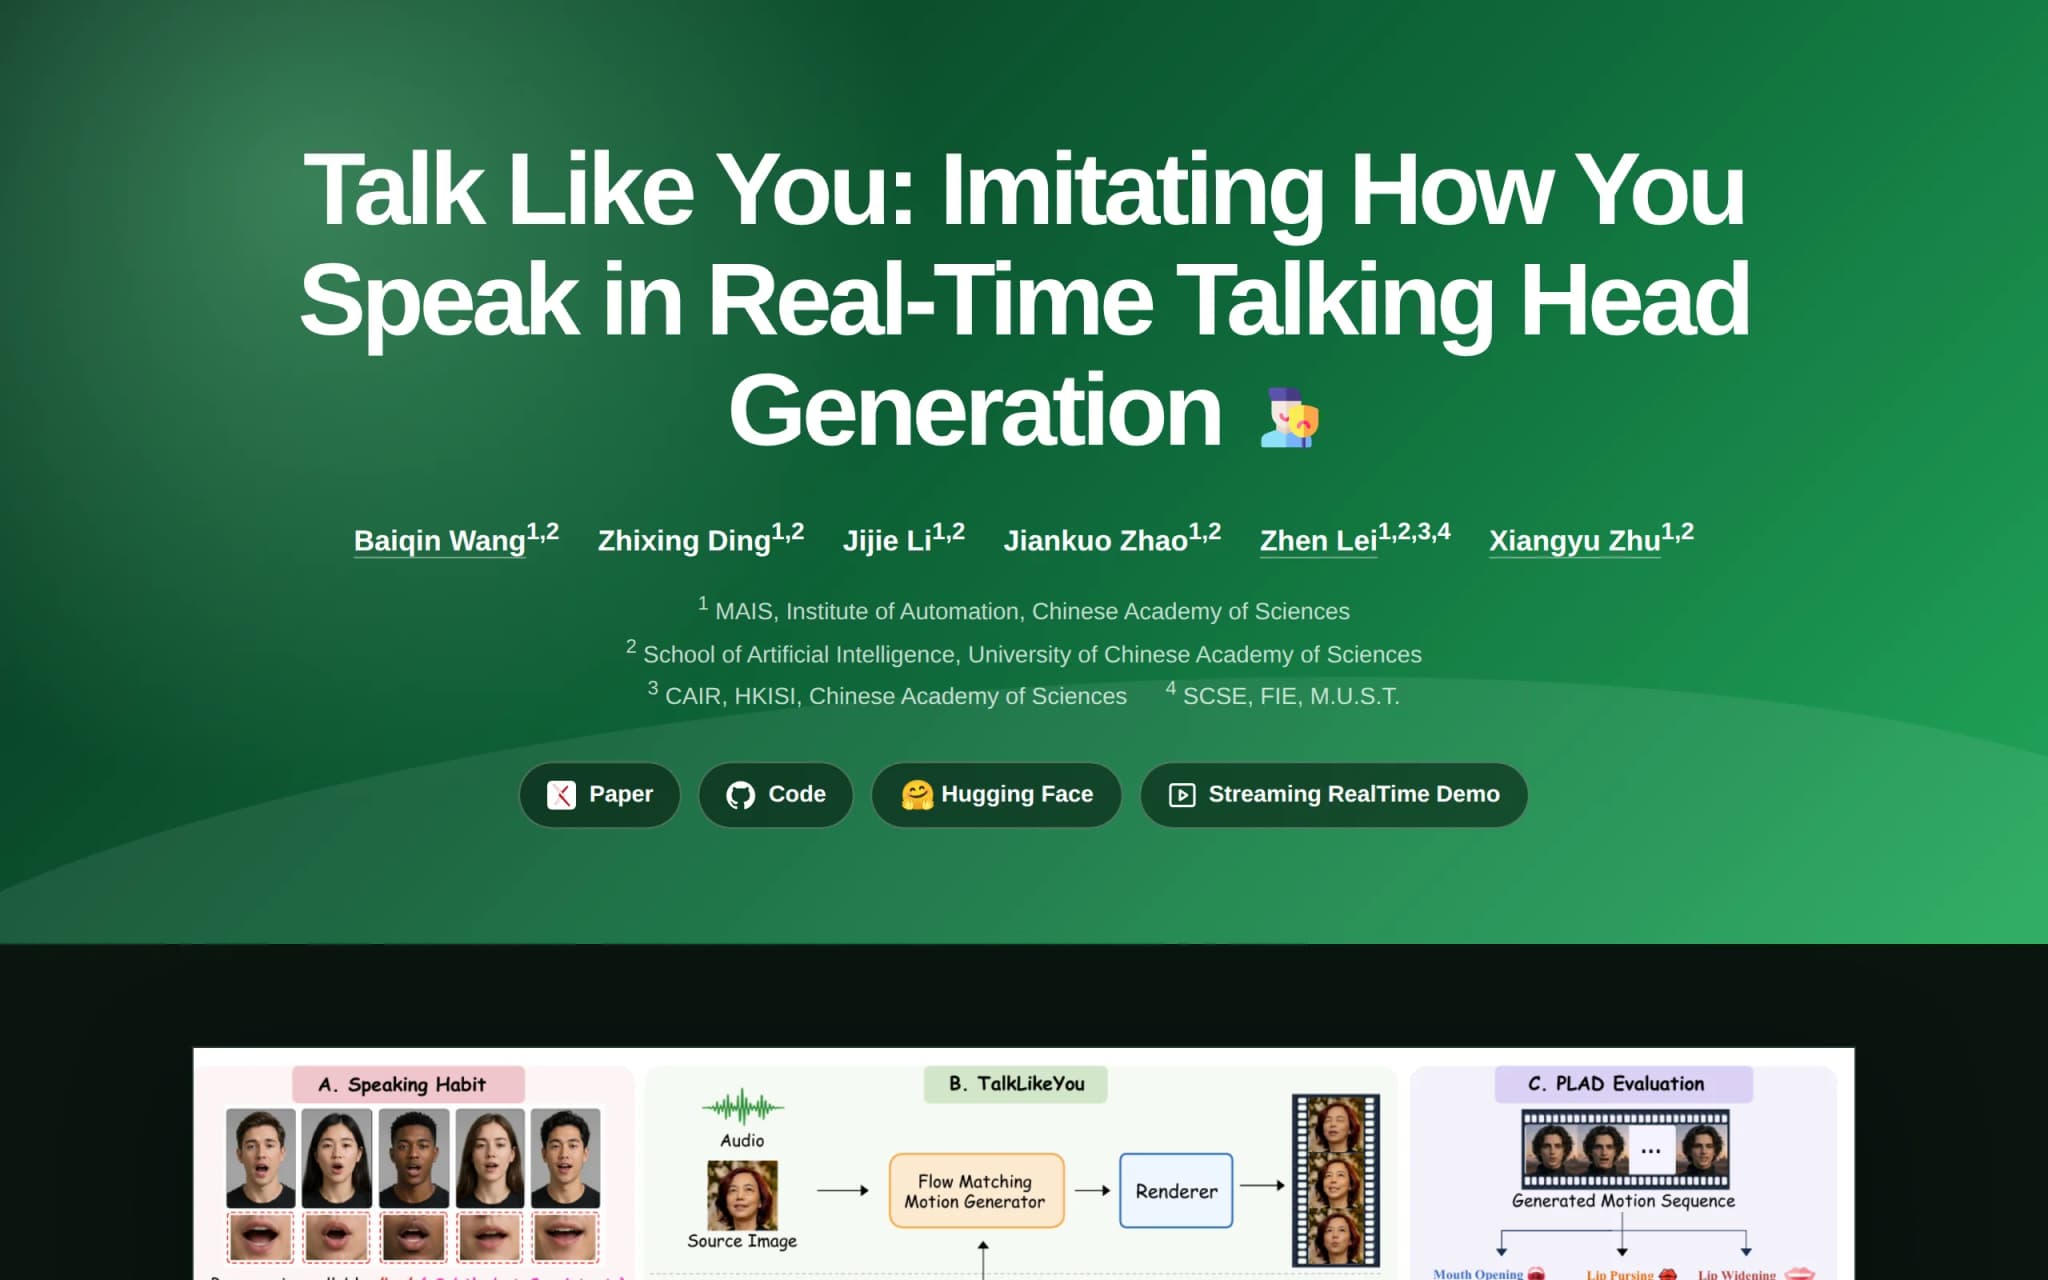
TalkLikeYou —— 中科院自动化所开源的实时数字人框架深度评测
TalkLikeYou 是由中国科学院自动化研究所开源的一款实时数字人(Talking Head)生成框架,其核心能力在于仅凭一张人像照片和一段音频,即可驱动照片中的人物开口说话,且嘴部动作能够精准模仿指定真人的个性化说话习惯。该框架通过运动空间建模与一步采样技术,在单张 RTX 3090 显卡上实现了 32.43 FPS 的实时生成速度,打破了以往数字人生成在速度与画质之间的平衡限制。项目代码与...
Vidu Q4 Preview:生数科技旗舰视频生成模型的传神演绎与多主体一致性实践
Vidu Q4 Preview是生数科技于2026年10月7日推出的新一代旗舰视频生成模型的首个公开预览版,主打"传神表现力"。该模型在人物演绎层面实现显著升级,面部表情更细腻、情绪传递更饱满、肢体动作更自然,同时支持最多15张参考图与3段参考音频,可在生成全程锁定人物形象、场景风格与角色音色的高度一致。在镜头语言方面,模型强化了动态运镜、丝滑切镜与复杂场景衔接能力,爆炸、烟火、粒子等视觉特效更具...
EmbeddingGemma 2 – 谷歌开源的原生多模态嵌入模型评测
EmbeddingGemma 2 是谷歌开源的原生多模态 Embedding 模型,基于 Gemma 4 架构构建,将文本、代码、图片、视频、音频五类模态统一映射到同一向量空间,实现跨模态语义检索。该模型采用模块化设计,全模态仅 740M 参数,上下文窗口为 8K token,量化后在 Pixel 11 Pro 上仅占约 567MB 内存。作为 1B 参数以下性能领先的多模态向量模型,其代码检索能...
Index-Translate – B站开源的多语言翻译模型家族
Index-Translate是B站(哔哩哔哩)Index LLM团队开源的多语言翻译模型家族,基于Qwen3.5底座构建,采用Apache-2.0协议开放权重。该家族文本模型覆盖150种语言互译,提供2B、9B、35B-A3B三种参数规模,支持术语统一、格式保留、指定字段翻译等指令约束。除文本翻译外,家族还包含Index-Echo语音翻译、Index-Homura音节可控翻译、Index-Nat...
Kling 4.0 – 快手推出的一代 AI 视频生成模型
Kling 4.0是快手旗下可灵AI推出的新一代视频生成模型,轻量版Kling 4.0 Flash已开放抢先体验,正式版预计2026年10月向所有用户开放。该模型在画面真实感、创意可控性和叙事完整度三个维度实现系统性升级,支持单次生成最长30秒的原生视频、最多10张关键帧精准控制、多模态参考输入、4K HDR专业级输出以及高品质口型匹配,具备多语种方言、创意复刻和超长续拍等能力,为创作者提供从灵感...
Space Bunny – 匿名登场的免费多模态大模型,单日调用量登顶 OpenRouter
Space Bunny(太空兔)是一款匿名上线于 OpenRouter 和 OpenCode 平台的免费大语言模型,凭借极速推理、突出编程能力和原生多模态输入能力,在上线仅 3 天内便冲上两大平台的单日调用量榜首。该模型拥有 100 万 Token 的上下文窗口,单次最大输出可达 524,288 Token,支持文本、图像和视频三种输入形式。社区开发者评价其推理速度“约等于 GLM 5.3 Fla...
Kimu:trykimu 团队开源的 AI 视频编辑器深度评测
Kimu(官方名 Kimu Studio)是 trykimu 团队开源的一款 AI 视频编辑器,其核心理念在于用自然语言描述需求,由 AI 自动生成剪辑、时序和布局方案,从而显著降低视频创作的门槛。该工具在架构上融合了 React 前端框架、FastAPI 后端服务与 Remotion 声明式视频渲染引擎,支持无限轨道叠加、实时预览、快速导出、智能媒体库管理以及多人云端协作。产品采用 AGPL 类...
Xiaomi MiMo-V2.6 – 小米开源的全模态模型系列
Xiaomi MiMo-V2.6是小米发布并开源的全模态模型系列,包含Pro和Flash两个原生全模态模型,以可验证复杂任务为核心的大规模Agentic强化学习为技术主线。该系列通过6天在线强化学习、约75万条交互轨迹的系统训练,显著提升了软件工程、代码生成、视觉理解与网络安全等多维度能力,并将能力边界扩展至3D游戏场景构建、Blender三维建模、机械臂具身控制、Computer Use自动化操...

Qwen3.8-LiveTranslate评测:阿里通义推出的实时同声传译大模型
Qwen3.8-LiveTranslate是阿里通义千问团队推出的实时同声传译大模型,基于Interleave单流架构将音频与文本交织处理,字均延迟从2.8秒优化至2.3秒,支持60种语言识别与29种语言语音输出。模型采用Hybrid MoE的Thinker-Talker双模块设计,在翻译前完成说话人分离,并能够复刻原说话人音色生成译文语音,同时支持视频/图像输入辅助翻译消歧,实现原文与译文同帧同...
HappyOyster 1.0 — 阿里推出的实时生成式开放世界模型深度评测
HappyOyster 1.0是阿里巴巴ATH创新事业部推出的实时生成式开放世界模型系列,定位为世界模拟器范式下的新一代交互式生成模型。该系列包含Adventure与Directing两款模型,前者可基于文本或图像输入实时生成可自由探索的开放世界,支持实时移动、镜头控制与持续交互;后者可通过文本指令实时驱动角色、剧情与镜头演绎。模型已上架阿里云百炼平台,开发者无需邀测即可通过API直接调用,单次世...