AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:图像生成
共 64 篇文章 · 清除标签
MAI-Image-2.5-Pro – 微软推出的高精度图像生成模型
MAI-Image-2.5-Pro是由微软AI团队推出的高精度图像生成模型,专注于高质量主视觉图、写实摄影及商业设计素材的生成。该模型在Arena文生图榜单中排名第三,尤其在写实摄影领域表现突出,同时支持图像内文字渲染与自然语言指令编辑。目前已深度集成至Bing Image Creator、PowerPoint和OneDrive等微软核心产品,相比GPT-Image-2可降低84%的GPU成本,兼...
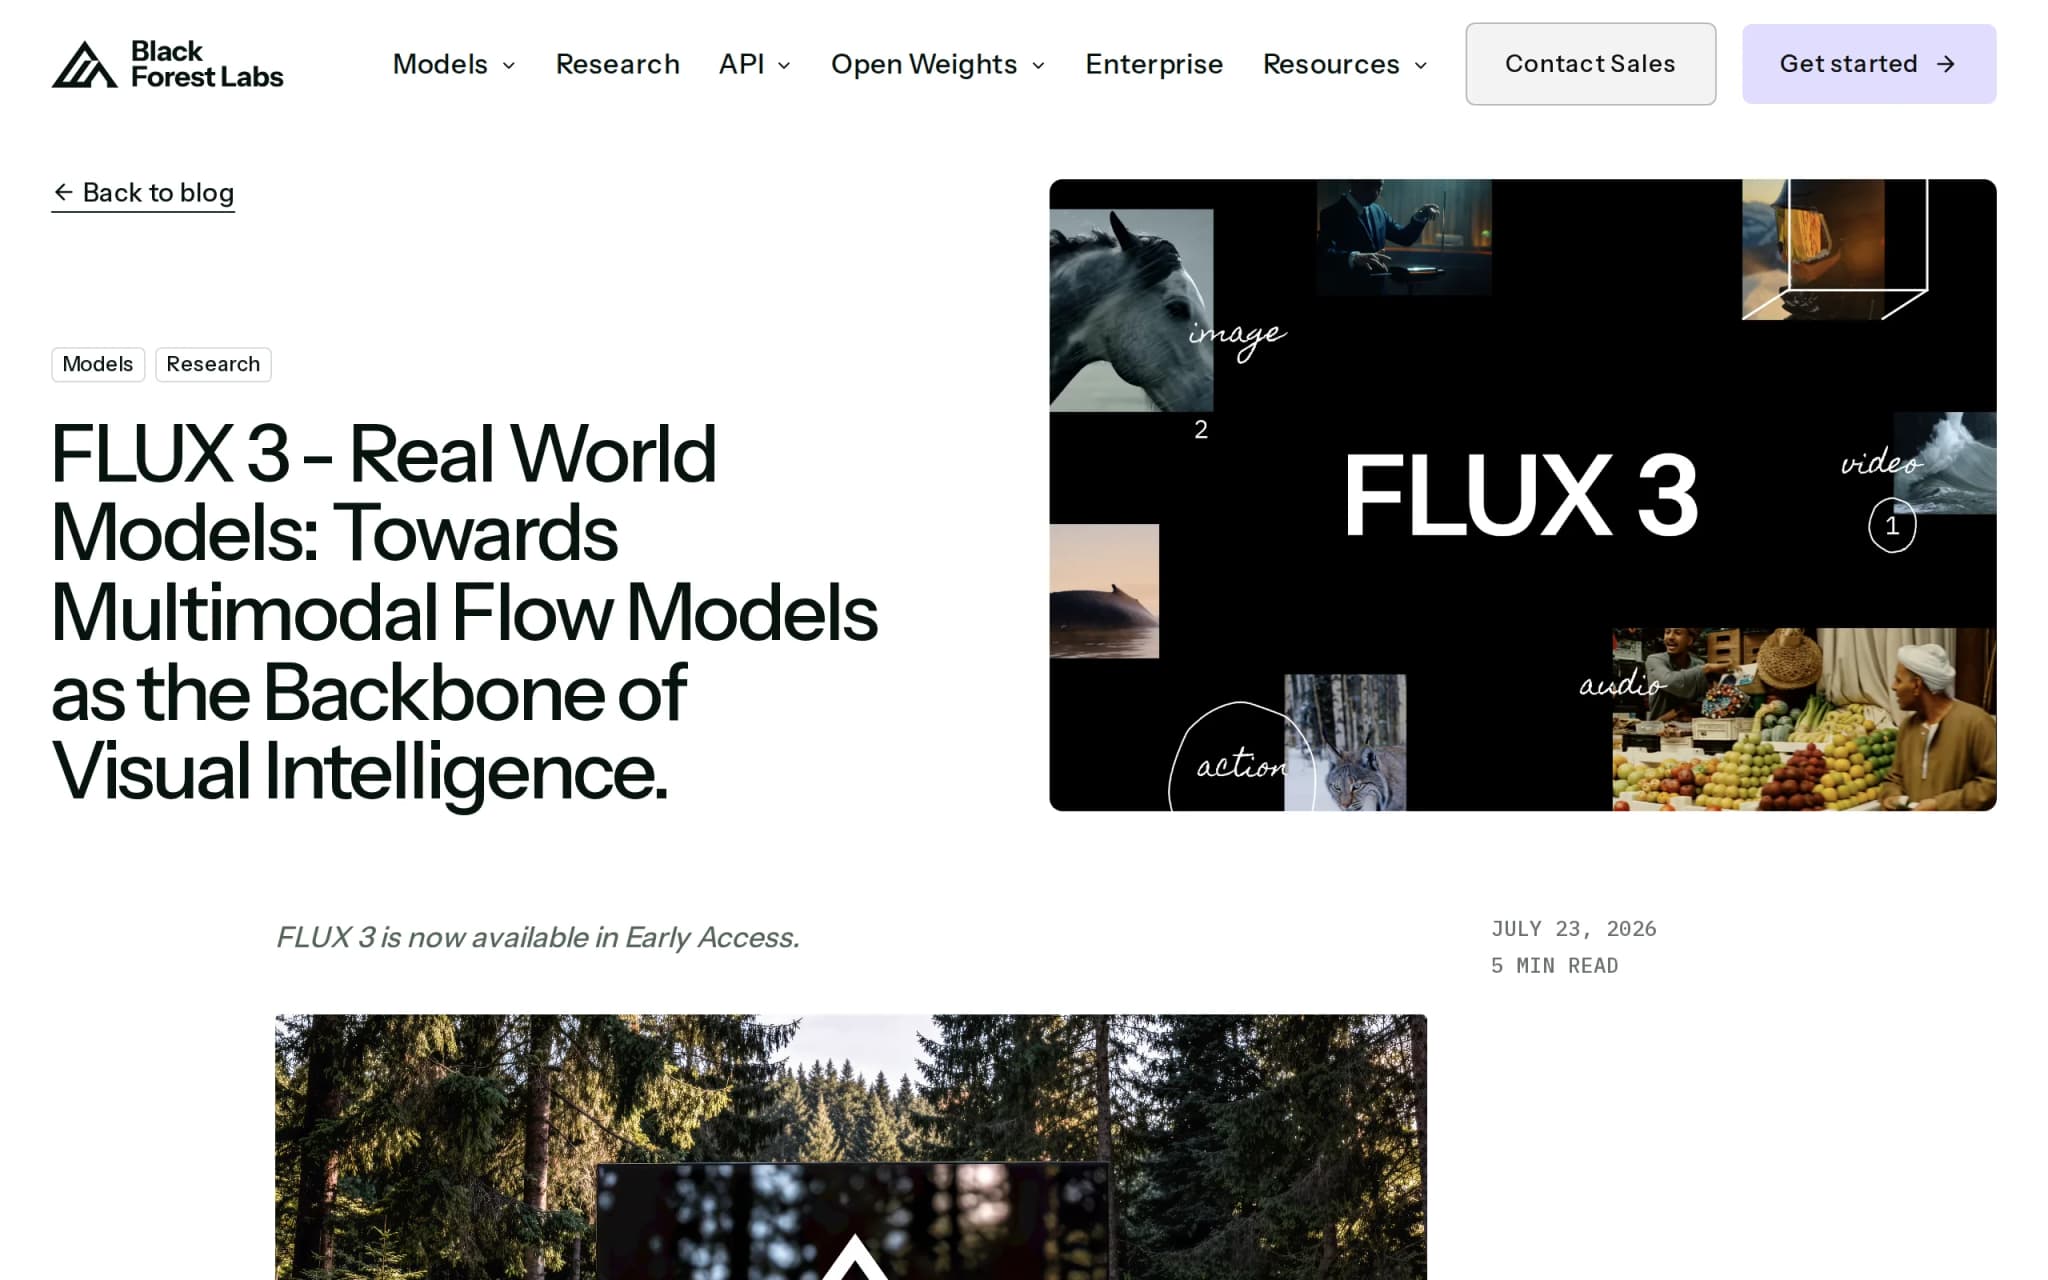
FLUX 3 – Black Forest Labs 推出的多模态基础模型
FLUX 3是由Black Forest Labs推出的多模态基础模型,首次在统一架构下联合学习图像、视频与音频。基于Self-Flow技术,模型将生成与理解对齐于同一框架,能够单次生成长达20秒带原生音频的视频,支持文生视频、图生视频、视频生视频及关键帧转视频。通过模态间的物理约束学习世界表征,FLUX 3在机器人操控等具身智能任务上表现优异。
img2threejs – 开源的 AI Skill,支持单图转 Three.js 3D 模型
img2threejs是由开发者hoainho推出的开源AI Skill,能够将单张参考图片自动转换为可交互的Three.js 3D模型。该工具通过深度分析图片的轮廓、比例、材质与表面细节,生成结构化的建模规格文档,并利用Three.js基础几何体与程序化纹理重建物体,最终输出一套纯代码模型。整个过程无需导入外部网格文件,模型可直接嵌入网页并进行版本管理,为Web前端开发者提供了一条从图片到3D代...

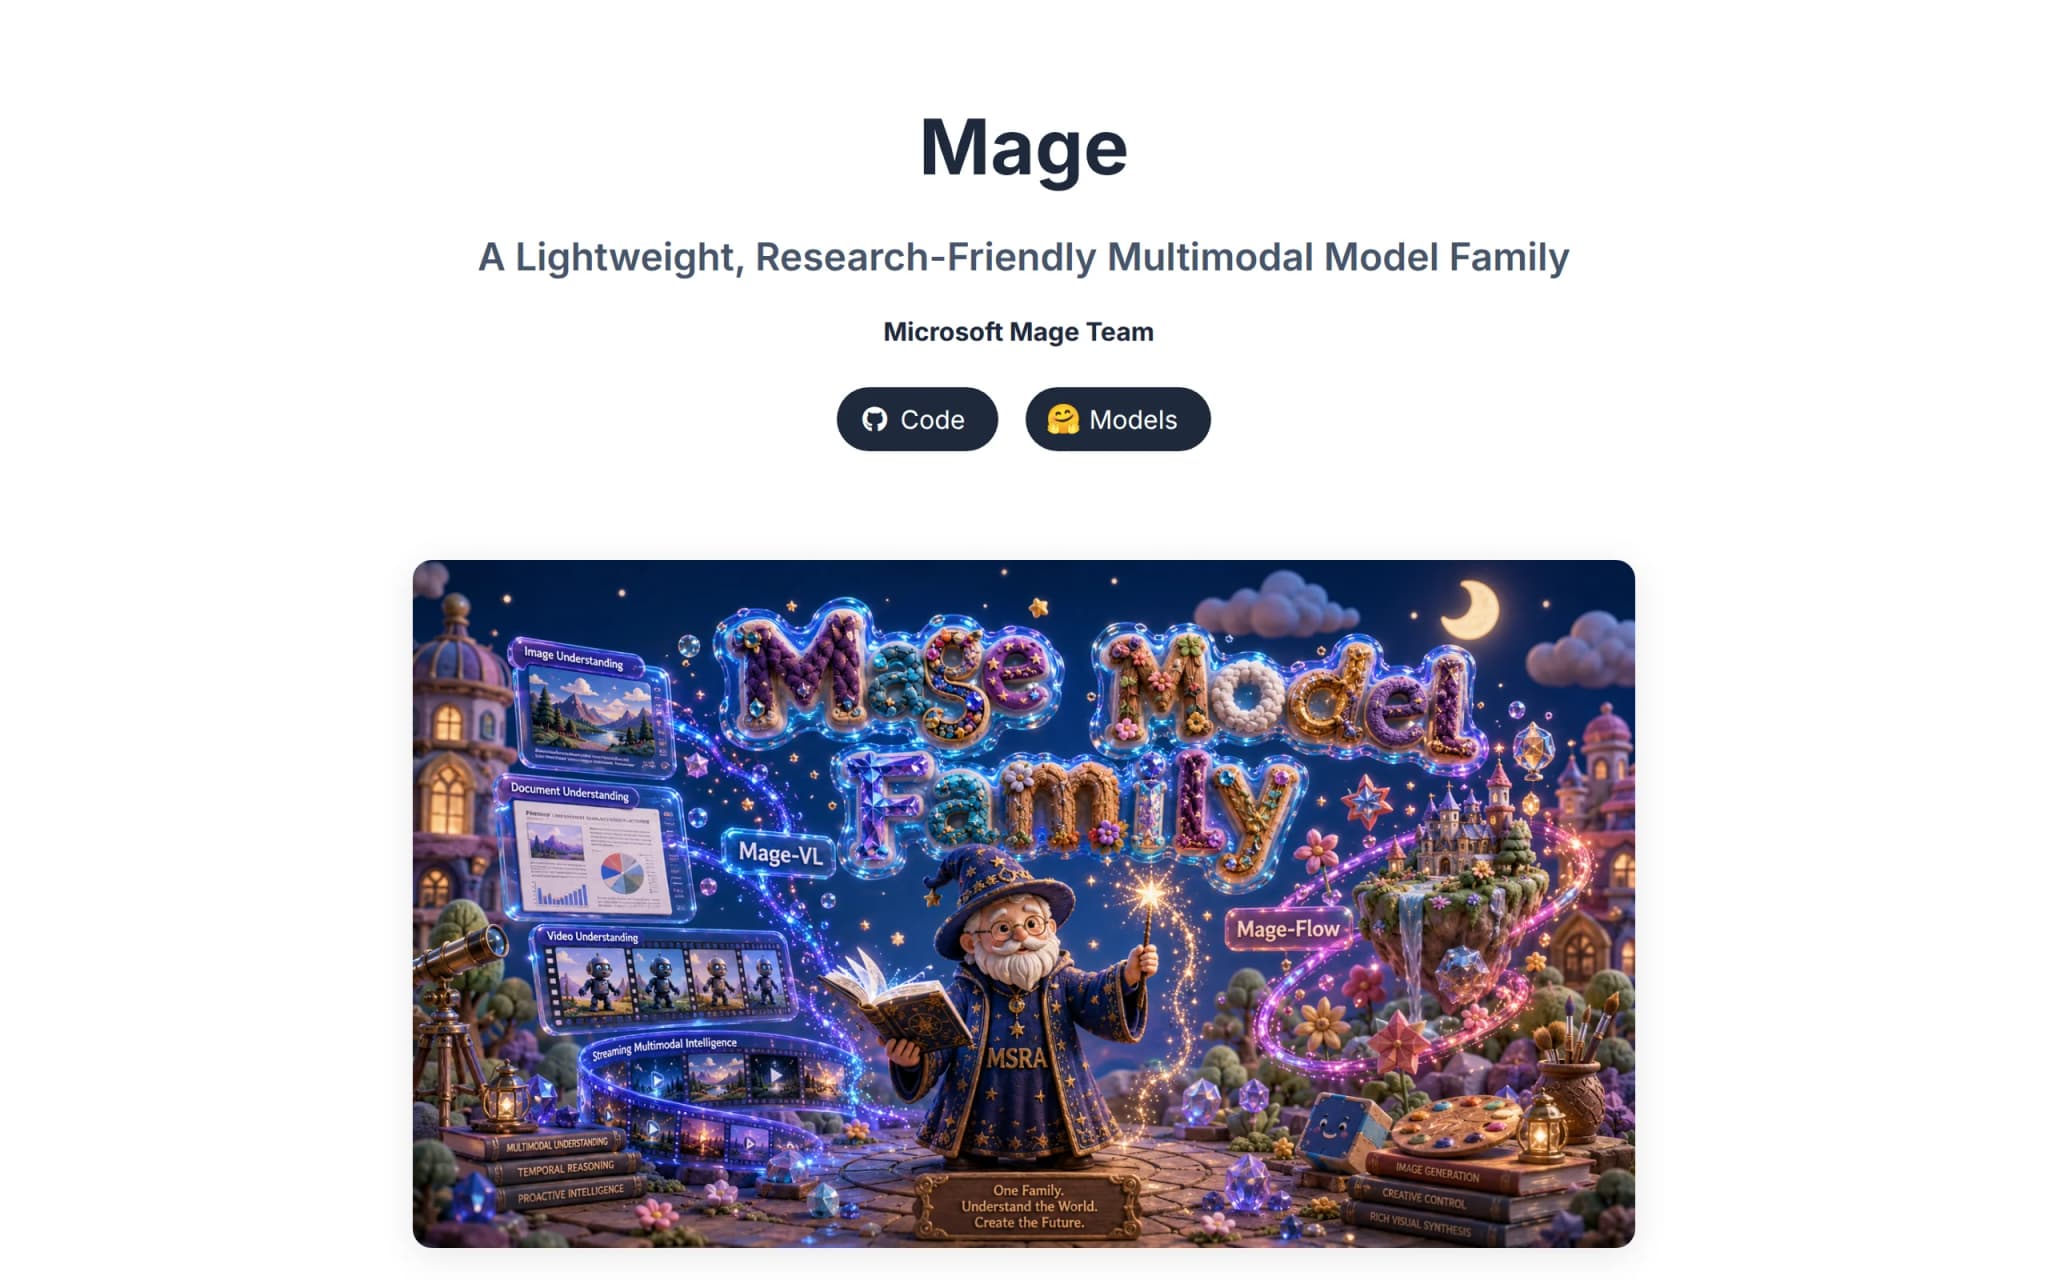
Mage-Flow – 微软开源的轻量级多模态图像生成模型系列
Mage-Flow 是微软开源的轻量级多模态图像生成模型系列,基于流匹配架构,仅 4B 参数。模型包含 Base 基础版、RL 强化学习版、Turbo 加速版和 Edit 图像编辑版四个变体,支持文本到图像生成、局部编辑与风格迁移。模型在保持高质量输出的同时大幅降低部署门槛,可在消费级 GPU 上高效运行,适用电商设计、广告创意、游戏开发等场景。
SenseNova U1 Pro – 商汤科技推出的旗舰图片创作模型
SenseNova U1 Pro是商汤科技推出的旗舰级图片创作模型,核心定位为理解、生成与行动的原生统一。该模型支持原生8K分辨率直出,具备图文交错思维能力,能够围绕目标连续完成草图、细化、着色、检查和调整的全流程,瞄准信息图、影视分镜、商业设计等可直接交付的专业场景。通过端到端的统一架构,它将图像理解、内容规划、信息组织、多模态生成、质量检查与最终交付整合为单一流程,而非传统分阶段拼接,从而在复...
SeFi-Image – 开源的文本到图像模型,基于语义优先扩散
SeFi-Image是一种基于语义优先扩散架构的开源文本到图像生成模型,提供1B、2B、5B三种参数规格。该模型通过将高层语义结构与纹理细节分离,并引入时序偏移机制,使语义流提前一个时间步开始去噪,从而为纹理生成提供清晰的结构锚点。5B模型仅需125K A800 GPU小时即可完成训练,在GenEval、LongTextBench、CVTG-2K和OneIG等多项基准测试中表现强劲,支持场景合成、...
HyOCR-1.5 – 腾讯混元开源的轻量级端到端 OCR 专家大模型
HyOCR-1.5是腾讯混元团队推出的轻量级端到端光学字符识别(OCR)专家大模型,参数量仅1B,却集文档解析、文本检测识别、信息抽取、拍照翻译、图表解析、古文字识别、视频字幕提取及多页文档问答等全栈能力于一体。该模型基于DFlash投机解码技术,在长结构化输出场景下推理速度最高提升6.37倍,并在OmniDocBench v1.6基准测试中以94.74分的成绩位居端到端OCR榜首,展现出优异的精...
Wan-Dancer – 阿里通义开源的人像舞蹈视频生成模型
Wan-Dancer 是阿里通义万相开源的音乐驱动人像舞蹈视频生成模型,用户仅需提供一张单人正面照片和一段音乐,即可自动生成节奏精准、动作流畅且风格鲜明的舞蹈视频。该模型首次突破分钟级时序生成瓶颈,支持输出 15 秒至 3 分钟的 720p/30fps 超长连贯视频,覆盖中国古典舞、韩舞、街舞、踢踏舞和拉丁舞五种舞种,并允许通过 LoRA 技术进行个性化舞蹈风格定制。Wan-Dancer 在长序列...
Muse Image – Meta 超级智能实验室推出的AI图像生成模型
Muse Image 是 Meta 超级智能实验室推出的首个自研 AI 图像生成模型,采用 Agent 架构,与 Muse Spark 协作进行多步规划与自我精炼。模型支持文生图、智能编辑、背景擦除、文字渲染及多素材融合,在 Arena AI 排行榜位列全球第二。模型深度整合 Instagram、WhatsApp 等 Meta 社交生态,用户可通过对话式提示或预设模板快速创作。
GenEvolve – 美团等推出的自演进图像生成 Agent
GenEvolve是由香港科技大学(广州)、美团与新加坡国立大学联合研发的自演进图像生成Agent,它将开放式图像生成任务形式化为工具编排的视觉轨迹,通过搜索文本证据、检索视觉参考、调用生成知识,最终合成可执行的prompt-reference program,交由任意参考条件生成器渲染。该Agent基于Qwen3-VL-8B-Instruct模型,采用两阶段训练策略——SFT冷启动与GRPO强化...