AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
星火X2.5 – 科大讯飞推出的旗舰通用大模型系列
星火X2.5是科大讯飞推出的旗舰通用大模型系列,包含云端MoE基座模型(293B/30B)及开源端侧模型星火X2.5-4B和星火X2.5-1.7B。该系列基于全国产算力完成全流程训练,实现从底层芯片到上层模型的全栈自主可控。核心能力聚焦代码生成、智能体协作与数学推理三大方向,端侧版本原生支持100万Token超长上下文,采用混合注意力架构显著降低计算开销。模型已兼容英伟达、华为昇腾等多硬件平台,支...

FireRedAudio – 小红书FireRed推出的通用音频语言模型深度评测
FireRedAudio是小红书FireRed团队于2026年8月开源的通用音频语言模型,基于9B参数Qwen3.5自回归大语言模型构建。该模型采用理解与生成解耦的连续表征架构,通过独立的Audio Encoder与RedAE通道分别提取语义特征与声学特征,再汇入共享LLM统一推理,同时支持语音识别、音频问答、1小时录音理解、Zero-shot TTS、指令TTS及语音编辑等六大任务,在MMAU、...
MAI-Transcribe-2 – 微软推出的最强 AI 语音转文字模型
MAI-Transcribe-2是微软推出的一款AI语音转文字(STT/ASR)模型,在准确率、速度和成本三个核心维度上实现了全面领先。该模型支持60种语言,在FLEURS测试集上的平均词错误率仅为5.2%,中文词错误率低至4.5%。处理速度达到403.6倍实时,即1小时音频约9秒即可完成转写,同时限时定价仅为0.10美元/小时,较上一代产品降价约72%。模型原生集成说话人分离、逐词时间戳、自动语...
Muse Voice Transcribe – Meta 推出的首个实时音频感知模型
Muse Voice Transcribe 是 Meta 推出的首个实时音频感知模型,集流式自动语音识别(ASR)、说话人分割与语音端点检测于一体。模型支持 70 多种语言及原生语码切换,可处理超过 1 小时的长音频与 20 人以上的同时对话场景,在流式转写和语音分割基准测试中均排名第一。基于强化学习的自适应延迟技术,使其能够动态权衡响应速度与识别准确率。目前 Muse Voice Transcr...
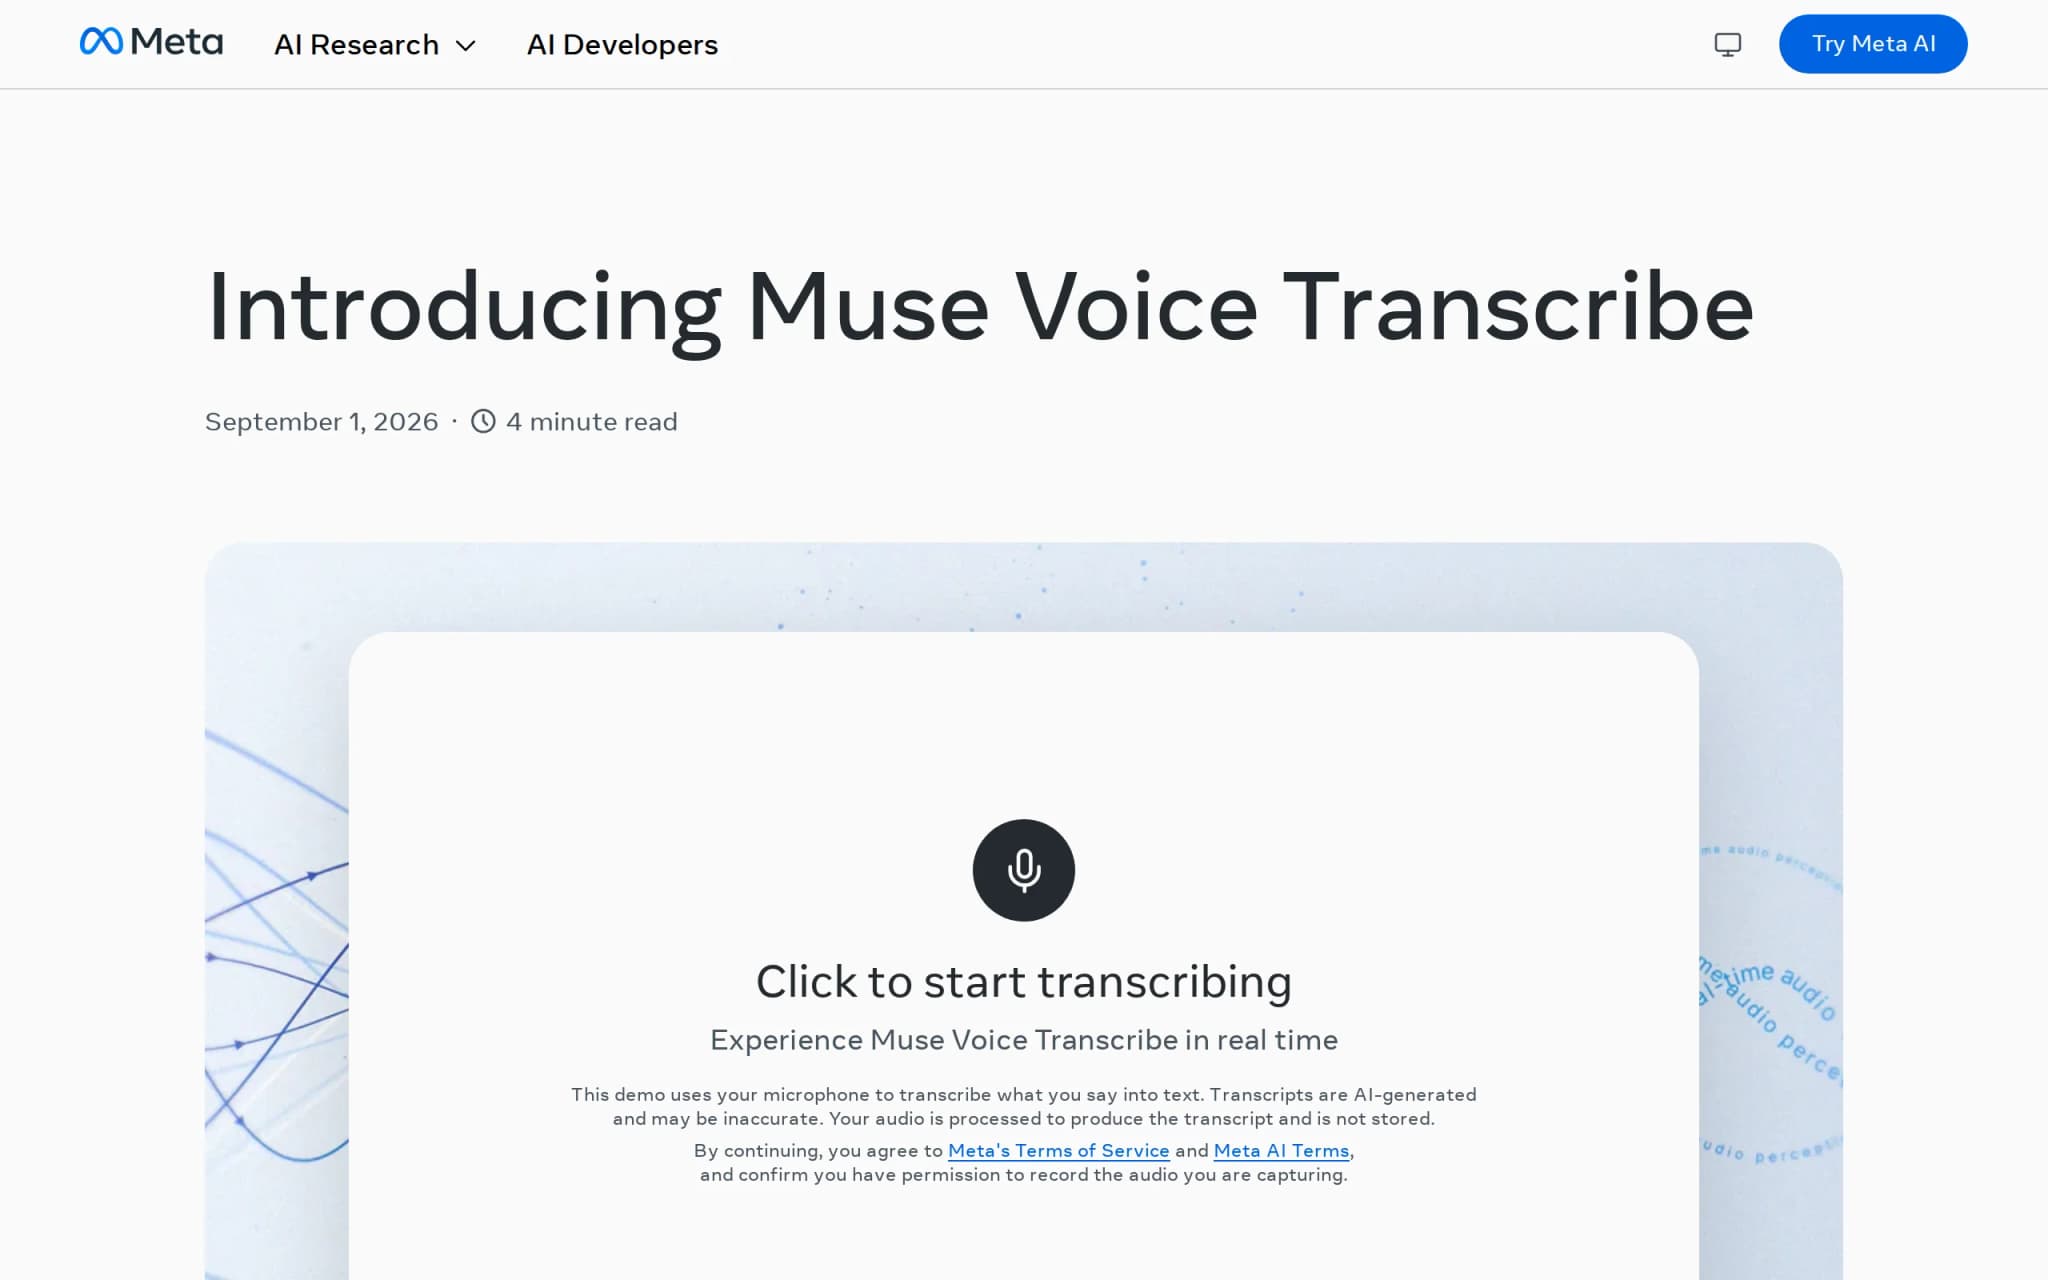
FireRedAudio – FireRedTeam 推出的通用音频语言模型
FireRedAudio 是 FireRedTeam 推出的通用音频语言模型,代码、权重和论文都已公开。它用一个共享的 9B 自回归 LLM 做推理主干。理解与生成走解耦的连续表征:Audio Encoder 负责理解,RedAE 与 flow-matching DiT 负责生成。
shuohao-skills – 开源AI短剧制作Skill集合,包含完整工作流
shuohao-skills是开源的AI短剧制作Skill集合,专为Claude Code、Codex等Agent设计。工具提供从小说改编大纲、角色设定、美术设定、剧本撰写到分镜切分的完整工作流,每个环节配有脚本化质量检查,确保角色不雷同、时长精准、风格一致。产出可直接对接TTS和视频生成管线,实现从文本到投产包的一站式AI短剧前期制作。
Gemini 3.5 Transcribe 深度评测:谷歌新一代语音转文本模型的技术解析与应用展望
Gemini 3.5 Transcribe 是 Google 推出的最新语音转文本(Speech-to-Text)模型,基于 Gemini 3.5 统一多模态架构构建,支持实时流式转录与预录音频处理两种核心模式。前者通过 Live API 实现亚秒级延迟的双向连续语音交互,后者通过 Interactions API 提供带说话人归属与词级时间戳的高精度离线转写。模型支持 85 种以上语言的自动识别...
Breeze TTS 2 – BreezeBlue推出的一代语音合成模型深度评测
Breeze TTS 2是BreezeBlue推出的新一代语音合成模型,支持通过自然语言零样本设计角色音色,并以自然语言指令精准控制情绪、语速、口音等表演细节。模型侧首字节延迟低至40ms,在Voice Design、Voice Direction和Latency三项权威评测中均位列全球第一,支持50余种语言,面向虚拟主播、游戏NPC、有声内容与AI Agent等实时交互场景提供端到端的语音生成能...
FireRedTTS3 – 小红书开源的统一语音生成与编辑模型
FireRedTTS3是由小红书FireRed团队开源的统一语音生成与编辑模型。基于RedAE语义增强连续表示与LLM-DiT架构,该模型在单一框架内实现了24种语言与21种中文方言的零样本音色克隆、自然语言描述驱动的全新声音设计,以及指定区域的精准语义与声学编辑。模型在Seed-TTS-Eval、MiniMax-MLS-Test等四个公开评测集上取得领先成绩,代码与权重全面开源,支持本地化部署,...
Luna-TTS – 宇生月伴推出的文本转语音大模型
Luna-TTS 是由上海交大系初创公司宇生月伴(VUI Labs)自主研发的文本转语音大模型。该模型摒弃了主流的自回归生成路线,采用 Masked Diffusion(掩码扩散)架构,基于 Qwen3-0.6B 语言模型进行训练,并配合自研的 Luna-Codec 编解码器,在中英日韩四种语言的 100 万小时语音数据上完成预训练。在 Hugging Face TTS Arena V2 盲听评测...