AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:图像生成
共 63 篇文章 · 清除标签
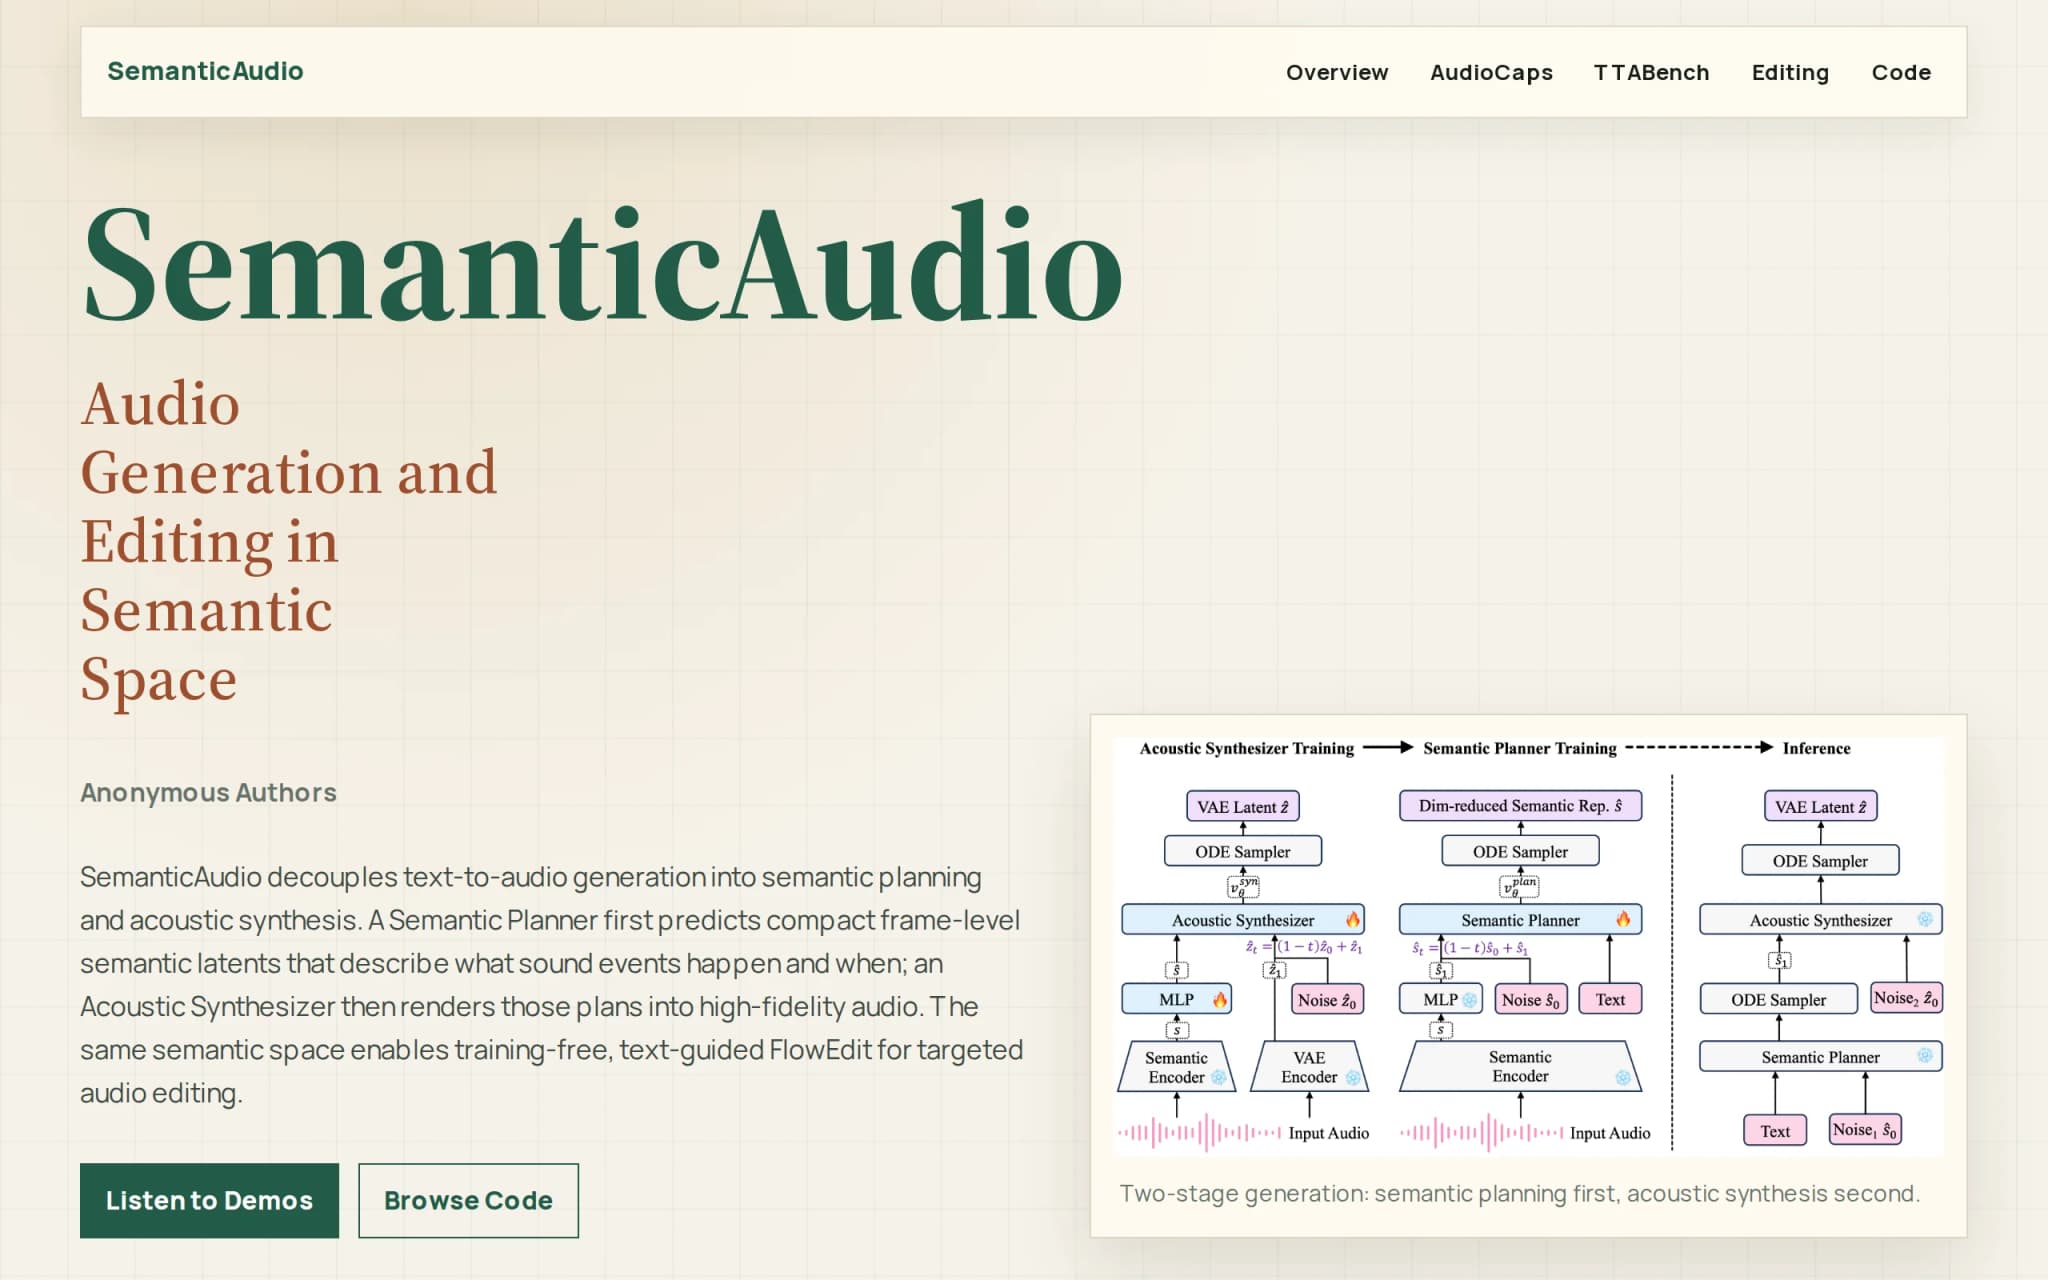
SemanticAudio – 港中文等推出的音频生成与编辑框架
SemanticAudio 是由香港中文大学、LIGHTSPEED 与上海交通大学联合推出的两阶段音频生成与编辑框架。它将文本到音频生成拆解为“语义规划”与“声学合成”两个阶段,先在高层语义空间规划声音事件的身份、时序与结构,再渲染为高质量音频。框架内置 FlowEdit ODE 机制,支持无需训练的文本引导音频编辑,在 AudioCaps 和 TTABench 基准上均显著优于 TangoFlu...
Nemotron-Labs-TwoTower – 英伟达开源的双塔架构扩散语言模型
NVIDIA Nemotron-Labs-TwoTower 是英伟达开源的一款双塔架构扩散语言模型,总参数量约60B,活跃参数仅3B,基于MoE稀疏激活机制实现高效计算。该模型将传统的上下文理解与去噪生成解耦为两个独立塔:冻结的自回归上下文塔负责处理干净token,可训练的扩散去噪塔通过交叉注意力机制精炼噪声块。模型基于Nemotron-3-Nano-30B-A3B构建,在约2.1T tokens...
Nano Banana 2 Lite – 谷歌推出的轻量级 AI 图像生成模型
Nano Banana 2 Lite 是谷歌推出的自研轻量级 AI 图像生成模型,定位速度优先的极速版,可在 4 秒内生成单张图像,每千张收费仅 0.034 美元。该模型基于 Gemini 3.1 Flash 底层能力进行蒸馏压缩,在保留核心生成质量的同时大幅削减计算开销,相比标准版 Nano Banana 2 延迟更低、成本更便宜,主打高频批量生产与快速迭代场景。目前已取代初代 Nano Ban...
虎牙VAM 1.0 – 虎牙推出的实时多模态数字人基础模型
虎牙VAM 1.0(Vivid Avatar Model)是虎牙公司推出的基于DiT(Diffusion Transformer)架构的实时多模态数字人基础模型。该模型能够在仅提供一张照片的条件下,生成可说话、唱歌、跳舞的AI数字人,并以480×832分辨率、28帧流式输出实现7×24小时实时直播互动。VAM 1.0支持全双工对话、即时打断、弹幕回复与多角色策略游戏,在真实感、身份保持与推理速度上...
Cowart – 开源的本地无限画布插件,让 Codex 看图说话
Cowart是由豆包桌面端产品经理钟二信个人开源的、面向OpenAI Codex的本地无限画布插件。该工具基于tldraw框架构建可视化画布,使Codex能够在本地电子白板上摆放图片、画箭头标注、保留迭代版本,实现了从聊天框改图到画布标注迭代的范式转变。画布数据保存在项目本地目录,支持MCP工具协议,让AI直接“看图说话”,大幅降低空间描述类指令的沟通成本。
Krea 2 – Krea AI 推出首个从零训练的基础图像生成模型
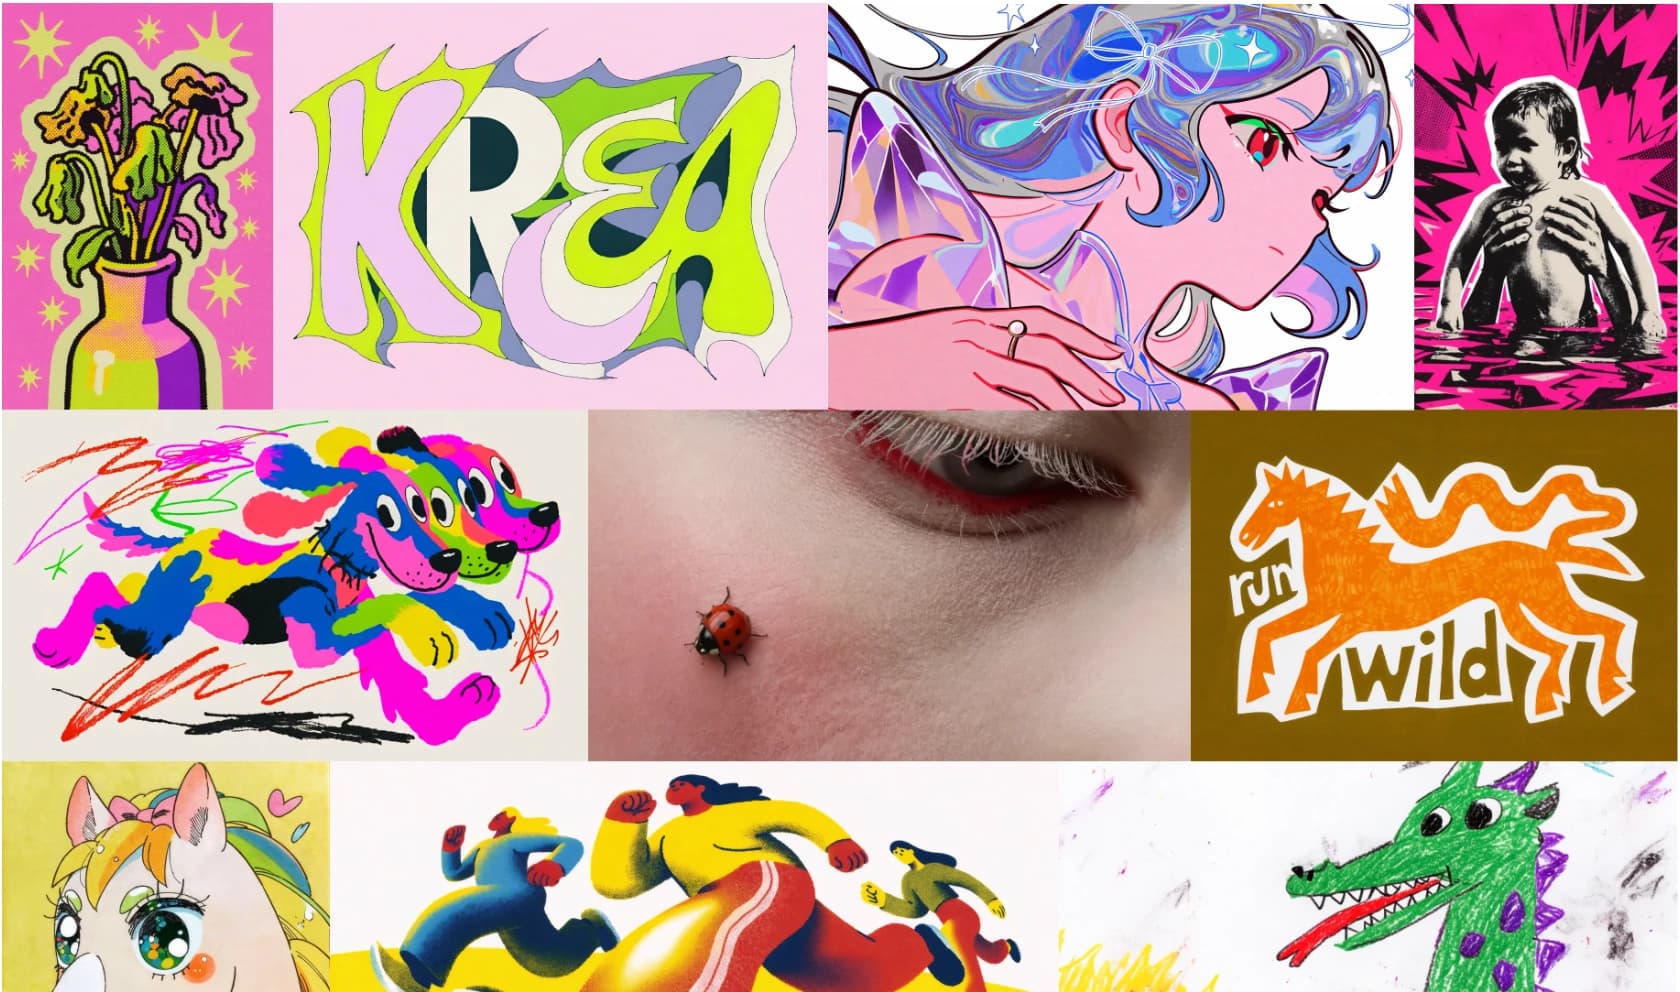
Krea 2 是 Krea AI 推出的首个从零训练的基础图像生成模型,定位为“美学优先”的创意协作者,而非传统的提示词精确翻译器。该模型基于全新的自研架构,从数据筛选、训练策略到推理管线均围绕视觉美学一致性、风格迁移和创意控制进行设计。Krea 2 开源了两个版本:RAW(未蒸馏基础模型,可塑性极强,适合训练 LoRA)和 Turbo(8 步蒸馏模型,约 2 秒出图,支持 1K~2K 分辨率)。...
Boogu-Image-0.1 – Boogu开源的统一图像生成与编辑模型
Boogu-Image-0.1是Boogu团队开源的统一图像生成与编辑模型家族,在同一架构下同时支持文生图、指令式图像编辑及中英双语文本渲染三大核心任务。家族包含Base、Edit和Turbo三个变体,其中Edit变体拥有10B参数,Turbo变体通过蒸馏技术实现3-4步极速推理。在自建的Boogu Arena千级提示词ELO评测中,该系列位列所有参评开源与闭源系统前排,并在Qwen-Image-...
Image-to-LoRA-V2 – 魔搭社区开源的免训练风格迁移工具
Image-to-LoRA-V2(简称i2L-V2)是魔搭社区(ModelScope)旗下DiffSynth-Studio团队开源的免训练风格迁移工具。用户只需上传1至8张风格一致的参考图片,模型通过一次前向推理即可直接预测出文生图模型的LoRA权重,无需任何GPU训练过程。工具原生支持Z-Image、FLUX.2、Hidream-O1三大主流基座模型,在风格保真度、内容一致性及美学质量等多项指标...
EvoQuality – 字节跳动开源的图像质量评估模型
EvoQuality是字节跳动与香港城市大学联合推出的自进化视觉语言模型框架,专注于无参考图像质量评估领域。该模型基于Qwen2.5-VL-7B构建,核心创新在于完全无需人工标注的质量分数或失真标签,通过模型自身的成对比较与多数投票机制生成伪排名标签,再借助GRPO强化学习算法实现多轮迭代自进化。这一技术路线打破了传统IQA模型对大规模人工标注数据的依赖,为图像质量评估领域提供了一种低成本、高性能...
DiffusionGemma – 谷歌开源的实验性文本扩散模型
DiffusionGemma是由Google DeepMind推出的实验性开源文本扩散模型,基于Gemma 4架构与Gemini Diffusion研究成果构建。该模型采用26B参数MoE(混合专家)设计,通过并行去噪256-token文本块的方式,在单张NVIDIA H100上实现超过1000 tokens/秒的生成速度,较传统自回归模型提升约4倍。模型支持双向注意力机制与实时自我纠错能力,量化...