AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
Vidu S1 – 生数科技推出的实时交互视频基础模型
Vidu S1是生数科技推出的全球领先实时交互视频基础模型,标志着AI视频生成从离线批量渲染迈入实时双向互动时代。该模型基于自回归扩散(AR+Diffusion)混合架构,支持540P分辨率、25FPS(最高可达42FPS)的实时视频流式生成,并且可在消费级GPU上运行,大幅降低了部署门槛。用户只需上传一张图片即可零训练创建数字角色,通过语音指令实时驱动角色的表情、口型、手势及全身动作,实现无限时...
video-use – Browser Use 团队开源的 AI 视频剪辑 Agent
Video-use 是由 Browser Use 团队开源的 AI 视频剪辑 Agent,通过自然语言对话替代传统时间线操作,实现从素材盘点、口癖清除、调色、字幕叠加到动画生成的全自动剪辑流程。用户只需将原始素材放入文件夹并描述需求,Agent 即可独立完成成片输出。其核心创新在于让大语言模型(LLM)通过音频转录文本(约 12KB)理解视频内容,而非逐帧分析画面,从而将 token 成本降至极低...
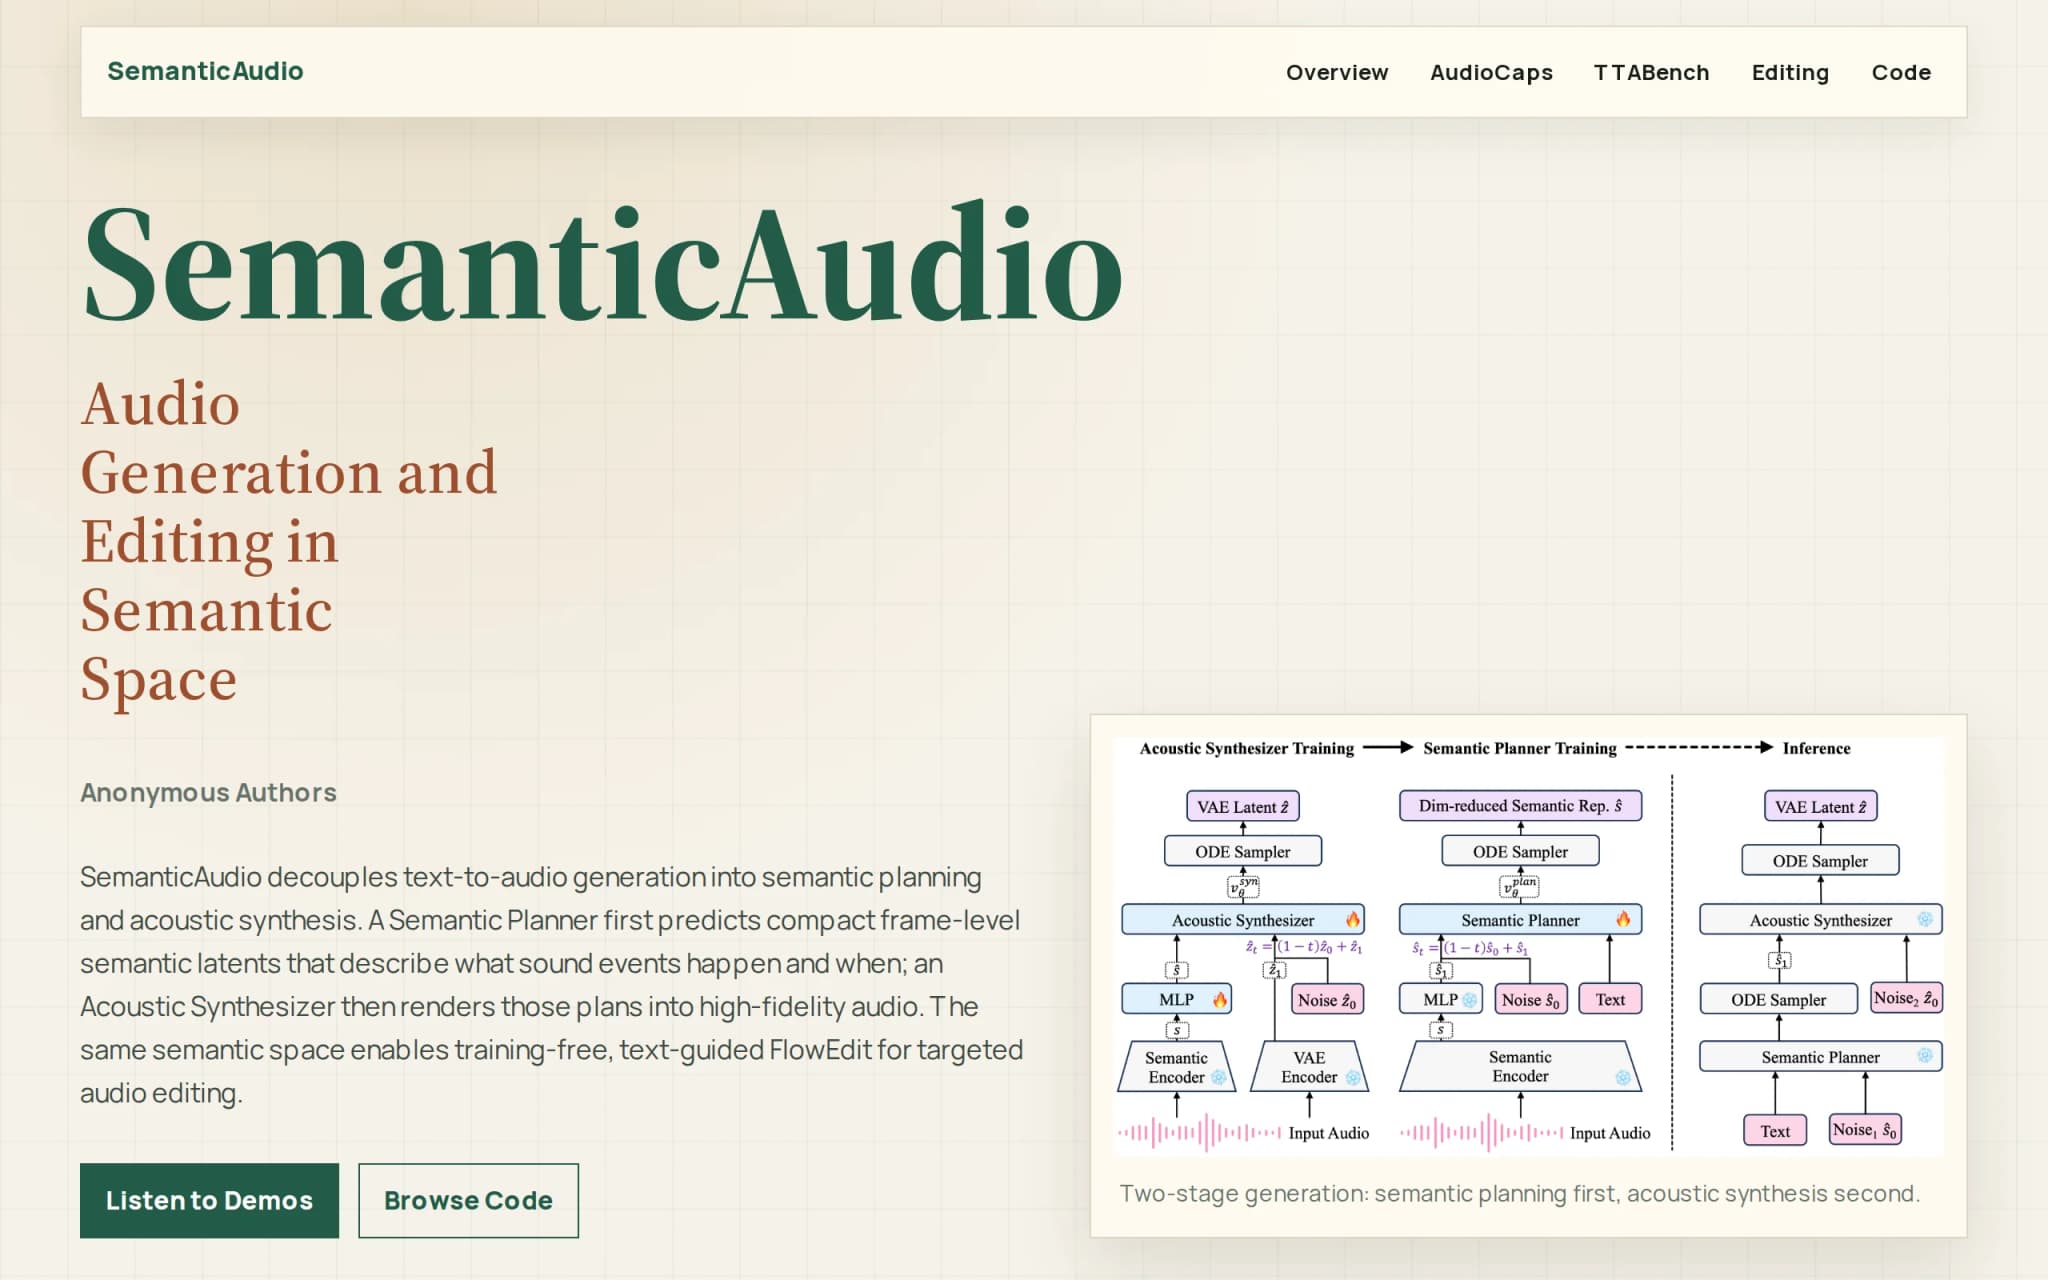
SemanticAudio – 港中文等推出的音频生成与编辑框架
SemanticAudio 是由香港中文大学、LIGHTSPEED 与上海交通大学联合推出的两阶段音频生成与编辑框架。它将文本到音频生成拆解为“语义规划”与“声学合成”两个阶段,先在高层语义空间规划声音事件的身份、时序与结构,再渲染为高质量音频。框架内置 FlowEdit ODE 机制,支持无需训练的文本引导音频编辑,在 AudioCaps 和 TTABench 基准上均显著优于 TangoFlu...
ViiTorVoice – 云上曲率推出的 AI 语音合成模型
ViiTorVoice是由云上曲率推出的全球首款支持局部编辑的AI语音合成模型,基于NAR非自回归架构,登顶Seed-TTS权威评测榜首。它实现了“像改Word一样修语音”——可定向替换音频中的某个词或片段,而其余音色、节奏、情感完全保持不变。该模型还支持无文本跨语种克隆、情绪精准控制及60ms超低延迟推理,1B参数版本已开源,为语音合成领域带来了突破性的交互范式。
WorldCupVoice – 开源的 AI 实时体育解说系统
WorldCupVoice 是一款基于开源理念构建的 AI 实时体育解说系统,通过接入 Agora RTC 直播流,由视觉模型实时分析比赛画面并生成语音解说,再回传至直播间与观众同步收听。系统支持 OpenAI TTS、ElevenLabs 和 Fish Audio 等多语音引擎,可配置英语、法语、中文等多语言解说风格,专为世界杯等大型体育赛事设计,同时兼顾视障用户的无障碍观赛需求,提供球场空间细...

虎牙VAM 1.0 – 虎牙推出的实时多模态数字人基础模型
虎牙VAM 1.0(Vivid Avatar Model)是虎牙公司推出的基于DiT(Diffusion Transformer)架构的实时多模态数字人基础模型。该模型能够在仅提供一张照片的条件下,生成可说话、唱歌、跳舞的AI数字人,并以480×832分辨率、28帧流式输出实现7×24小时实时直播互动。VAM 1.0支持全双工对话、即时打断、弹幕回复与多角色策略游戏,在真实感、身份保持与推理速度上...
Wan-Streamer – 阿里开源的实时全双工多模态基础模型
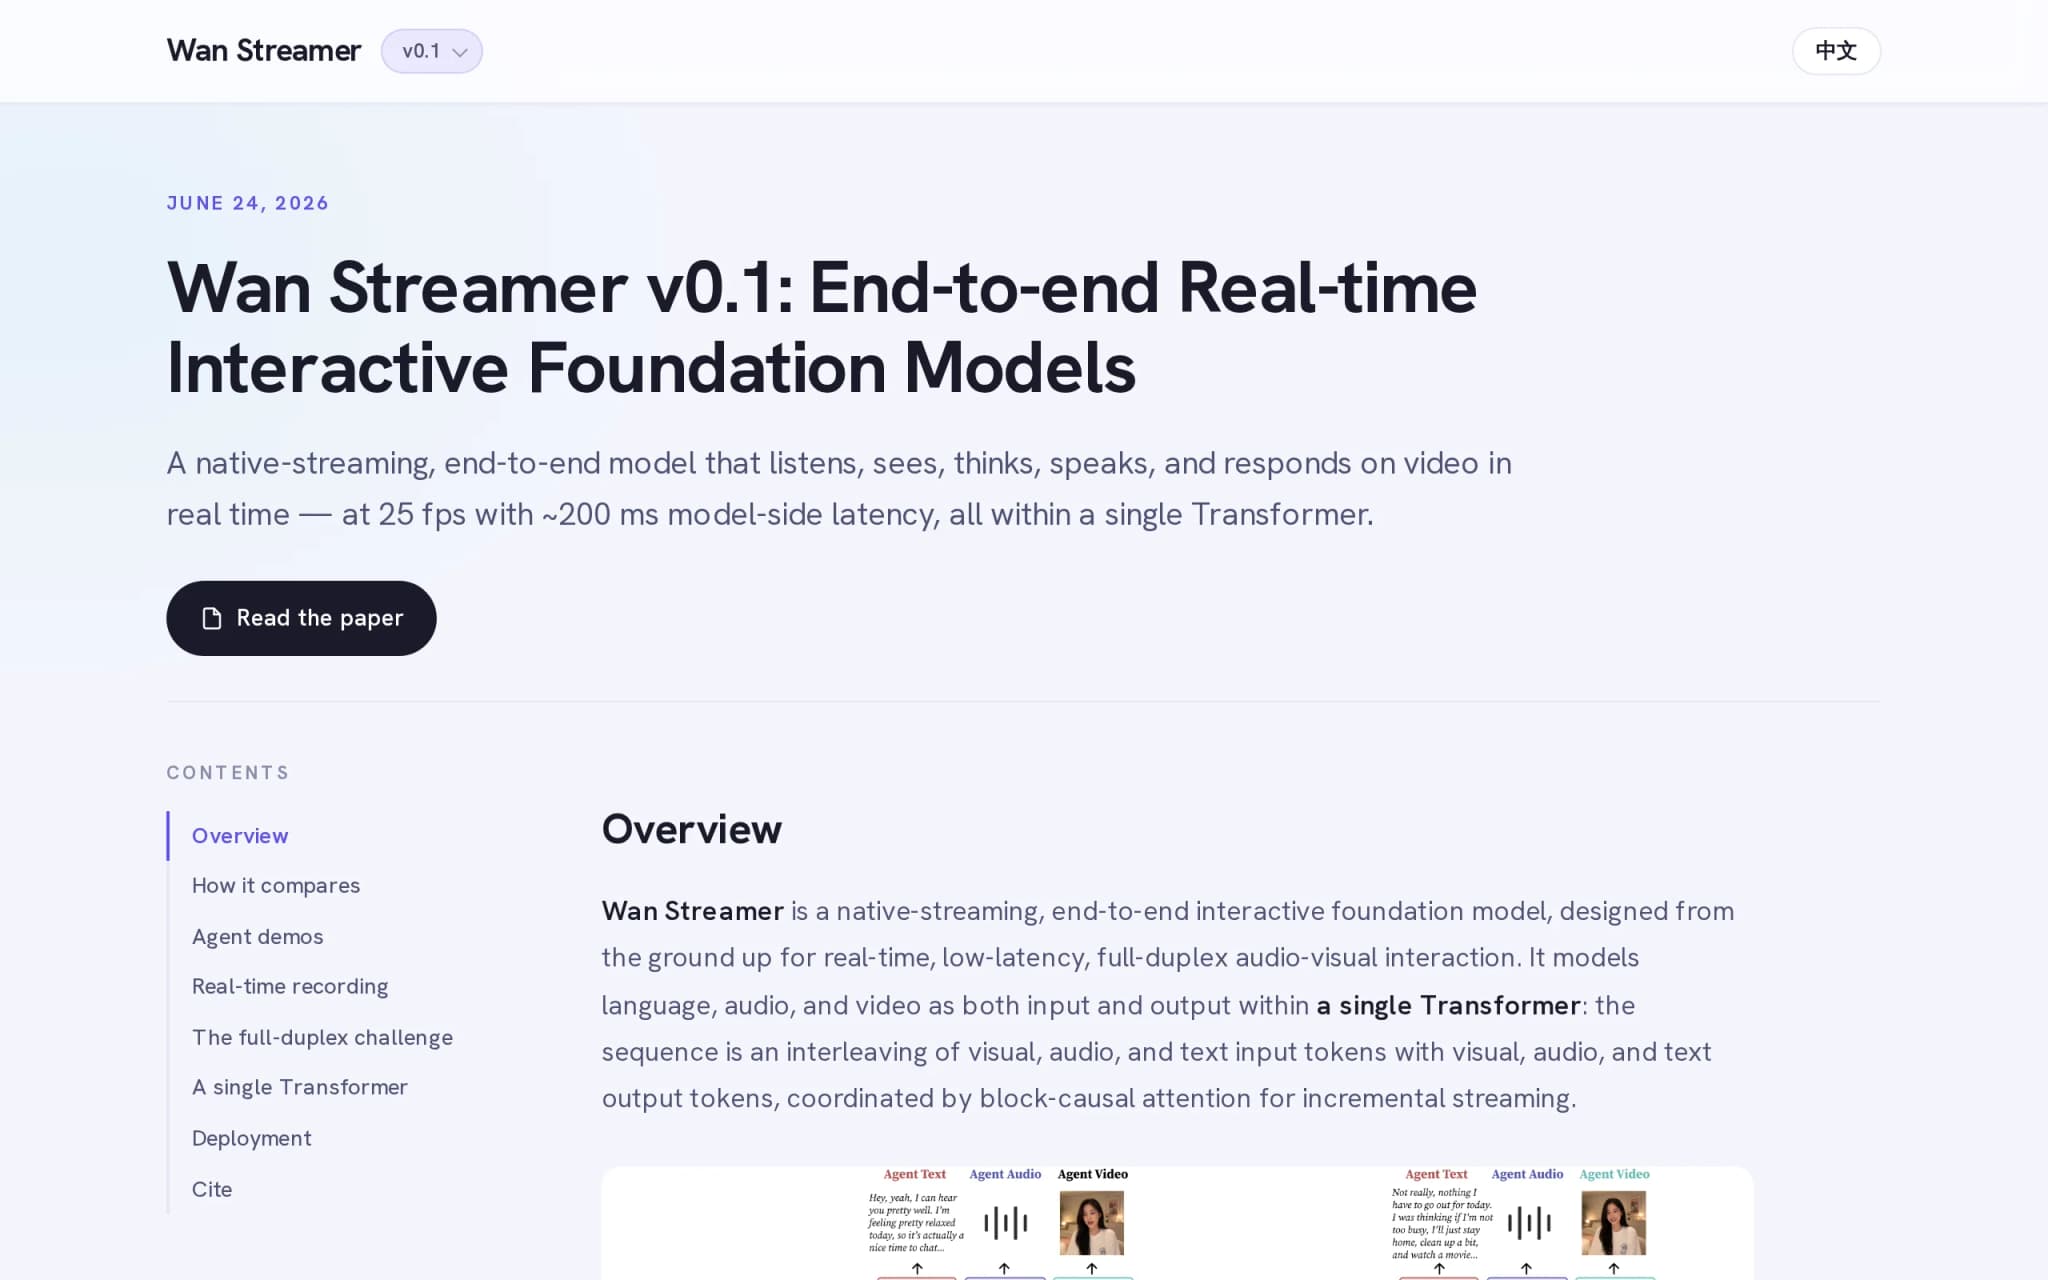
Wan-Streamer 是阿里达摩院开源的端到端实时全双工多模态基础模型,通过统一因果 Transformer 架构将文本、音频、视频的输入输出 token 整合为同一条因果序列,实现亚秒级实时双向视频交互,模型响应延迟仅 200ms,端到端总延迟 550ms,稳定输出 25FPS 同步音视频。该模型摒弃了传统多模块拼接方案(ASR+LLM+TTS+渲染),以单一模型完成感知、理解与生成的全流程...
Xiaomi Miloco 2.0 – 小米开源的全屋智能 AI 方案
Xiaomi Miloco 2.0 是小米基于自研 MiMo-V2.5-Pro 大模型推出的开源全屋智能 AI 方案,通过 OpenClaw 框架以 Agent 形式接入,实现多模态感知、主动智能、持续任务与家庭记忆四大核心能力。该方案旨在将智能家居从传统的被动执行角色,进化为能够主动理解家庭环境与成员需求的智能管家,同时确保原始数据本地保存,隐私安全可控。
VidMuse – Sand.ai 推出的 AI 音乐视频 Agent
VidMuse 是由 Sand.ai 推出的 AI 音乐视频 Agent,旨在将音乐创作与视频生成深度融合。用户只需上传 Suno 链接或本地 MP3 文件,即可自动生成 30–60 秒的高质量音乐视频。其 2.0 版本基于“Video as Code”理念,从固定 Workflow 升级为开放 Agent 框架,能够自主调度计算资源、动态组织分镜与叙事逻辑,目标是成为用户可长期信赖的数字制片团队...
HappyHorse 1.1 – 阿里推出的升级版AI视频生成模型
HappyHorse 1.1是阿里巴巴集团旗下堆友平台最新发布的AI视频生成模型升级版本,在1.0基础上围绕动态表现力、主体一致性、指令遵循、视觉质感和音频能力五大维度实现了系统性升级。该模型延续统一单流Transformer架构,支持文本到视频、图像到视频两种输入方式,单次生成时长3至15秒,输出分辨率涵盖720p与1080p,并支持自由宽高比。其核心技术亮点包括DMD-2蒸馏加速将推理步数压缩...