AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
AudioX-Turbo – Noiz AI 联合清华推出的音频生成框架
AudioX-Turbo 是 Noiz AI 联合香港科技大学、清华大学共同推出的一款统一高效音频生成框架。该框架基于 2.7B 参数的多模态扩散 Transformer 架构,支持文本、视频、音频任意组合输入,能够生成高质量的音效与音乐片段。通过分布匹配蒸馏(DMD)与对抗蒸馏技术,模型将推理步数从传统的 50–200 步压缩至仅 4 步,在单张 RTX 4090 上生成 10 秒音频仅需 0....
Unlimited-OCR – 百度开源的端到端长文档 OCR 模型
Unlimited-OCR是百度推出的端到端长文档OCR模型,通过创新的Reference Sliding Window Attention(R-SWA)机制将解码器KV cache从线性增长压缩为常数,实现单次前向转录数十页文档而无需逐页循环。模型基于3B总参、500M激活的MoE架构,在OmniDocBench v1.6上以93.92%总分取得端到端SOTA,推理速度达5580 TPS,代码与...

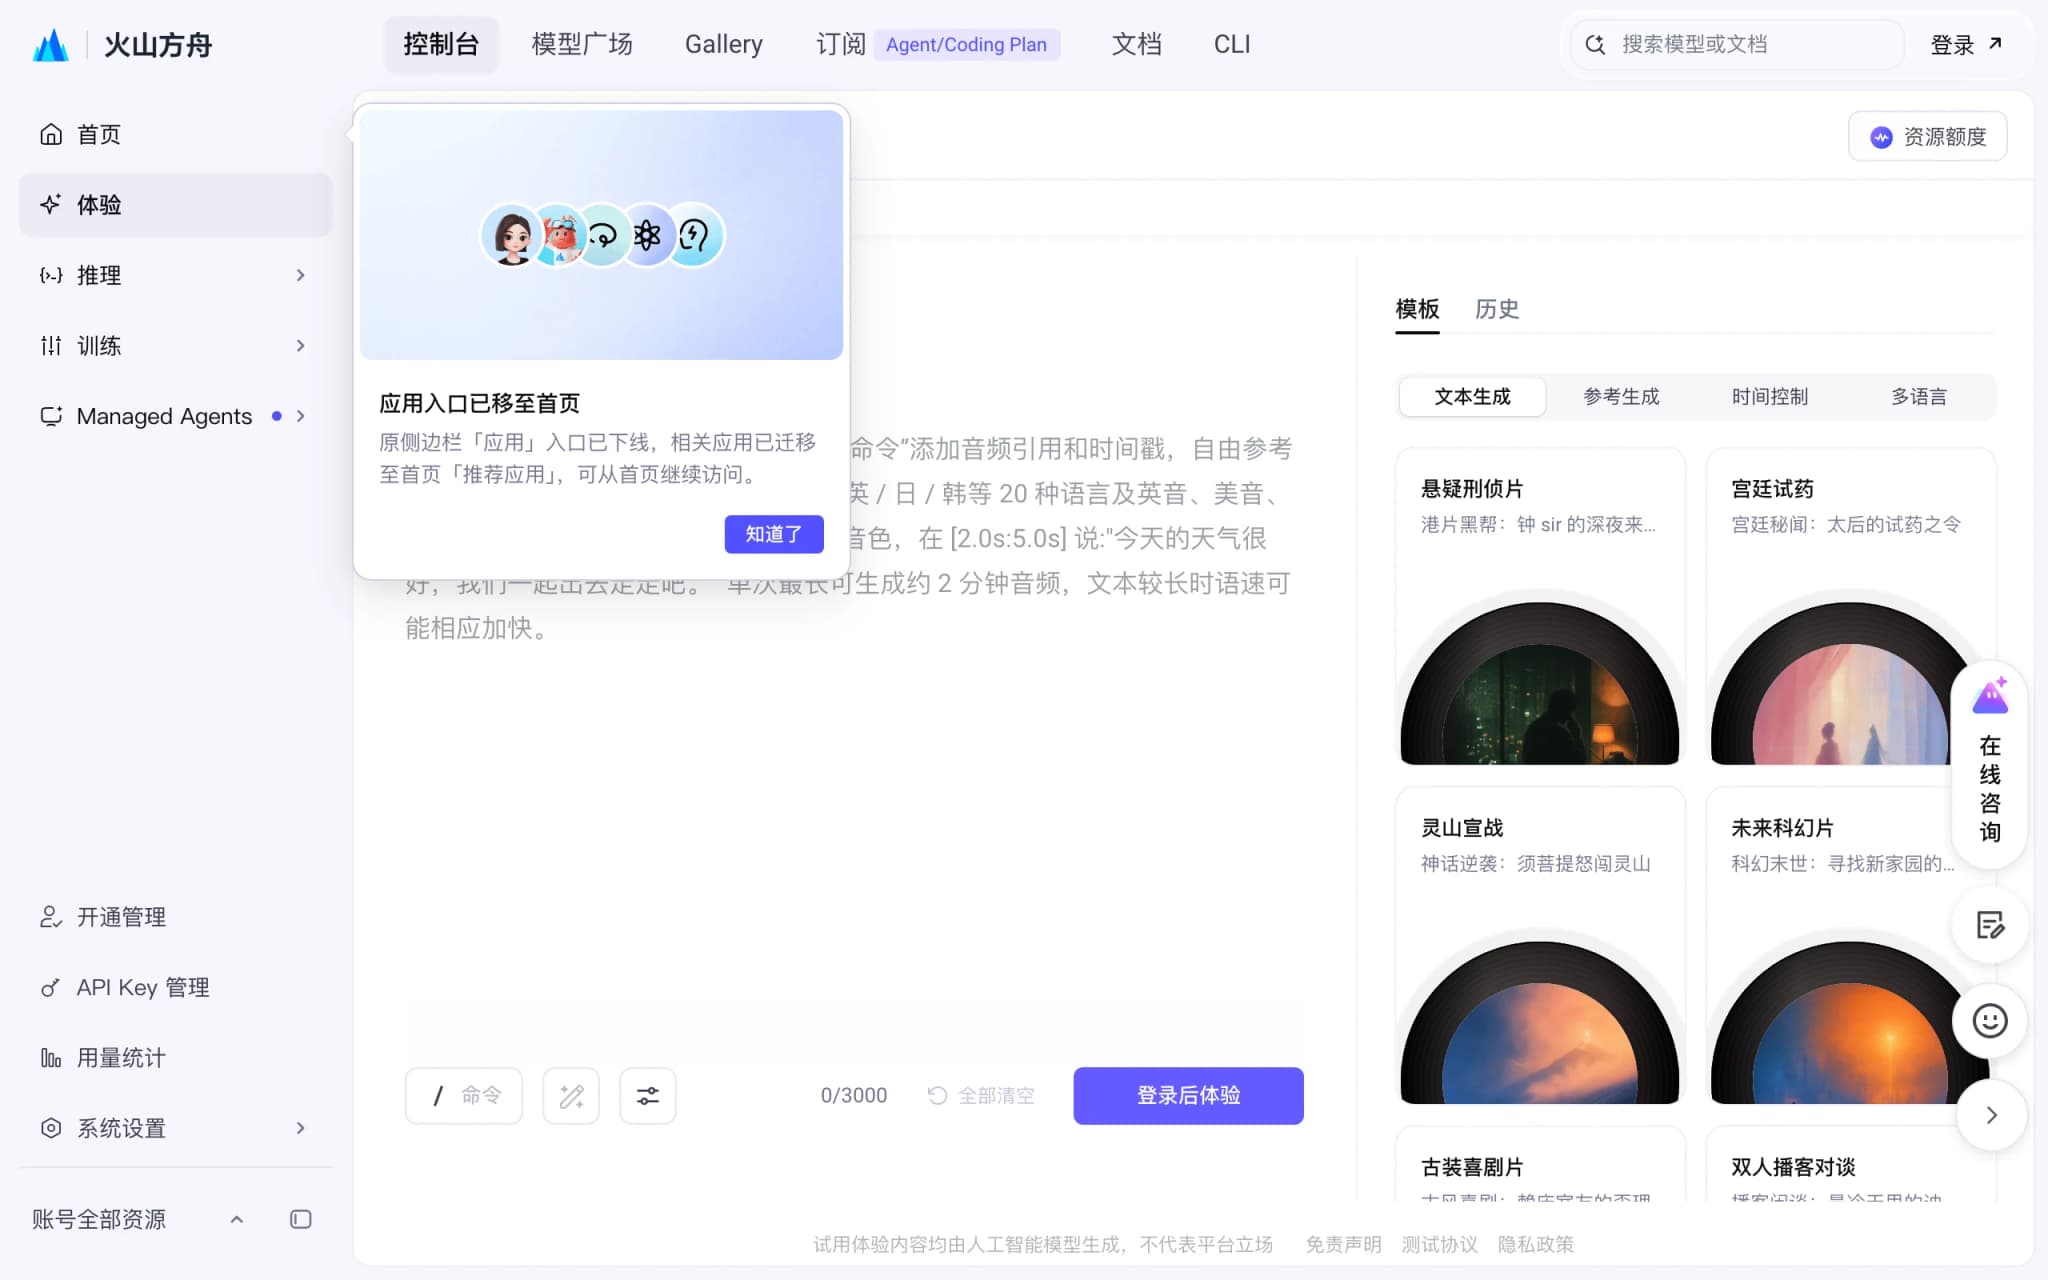
豆包音频生成模型1.0 – 火山引擎推出的端到端音频创作模型
豆包音频生成模型1.0(Seed-Audio 1.0)是火山引擎推出的端到端音频创作模型,支持文本或音频作为参考输入生成目标音频。模型单条Prompt可编排多角色对白、情绪语气、背景音乐与环境氛围,直接产出具备叙事张力的完整音频作品,无需后期多轨混音。模型在长时生成中保持音色高度一致,支持音色与风格解耦控制,覆盖有声剧、播客、品牌音频等场景。
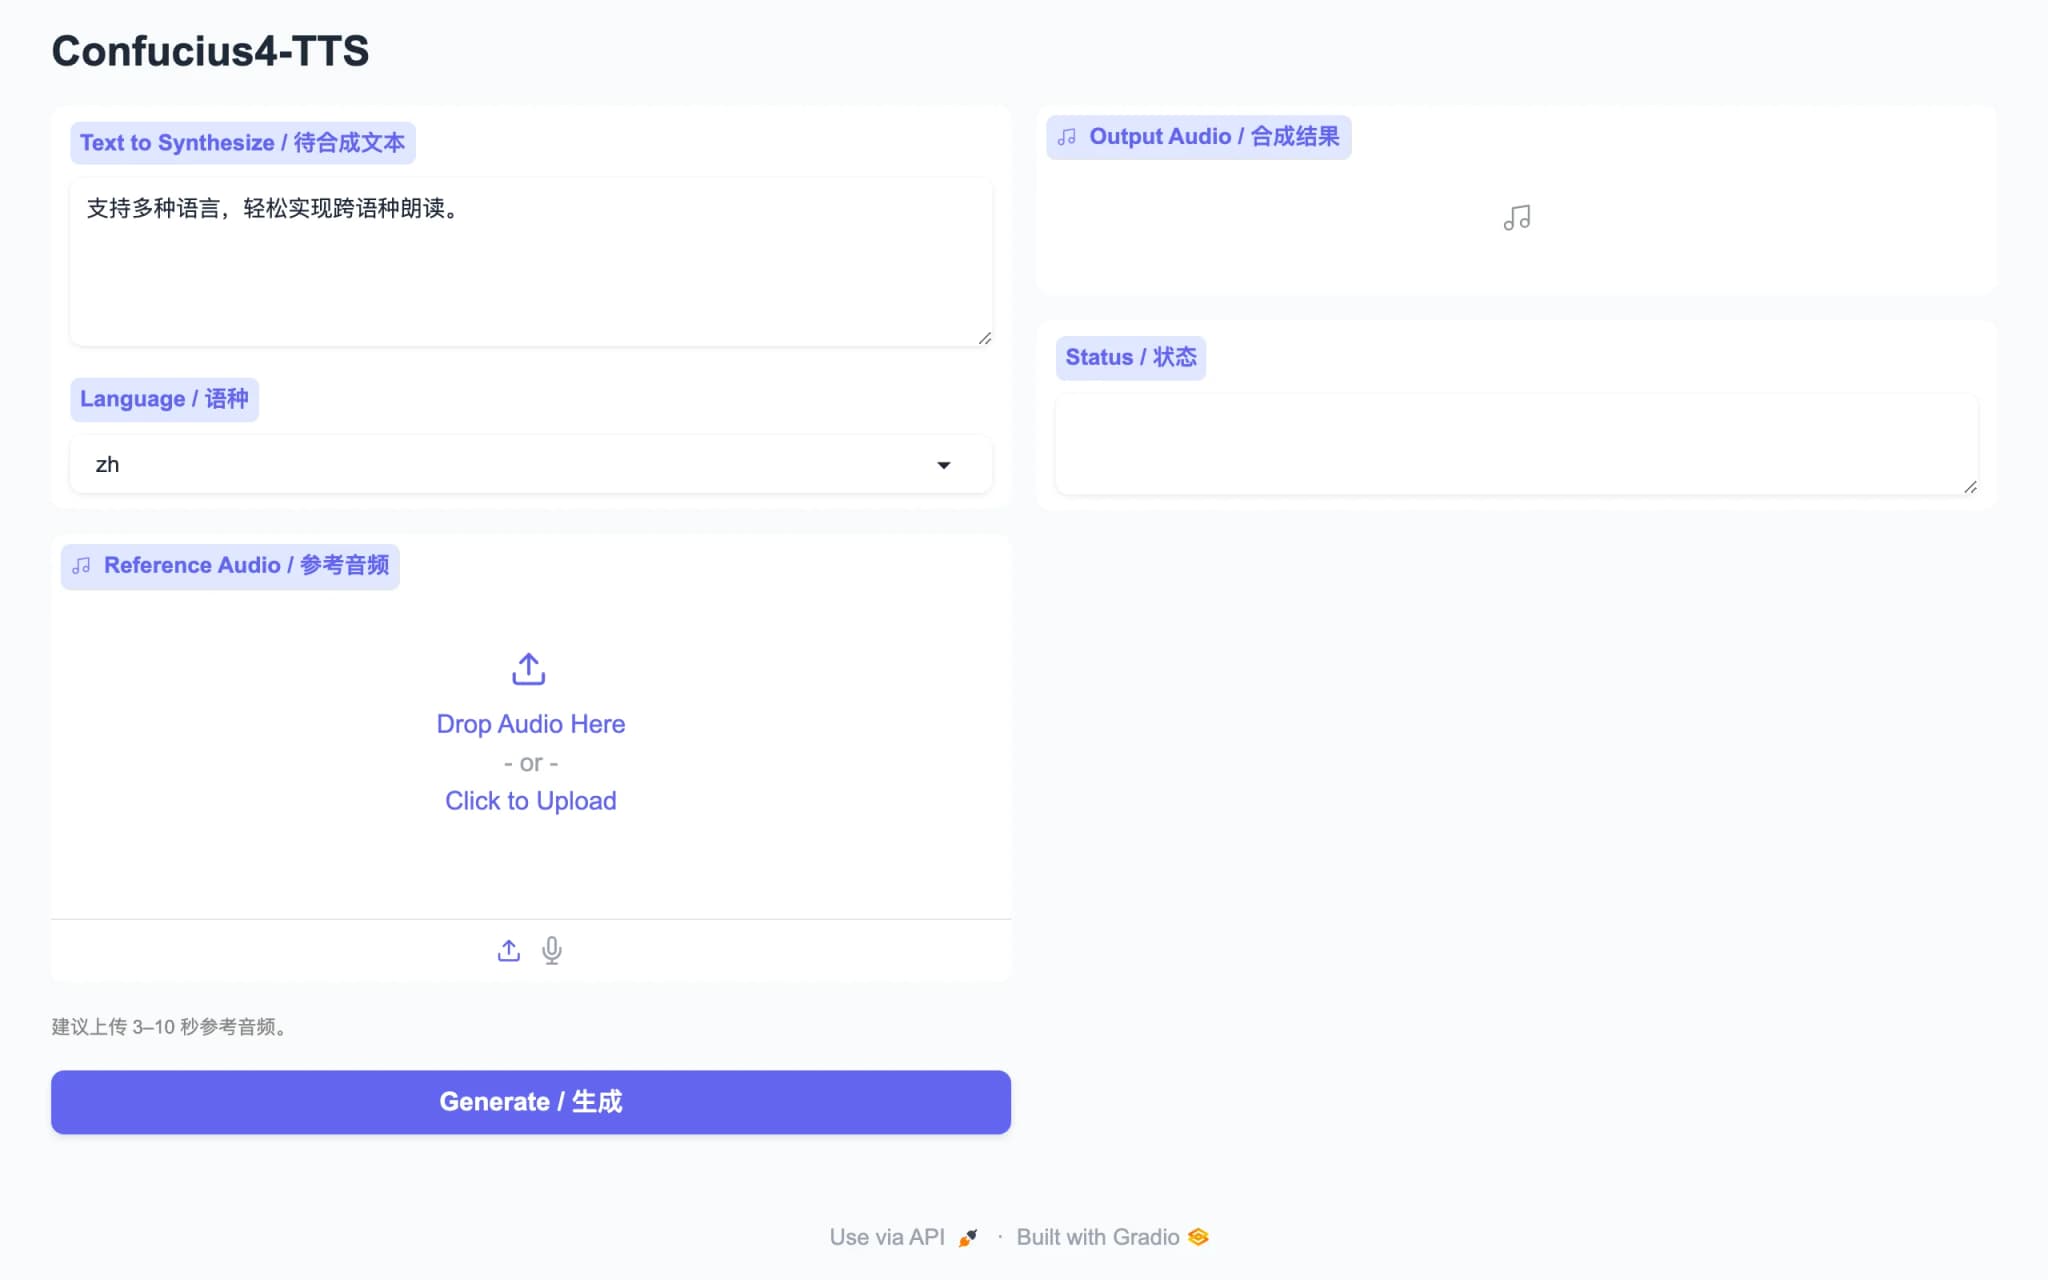
Confucius4-TTS – 网易有道开源的多语言语音合成引擎
Confucius4-TTS 是网易有道开源的 1.3B 参数多语言语音合成引擎,凭借仅需 3 秒参考音频即可实现零样本音色克隆的突破性能力,无需参考文本或转录,并支持中、英、日、韩等 14 种语言的跨语种无口音合成,同时能够迁移情感与韵律。该模型可完全本地部署与训练,适用于数字人配音、出海本地化及多语种内容创作等场景,为语音合成领域提供了高灵活性与低门槛的开源解决方案。
Grok Imagine Video 1.5 – xAI 推出的图生视频模型
Grok Imagine Video 1.5 是由 xAI 推出的新一代图生视频模型,基于自研 Aurora 自回归引擎构建。该模型支持用户上传单张静态图片,通过自然语言提示一键生成带原生同步音频的短视频,最高支持 720p 分辨率。在 Fast 模式下,生成一段 6 秒 720p 视频仅需约 25 秒,显著提升了内容创作效率。模型在 Arena.ai 图生视频榜单中排名第一,Elo 评分约 13...
Hojo-ASR-V1 – Hojo 开源的自动语音识别模型
Hojo-ASR-V1 是由初创团队 Hojo 开源的自动语音识别模型,采用“Whisper 特征提取 + Qwen3-Omni 音频编码 + Conformer 适配 + Qwen3-4B 语言模型解码”的四阶段混合架构。该模型在 LibriSpeech Clean 数据集上词错误率(WER)仅为 1.74%,GigaSpeech 上达到 7.6%,VoxPopuli 上为 7.02%,性能已逼...
MiMo Code – 小米开源的终端 AI 编程助手
MiMo Code 是小米大模型团队基于 OpenCode 框架,采用 MIT 协议开源的新一代终端 AI 编程助手。该工具内置限时免费的 MiMo-V2.5 模型,通过独创的持久记忆系统、Compose 全流程模式以及 Dream 记忆沉淀机制,在 SWE-Bench 和 Terminal Bench 等真实编程测试中表现优于 Claude Code。全面中文汉化、支持语音输入和第三方模型接入的...
SpaceMind – 科大讯飞推出的智慧空间Agentic架构
SpaceMind是科大讯飞推出的智慧空间Agentic架构,它将传统智能家居空间升级为具备感知、理解、记忆、决策与执行能力的L2.5阶段主动智能体。该系统采用毫米波雷达实现隐私感知,并创新性地引入双路由解耦架构,实现了700毫秒内的设备响应与复杂推理分离。通过本地语义模型与云端大模型的协同,SpaceMind能够基于人的位置、状态和习惯主动提供个性化服务,而非被动等待指令。目前,该架构已在中东、...
Khala – 中央音乐学院联合清华开源的 AI 音乐模型
Khala 是由中央音乐学院与清华大学联合研发的开源 AI 音乐大模型,专注于高保真歌曲生成任务。该模型采用 64 层深度声学 Token 层级结构,将声音拆解为极细的离散单位,支持根据文本描述和歌词条件生成包含人声与伴奏的完整歌曲。在人声清晰度、乐器分离度与歌词节奏对齐方面,Khala 达到了开源模型的第一梯队水准,其生成音频在瞬态响应、泛音保留与乐器纹理细腻度上显著优于同类开源方案。项目已公开...
Gemini 3.5 Live Translate – 谷歌推出的最实时翻译模型
Gemini 3.5 Live Translate 是 Google 推出的最新实时语音翻译模型,基于端到端流式架构实现 70+ 种语言的近实时语音到语音翻译。该模型能够连续生成翻译语音,仅延迟数秒,同时保留说话者的语调、节奏和音高特征,输出结果更接近真人对话而非机械朗读。模型通过 Gemini Live API 和 Google AI Studio 向开发者开放预览,并已在 Google Mee...