
Open Code Review – 阿里开源的 AI 代码审查 CLI 工具
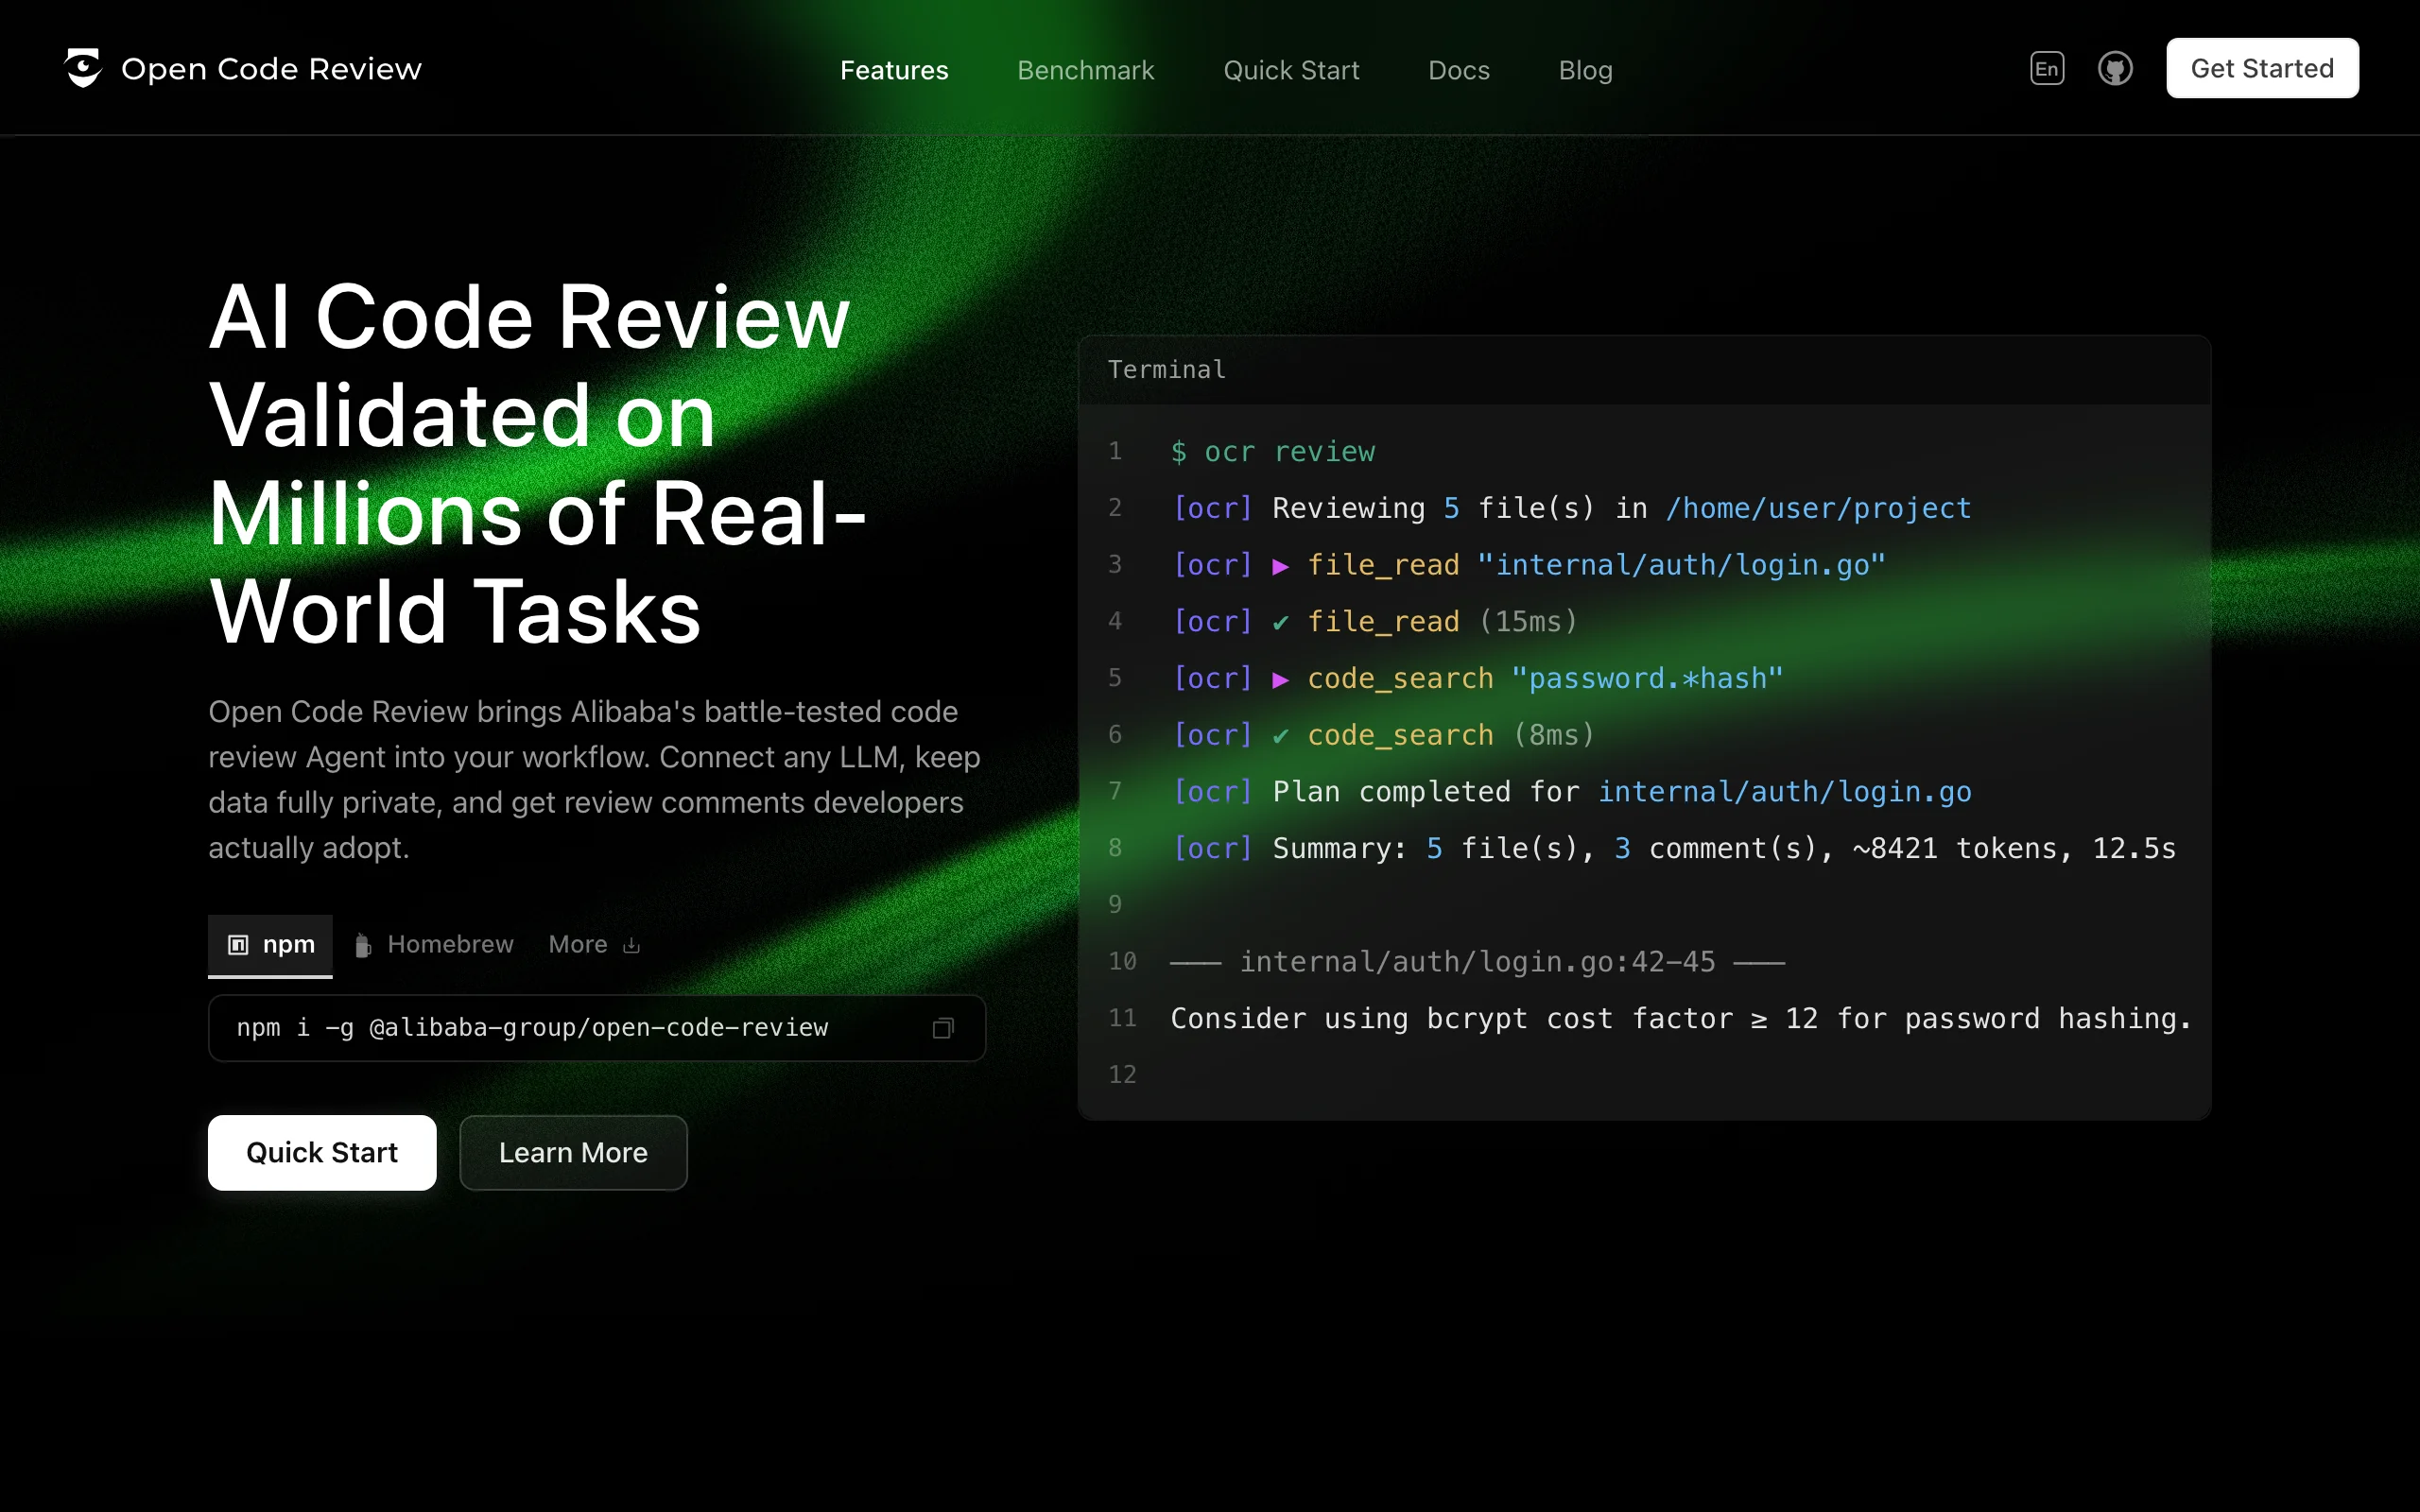
导读摘要:
Open Code Review是阿里巴巴基于其内部生产级实践开源的一款AI代码审查命令行工具,旨在为开发者提供高效、精准且数据私有的代码审查能力。该工具采用“确定性工程 + LLM Agent”的混合架构,突破了传统纯AI审查方案在成本、精度和隐私方面的局限。它支持连接任意大型语言模型(LLM),并在本地环境中完成全部审查流程,确保代码数据不离开私有环境。其内置的覆盖Java、Go、Python等10余种编程语言的审查规则,经过阿里内部20K+活跃用户、超百万次审查任务的验证,Token成本仅为通用Agent方案的1/5,并在AACR-Bench基准测试中取得了26.1%的SEM.F1得分,展现了其在代码审查领域的专业性与实用性。
1. Open Code Review是什么
Open Code Review是阿里巴巴基于其内部生产级实践开源的一款AI代码审查命令行工具,旨在为开发者提供高效、精准且数据私有的代码审查能力。该工具采用“确定性工程 + LLM Agent”的混合架构,突破了传统纯AI审查方案在成本、精度和隐私方面的局限。它支持连接任意大型语言模型(LLM),并在本地环境中完成全部审查流程,确保代码数据不离开私有环境。其内置的覆盖Java、Go、Python等10余种编程语言的审查规则,经过阿里内部20K+活跃用户、超百万次审查任务的验证,Token成本仅为通用Agent方案的1/5,并在AACR-Bench基准测试中取得了26.1%的SEM.F1得分,展现了其在代码审查领域的专业性与实用性。
技术定位与领域: 该工具定位于AI辅助的代码审查(AI Code Review)领域,属于DevOps和软件工程工具链中的关键环节。其独特之处在于,它并非一个简单的LLM封装,而是一个深度结合了确定性算法与LLM推理能力的专业系统,旨在解决通用LLM在代码审查中常见的“行号漂移”、高成本、幻觉等问题,为从个人开发者到大型企业提供可落地的生产级解决方案。
研发背景: 项目源自阿里巴巴内部,其研发动机源于集团内部数万名开发者在日常开发中对高效、低成本代码审查的迫切需求。经过内部超过百万次审查任务的实践检验,团队积累了丰富的经验,最终将这套经过验证的体系开源,旨在推动整个行业代码审查质量的提升,并解决传统SaaS审查方案下的数据隐私和成本问题。
核心价值: Open Code Review的核心价值在于解决了AI代码审查领域“不可能三角”中的部分难题——即同时兼顾高精度、低成本和数据隐私。通过混合架构,它将确定性规则用于任务拆分和定位,将LLM用于深度风险分析,从而在保证审查质量的同时,将Token消耗降至最低。其本地化运行模式,彻底消除了代码外泄的风险,尤其适合金融、电商等对数据安全有严格要求的行业。
技术特点: 其最突出的技术特点是“确定性工程+LLM Agent”的混合架构,实现了任务的高效分解与精准定位。此外,其独创的三层渐进式行级定位模块和智能记忆压缩技术,有效解决了通用Agent方案中常见的幻觉和上下文窗口限制问题,确保了审查结果的专业性和深度。
2. 主要功能
混合架构审查引擎: 这是Open Code Review的核心技术亮点。它并非将整个任务丢给LLM,而是通过确定性工程模块(如静态分析、语法解析)负责任务拆分、文件筛选和行号映射,再将需要深度理解的风险检测、逻辑推理等任务交给LLM Agent。这种分工协作的模式,既利用了确定性方法的高效与精确,又发挥了LLM的语义理解能力,在保证质量的同时,大幅降低了Token消耗和推理延迟。
精确行级评论定位: 针对通用Agent方案常见的“行号漂移”问题,Open Code Review设计了一个独立的三层渐进式LLM定位模块。该模块首先在代码块级别进行匹配,然后逐步缩小到函数、语句层次,最终将每条审查评论精确锚定到具体的代码行号。配合一个独立的反射模块,系统能在早期阶段拦截并修正因模型幻觉或知识漂移导致的错误定位,确保评论的实用性与可信度。
多模型协议支持: 工具原生支持Anthropic Messages API与OpenAI Chat Completions API两大主流协议,这意味着开发者可以无缝接入Claude、GPT-4等主流模型。同时,它也支持连接任何兼容这些协议的自定义模型端点,并能够自动识别Claude Code的环境变量配置,实现了“零配置”接入,极大降低了用户在不同模型间切换的迁移成本。
动态并发处理: 基于Go语言的Goroutine并发模型,Open Code Review能够将大型变更集(如包含几十个文件的Pull Request)动态拆分为多个独立的审查子任务,并并行执行。这种设计使得审查速度不再受限于文件数量或变更规模,即便是超大型代码库,也能在极短时间内完成审查,显著提升了开发者的代码审查体验。
智能记忆压缩: 针对代码审查场景,工具实现了一种创新的三层分区上下文管理策略。它将上下文划分为“冻结区”(如公共接口定义)、“压缩区”(如已审查的相似代码块)和“活跃区”(当前正在审查的代码),根据审查进程动态调整各区域的Token分配。这种机制有效突破了LLM的上下文窗口限制,使得工具能够对包含大量依赖关系的复杂代码进行深度、连贯的审查。
内置审查规则库: 工具内置了一套经过海量真实场景验证的规则库,覆盖了空指针异常(NPE)、线程安全问题、跨站脚本攻击(XSS)、SQL注入等数十种常见的高风险漏洞类型。规则库不仅涵盖了通用安全规范,还针对国内开发团队的常见痛点进行了优化。用户还可以通过定义四层优先级链(阻断、严重、警告、建议)来注入自定义规则,实现审查策略的灵活定制。
3. 如何使用
环境要求与安装: 使用Open Code Review前,需确保系统已安装Node.js(版本要求≥16.x)。安装方式有两种:推荐使用npm全局安装,执行命令
npm i -g @alibaba-group/open-code-review;或者,可以从项目的GitHub Releases页面下载对应操作系统(如Linux、macOS、Windows)的预编译二进制文件,解压后即可使用。配置LLM模型: 安装完成后,首次使用需要配置LLM端点。运行
ocr config set命令,根据提示依次设置LLM的API端点URL、API Token以及模型名称(例如claude-3-5-sonnet-20241022或gpt-4o)。如果用户已经配置了Claude Code的环境变量(如ANTHROPIC_API_KEY),工具会自动识别并跳过此配置步骤,实现零配置兼容。验证连通性: 配置完成后,建议先执行
ocr llm test命令来验证模型连接是否正常。该命令会向配置的LLM发送一个简单的测试请求,并返回连接状态和模型响应时间,确保后续审查流程能够顺利进行。执行代码审查: 核心审查命令是
ocr review。默认情况下,它会对当前工作区中所有未提交的变更进行审查。如果需要审查特定分支间的差异,可使用ocr review --from main --to feature;若要审查单个历史提交,则使用ocr review --commit abc123。审查结果会以清晰的格式输出到终端,包括风险等级、问题描述和精确的行号定位。集成至CI/CD流水线: 为了最大化其价值,建议将Open Code Review集成到持续集成/持续部署(CI/CD)流程中。例如,在GitHub Actions或GitLab CI中,可以通过
ocr review --format json命令输出结构化的JSON结果,并将其作为检查项,阻止带有高风险问题的代码合并。工具可作为Claude Code的Skill或Plugin接入,实现更智能的开发辅助。阅读审查输出: 终端输出会按风险等级(阻断/严重/警告/建议)列出问题描述、文件路径和精确行号。可先处理阻断项,再用
--format json把结果交给脚本做趋势统计或自动开 Issue。限定审查范围: 大型仓库可用
.ocrignore或命令行路径参数跳过生成代码、第三方依赖和二进制资源,避免把 Token 花在无意义文件上。审查前先git diff --stat确认变更集符合预期。日常工作流建议: 本地提交前跑一遍
ocr review,合并前再在 CI 中跑一遍 JSON 门禁。规则库可按团队安全基线逐步收紧,不必第一次就把自定义规则写到最严。
4. 优缺点分析
| 优点 |
|---|
| 生产级验证与高采纳率: 源自阿里巴巴内部20K+活跃用户、超百万次审查任务的生产级实践,采纳率超过30%,证明其审查建议具有极高的实用价值和可信度。 |
| 极致的成本控制: 通过混合架构和智能上下文管理,其Token消耗仅为通用Agent+Skills方案的1/5。对于需要频繁审查大规模代码库的团队,这可以带来显著的成本节约。 |
| 数据完全私有化: 代码在本地运行,无需上传至任何第三方云端。这对于金融、电商、政务等对数据安全和合规性有极高要求的企业来说,是决定性的优势。 |
| 精准的行级定位: 独立的三层渐进式定位模块,有效解决了通用AI审查方案中常见的“行号漂移”问题,使得审查建议可以直接指导开发者进行修改,极大提升了修复效率。 |
5. 同类工具对比
| 维度 | Open Code Review | CodeRabbit | GitHub Copilot Code Review |
|---|---|---|---|
| 核心架构 | 确定性工程 + LLM Agent 混合架构 | LLM + 40+ 开源 Linter 聚合分析 | LLM 基于 Git Diff 分析 |
| 部署方式 | 本地运行 / 任意CI集成 | 云端SaaS服务 | GitHub云端 / Self-hosted Runners |
| 数据隐私 | 代码完全不出本地,私有环境运行 | 代码上传至云端分析 | 代码在GitHub基础设施内处理 |
| 成本模型 | 仅LLM Token费用(约为通用方案1/5) | Free tier / Pro $24/人/月 / Enterprise定制 | 捆绑Copilot Business/Enterprise |
| 支持平台 | 任意Git平台 | GitHub / GitLab / Bitbucket / Azure DevOps | 仅GitHub |
| AI架构 | 确定性工程 + LLM Agent 混合架构 | LLM + 40+ 开源 Linter 聚合分析 | LLM 基于 Diff 分析 |
选型建议:
对于对数据隐私有严格要求的金融、电商或政府机构,Open Code Review是唯一能够保证代码完全不离开本地环境的选项。其混合架构带来的低成本优势,也使其成为大规模团队进行日常审查的性价比之选。而CodeRabbit和GitHub Copilot Code Review则更适合那些追求开箱即用、团队规模较小、且对数据隐私要求不高的初创公司或个人开发者,它们提供了更便捷的SaaS化体验。
对于深度依赖AWS生态的团队,Amazon CodeGuru的深度集成和性能分析能力是独特优势。然而,如果需要审查非AWS平台的代码,或希望拥有更高的灵活性和成本控制能力,Open Code Review的开源特性和本地化部署则更具吸引力。总体而言,Open Code Review在专业度、成本控制和数据隐私方面建立了显著的差异化优势。
6. 编辑点评
从技术创新的角度看,Open Code Review最值得称道的是其“确定性工程+LLM Agent”的混合架构。这并非简单的“套壳”产品,而是针对代码审查这一特定场景进行的深度架构优化。它巧妙地将静态分析、语法解析等确定性算法的精确性,与LLM的语义理解能力相结合,不仅解决了通用Agent方案成本高、定位不准的痛点,也为AI在专业工具链中的应用提供了一个优秀的范式。其智能记忆压缩和三层渐进式定位模块,更是从工程层面解决了LLM的固有缺陷,体现了阿里团队深厚的技术功底。
在实用价值方面,该工具定位清晰,直击企业级代码审查的三大痛点:成本、隐私和精度。对于大型团队,其成本优势是巨大的,能够将AI审查的日常运行成本降低一个数量级。对于金融、政务等敏感行业,数据私有化是硬性要求,Open Code Review几乎是目前唯一可行的AI审查开源方案。其生产级验证背景(阿里内部20K+用户)也为其可靠性提供了有力背书。
该工具主要面向中大型开发团队、DevOps平台团队、以及对代码质量和安全有高要求的金融、电商企业。对于个人开发者或小型初创团队,如果对成本不敏感且追求极致便捷,SaaS方案可能更合适。但Open Code Review的开源特性也使得它成为RL训练管道中代码质量验证器的绝佳选择,为AI代码生成模型提供可靠的奖励信号。
展望未来,该项目有巨大的发展潜力。随着社区贡献的增加,其内置规则库有望覆盖更多语言和漏洞类型。如果能进一步开发出IDE插件,将大幅降低其使用门槛,吸引更广泛的用户群体。此外,作为开源项目,其与不同CI/CD系统的深度集成和生态建设将是决定其能否成为行业标准的关键。
推荐指数:★★★★☆(4.5/5星)
评分依据: 扣去的0.5星主要源于其初始学习曲线和对非Git工作流的支持有限。但瑕不掩瑜,其在技术创新、成本控制、数据隐私和实用性方面的卓越表现,使其成为当前AI代码审查领域最具竞争力的开源方案之一。
7. 应用场景
个人开发者本地自检: 开发者在提交代码前,可运行
ocr review命令对工作区的未提交变更进行快速审查。这相当于一个智能的“预检”环节,能够及时发现潜在的逻辑错误、安全问题或代码异味,有效减少因疏忽导致的线上事故,并提升代码提交的质量。平台团队集成至内部DevOps: 企业内部DevOps平台团队可将Open Code Review作为一项强制检查步骤,集成到代码合并(Merge Request / Pull Request)流程中。通过统一配置审查规则和优先级,可以实现全团队的代码审查策略标准化,并统一收集和分析审查数据,为团队的技术改进提供数据支撑。
ML研究员作为RL训练验证器: 在强化学习(RL)训练代码生成模型(如CodeRL)的管道中,Open Code Review可以作为代码质量验证器。它能为模型生成的代码提供结构化的、多维度的质量反馈信号(如是否存在NPE、线程安全风险等),从而引导模型生成更健壮、更安全的代码,提升模型的实用价值。
金融/电商企业安全合规: 在金融、电商等对数据安全有极高要求的企业中,代码通常需要在隔离的内网环境中开发。Open Code Review的本地运行特性,使得这些企业能够在完全离线的环境中,依然享受到AI驱动的代码审查能力,满足严格的安全合规要求,同时提升代码质量。
开源项目维护者自动化审查PR: 对于维护者精力有限的开源项目,可以通过GitHub Actions等CI工具配置Open Code Review。当社区贡献者提交Pull Request时,工具会自动触发审查,并给出结构化的评论。这能显著降低维护者的手动审查负担,同时为贡献者提供即时、专业的反馈,提升协作效率。
8. 常见问题FAQ
Q:Open Code Review是否支持我自己的私有化LLM模型(如部署在内部的Llama 3)?
A:是的,完全支持。只要您的私有化LLM模型提供了兼容OpenAI Chat Completions API或Anthropic Messages API的端点,您就可以通过 ocr config set 命令配置该端点、Token和模型名称,从而在完全内部化的环境中运行Open Code Review。
Q:对于非常大的代码仓库(如包含数千个文件),审查速度会慢吗?
A:不会。Open Code Review基于Go语言的Goroutine实现了动态并发处理。它会自动将大型变更集拆分为多个子任务并行审查。审查速度主要受限于您配置的LLM API的响应速度,而非代码库的大小。对于超大型仓库,其并发架构反而能带来更快的审查体验。
Q:Open Code Review和传统的Linter(如ESLint、Pylint)有什么区别?
A:传统Linter主要基于预定义的静态规则进行模式匹配,擅长检测语法错误和编码风格问题。而Open Code Review的混合架构使其能通过LLM进行更深层次的语义分析,例如检测复杂的逻辑漏洞、并发安全问题、业务逻辑正确性等。它是对传统Linter的补充,而非替代。
Q:如何将Open Code Review集成到我的GitHub Actions工作流中?
A:您可以在GitHub Actions的YAML配置文件中添加一个步骤,使用 npm i -g @alibaba-group/open-code-review 安装工具,然后执行 ocr review --format json 命令。您可以进一步配置,根据JSON输出中的风险等级来决定是否阻止PR合并。
Q:如果我配置了多个不同的LLM模型,能否在不同项目或场景下切换使用?
A:目前工具主要通过 ocr config set 进行全局配置。如果您需要为不同项目使用不同模型,建议使用环境变量或为每个项目创建一个独立的配置文件(该功能可能通过后续版本或社区贡献实现)。当前最直接的方式是在执行审查前,手动修改配置文件或环境变量来切换模型。
9. 项目地址
相关推荐
Agents-A1 – 上海 AI Lab开源的混合专家智能体模型
Agents-A1是由上海人工智能实验室(上海AI Lab)开源的35B参数混合专家(MoE)智能体模型,专为复杂科研长程任务设计。该模型通过知识-行动图谱(KAG)构建可验证长轨迹基础设施,并采用三阶段多专家蒸馏训练,突破了大模型依赖海量参数实现复杂推理的局限。在长程搜索、科学推理、指令遵循等基准上,Agents-A1以35B参数实现了比肩甚至超越万亿参数模型的性能。
LingBot-VA 2.0 – 蚂蚁灵波推出的具身原生世界动作模型
LingBot-VA 2.0是蚂蚁灵波推出的行业首个具身原生世界动作模型,基于自回归架构从零预训练,使机器人具备“边推演、边行动”的通用控制能力。模型采用因果DiT与稀疏MoE架构,总参数15.3B但推理仅激活2.5B,在RoboTwin 2.0基准上实现93.6%的双臂任务成功率,单GPU推理速度达到150Hz,异步模式下可达225Hz。该模型从架构设计、数据采集到训练目标均为物理世界量身定制,...
KAT-Coder-Pro V2.5 – 快手推出的 Agentic Coding 模型
KAT-Coder-Pro V2.5是快手KwaiKAT推出的旗舰级Agentic Coding模型,专注于长程工程能力与通用Agentic能力。通过自研AutoBuilder将真实仓库环境构建成功率从16.5%提升至57.2%,沉淀超10万个可运行仓库;并建设KwaiClawEnv通用Agentic训练体系,结合多框架强化学习与MOPD多专家融合技术。模型在SWE-Bench Pro取得65.2...
LingBot-VLA 2.0 – 蚂蚁灵波开源的一代具身智能基座模型
LingBot-VLA 2.0是蚂蚁灵波科技(Robbyant)开源的新一代具身智能基座模型,基于6万小时大规模预训练数据(含5万小时真机操作和1万小时人类操作视频),覆盖17个品牌20种机器人构型,支持单臂/双臂、双足/轮式及头部、腰部、底盘等多自由度控制。模型采用稀疏MoE架构(1.6B总参数,0.6B激活参数)与统一动作空间表示,在GM-100双臂评测和长程移动操作任务中均超越π0.5与GR...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。