
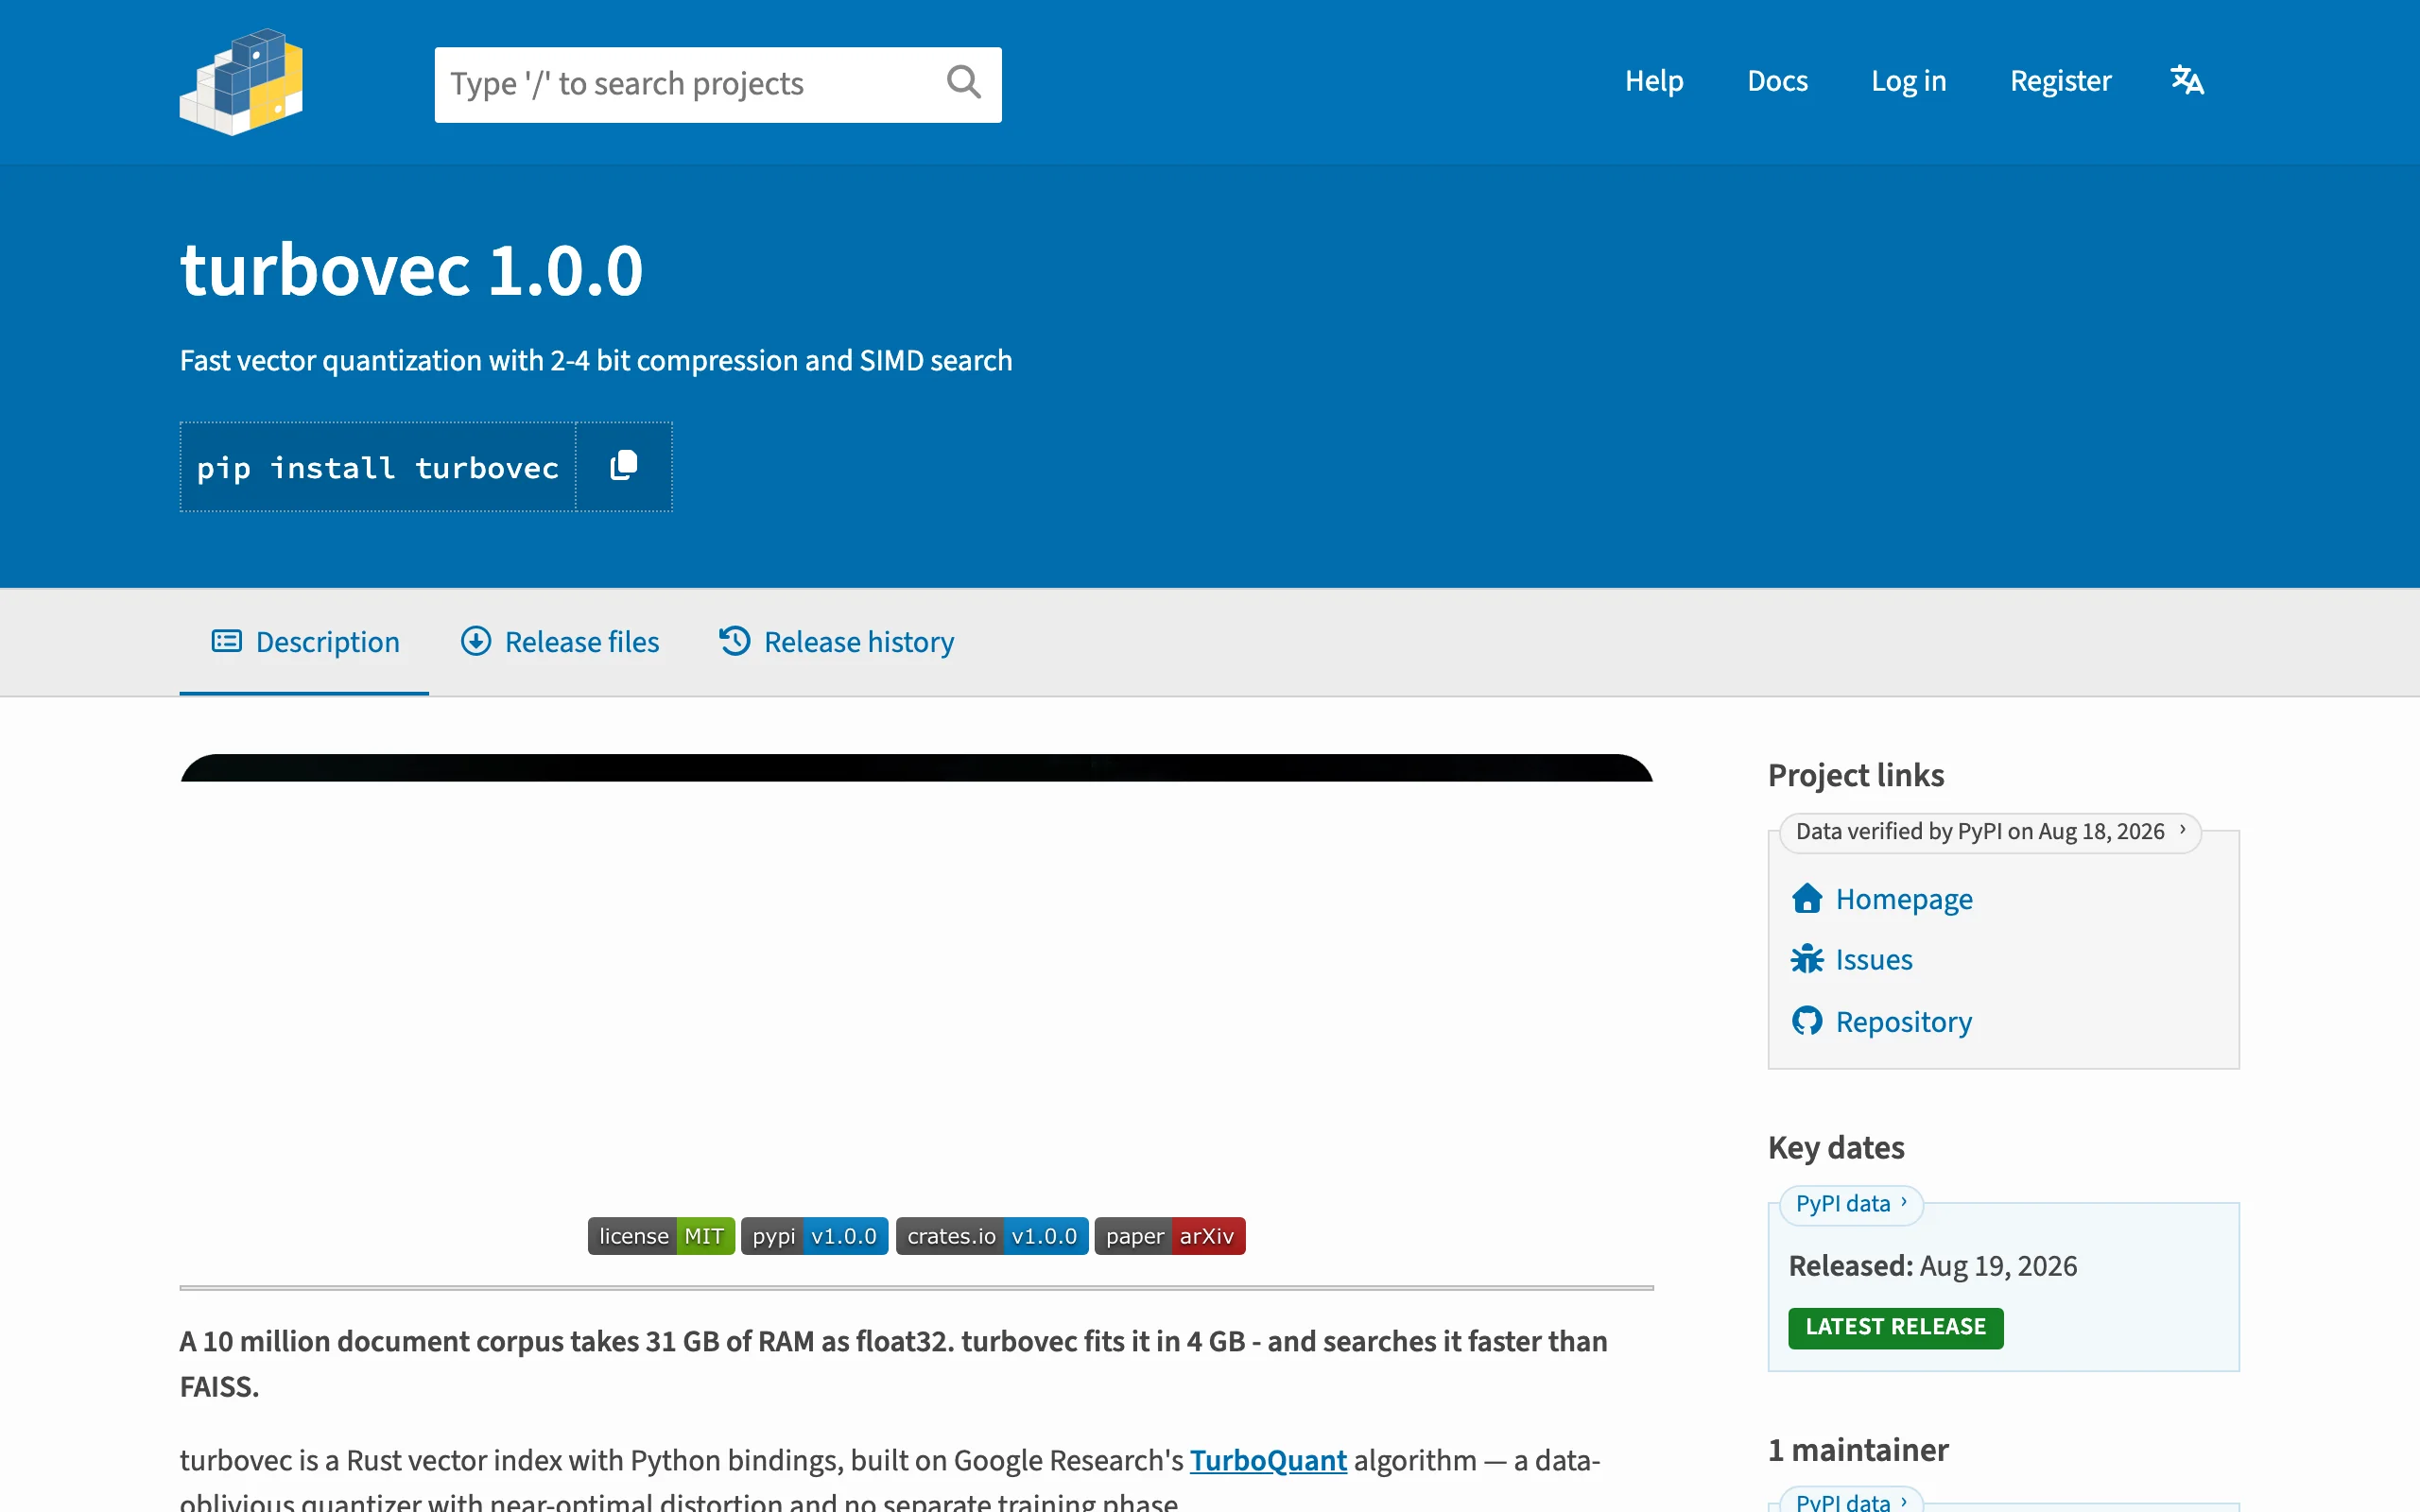
turbovec – 谷歌开源的向量索引算法
导读摘要:
turbovec是由Google Research开源的高性能向量索引库,实现了其TurboQuant算法。该库采用Rust编写并附带Python绑定,专为RAG场景设计。其核心优势在于数据无关的量化策略,无需训练即可将1000万条float32向量从31GB压缩至约4GB,并在ARM和x86平台上通过手写SIMD内核实现比FAISS更快的搜索速度。此外,turbovec支持搜索时过滤、索引持久化以及主流框架的即插即用替换,为内存敏感和低延迟的向量检索需求提供了高效解决方案。
1. turbovec是什么
turbovec是由Google Research开源的高性能向量索引库,实现了其TurboQuant算法。该库采用Rust编写并附带Python绑定,专为RAG场景设计。其核心优势在于数据无关的量化策略,无需训练即可将1000万条float32向量从31GB压缩至约4GB,并在ARM和x86平台上通过手写SIMD内核实现比FAISS更快的搜索速度。此外,turbovec支持搜索时过滤、索引持久化以及主流框架的即插即用替换,为内存敏感和低延迟的向量检索需求提供了高效解决方案。
技术定位与领域: turbovec属于向量索引与近似最近邻搜索(ANNS)领域,专注于为检索增强生成(RAG)系统提供高性能、低内存占用的向量存储与检索能力。其独特之处在于采用数据无关的量化方法,无需训练阶段,区别于传统基于训练码本的量化索引。
研发背景: turbovec由Google Research团队基于其TurboQuant算法开发并开源,旨在解决大规模向量索引中训练开销大、压缩率与速度难以兼得的问题。团队在量化理论及SIMD优化方面有深厚积累,该开源项目为社区提供了可直接部署的高效工具。
核心价值: turbovec解决了传统向量索引(如FAISS)需要耗时的k-means训练、内存占用高、搜索时过滤效率低等痛点。其在线摄入机制允许向量添加后立即搜索,无需参数调优或重建索引;16倍压缩率使千万级向量可在普通服务器上运行;纯本地运行保障数据隐私。
技术特点: turbovec的核心技术包括随机正交旋转、TQ+自适应校准、Lloyd-Max标量量化及位打包,实现无训练、高压缩、低失真。手写NEON和AVX-512BW SIMD内核在ARM上比FAISS IndexPQFastScan快10-19%,在x86上4-bit配置胜出。搜索时过滤在SIMD内核内直接短路,避免过度抓取,零召回损失。
2. 主要功能
在线摄入索引: 向量添加后立即自动完成索引构建,无需预先训练、参数调优或语料库增长时重建。这一机制基于数据无关的量化策略,使得索引始终处于最新状态,特别适合动态变化的数据集。
快速SIMD搜索: 手写NEON(ARM)和AVX-512BW(x86)SIMD内核,在ARM平台上搜索速度比FAISS IndexPQFastScan快10-19%,在x86上4-bit配置全面胜出。通过位打包和预计算最优量化桶,实现了极低的搜索延迟。
搜索时过滤: 支持传入ID白名单或槽位位掩码,过滤逻辑在SIMD内核内直接短路,无需先检索全部结果再过滤,避免了过度抓取和召回损失。这一特性对于权限过滤和混合检索场景尤为重要。
稳定外部ID与删除: 通过IdMapIndex支持自定义uint64外部ID,并提供O(1)时间复杂度的按ID删除操作。这使得用户能够维护稳定的文档标识,便于数据更新和管理。
索引持久化: 支持write保存到磁盘和load快速恢复,无需重新编码向量。索引文件格式紧凑,加载速度极快,适合生产环境的冷启动和容灾恢复。
框架即插即用: 提供LangChain、LlamaIndex、Haystack、Agno四大主流框架的官方集成,用户只需修改几行import语句即可替换原有向量存储后端,极大降低了集成成本。
纯本地运行: 无需任何托管服务,数据不离开本地机器或VPC,可构建完全离线的RAG栈。这对于数据隐私要求严格的政企、金融场景具有重大价值。
3. 如何使用
环境要求: 支持ARM(NEON)或x86(AVX-512BW)架构,推荐Linux或macOS系统。Python版本需3.8以上,并确保pip已更新至最新版本。
安装库: 执行
pip install turbovec获取Python绑定。该命令会自动下载预编译的Rust二进制文件,无需手动编译C++扩展。创建索引: 实例化
TurboQuantIndex(dim=1536, bit_width=4),指定向量维度与量化位数(2-bit或4-bit)。bit_width决定压缩率和精度,4-bit在大多数场景下平衡性更佳。添加向量: 调用
index.add(vectors)将数据批量入库。系统自动完成归一化、随机正交旋转、TQ+校准与Lloyd-Max量化,用户无需任何干预。执行搜索: 调用
index.search(query, k=10)获取Top-K相似度分数与索引ID。返回结果按内积降序排列,支持单条或批量查询。持久化存储: 使用
index.write("my_index.tv")保存索引到磁盘,后续通过TurboQuantIndex.load("my_index.tv")快速恢复,无需重新编码向量。外部ID管理: 改用
IdMapIndex实现add_with_ids和 O(1)删除,适用于需要稳定文档ID映射的场景,如增量更新。混合检索: 先用SQL/BM25/权限系统筛选候选ID,再传入
allowlist参数进行稠密精排,实现高效的多阶段检索。
4. 优缺点分析
| 优点 |
|---|
| 无需训练,在线摄入: 数据无关量化策略免去k-means训练,向量添加后立即可搜,适合动态数据集。 |
| 高压缩率与低内存: 16倍压缩(2-bit)使1000万向量从31GB降至约4GB,极大降低内存需求。 |
| SIMD加速搜索: 手写NEON/AVX-512内核,ARM上比FAISS快10-19%,4-bit x86全面胜出。 |
| 搜索时过滤零开销: 过滤逻辑在SIMD内核内直接短路,避免过度抓取,召回无损失。 |
| 纯本地运行与隐私: 无需托管服务,数据不离开本地,适合隐私敏感场景。 |
5. 同类工具对比
| 维度 | turbovec | FAISS (IndexPQFastScan) | HNSWlib |
|---|---|---|---|
| 核心架构 | 数据无关量化(旋转+标量量化) | 基于k-means的乘积量化 | 基于图的HNSW算法 |
| 训练需求 | 无需训练,在线摄入 | 需要k-means训练码本 | 无需训练,但构建图需时间 |
| 压缩率 | 16倍(2-bit)/8倍(4-bit) | 类似,但依赖训练质量 | 不压缩,原始向量存储 |
| ARM搜索速度 | 比FAISS FastScan快10-19% | 基准 | 不支持ARM优化 |
| x86搜索速度 | 4-bit胜出,2-bit接近 | 基准,2-bit VBMI有优势 | 较慢,需遍历图 |
| 搜索时过滤 | SIMD内核内短路,零损失 | 先算后滤,过度抓取 | 不支持直接过滤,需后处理 |
| 部署形态 | 纯本地嵌入式库 | 纯本地嵌入式库 | 纯本地嵌入式库 |
| 框架集成 | 官方支持LangChain等4个 | 社区支持广泛 | 社区支持 |
| 召回率 | 高(TQ+校准后) | 高(训练后) | 极高(图方法) |
对于内存敏感且需要动态更新的RAG场景,turbovec的在线摄入和高压缩率优势明显,尤其适合ARM边缘设备。如果追求极致召回率且数据量不大,HNSWlib是更好的选择,但其内存占用高且不支持过滤。对于需要训练后达到最高精度的场景,ScaNN或FAISS的PQ变体仍具竞争力,但训练开销不可忽视。整体而言,turbovec在无需训练、低延迟、过滤支持方面具备独特优势,适合现代RAG流水线。
6. 编辑点评
turbovec作为Google Research TurboQuant算法的开源实现,在向量索引领域带来了一项重要的技术创新:数据无关的量化策略。与FAISS等传统方法依赖训练码本不同,turbovec通过随机正交旋转和基于Beta分布的标量量化,实现了无需训练、在线摄入的索引构建,从根本上消除了训练开销和参数调优的痛点。其在ARM平台上的SIMD加速表现尤为亮眼,比FAISS快10-19%,为边缘计算和移动端部署提供了可行性。从实用价值来看,16倍压缩率使千万级向量检索可在普通服务器上运行,搜索时过滤的零开销设计极大提升了混合检索效率,纯本地运行满足了隐私合规要求。适用人群包括中小团队、RAG开发者、隐私敏感行业从业者以及边缘设备开发者。未来发展潜力方面,随着社区生态的完善和更多框架集成的推出,turbovec有望成为RAG场景下的默认向量索引方案。推荐指数:★★★★☆(4.5/5),扣分项在于文档尚不够详尽,2-bit在x86上竞争力有限,以及社区规模不及FAISS。
7. 应用场景
内存敏感型RAG: 中小团队或本地部署场景,需在有限内存中索引千万级文档。turbovec可将1000万条向量从31GB压缩至约4GB,配合在线摄入机制,无需昂贵的服务器即可搭建高效RAG系统。
低延迟在线服务: 对向量检索延迟要求苛刻的线上RAG、推荐或搜索系统。turbovec的手写SIMD内核在ARM上比FAISS快10-19%,在x86上4-bit全面胜出,可大幅降低响应时间。
隐私优先架构: 数据不能上传至第三方或离境的政企、金融场景。turbovec纯本地运行,无需任何托管服务,数据不离开本地机器或VPC,可构建完全离线的RAG栈。
边缘与移动端: ARM优化强劲,适合在手机、IoT设备或嵌入式硬件上运行向量检索。turbovec的Rust核心和轻量级设计使其能在资源受限设备上高效运行。
混合检索系统: 先用SQL/BM25/权限系统粗筛候选ID,再传入allowlist做稠密向量精排。turbovec的搜索时过滤在SIMD内核内直接短路,避免过度抓取,实现高效的多阶段检索。
8. 常见问题FAQ
Q:turbovec需要训练吗?
A:不需要。量化与码本都是数据无关的:向量 add 之后立刻可搜,不用 k-means、不用按语料重建。动态知识库每天追加文档时,这一点比 FAISS PQ 省一整段训练流水线,也少一次停机重建索引。
Q:turbovec支持哪些硬件平台?
A:turbovec支持ARM(NEON指令集)和x86(AVX-512BW指令集)平台。在ARM上搜索速度比FAISS快10-19%,在x86上4-bit配置全面胜出,但2-bit在x86上竞争力有限。
Q:如何将turbovec集成到LangChain中?
A:turbovec提供了LangChain官方集成。只需将原有向量存储的import语句替换为from turbovec.langchain import TurboQuantVectorStore,并传入相应的索引实例即可。
Q:turbovec的压缩率是多少?
A:2-bit 大约 16 倍(1536 维 float32 从 6144 字节降到 384 字节),4-bit 大约 8 倍。召回和速度一般选 4-bit;只在内存极紧、且接受 ARM 上更明显优势时才上 2-bit。x86 上 2-bit 相对 FAISS FastScan 没有同样大的领先。
Q:turbovec支持删除向量吗?
A:可以。用 IdMapIndex 绑定自己的 uint64 外部 ID,删除是 O(1),适合文档过期或权限回收。删完不必重建整库;持久化文件用 write/load 即可接着搜,适合权限回收和文档过期。
Q:turbovec与FAISS相比有何优势?
A:主要优势包括:无需训练、在线摄入、ARM搜索速度更快、搜索时过滤零开销、纯本地运行、框架集成官方支持。但FAISS在社区生态和某些低维场景的召回率上仍有优势。
9. 项目地址
- 项目官网(PyPI):https://pypi.org/project/turbovec/
- GitHub仓库:https://github.com/RyanCodrai/turbovec
相关 AI 模型文章
Agents-A1 – 上海 AI Lab开源的混合专家智能体模型
Agents-A1是由上海人工智能实验室(上海AI Lab)开源的35B参数混合专家(MoE)智能体模型,专为复杂科研长程任务设计。该模型通过知识-行动图谱(KAG)构建可验证长轨迹基础设施,并采用三阶段多专家蒸馏训练,突破了大模型依赖海量参数实现复杂推理的局限。在长程搜索、科学推理、指令遵循等基准上,Agents-A1以35B参数实现了比肩甚至超越万亿参数模型的性能。
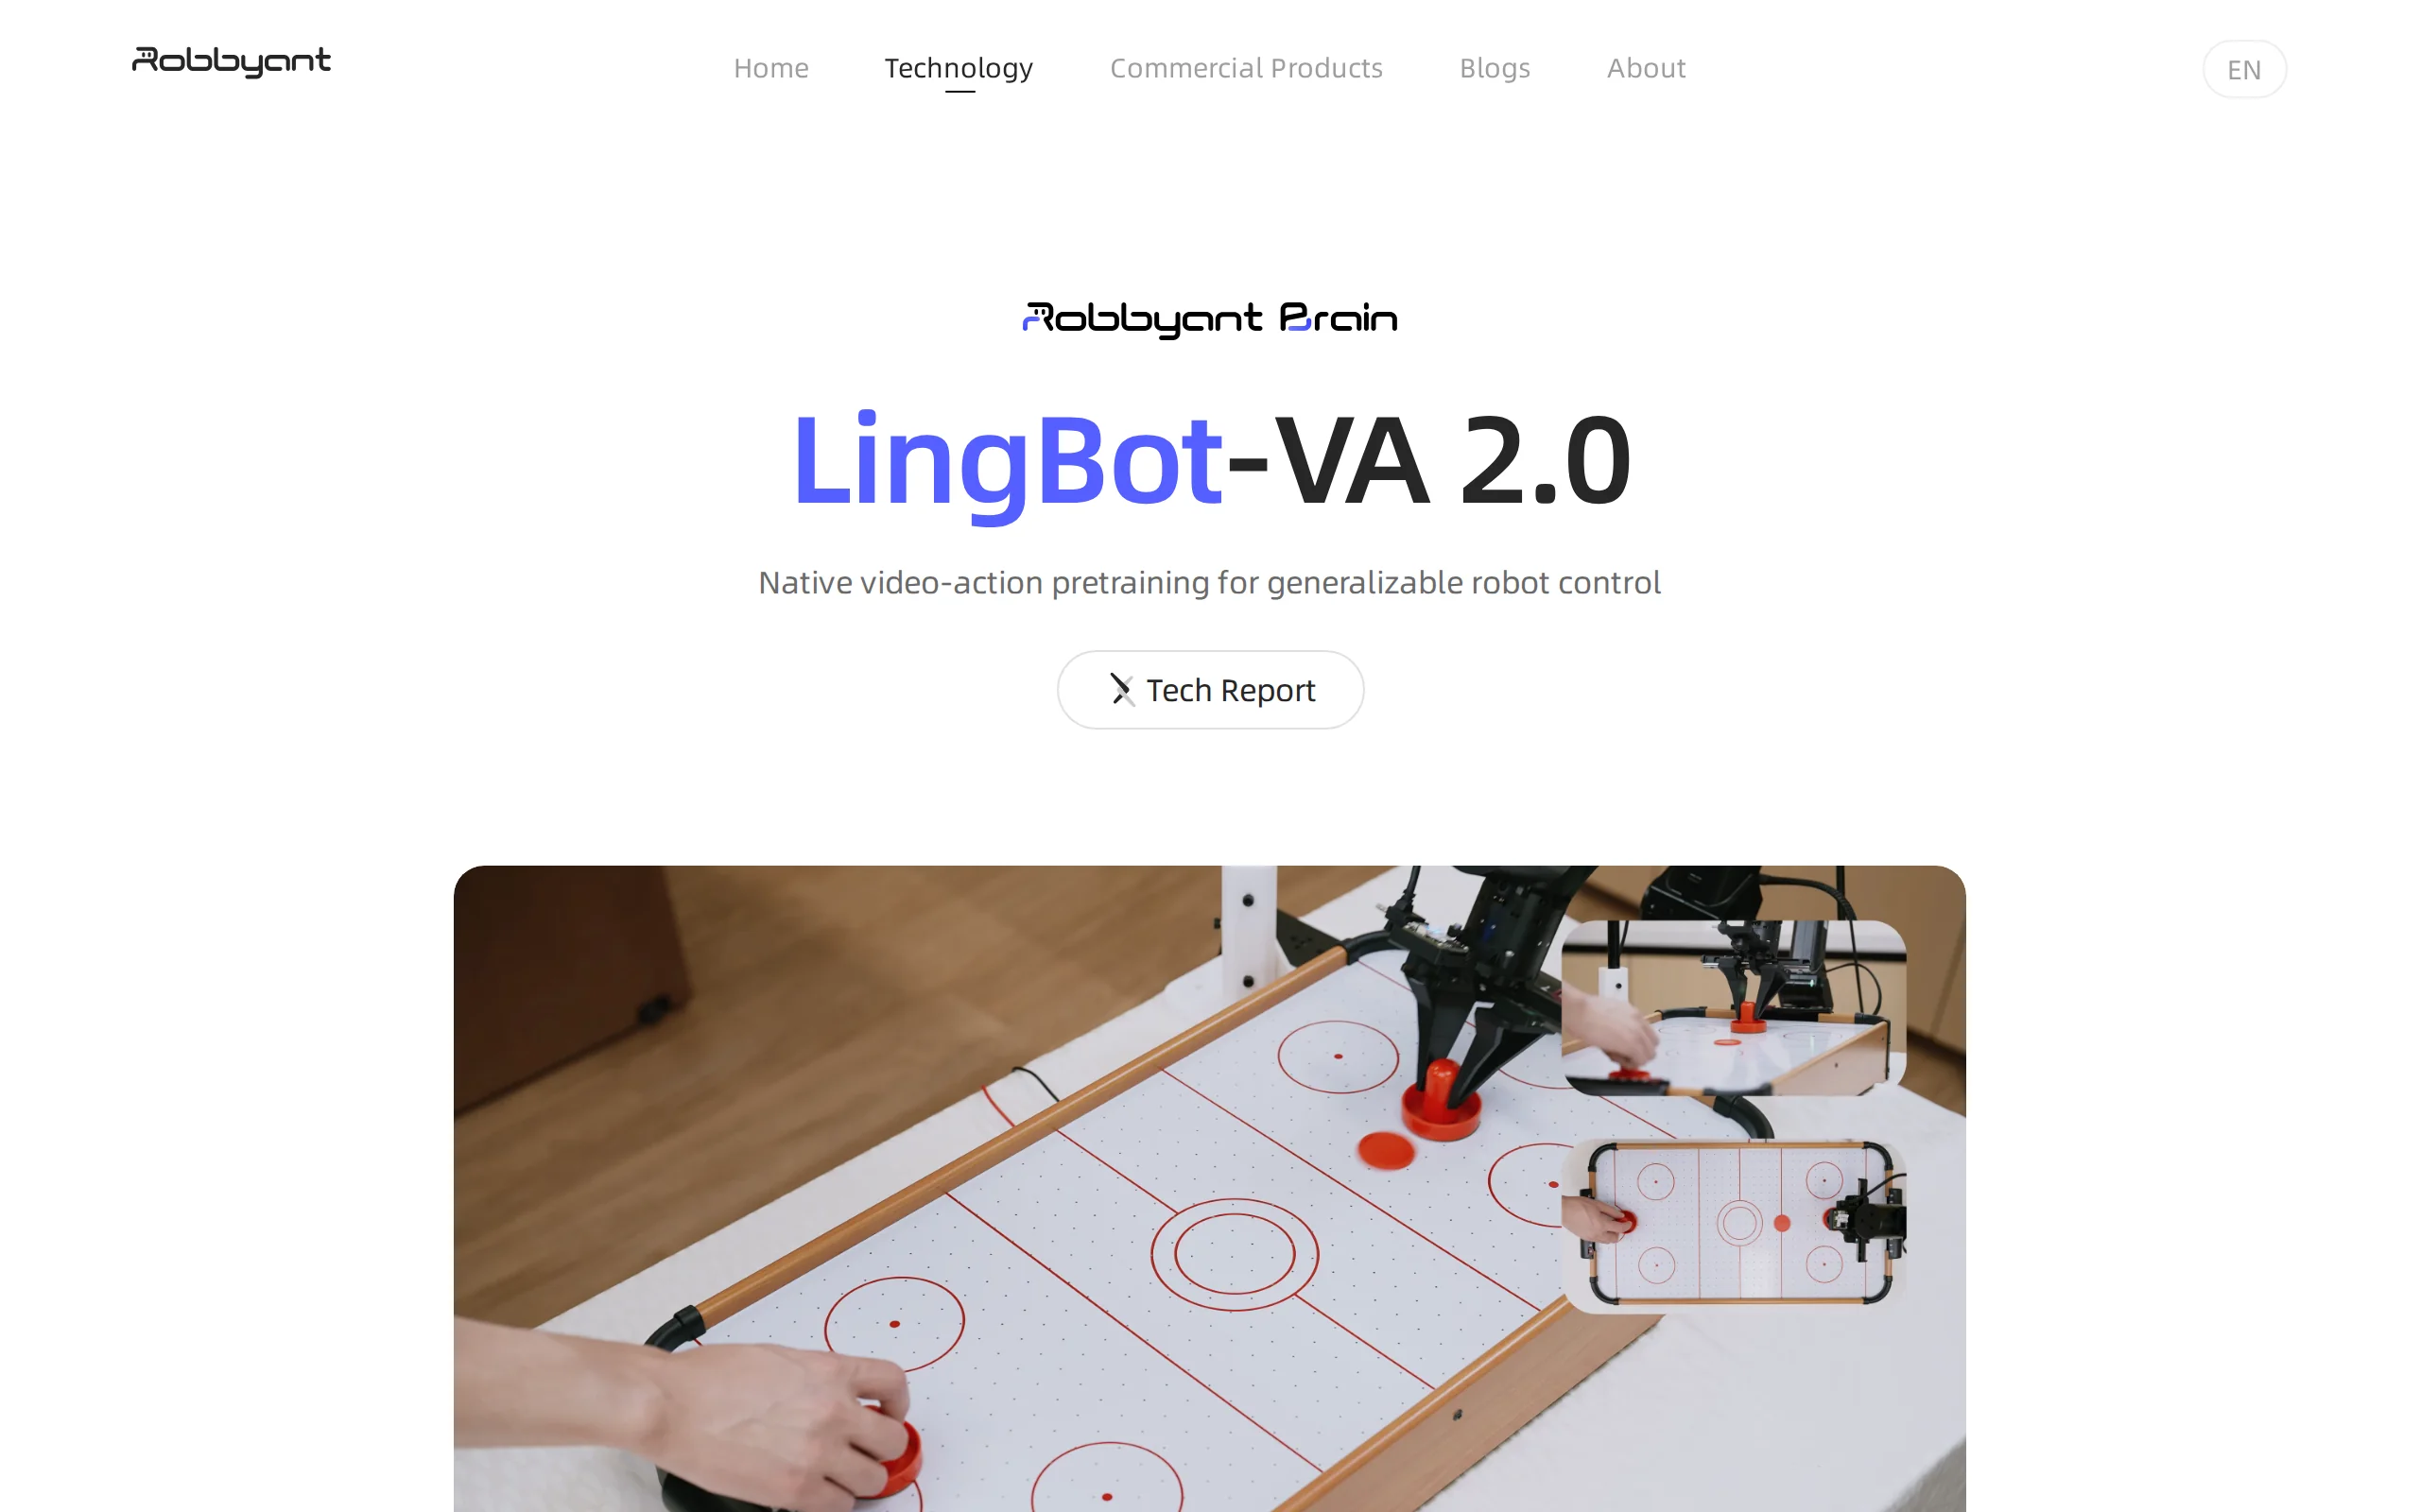
LingBot-VA 2.0 – 蚂蚁灵波推出的具身原生世界动作模型
LingBot-VA 2.0是蚂蚁灵波推出的行业首个具身原生世界动作模型,基于自回归架构从零预训练,使机器人具备“边推演、边行动”的通用控制能力。模型采用因果DiT与稀疏MoE架构,总参数15.3B但推理仅激活2.5B,在RoboTwin 2.0基准上实现93.6%的双臂任务成功率,单GPU推理速度达到150Hz,异步模式下可达225Hz。该模型从架构设计、数据采集到训练目标均为物理世界量身定制,...
KAT-Coder-Pro V2.5 – 快手推出的 Agentic Coding 模型
KAT-Coder-Pro V2.5是快手KwaiKAT推出的旗舰级Agentic Coding模型,专注于长程工程能力与通用Agentic能力。通过自研AutoBuilder将真实仓库环境构建成功率从16.5%提升至57.2%,沉淀超10万个可运行仓库;并建设KwaiClawEnv通用Agentic训练体系,结合多框架强化学习与MOPD多专家融合技术。模型在SWE-Bench Pro取得65.2...
LingBot-VLA 2.0 – 蚂蚁灵波开源的一代具身智能基座模型
LingBot-VLA 2.0是蚂蚁灵波科技(Robbyant)开源的新一代具身智能基座模型,基于6万小时大规模预训练数据(含5万小时真机操作和1万小时人类操作视频),覆盖17个品牌20种机器人构型,支持单臂/双臂、双足/轮式及头部、腰部、底盘等多自由度控制。模型采用稀疏MoE架构(1.6B总参数,0.6B激活参数)与统一动作空间表示,在GM-100双臂评测和长程移动操作任务中均超越π0.5与GR...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。