AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:图像生成
共 63 篇文章 · 清除标签
Canva Brush – Canva 推出的视觉-语言设计编辑模型深度评测
Canva Brush是Canva Research团队于2026年10月29日正式发布的首个自研视觉-语言模型(VLM),专为设计编辑场景打造。该模型能够理解设计稿的页面结构、识别用户的编辑意图,并通过智能体循环机制自主执行从单行文案修改到整套演示文稿批量调整的各类编辑任务。与Canva同期推出的图像生成模型Craft形成明确分工——Craft负责从零生成图像,Brush则聚焦于对现有设计的精细...
WorldSonus:港科大联合上海交大开源的实时流式视频配音框架深度评测
WorldSonus是由香港科技大学联合 Noiz AI、MetaX 及上海交通大学共同开源的流式视频配音框架,核心定位在于实现“视频流边生成、音频边输出”的实时交互式配音能力。该框架以 100ms 为一块进行增量生成,单块计算耗时仅 41.2ms,可持续输出 48kHz 立体声音频,显存占用恒定,支持无限时长跟流。有别于传统的离线双向配音模型,WorldSonus 采用因果 AR-Diffusi...
Hi3D 1.0 – Math Magic 开源的专业级 AI 3D 生成模型
Hi3D 1.0 是 Math Magic 团队开源的国产 AI 3D 生成模型,技术源自 NeurIPS 2025 论文中的 Sparc3D 架构。该模型基于约 200 万个筛选后的 3D 资产训练,采用稀疏几何细化架构,支持从 512³ 到 1024³再到 1536³ 的逐级分辨率细化,能够根据单张图片生成高分辨率水密网格,其多视图保真度和细节丰富度在同类方法中排名首位,切片成功率高达 90%...
MOSS-Image – 模思智能联合OpenMOSS开源的文生图模型
MOSS-Image是模思智能与OpenMOSS团队联合开源的文生图模型,其核心由5B参数的单流扩散Transformer(DiT)主干构成,配合冻结的Qwen3.5-9B文本编码器与FLUX.2 VAE,权重采用Apache-2.0协议发布。该模型在训练阶段剔除AI生成图像以降低"AI味",并针对中英文密集文本渲染、JSON Layout/Bounding Box结构化布局控制以及最长4096 ...
FLUX 3 Max – fal 与 Black Forest Labs 推出的视频生成模型深度评测
FLUX 3 Max 是由 fal Research 与 Black Forest Labs 联合推出的后训练视频生成模型,基于 BFL 自研的 FLUX 3 多模态基础模型,支持文生视频、图生视频与关键帧插值三种工作流,可生成 5–20 秒、最高 1080p 分辨率且自带原生音频的视频内容。该模型主打极致推理速度与成本效率,10 秒成片约 12 秒完成生成,官方宣称在同画质条件下比 Seedan...
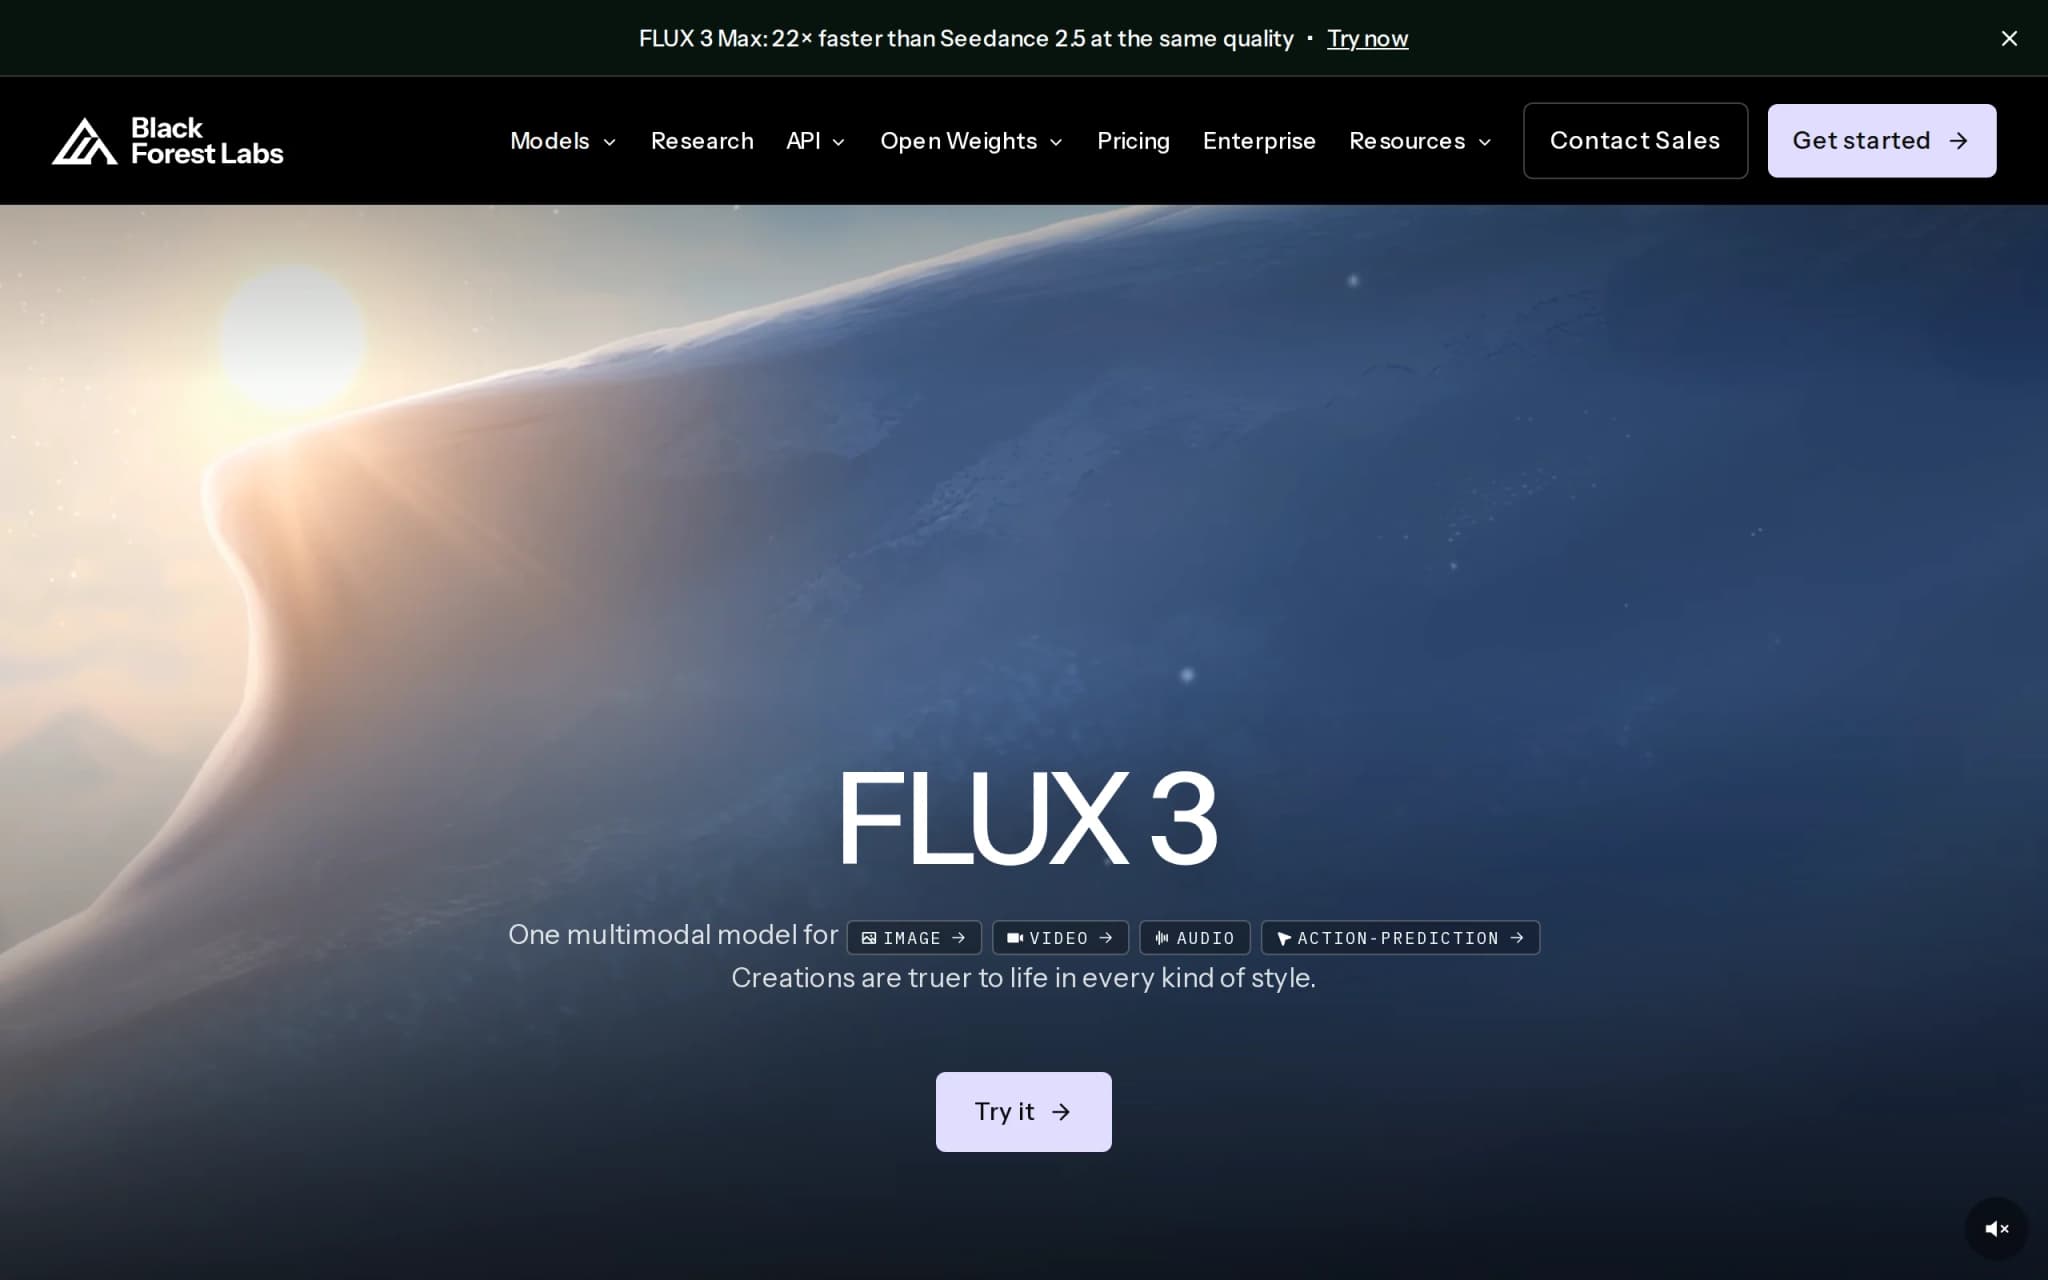
FLUX 3 Image Klein – Black Forest Labs 开源的AI图像模型
FLUX 3 Image Klein 是由 Black Forest Labs 开源的 AI 图像生成模型,以仅 5.6B 参数的轻量级体量实现了此前需要数十亿参数乃至闭源大模型才能达成的能力。该模型同时支持文生图、指令式图编辑以及最多 10 张参考图的多图生成,具备原生 4K 输出、像素级精确编辑和坐标框布局控制等差异化功能。官方内部盲测显示,其在中文生图、编辑、多参考三项任务中均排名第一,超越...
DMAD – 字节联合德州农工开源的扩散模型少步蒸馏技术
DMAD(Distribution Matching as Adversarial Distillation)是由字节跳动与德州农工大学联合开源的少步蒸馏框架,核心目标是显著加速扩散模型的生成过程。该方法通过训练二分类判别器直接学习目标分布与学生分布之间的差异,省去传统蒸馏方法中辅助扩散模型的依赖,在ImageNet-64数据集上实现了FID低至1.04的一步生成效果,并将50步教师模型高效压缩为...
ArtCraft 深度评测:开源AI图像视频创作工作台,以“可控性前置”重塑创作流程
ArtCraft 是一款开源的 AI 图像与视频创作工作台,其核心设计理念是将“可控性前置”,即在生成最终画面之前,通过三维空间布局、角色摆姿和场景搭建等手段,彻底解决传统 AI 绘画工具“出图不可控、角色场景不一致”的行业痛点。它允许创作者将虚拟演员固定于真实环境照片中,无论镜头如何调度,人物位置始终保持一致;同时支持在 3D 空间内拼贴素材、使用 3D 人偶精确控制姿势与机位。此外,ArtCr...
PixelUMM深度评测:NVIDIA与滑铁卢大学联合打造的无编码器统一多模态模型
PixelUMM是NVIDIA与滑铁卢大学联合推出的无编码器统一多模态模型,其核心创新在于彻底移除传统多模态系统中的VAE和视觉编码器,构建了一个纯粹的Decoder-only Transformer架构,直接在原始像素空间读写图像与视频。该模型将图像按16×16 patch、视频按4帧tubelet切分,理解和生成任务共享同一解码器与自注意力机制,实现了端到端的像素级信息处理,代码已全面开源。
Nano Banana 2.1:Google DeepMind 图像生成与对话式编辑模型深度评测
Nano Banana 2.1(模型 ID:gemini-nano-banana-2.1)是 Google DeepMind 于 2026 年 10 月 6 日正式发布的第二代图像生成与对话式编辑模型,隶属于 Gemini 3 系列,底层架构基于 Gemini 3.6 Flash。该模型深度融合了原生多模态推理、1M token 长上下文与知识 grounding 能力,支持 1K/2K/4K 分...