AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:视频AI
共 117 篇文章 · 清除标签
AudioX-Turbo – Noiz AI 联合清华推出的音频生成框架
AudioX-Turbo 是 Noiz AI 联合香港科技大学、清华大学共同推出的一款统一高效音频生成框架。该框架基于 2.7B 参数的多模态扩散 Transformer 架构,支持文本、视频、音频任意组合输入,能够生成高质量的音效与音乐片段。通过分布匹配蒸馏(DMD)与对抗蒸馏技术,模型将推理步数从传统的 50–200 步压缩至仅 4 步,在单张 RTX 4090 上生成 10 秒音频仅需 0....
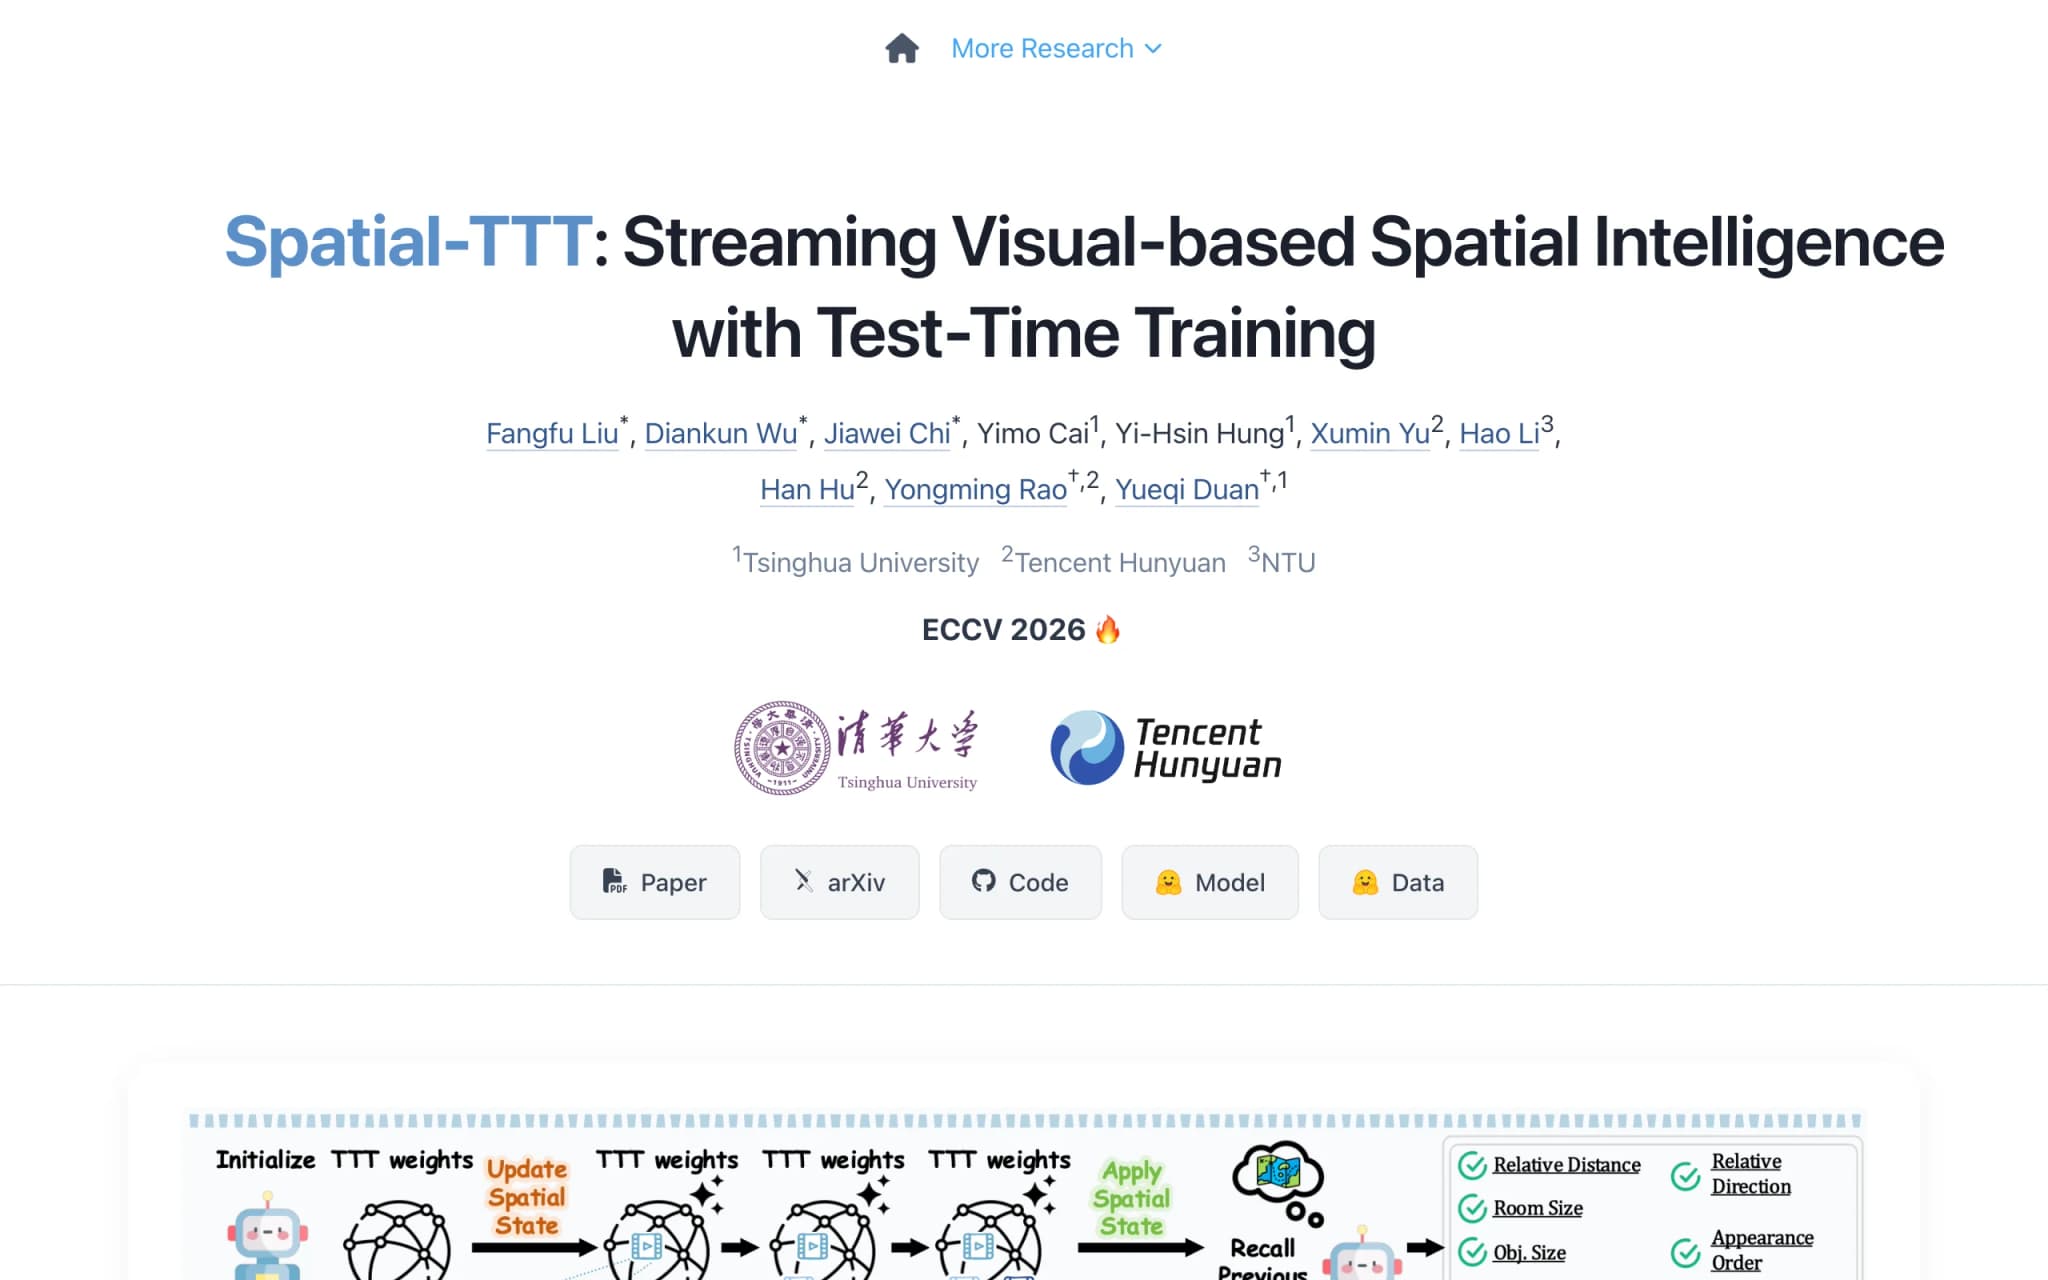
Spatial-TTT – 清华联合混元开源的流式视觉空间智能框架
Spatial-TTT是由清华大学、腾讯混元与南洋理工大学联合推出的流式视觉空间智能框架。该框架仅2B参数,通过Test-Time Training(TTT)技术,在观看视频流的过程中持续更新内部空间记忆,实现对长达120分钟视频的空间推理。在VSI-Bench、MindCube-Tiny等多个基准上,其表现超过GPT-5、Gemini-3-pro等闭源大模型,峰值显存占用比行业领先方案节省超40...
豆包2.1 – 字节跳动推出的全智能体模型系列
豆包2.1(Seed 2.1)是字节跳动 Seed 团队推出的面向真实生产力场景的全智能体模型系列,包含 Pro 与 Turbo 两个版本。该系列以解决日常生活、专业工作和前沿探索中的复杂需求为目标,在通用 Agent 能力、代码工程端到端交付和多模态理解三大维度实现显著提升,强调在实际工作流中的稳定交付。模型支持 128K 长上下文、小时级视频分析、跨端 GUI 操作,并通过深度思考架构与缓存复...
Seedance 2.5 – 字节跳动推出的最视频生成模型
Seedance 2.5 是字节跳动旗下豆包视频生成模型系列的最新旗舰版本,于2026年6月23日在火山引擎FORCE原动力大会上正式发布。作为Seedance 2.0的重大升级,该模型实现了三大全球突破:单段原生视频直出长达30秒、支持50个全模态参考素材联合输入、以及更可控的局部视频编辑能力。这些突破使Seedance 2.5从UGC玩具级工具迈向了专业影视与商业广告级应用,重新定义了AI视频...
JoyAI-VL-Interaction – 京东开源的实时视频视觉语言交互模型
JoyAI-VL-Interaction是由京东Joy Future Academy开源的实时视频视觉语言交互模型,是全球首个全栈开源的interaction模型系统。该模型突破了传统AI助手的轮询问答范式,实现了“边看边说”的主动交互能力——可持续观察视频流、自主判断何时发声、实时响应画面变化,并支持将复杂任务委托给后台Agent处理。在58项真人盲评中,对比豆包视频通话助手胜率77.6%,对比...
MaineCoon – AI 实时音视频世界模型,专为社交互动场景
MaineCoon是全球首个专为社交互动场景优化的实时音视频自回归世界模型,拥有220亿参数,能在单GPU上实现47.5 FPS的实时流式生成,支持亚秒级交互响应与千秒级连续音视频生成。不同于传统聚焦于物理环境模拟或游戏探索的世界模型,MaineCoon首次将世界模型的视角转向以人为中心的社交动态场景,通过自重采样、跨模态表示对齐、领域感知偏好优化等创新技术,为下一代AI原生社交平台的构建奠定了关...
Grok Imagine Video 1.5 – xAI 推出的图生视频模型
Grok Imagine Video 1.5 是由 xAI 推出的新一代图生视频模型,基于自研 Aurora 自回归引擎构建。该模型支持用户上传单张静态图片,通过自然语言提示一键生成带原生同步音频的短视频,最高支持 720p 分辨率。在 Fast 模式下,生成一段 6 秒 720p 视频仅需约 25 秒,显著提升了内容创作效率。模型在 Arena.ai 图生视频榜单中排名第一,Elo 评分约 13...
ACE-Ego – 大晓机器人联合港中文开源的具身操作 VLA 模型
ACE-Ego是由大晓机器人联合香港中文大学MMLab共同开发的开源一脑多型具身操作VLA模型。该模型以6.0K+小时人类第一视角视频为核心进行预训练,通过相机空间动作与形态条件编码,使同一模型可适配不同机器人本体。在RoboCasa GR1 TableTop基准上以72.8%刷新SOTA,能稳定完成塑料袋打包、鞋盒装鞋等复杂零售操作,大幅降低多本体部署成本。

Seedance 2.0 Mini – 字节跳动推出的轻量化视频生成模型
Seedance 2.0 Mini 是字节跳动火山引擎推出的一款高性价比轻量化视频生成模型,旨在以更低的计算成本和更快的生成速度满足短视频批量生产、营销素材迭代及项目前期草稿等高频需求。该模型在保留核心多模态参考生成能力的前提下,将生成成本较标准版降低约50%,生成速度达到 Seedance 2.0 Fast 的2倍,10秒视频实测约2分钟即可完成。基于双分支并行生成架构、统一多模态联合训练以及知...
SCAIL-2 – 智谱联合清华开源的角色动画模型
SCAIL-2是由智谱AI联合清华大学刘永进教授课题组开源的影视级角色动画框架第二代。基于扩散变换器(DiT)架构,采用端到端训练直接实现高质量动画迁移,无需传统姿态估计中间环节,避免骨架图歧义。支持动画生成与角色替换双模式,通过SAM3掩码增强实现精准匹配。能驱动人体,可处理动物、手绘角色等非人体目标,支持多人物交互,为影视、游戏、虚拟偶像等领域提供高效动画解决方案。