AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:文档AI
共 27 篇文章 · 清除标签
huashu-excel 深度评测:花叔开源的 AI 数据分析 Skill,用八步流程终结「算错不报错」
huashu-excel 是花叔开源的 AI 数据分析 Skill,通过体检→清洗→对齐→分析→对账→交付→验图→质控八步流程,解决 AI 数据分析时算错不报错的核心问题。该工具用 openpyxl 读取原始单元格识别结构陷阱,再用表内合计行当免费校验和对账,另派独立 agent 重算拆台,支持 HTML/Excel/Word 报告输出,依赖仅 openpyxl,MIT 协议开源。

PixelRAG – 伯克利开源的视觉原生 RAG 框架
PixelRAG是伯克利SkyLab/BAIR开源的一款视觉原生RAG框架。它跳出传统RAG从网页或PDF中抽取文本再检索的范式,改用无头Chromium将文档渲染为截图瓦片,并通过LoRA微调的Qwen3-VL视觉向量检索模型直接读取图像中的表格、图表和版式信息,从而解决了传统RAG在表格、图表和复杂版式上信息丢失的痛点。该框架提供从渲染、索引到检索、生成的完整工具链,并附带覆盖828万维基百科...
HOMIE – 香港科技大学开源的数字人视频生成框架
HOMIE是由香港科技大学计算机科学与工程系开源的数字人视频生成框架,基于阿里Wan2.1-T2V-14B骨干网络并集成Qwen3-VL多模态大模型。该框架能够在一个统一管线中同时处理数字人、商品、Logo、文字四类视觉元素,解决人‑物交互、品牌贴牌、OCR文字保真和多视角一致性四大技术难题。模型训练仅需约5.5K步/1万A100小时,OCR准确率比开源最强模型提升38.7%,支持480P单卡到7...
Wan3.0 – 阿里万相最新推出的视频生成大模型
Wan3.0是阿里云万相团队最新推出的视频生成大模型,在生成时长、多模态输入、一致性保持和真实感等方面实现全面升级。该模型单次可生成30秒视频,并首次支持doc、xls、ppt、pdf、md等文档格式输入,将静态办公文档直接转化为动态视频内容。在人物刻画、场景还原和跨模态融合方面表现突出,可广泛应用于影视创作、广告营销、设计创意与文旅传播等场景。
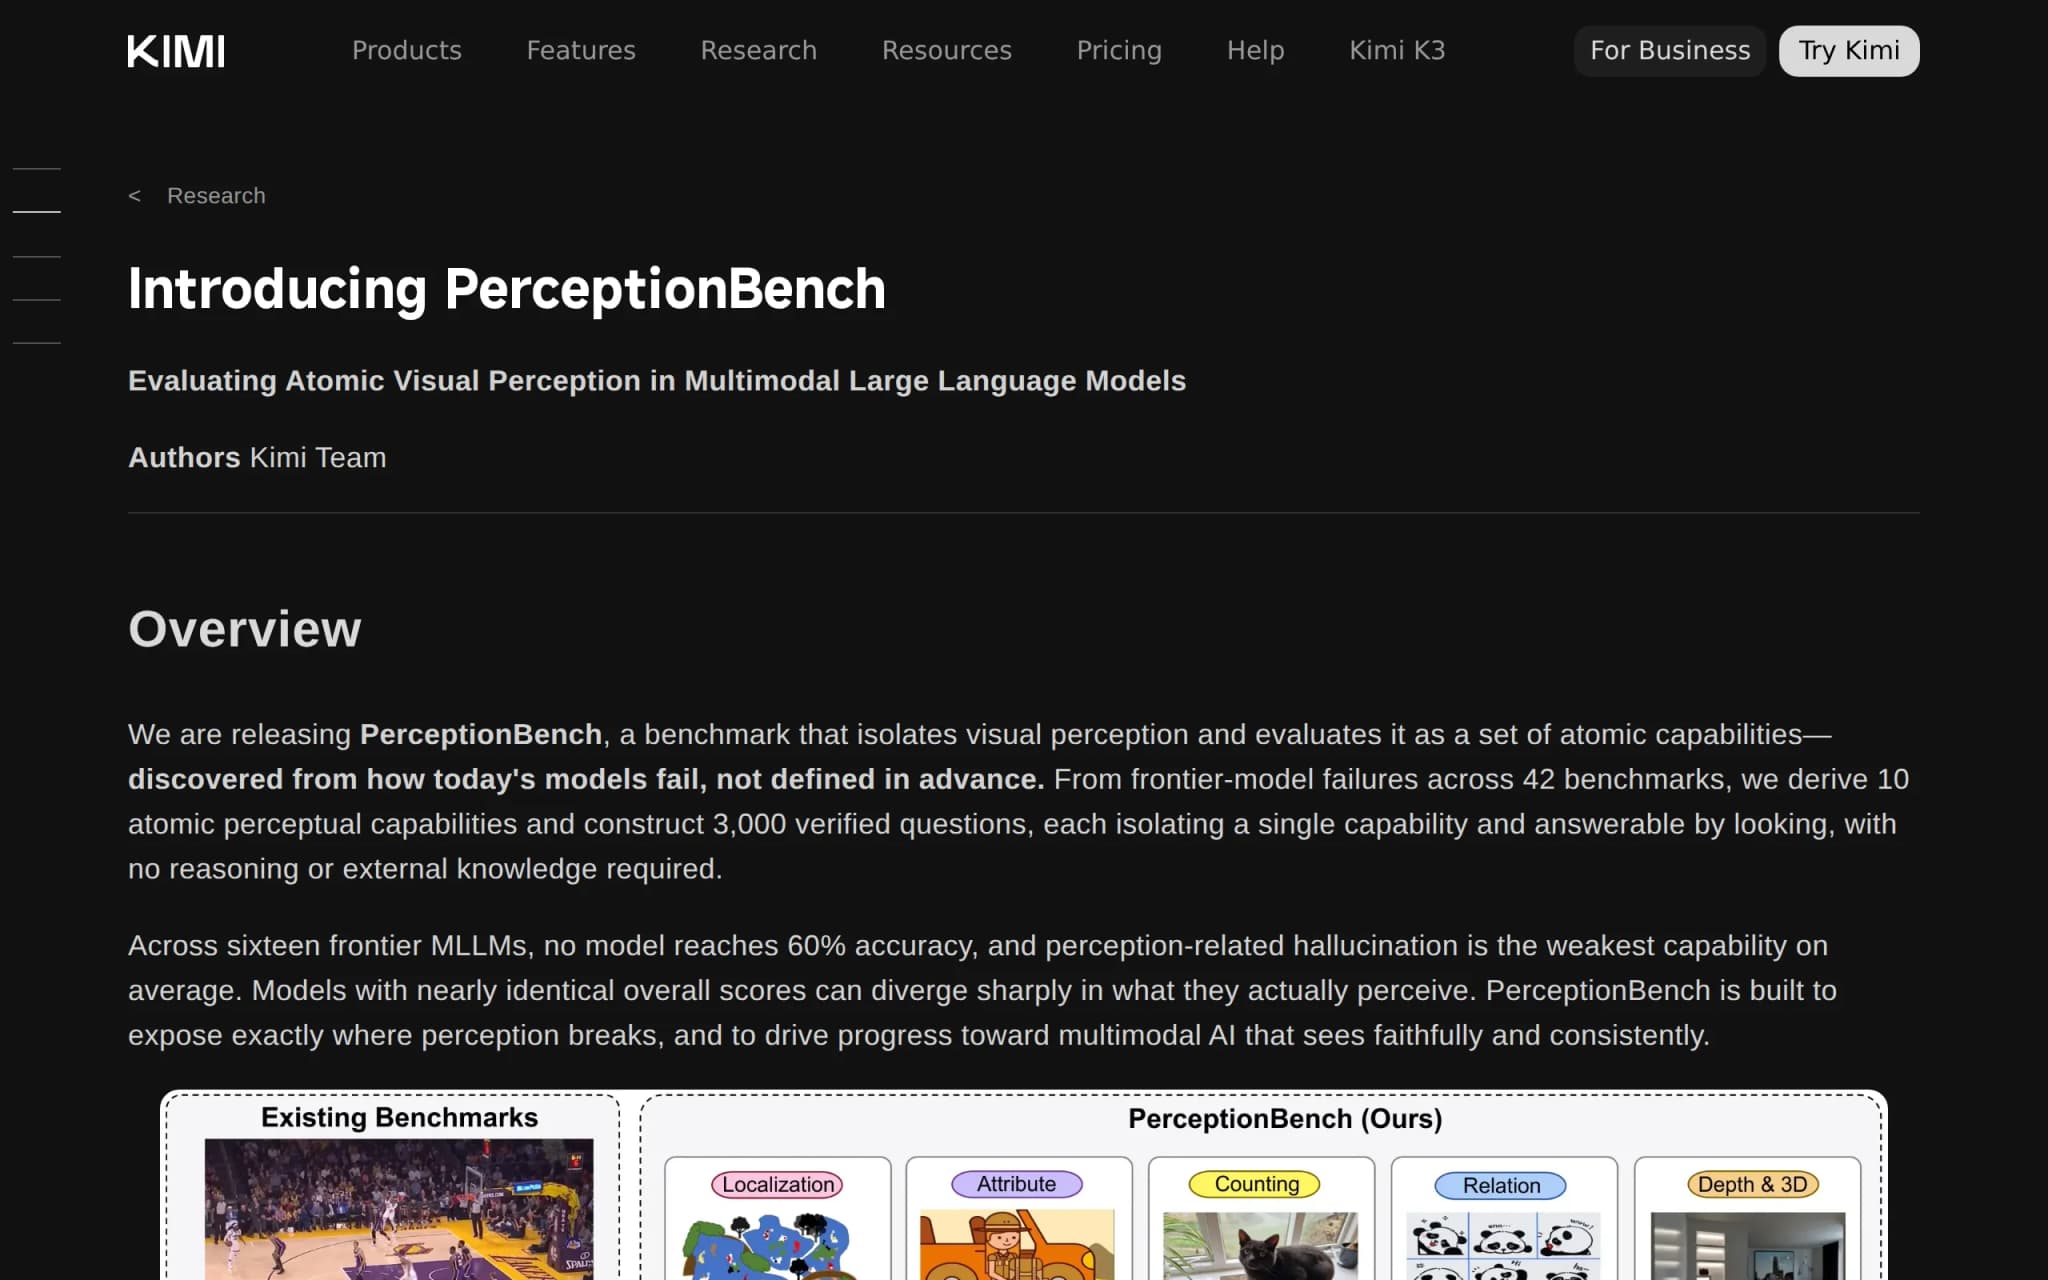
PerceptionBench – 月之暗面开源的视觉感知诊断基准
PerceptionBench是由月之暗面(Moonshot AI)开源的视觉感知诊断基准,专注于原子级视觉感知能力的细粒度评测。该基准从42个现有多模态评测集中前沿模型的失败案例出发,归纳出10项原子视觉感知能力,并构建了3,000道隔离式验证题,每道题目仅考察单一感知能力,无需推理或外部知识。测试结果显示,当前16个主流多模态大模型(MLLM)无一达到60%的准确率,揭示了原子级视觉感知仍是行...
Instella-MoE – AMD 开源的混合专家语言模型系列
Instella-MoE 是 AMD 开源的混合专家(MoE)语言模型系列,总参数量 16B、激活参数量 2.8B,采用 27 层解码器架构。模型基于 AMD Instinct MI300X / MI325X GPU 及 ROCm 软件栈从头训练,提供预训练、Mid-training、长上下文 Base、SFT、DPO 和 RL 优化共 6 个全开源版本,覆盖从基座到对话的全链路需求,在 AMD ...
SenseNova-Vision – 商汤开源的理解生成统一视觉大模型
SenseNova-Vision是商汤科技开源的理解与生成统一视觉大模型,其核心创新在于将目标检测、图像分割、深度预测、3D重建等经典视觉任务原生融入大模型底座,无需任务特定头或架构改动。模型基于统一多模态生成框架(UMM),通过自然语言指令即可定义任意视觉任务,输出文本符号记录、图像稠密预测或混合格式。SenseNova-Vision具备零样本泛化能力,可处理跨域游戏画面、镜面反射等极端场景,在...
OvisOCR2 – 阿里ATH-MaaS团队推出的端到端文档解析模型
OvisOCR2是由阿里巴巴ATH-MaaS团队研发并完全开源的端到端文档解析模型,基于Qwen3.5-0.8B基座模型训练,参数规模仅0.8B。该模型在OmniDocBench v1.6评测基准中以96.58分登顶榜首,展现出对复杂版式文档的高精度识别与结构化提取能力,支持多栏排版、表格、公式等场景的解析,适用于学术研究、档案数字化及企业知识库构建等文档智能处理需求。其端到端架构直接输出Mark...
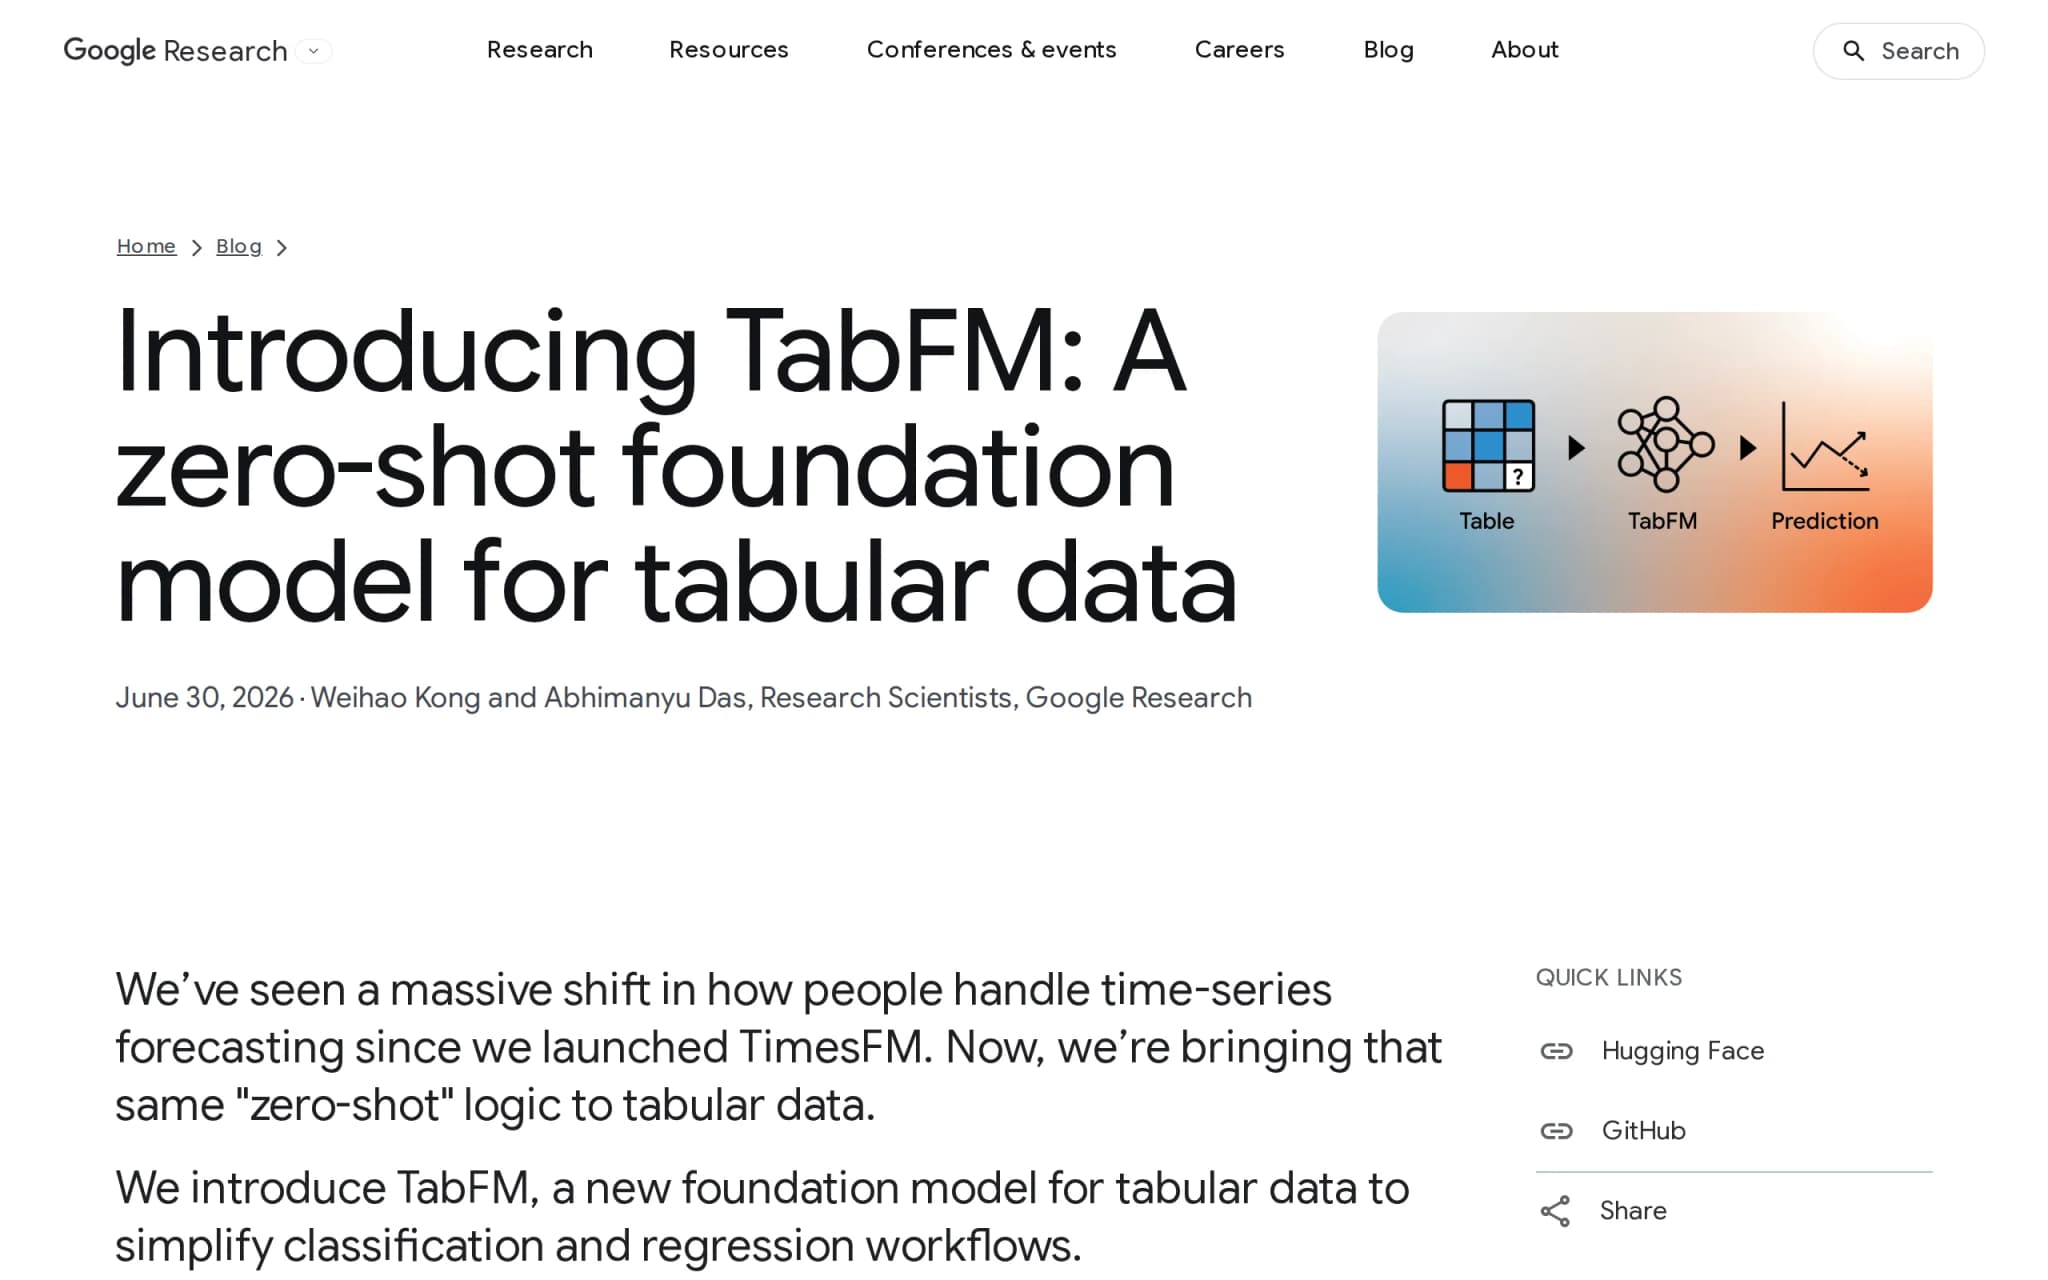
TabFM – 谷歌开源的零样本表格基础模型
TabFM是由Google Research推出的零样本表格基础模型,专为混合数值与类别特征的结构化数据设计,支持分类(最多10类)和回归任务。模型基于结构因果模型(SCM)生成的数百亿合成表格数据预训练,无需微调或超参数搜索,仅以训练数据作为上下文进行单次前向预测即可完成推断。在TabArena基准的51个真实数据集上,TabFM的零样本性能超越了经过大量超参数调优的梯度提升树等强基线模型。该项...
LocateAnything – 英伟达推出的视觉语言定位模型
LocateAnything是英伟达(NVIDIA)推出的视觉语言定位模型,基于并行框解码(PBD)技术,用户输入自然语言即可在图像中精准框选目标。该模型以3B参数量实现了多目标检测、GUI元素定位、OCR文本检测和点级指向等多样化任务,在单张H100 GPU上推理速度达到12.7 BPS(边界框每秒),较Qwen3-VL快约10倍,在LVIS、M6Doc、ScreenSpot-Pro、DocLa...