AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:AI Agent
共 305 篇文章 · 清除标签
LLM Council – Karpathy 开源的多模型协作框架
LLM Council是由前OpenAI、Tesla AI负责人Andrej Karpathy开源的多模型协作推理框架。它颠覆了传统单一模型“一言堂”的问答模式,通过引入类似“专家评审团”的机制,将用户问题同时分发给多个不同的大语言模型(如Claude、GPT、Gemini等)独立作答,并让模型之间进行匿名交叉评审与打分,最终由指定的“主席模型”(Chairman LLM)综合所有观点,输出一个经...
autoresearch – Karpathy 开源的 AI 自主科研实验框架
autoresearch 是由 OpenAI 前研究科学家、特斯拉前 AI 总监 Andrej Karpathy 开源的 AI 自主科研实验框架,旨在将深度学习模型训练中的“调参-跑实验-看日志-再调参”这一人工循环完全自动化。该框架允许 AI Agent 在单张 GPU 上自动运行 nanochat 训练实验,自主修改代码、调整超参数、执行训练、分析验证指标,并决策下一步优化方向,从而让 AI ...
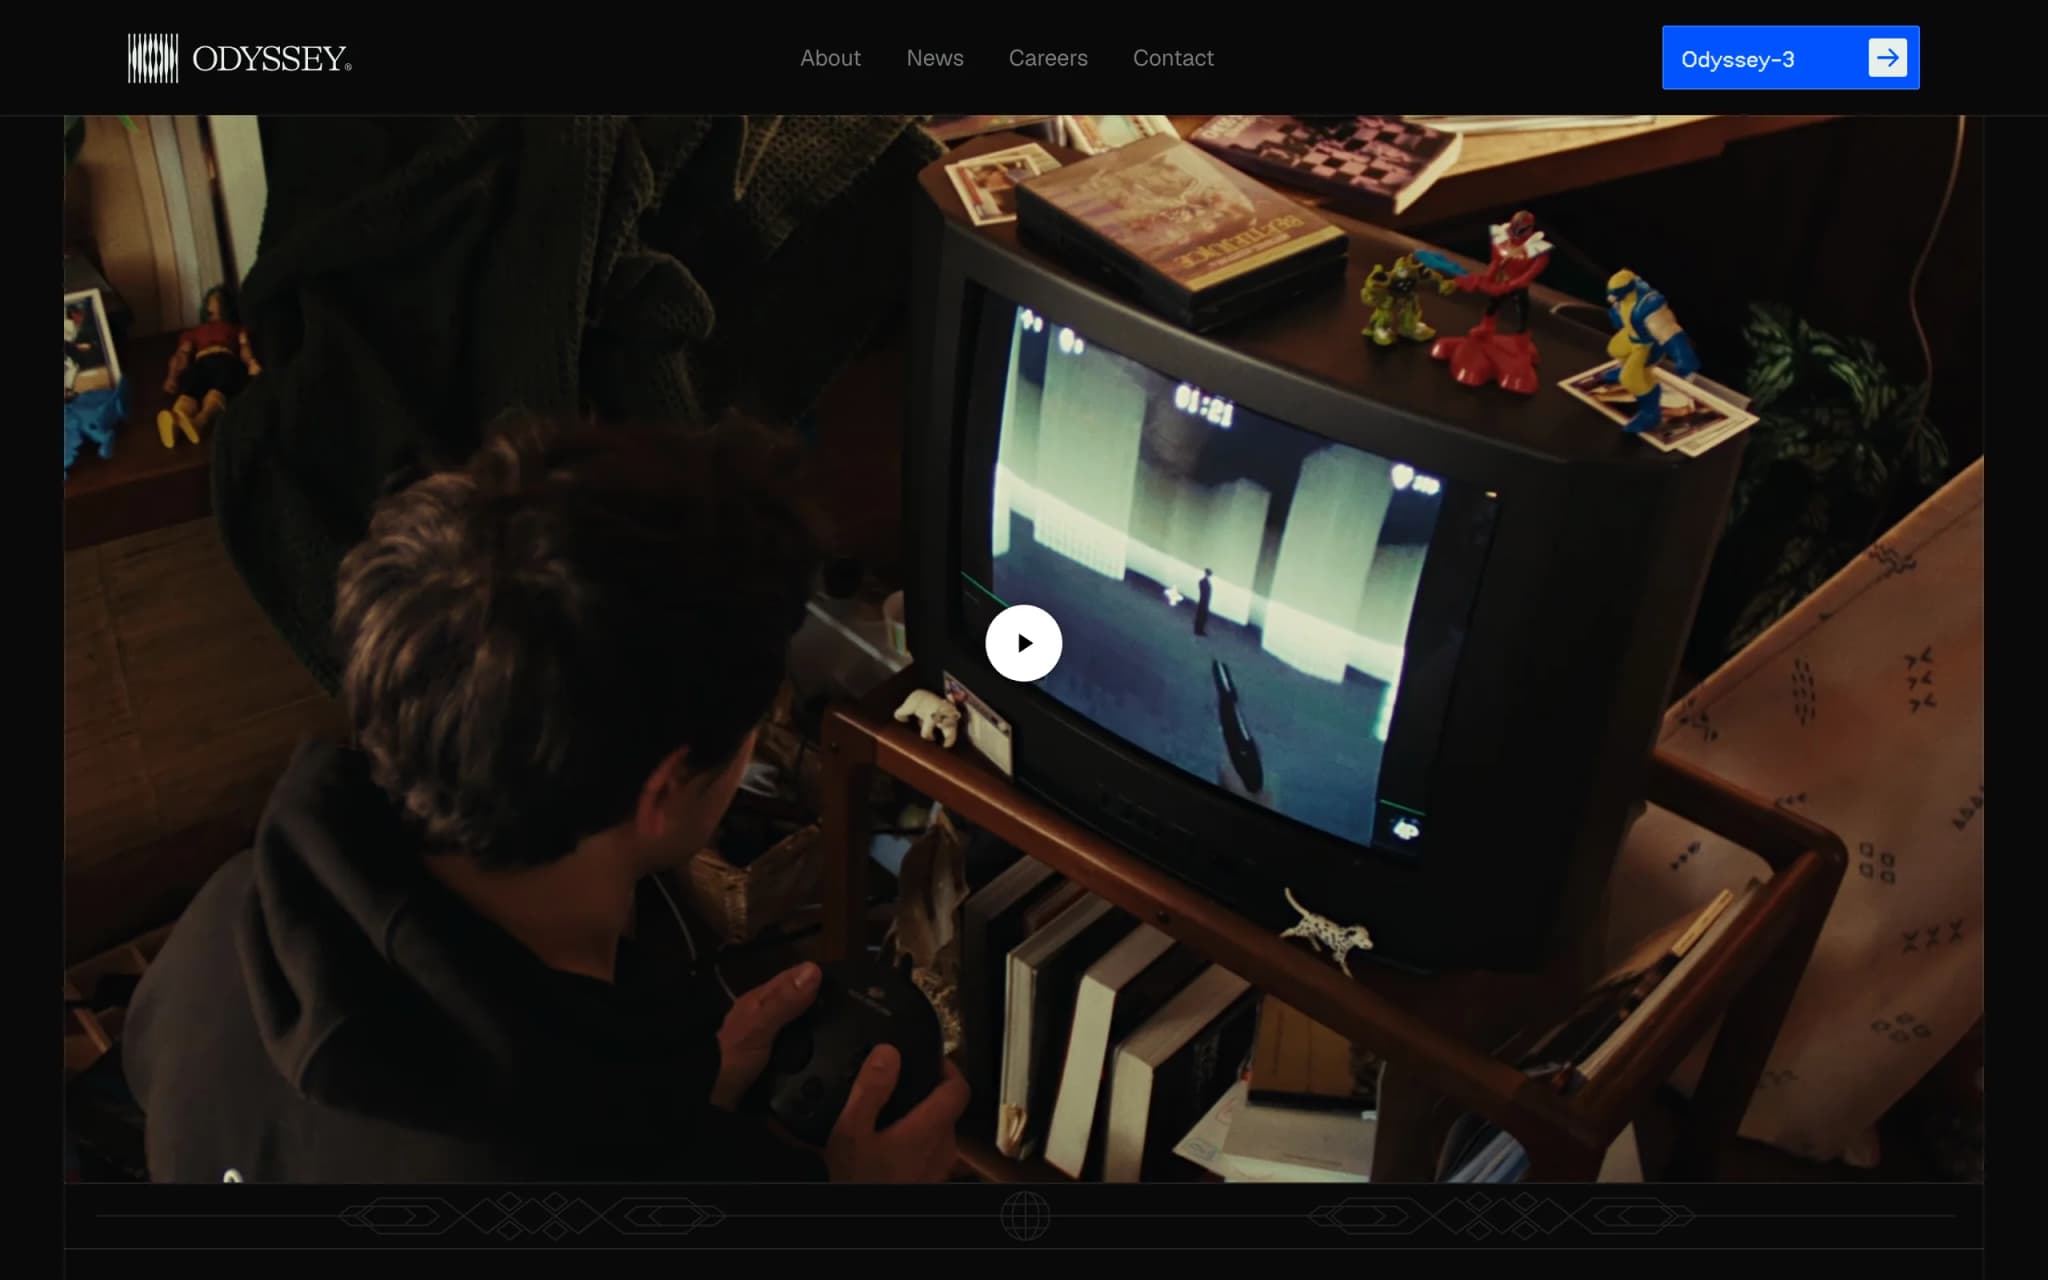
Agora-1 – Odyssey 推出的首款多智能体世界模型
Agora-1是Odyssey公司推出的首款多智能体世界模型,它突破了传统世界模型的单用户限制,支持人类与AI在同一实时生成的世界模拟中互动。该模型以经典FPS游戏《黄金眼007》作为研究场景,最多支持4名参与者共享死亡竞赛体验。与传统世界模型不同,Agora-1通过解耦模拟动态与视觉渲染,维持显式共享世界状态,实现多视角一致性生成。其模型架构类似现代游戏引擎,但所有组件均为学习系统,无需硬编码逻...
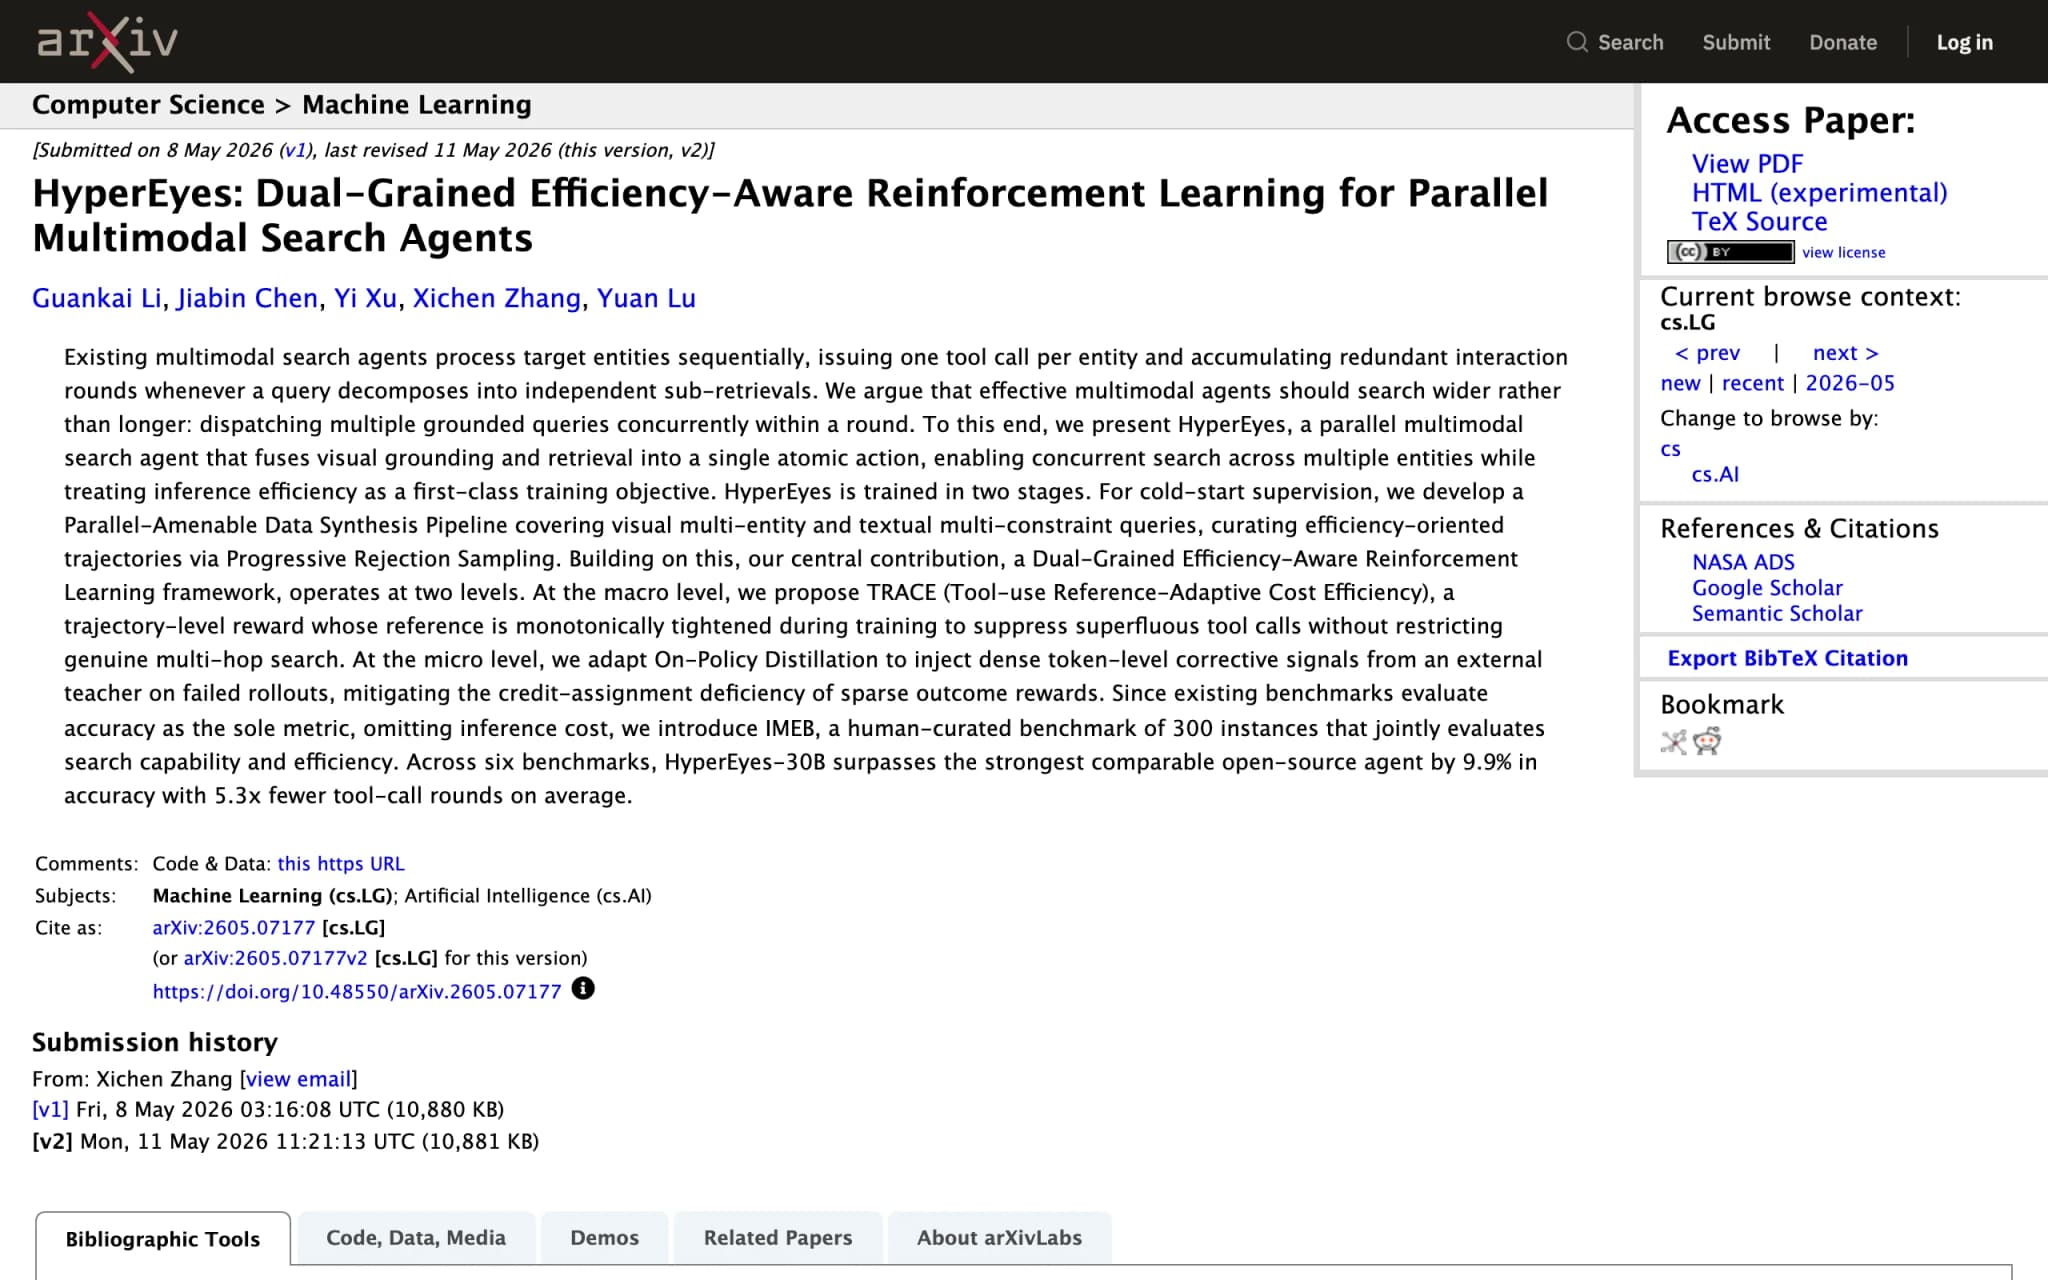
HyperEyes – 小红书联合剑桥推出的并行多模态搜索智能体
HyperEyes是小程序与剑桥大学联合推出的并行多模态搜索智能体,它开创性地提出了UGS(Unified Grounded Search)范式,将视觉定位与检索融合为单一原子动作,实现了单轮多实体并发搜索。该模型采用双粒度效率感知强化学习框架(TRACE + OPD),在6个基准测试中,30B版本准确率超越最强开源同规模模型9.9%,工具调用轮次减少5.3倍,实现了准确率与效率的帕累托最优。Hy...
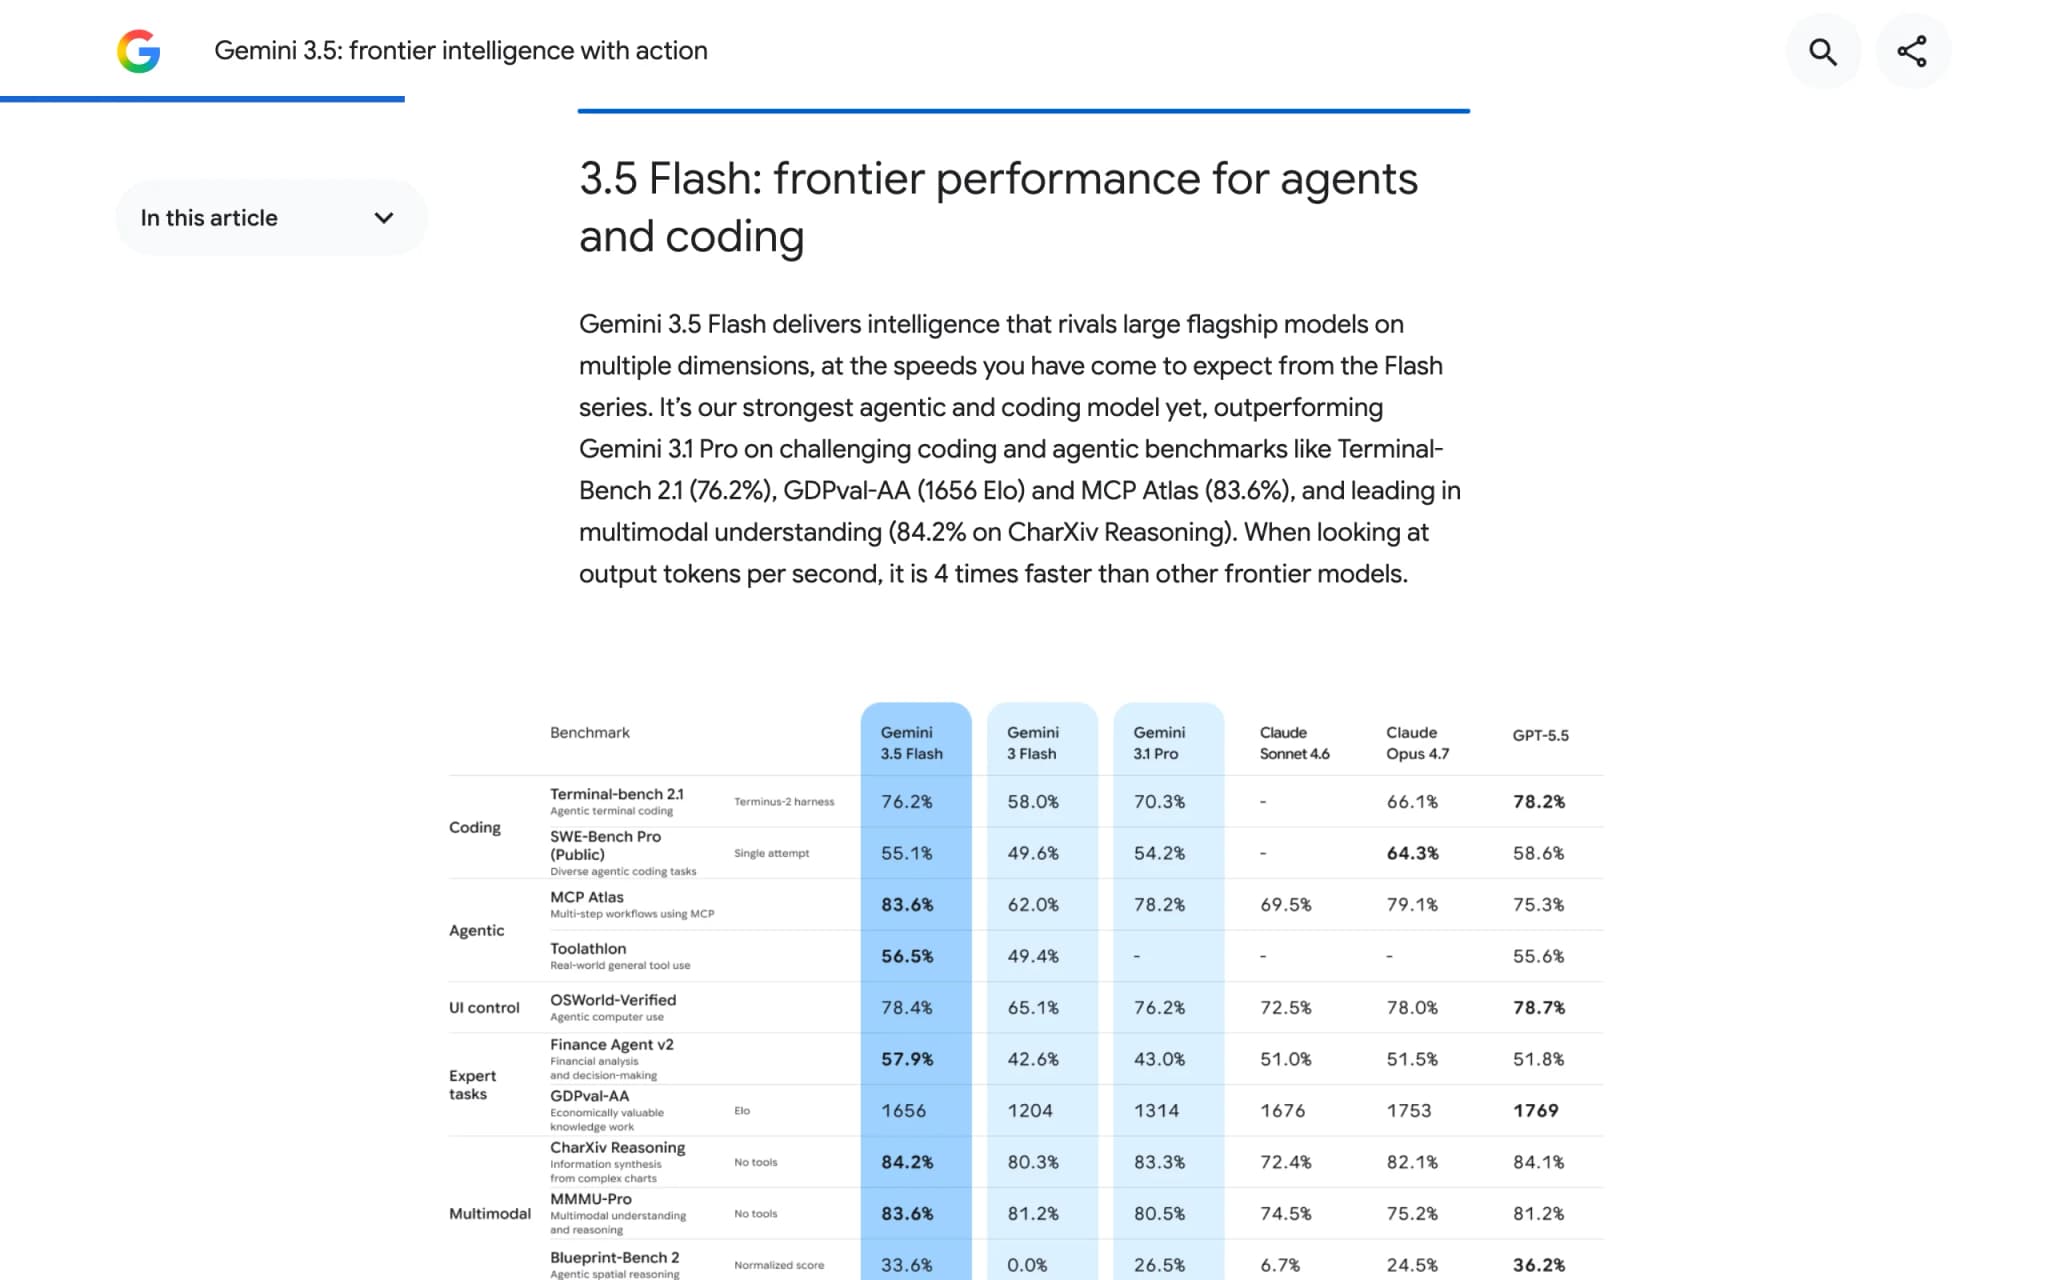
Gemini 3.5 Flash – Google 推出的一代 AI 大模型
Gemini 3.5 Flash 是 Google 推出的新一代 AI 大模型,以“前沿智能+行动能力”为核心定位,标志着 Google 在高效推理与 Agent 能力融合上的重大突破。该模型在 Terminal-Bench 2.1 编码基准上取得 76.2% 的得分,在 GDPval-AA 代理任务中达到 1656 Elo,在 MCP Atlas 上获得 83.6%,三项关键指标均超越前代旗舰 ...
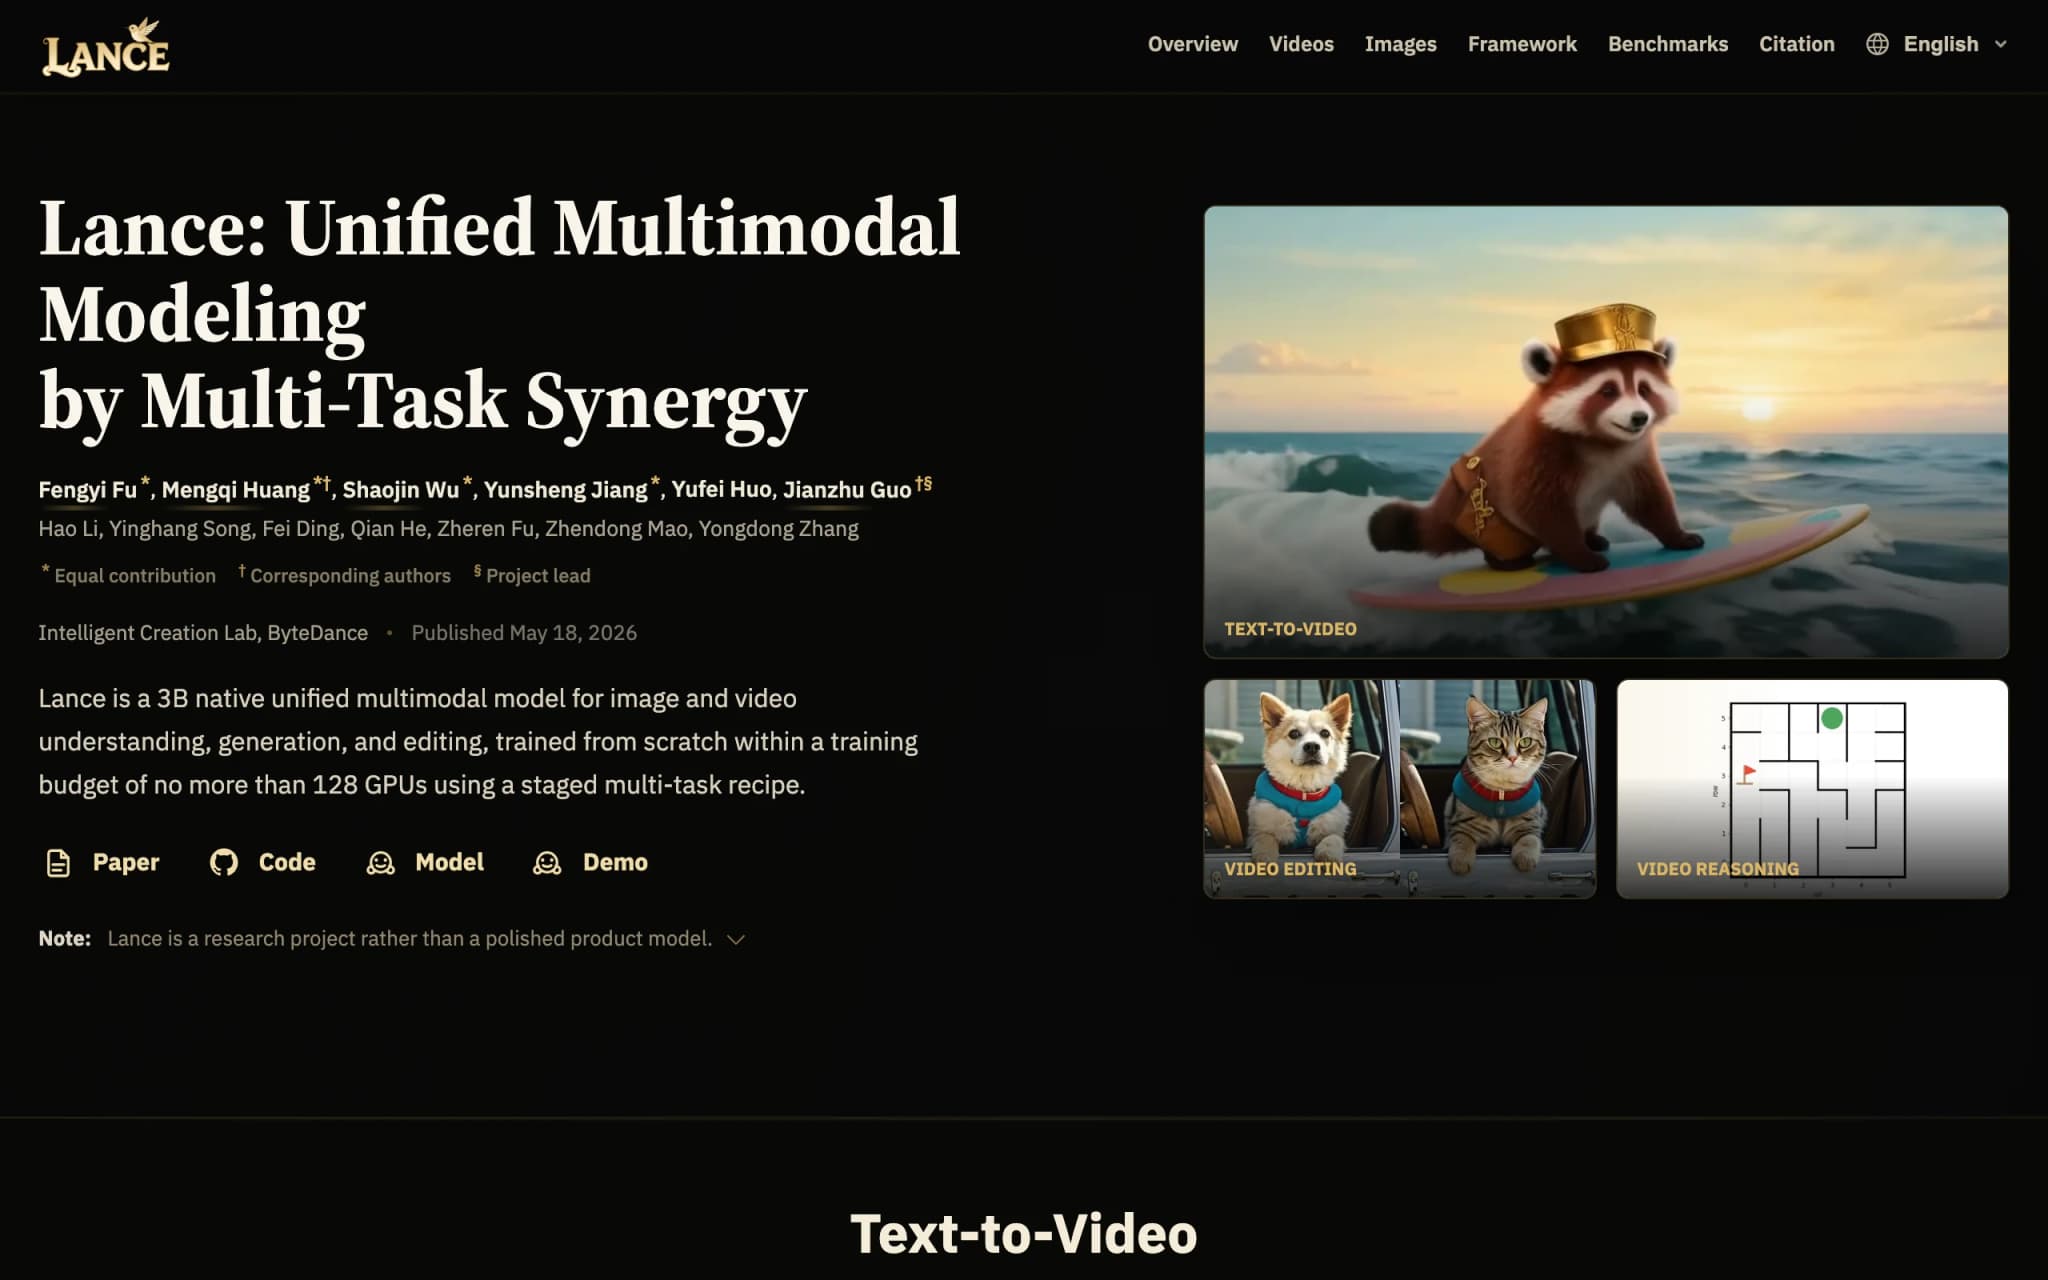
Lance – 字节跳动开源的轻量级原生统一多模态模型
Lance是字节跳动智能创作团队开源的一款轻量级原生统一多模态模型,仅需3B激活参数即可在单一框架内同时支持图像与视频的理解、生成与编辑全链路任务。该模型采用分阶段多任务方案从零训练,整个训练周期仅消耗128张A100 GPU,显著降低了大规模多模态模型的研发门槛。在GenEval、VBench等多项权威基准测试中,Lance的表现优于或持平于参数量数倍于己的开源模型,并遵循Apache-2.0开...
Qwen3.7-Max – 阿里通义推出的一代旗舰大模型
Qwen3.7-Max是阿里通义千问团队推出的面向智能体时代的新一代旗舰大模型,定位为全能智能体基座。该模型围绕前沿编程、办公自动化、长周期自主执行与跨框架泛化四大核心能力进行深度优化,在SWE-Pro、MCP-Atlas、GPQA Diamond等数十项编程、智能体与推理基准上取得领先成绩,并原生适配Claude Code、OpenClaw、Qwen Code等主流智能体框架,标志着国产大模型在...
ESP-Claw – 乐鑫开源的物联网设备 AI Agent 框架
ESP-Claw 是乐鑫科技推出的面向物联网设备的 AI Agent 框架,采用“Chat Coding”理念,允许用户通过自然语言对话定义和修改硬件设备行为。该框架基于 OpenClaw 概念,用 C 语言重新实现,专为资源受限的 ESP32 系列芯片进行深度优化。它将传统需要云端协同的 Agent 能力下沉到端侧,在本地完成从环境感知、智能决策到设备执行的完整闭环,使低成本物联网芯片具备自主决...
Qwen3.7 Preview – 阿里通义推出的下一代旗舰大模型预览版
Qwen3.7 Preview 是阿里通义千问团队推出的下一代旗舰大模型预览版,包含 Qwen3.7-Max-Preview 和 Qwen3.7-Plus-Preview 两个版本,分别瞄准极致复杂推理与均衡体验两大方向。该模型在智能体编程、世界知识和指令遵循方面实现显著提升,在 LMSYS Chatbot Arena 榜单中助力阿里跃升至文本领域第 6、视觉领域第 5,标志着国产大模型在国际主流...
Composer 2.5 – Cursor 推出的自研 Agentic 编程模型
Composer 2.5 是 Cursor 推出的自研 Agentic 编程模型,在智能水平和行为表现上较 Composer 2 有大幅提升。在 SWE-Bench Multilingual(79.8%)和 CursorBench v3.1(63.2%)等核心基准上与 Claude Opus 4.7、GPT-5.5 处于同一梯队,但单次任务成本仅为竞品的约 1/10,被称为“性价比之王”。模型基于...