AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:AI评测
共 72 篇文章 · 清除标签
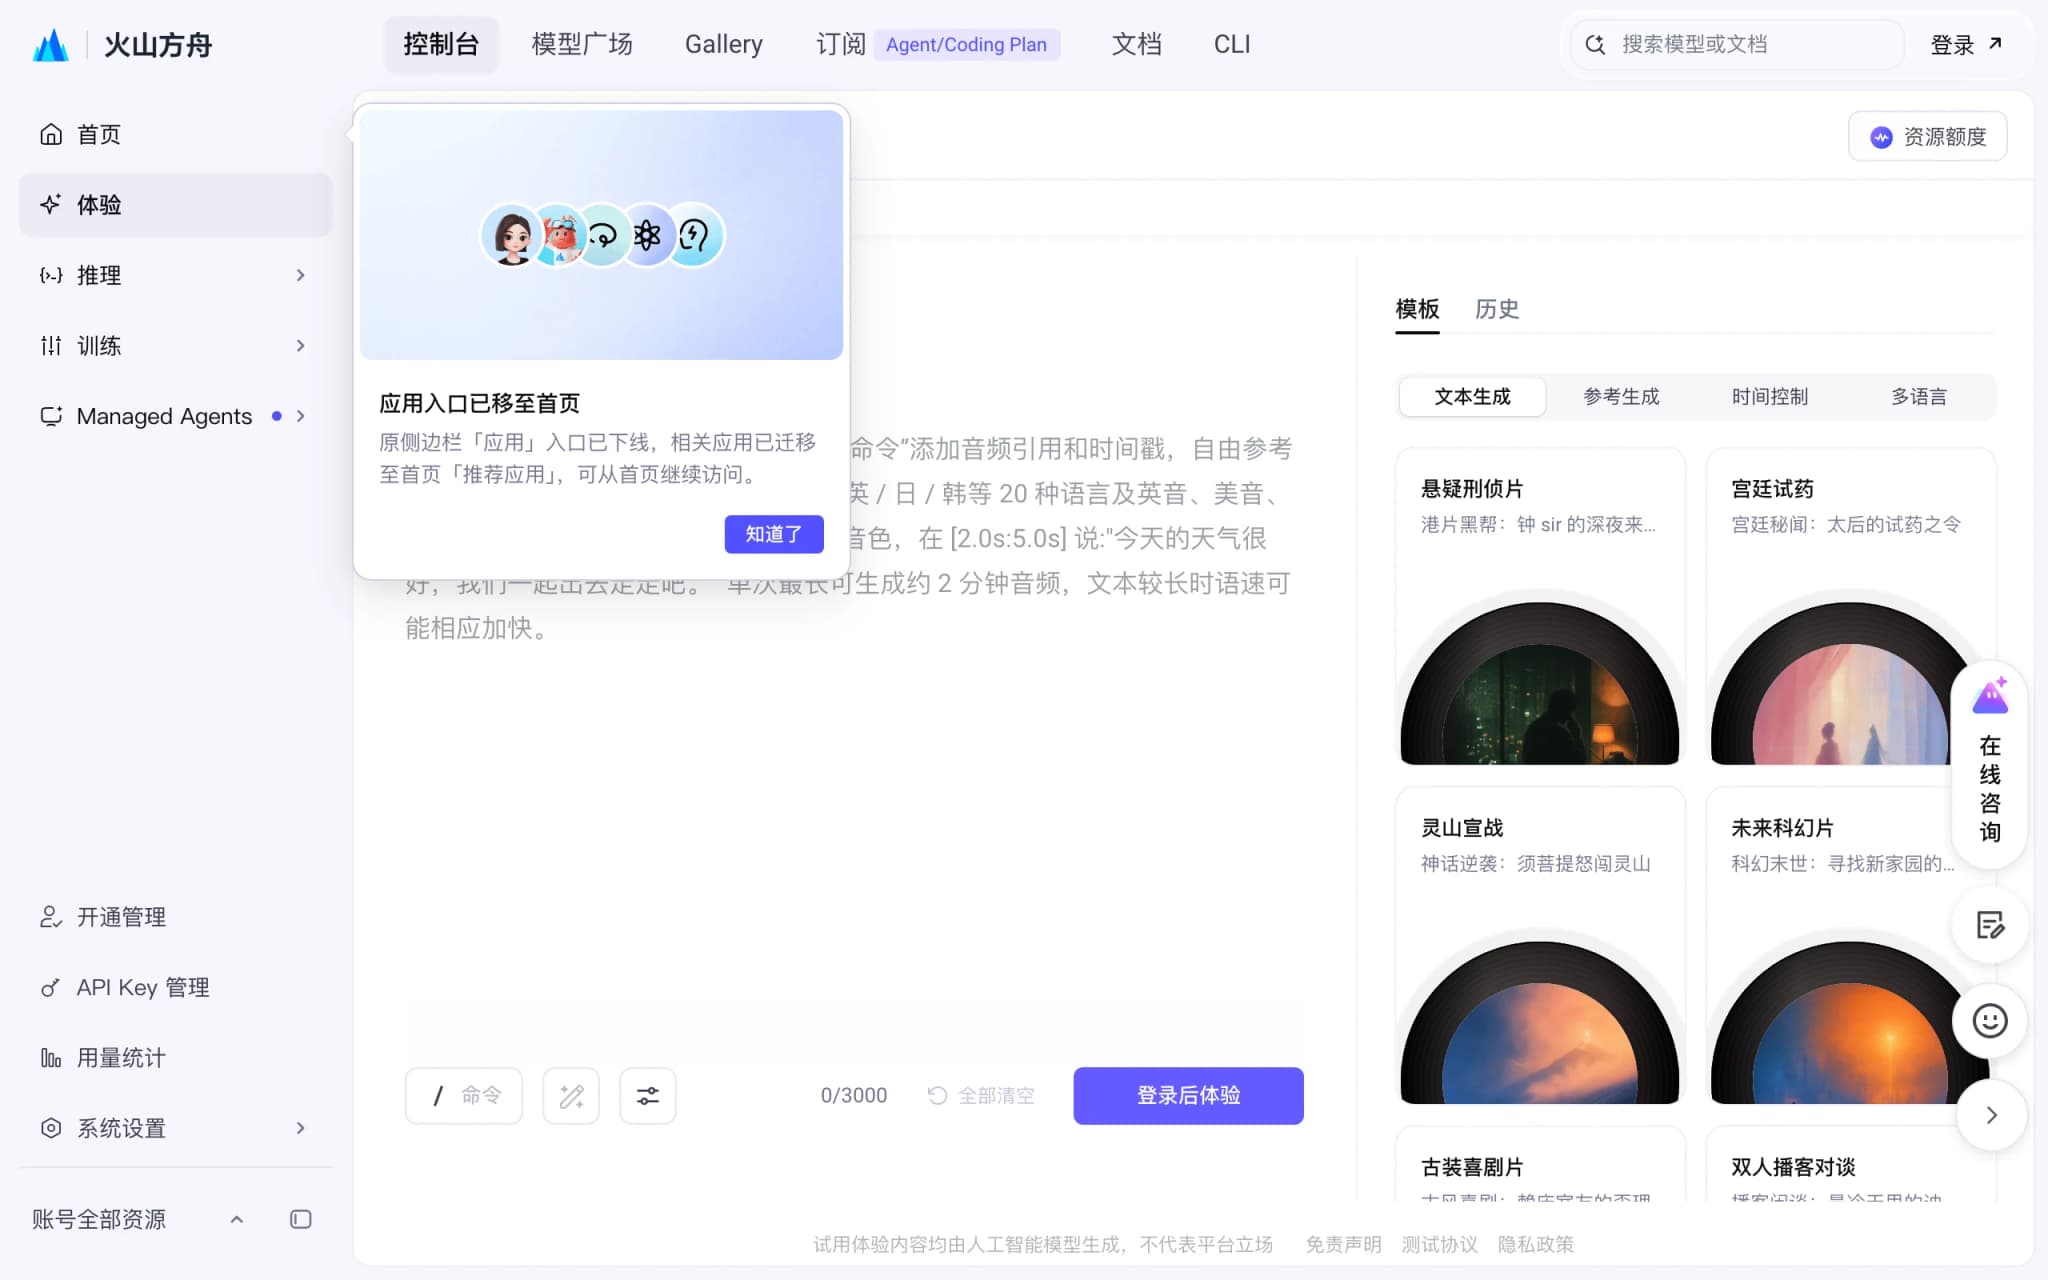
豆包音频生成模型1.0 – 火山引擎推出的端到端音频创作模型
豆包音频生成模型1.0(Seed-Audio 1.0)是火山引擎推出的端到端音频创作模型,支持文本或音频作为参考输入生成目标音频。模型单条Prompt可编排多角色对白、情绪语气、背景音乐与环境氛围,直接产出具备叙事张力的完整音频作品,无需后期多轨混音。模型在长时生成中保持音色高度一致,支持音色与风格解耦控制,覆盖有声剧、播客、品牌音频等场景。
Baichuan-M4 – 百川智能联合清华推出的医疗增强模型
Baichuan-M4是百川智能联合清华大学推出的新一代医疗增强大模型,在HealthBench综合、Hard、Professional三个权威榜单同时位列世界第一,幻觉率低至3.3%为全行业最低。该模型突破通用大模型被动应答的局限,聚焦深度问诊、全病程记忆、证据锚定与Agent自主调度四大临床核心能力,让AI从会答题真正迈向会看病。

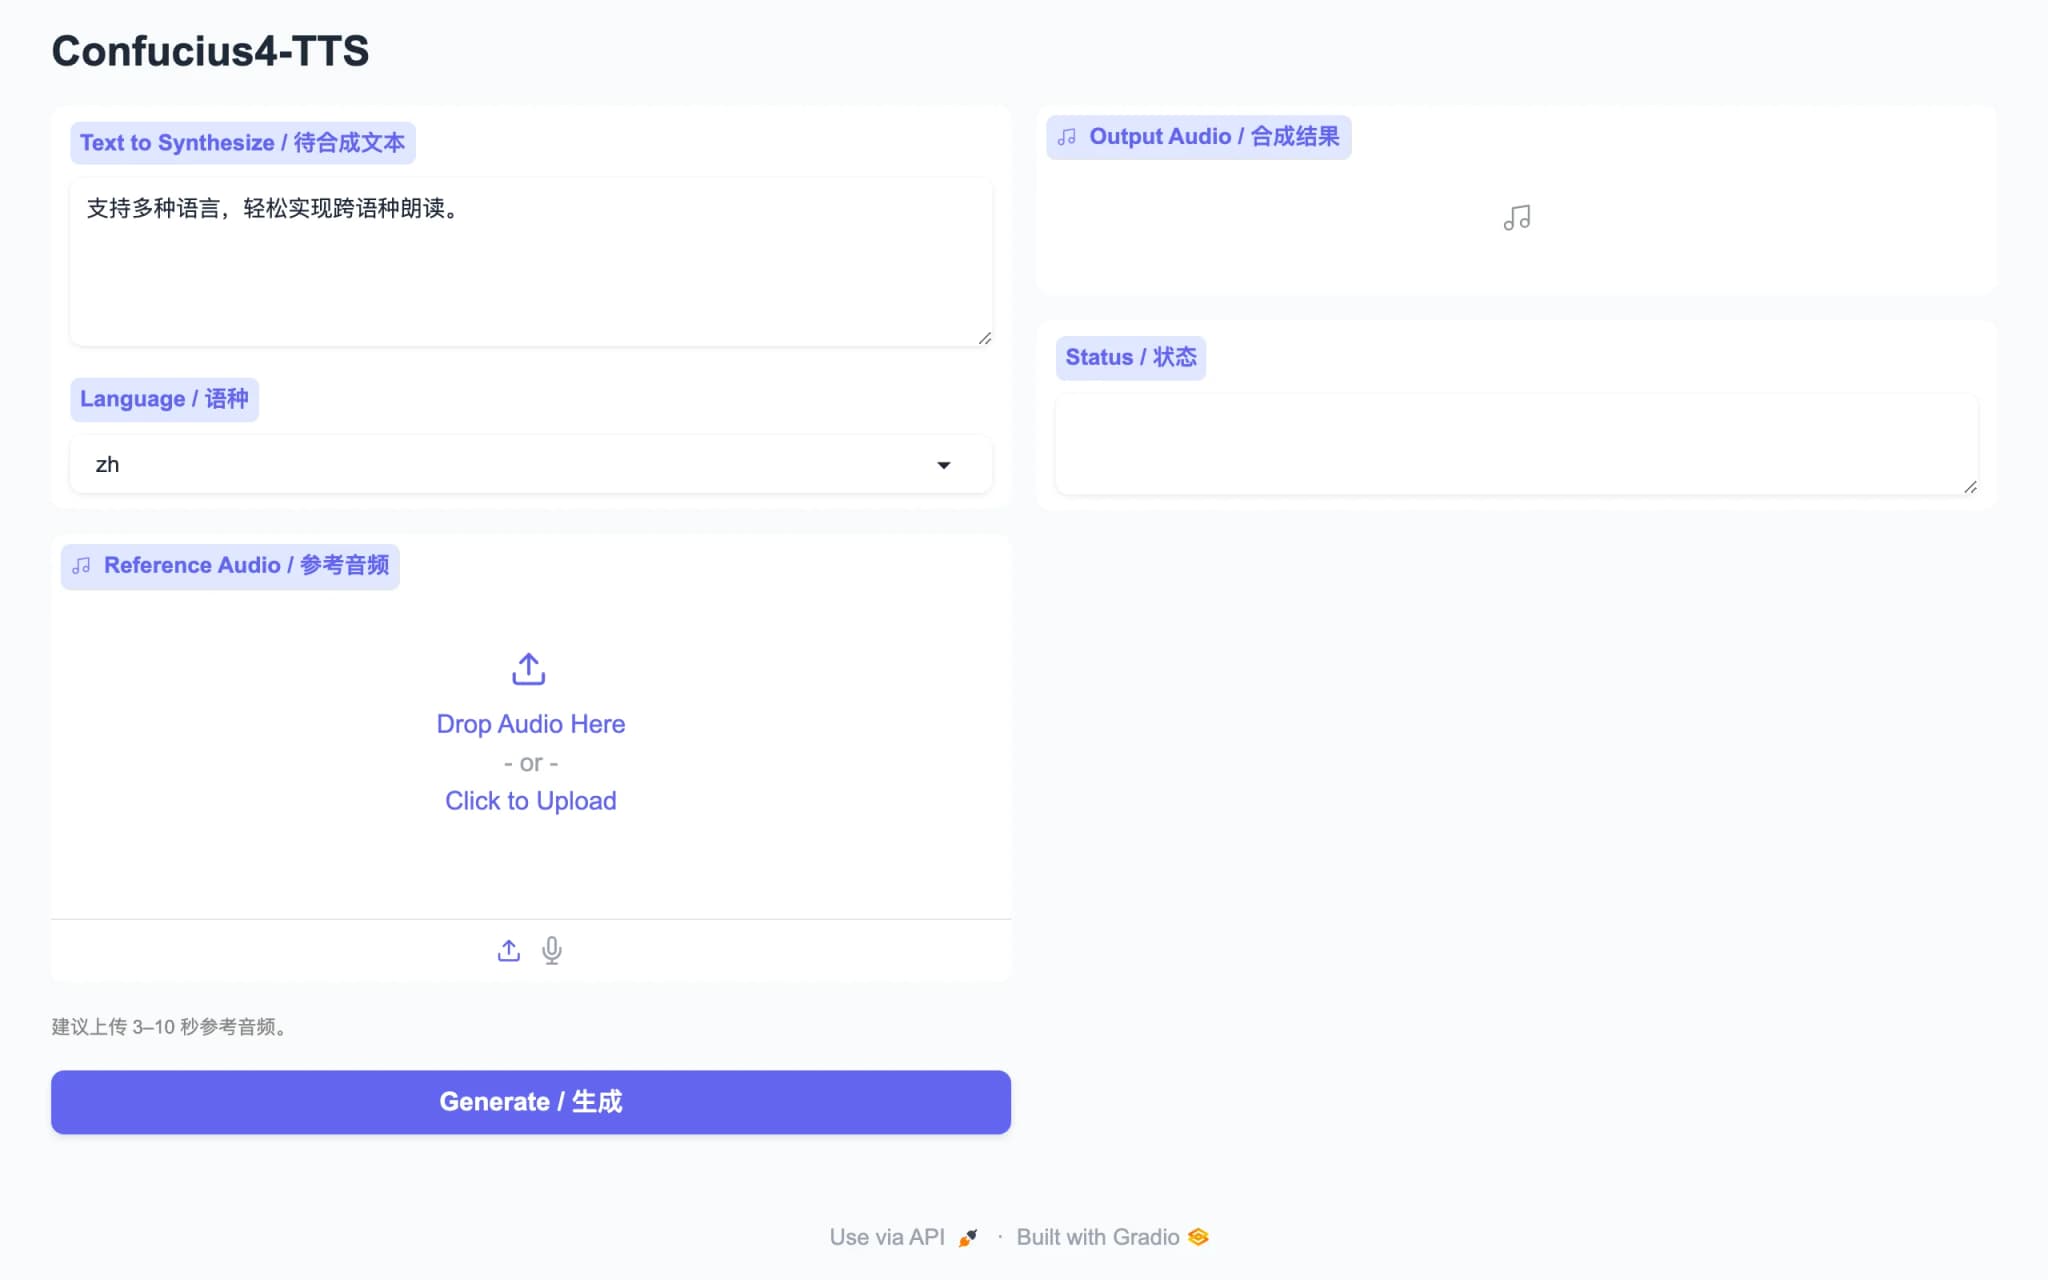
Confucius4-TTS – 网易有道开源的多语言语音合成引擎
Confucius4-TTS 是网易有道开源的 1.3B 参数多语言语音合成引擎,凭借仅需 3 秒参考音频即可实现零样本音色克隆的突破性能力,无需参考文本或转录,并支持中、英、日、韩等 14 种语言的跨语种无口音合成,同时能够迁移情感与韵律。该模型可完全本地部署与训练,适用于数字人配音、出海本地化及多语种内容创作等场景,为语音合成领域提供了高灵活性与低门槛的开源解决方案。
Gemini-SQL2 – 谷歌推出的文本转 SQL 任务 AI 模型
Gemini-SQL2是Google Research最新推出的专用于Text-to-SQL任务的AI模型,基于Gemini 3.1 Pro大语言模型进行专项后训练,在BIRD基准测试单模型赛道中以80.04%的执行准确率登顶,将自然语言直接转化为可运行的SQL查询,无需用户手写数据库语句。该模型面向企业级数据分析场景,旨在降低结构化数据查询的技术门槛,使业务人员能够通过自然语言直接获取经营指标,...
Claude Fable 5 – Anthropic 推出的最强 AI 模型
Claude Fable 5是Anthropic在其旗舰模型体系基础上推出的“安全版”最强模型,隶属于全新设立的Mythos-class能力层级。该模型在底层架构上与未设限的Claude Mythos 5完全一致,但通过加装一套保守的安全护栏系统,在保持顶尖性能的同时,实现了面向公众的开放部署。它在软件工程、知识工作、视觉推理及长周期自主任务等几乎所有公开基准测试中均达到业界领先水平(SOTA),...
WBench – 美团推出的交互式视频世界模型多轮评测基准
WBench是由美团LongCat团队推出的首个系统性多轮评测基准,专为交互式视频世界模型设计。该基准包含289个测试案例和1058个交互轮次,覆盖自然、城市、室内、工作区、幻想、运动共6类场景与写实、动漫、卡通、油画、水墨、扁平、素描7种艺术风格。WBench通过统一交互接口对20个前沿模型进行标准化评估,精准定位模型从被动观看到主动交互的能力边界,揭示当前世界模型在多轮交互、导航控制和视角切换...
PlanningBench – 腾讯混元等开源的大模型规划能力评测框架
PlanningBench 是由腾讯混元团队联合中国人民大学高瓴人工智能学院等机构推出的开源框架,专注于大语言模型的规划能力评测与训练。该框架从真实场景出发,构建了一套覆盖六大类、30余种规划任务的可验证数据生成体系,通过约束驱动的闭环合成流程,让模型规划结果从“看起来合理”走向“真的可执行”。与传统评测基准依赖静态题库或人工评分不同,PlanningBench 引入了结构化验证清单(checkl...
PawBench – 阿里通义推出的通用智能体评测基准
PawBench是通义实验室推出的通用智能体评测基准,面向个人助理与Agent场景,将底座模型与运行框架(Harness)纳入同一评测体系。PawBench v1.0构建了150道真实任务、4050个测试单元的评测集,通过9个模型×3个Harness的交叉评测,能够评估模型+Harness的最佳组合,帮助Harness开发者精准定位问题并验证优化效果,为Agent系统的协同进化提供了可量化、可复现...
Hy-Memory – 腾讯混元推出的 Agent 记忆插件
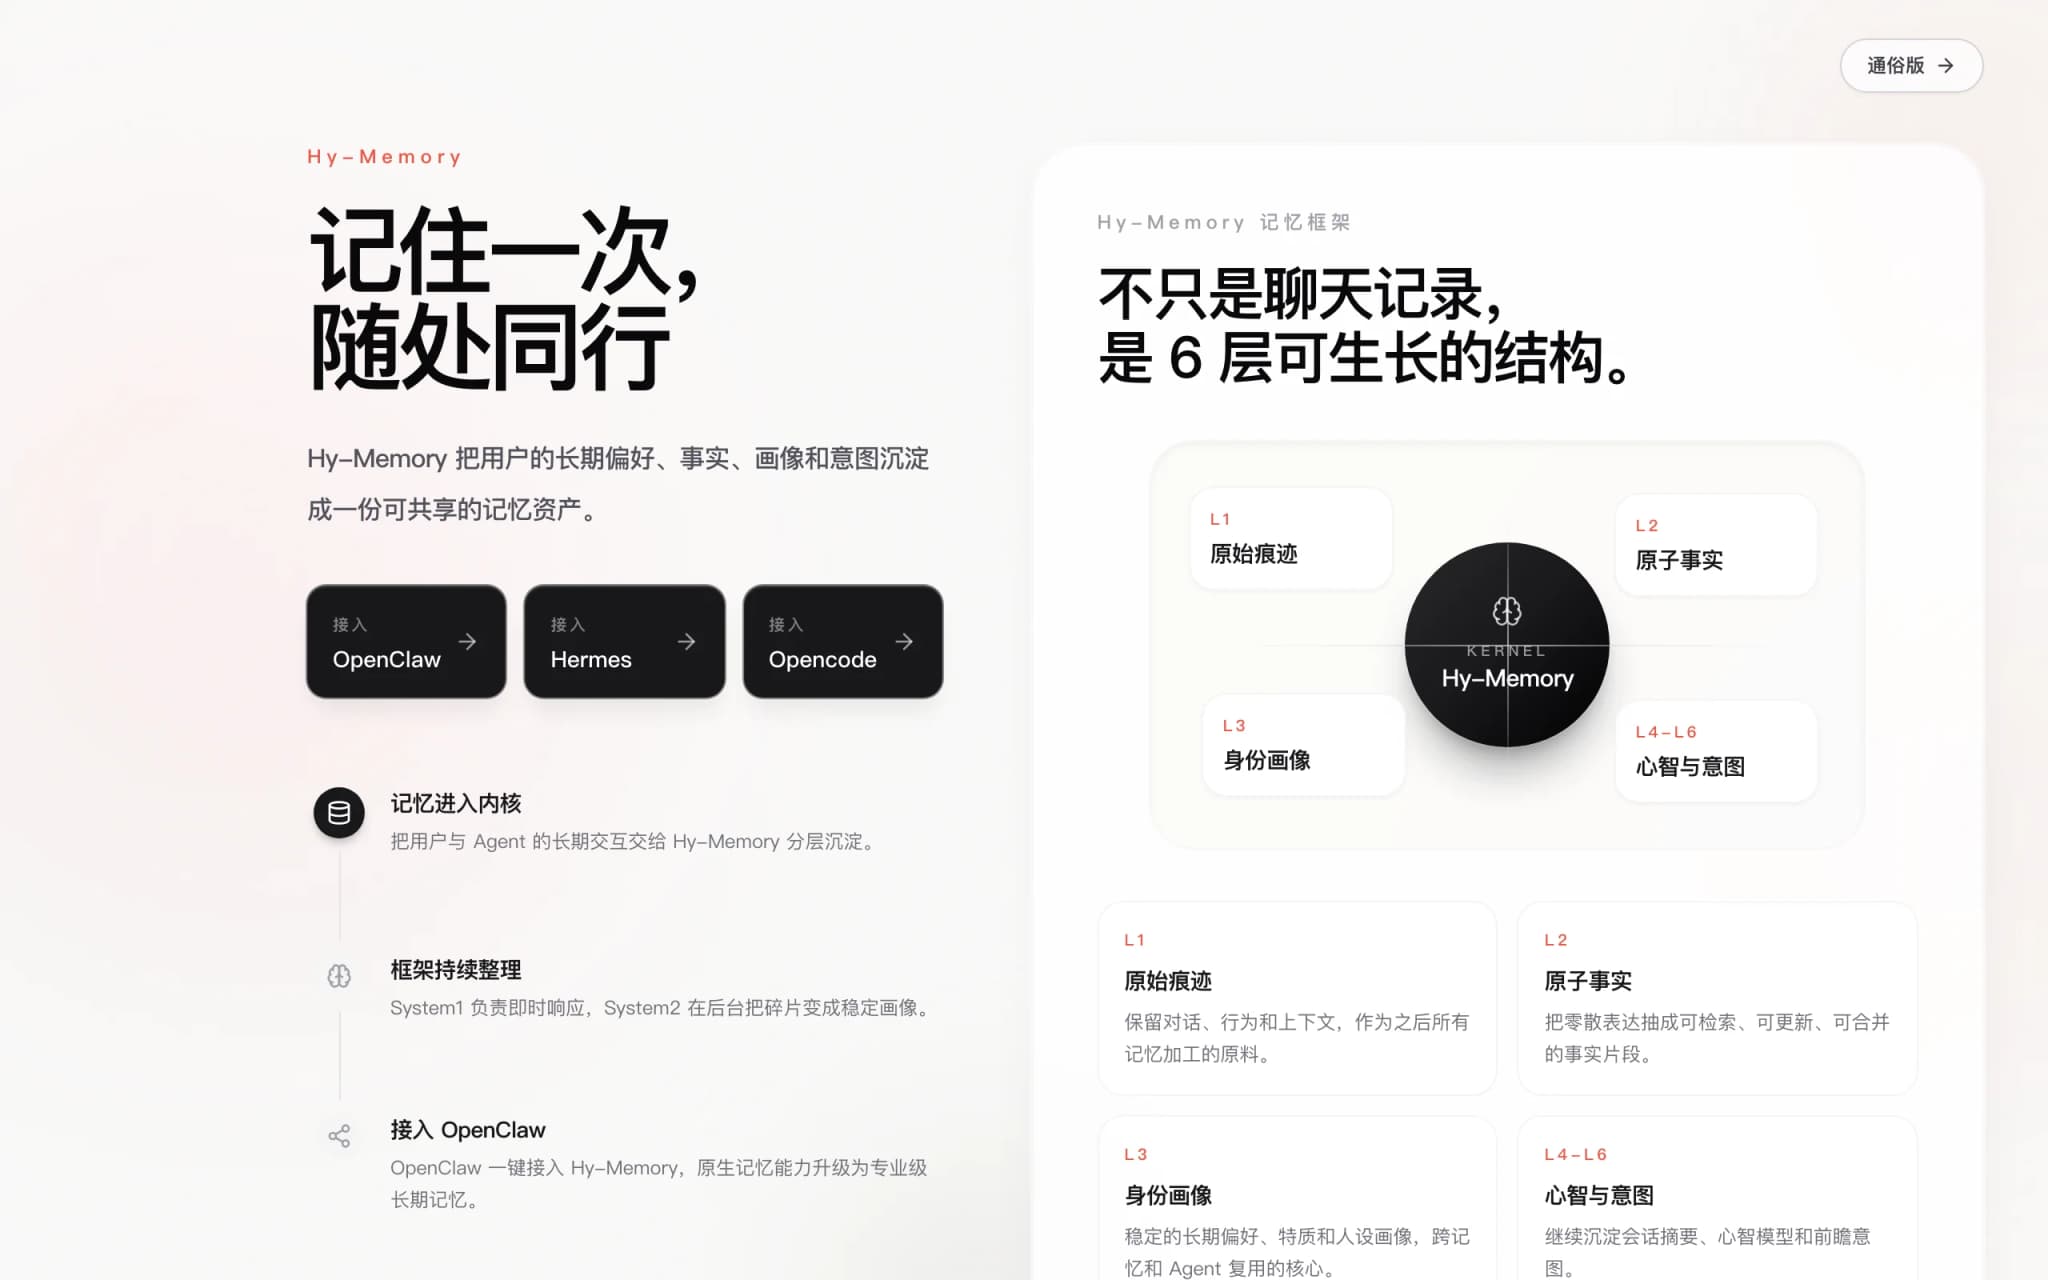
Hy-Memory是腾讯混元团队专为OpenClaw等长期协作型Agent设计的专业记忆插件,通过6层记忆框架、System1/System2双系统处理机制以及演化链三层架构,实现了对Agent记忆的精细化管理。该框架在LongMemEval和PersonaMem两大权威评测中均位列同类框架第一,记忆数量降低70%以上,信息密度提升45%,写入速度达到同类产品的8倍,为Agent提供了真正意义上的...
MAI-Image-2.5 – 微软推出的旗舰级文生图模型
MAI-Image-2.5是微软研究院推出的旗舰级文生图模型,作为MAI-Image系列的最强版本,它在Arena文生图排行榜上以1,254分的成绩跃升至第3名,较前代提升了72分,成功打破了Google DeepMind与OpenAI对前五名的长期垄断。该模型的核心突破在于重点增强了文字渲染与商业视觉能力,能够精准生成包含文字内容的海报、包装、标签等商业物料。同时,它在视觉推理、画面一致性和指令...