AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:模型推理
共 86 篇文章 · 清除标签
openPangu 2.0 – 华为开源的盘古大模型升级版
openPangu 2.0 是华为基于盘古大模型推出的重大升级版本,提供最高505B参数的Pro版本与92B参数的Flash版本,统一搭载512K超长上下文窗口。该模型从算法架构到训练推理全面原生深度调优昇腾与麒麟芯片,将于2026年6月30日起全链路陆续开源模型结构、权重、技术报告、推理代码、预训练代码、后训练代码及训练算子,是业界少数完整开放训练链路的超大规模MoE模型。

SwarmFlow – openJiuwen 开源的多智能体工作流编排框架
SwarmFlow 是由 openJiuwen 团队开源的多智能体可控工作流编排框架,其核心理念在于将编排逻辑与智能推理彻底分离:协作流程由系统通过预定义脚本稳定执行,而推理判断则交由 Agent 自主完成。该框架通过 `workflow.py` 脚本将团队协作流程算子化,支持并行、流水线、分阶段等多种编排模式,内置于 JiuwenSwarm 平台的 SwarmSkill Creator 中,用户...
HPC-Ops – 腾讯混元开源的工业级高性能大模型推理算子库
HPC-Ops是腾讯混元AI Infra团队开源的一款工业级高性能大模型推理算子库,专为应对生产环境中大规模、高并发的推理负载而设计。它并非单一的算子优化,而是覆盖了从Attention、MoE、GEMM到通信融合与采样的完整推理链路,通过深度软硬件协同设计,实现了端到端的性能飞跃。基于NVIDIA H20等SM90架构GPU,HPC-Ops通过动态调度与算子融合技术,将端到端的QPM(每秒查询量...
DiffusionGemma – 谷歌开源的实验性文本扩散模型
DiffusionGemma是由Google DeepMind推出的实验性开源文本扩散模型,基于Gemma 4架构与Gemini Diffusion研究成果构建。该模型采用26B参数MoE(混合专家)设计,通过并行去噪256-token文本块的方式,在单张NVIDIA H100上实现超过1000 tokens/秒的生成速度,较传统自回归模型提升约4倍。模型支持双向注意力机制与实时自我纠错能力,量化...
WBench – 美团推出的交互式视频世界模型多轮评测基准
WBench是由美团LongCat团队推出的首个系统性多轮评测基准,专为交互式视频世界模型设计。该基准包含289个测试案例和1058个交互轮次,覆盖自然、城市、室内、工作区、幻想、运动共6类场景与写实、动漫、卡通、油画、水墨、扁平、素描7种艺术风格。WBench通过统一交互接口对20个前沿模型进行标准化评估,精准定位模型从被动观看到主动交互的能力边界,揭示当前世界模型在多轮交互、导航控制和视角切换...
VitaBench 2.0 – 美团 LongCat 推出的长期动态智能体评测基准
VitaBench 2.0是由美团LongCat团队推出的首个面向真实生活场景的长期动态用户建模智能体评测基准。该基准包含56名基于真实世界统计数据构建的拟真用户、819个贯穿用户生命周期的复杂任务、超过2000个动态演化的用户偏好以及66个可执行工具,平均交互跨度达到1580天(最长2974天),旨在系统性地评测大语言模型在长期互动中的个性化理解、主动服务与动态适应能力。
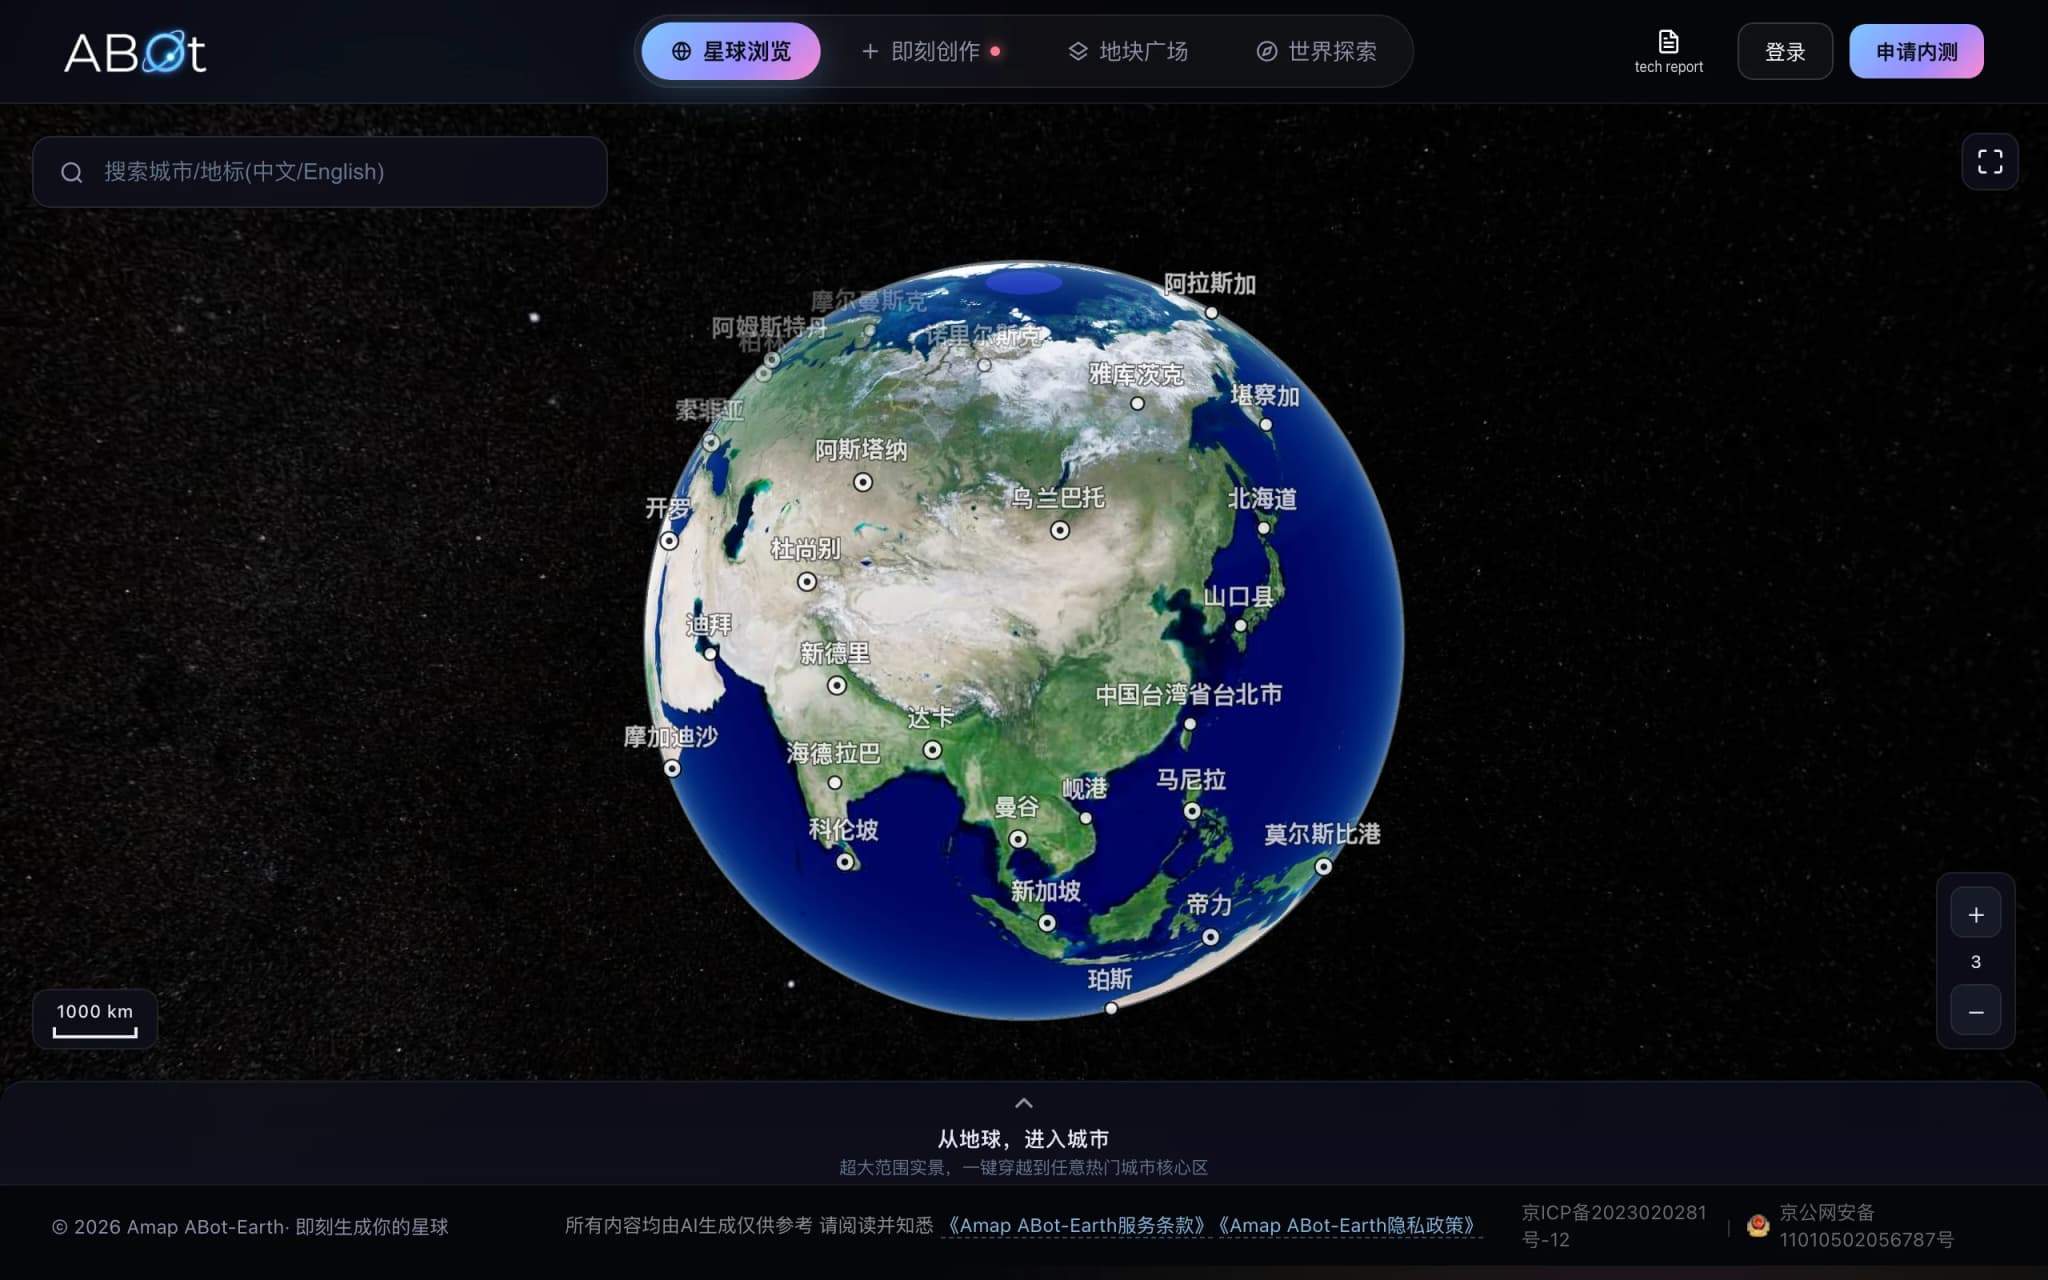
ABot-Earth 0.5 – 高德推出的全球首个3D原生城市世界模型
ABot-Earth 0.5是阿里巴巴集团旗下高德地图推出的全球首个3D原生城市世界模型,定位为自动化3D城市工厂。用户只需输入单张卫星图像或一段文字描述,系统即可在消费级GPU上于10分钟内生成公里级高精度3D城市场景,输出可编辑的3D Gaussian Splatting(3DGS)格式素材,可直接导入Unity、Unreal Engine等主流引擎使用。这一突破性技术将传统需要数天甚至数周的...
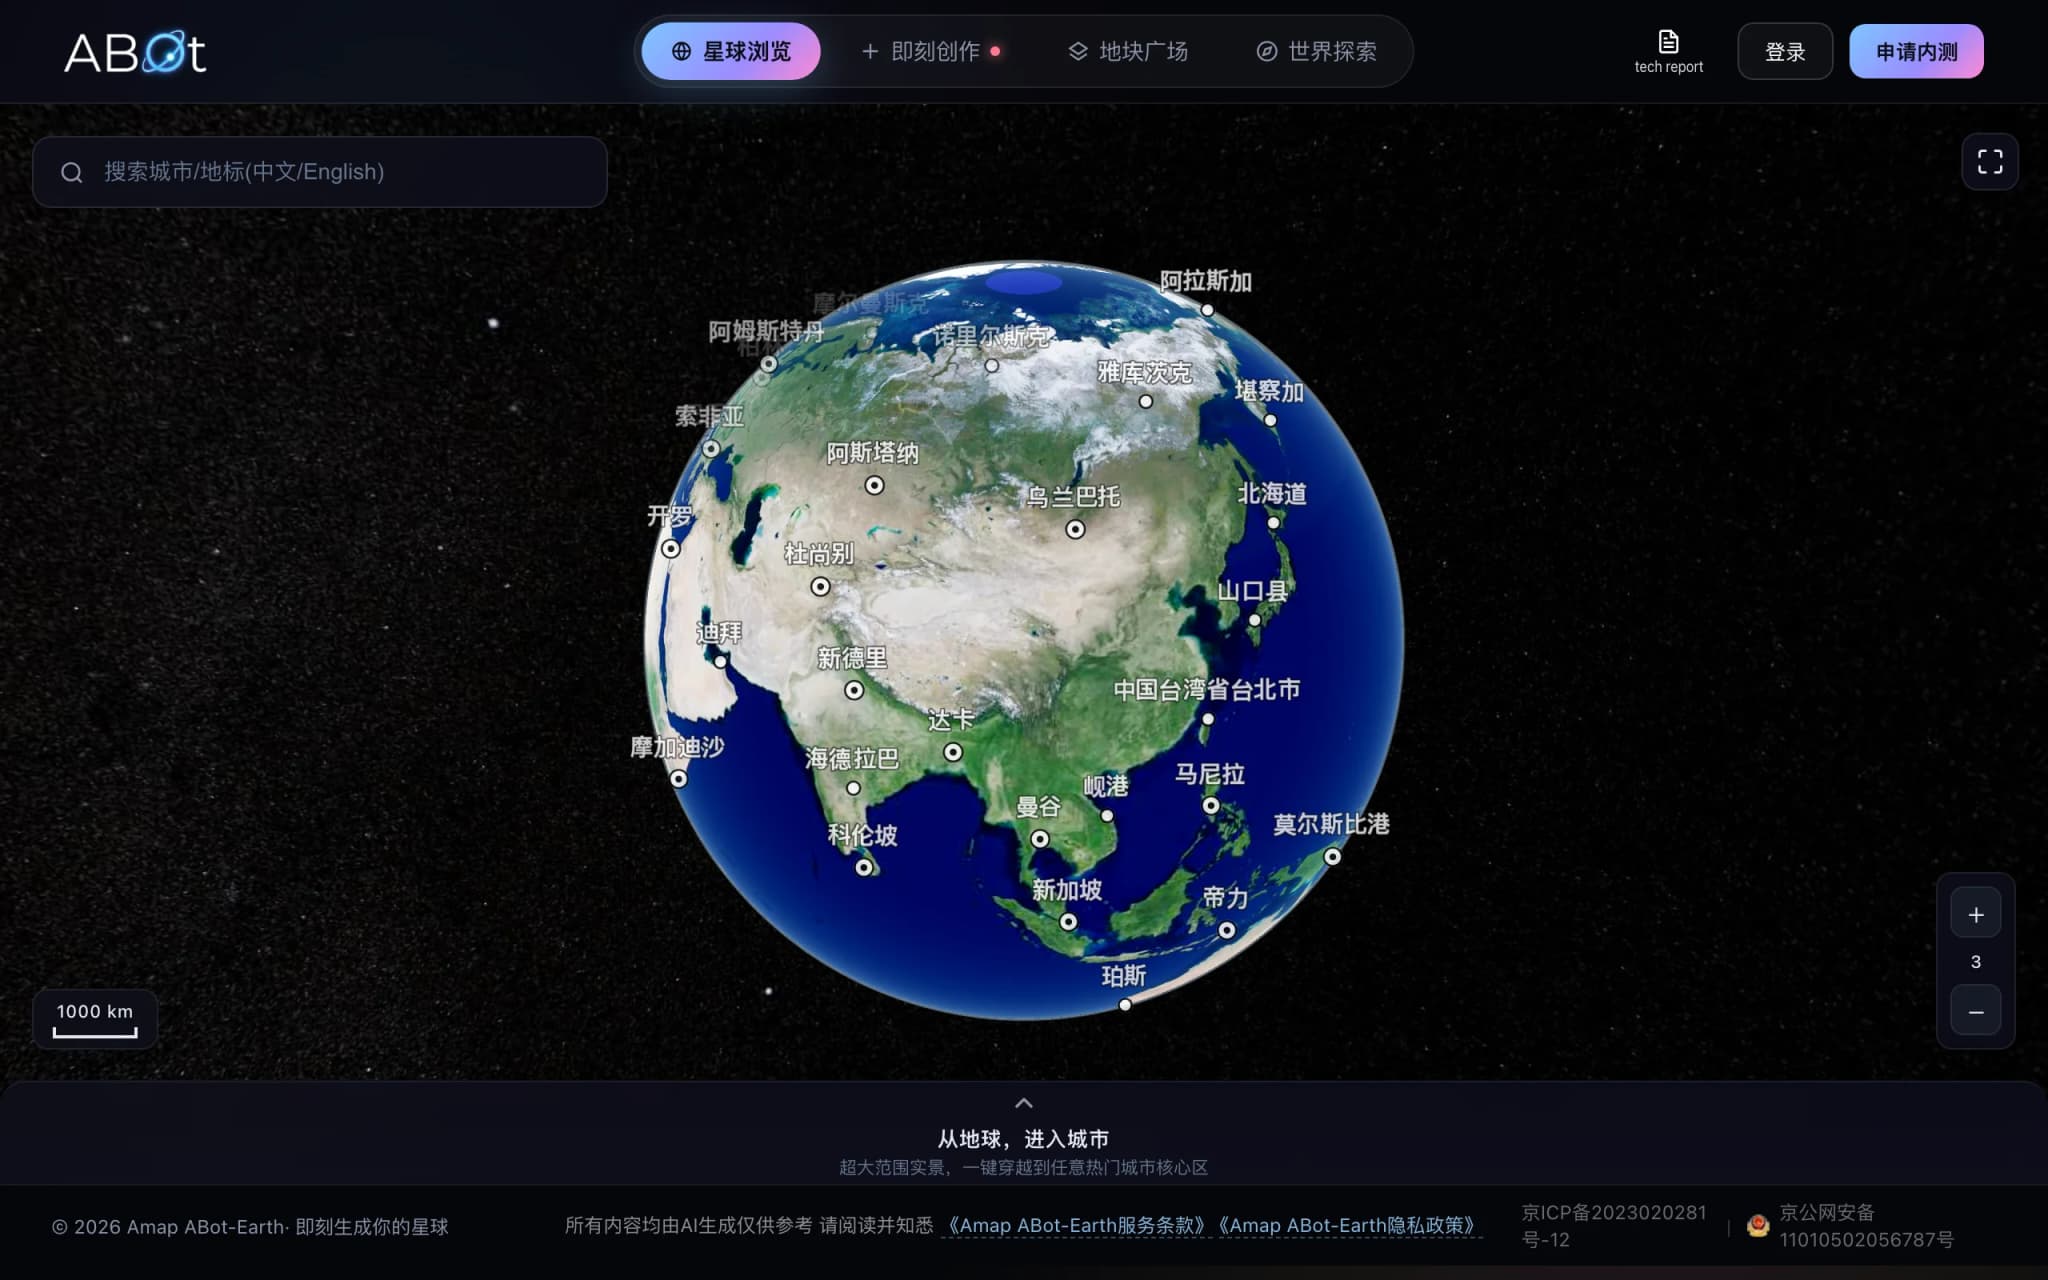
ABot-Earth0.5 – 高德推出的全球首个3D原生城市世界模型
ABot-Earth0.5是阿里巴巴集团旗下高德地图推出的全球首个3D原生城市世界模型,定位为自动化3D城市工厂。用户仅需输入单张卫星图像或一段文字描述,系统即可在消费级GPU上约10分钟内生成公里级高精度3D城市场景,输出可编辑的3D Gaussian Splatting(3DGS)格式素材,并直接导入Unity、Unreal Engine等主流引擎使用。该模型通过生成式AI端到端重建管线,将传...
PawBench – 阿里通义推出的通用智能体评测基准
PawBench是通义实验室推出的通用智能体评测基准,面向个人助理与Agent场景,将底座模型与运行框架(Harness)纳入同一评测体系。PawBench v1.0构建了150道真实任务、4050个测试单元的评测集,通过9个模型×3个Harness的交叉评测,能够评估模型+Harness的最佳组合,帮助Harness开发者精准定位问题并验证优化效果,为Agent系统的协同进化提供了可量化、可复现...
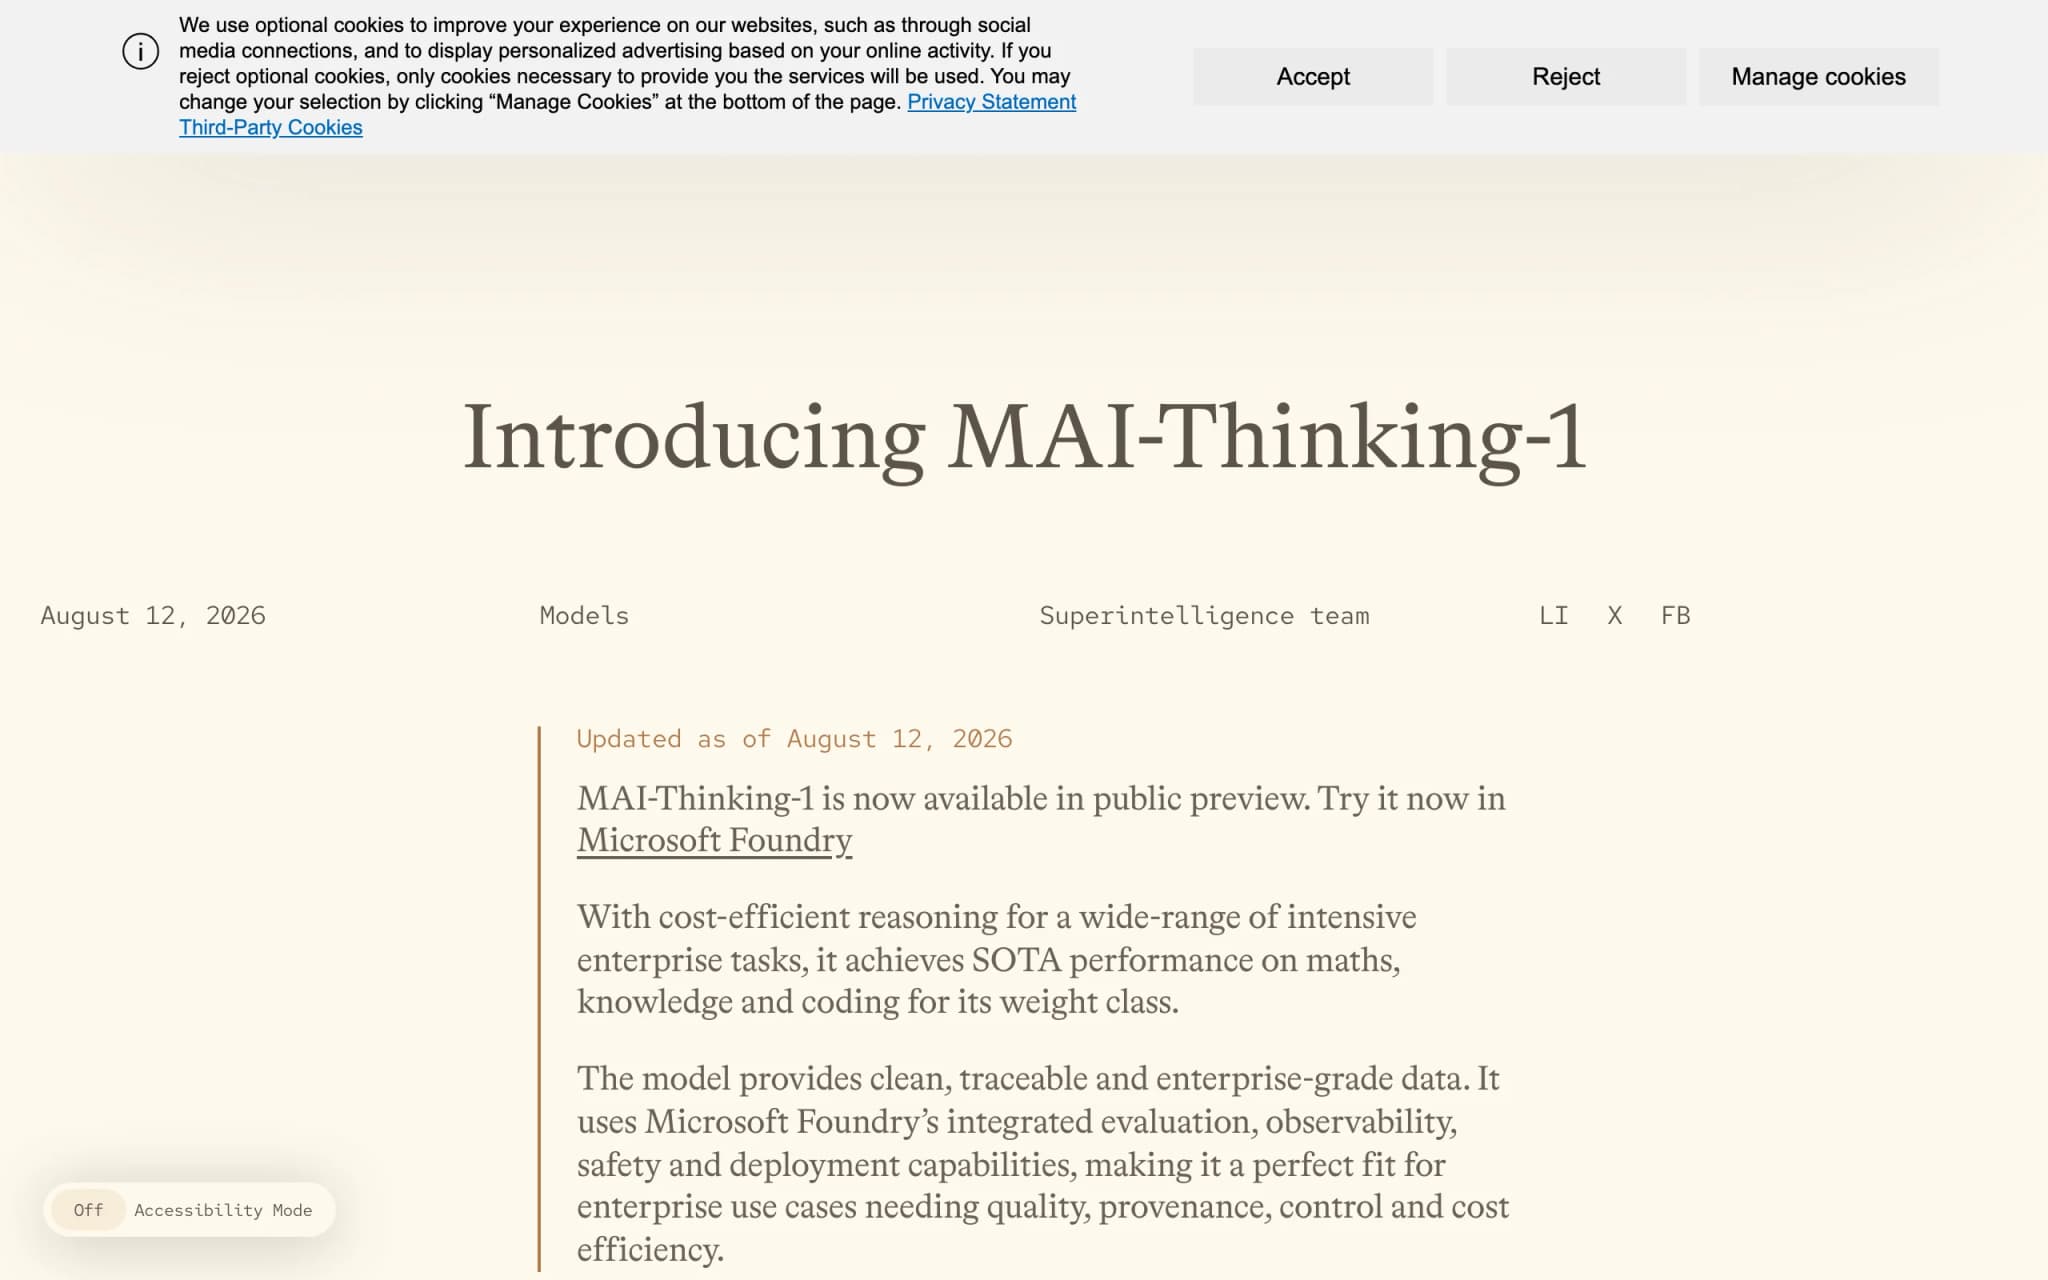
MAI-Thinking-1 – 微软推出的首款自研高级推理模型
MAI-Thinking-1是微软推出的首款自研高级推理模型,标志着微软在基础大模型领域从跟随者向领跑者的战略转型。该模型采用35B活跃参数/约1T总参数的稀疏MoE架构,完全基于干净、商业授权数据从头训练,未使用任何第三方模型蒸馏,在SWE-Bench Pro、AIME 2025/2026等关键基准上达到业界顶尖水平,与Claude Opus 4.6持平,在盲测中优于Sonnet 4.6。MAI...