AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
U2 – 云知声推出的原生智能体大模型
U2是云知声面向个人、开发者与组织推出的原生智能体大模型,拥有2660亿参数却达到1.2万亿参数级性能,核心理念为“高智能密度×高Token价值”。该模型通过混合思考机制与Agent-Harness协同训练,能够自主拆解并完成100+步复杂真实工作流,在GPQA、SWE-Bench、Claw-Eval等多项评测中进入国产大模型第一梯队。U2并非传统意义上的对话式语言模型,而是以任务执行为核心的原生...
Magenta RealTime 2 – 谷歌Magenta开源的实时音乐生成模型
Magenta RealTime 2(MRT2)是谷歌 Magenta 团队推出的第二代开源本地实时音乐生成模型,基于逐帧自回归架构,将音频生成延迟压缩至约200毫秒,实现接近真实乐器演奏的交互体验。该模型采用编解码器语言模型范式,通过 SpectroStream 音频编解码器将48kHz立体声离散化为25Hz帧率的标记序列,以40毫秒每帧的粒度逐帧预测并解码输出。MRT2提供 mrt2_base...
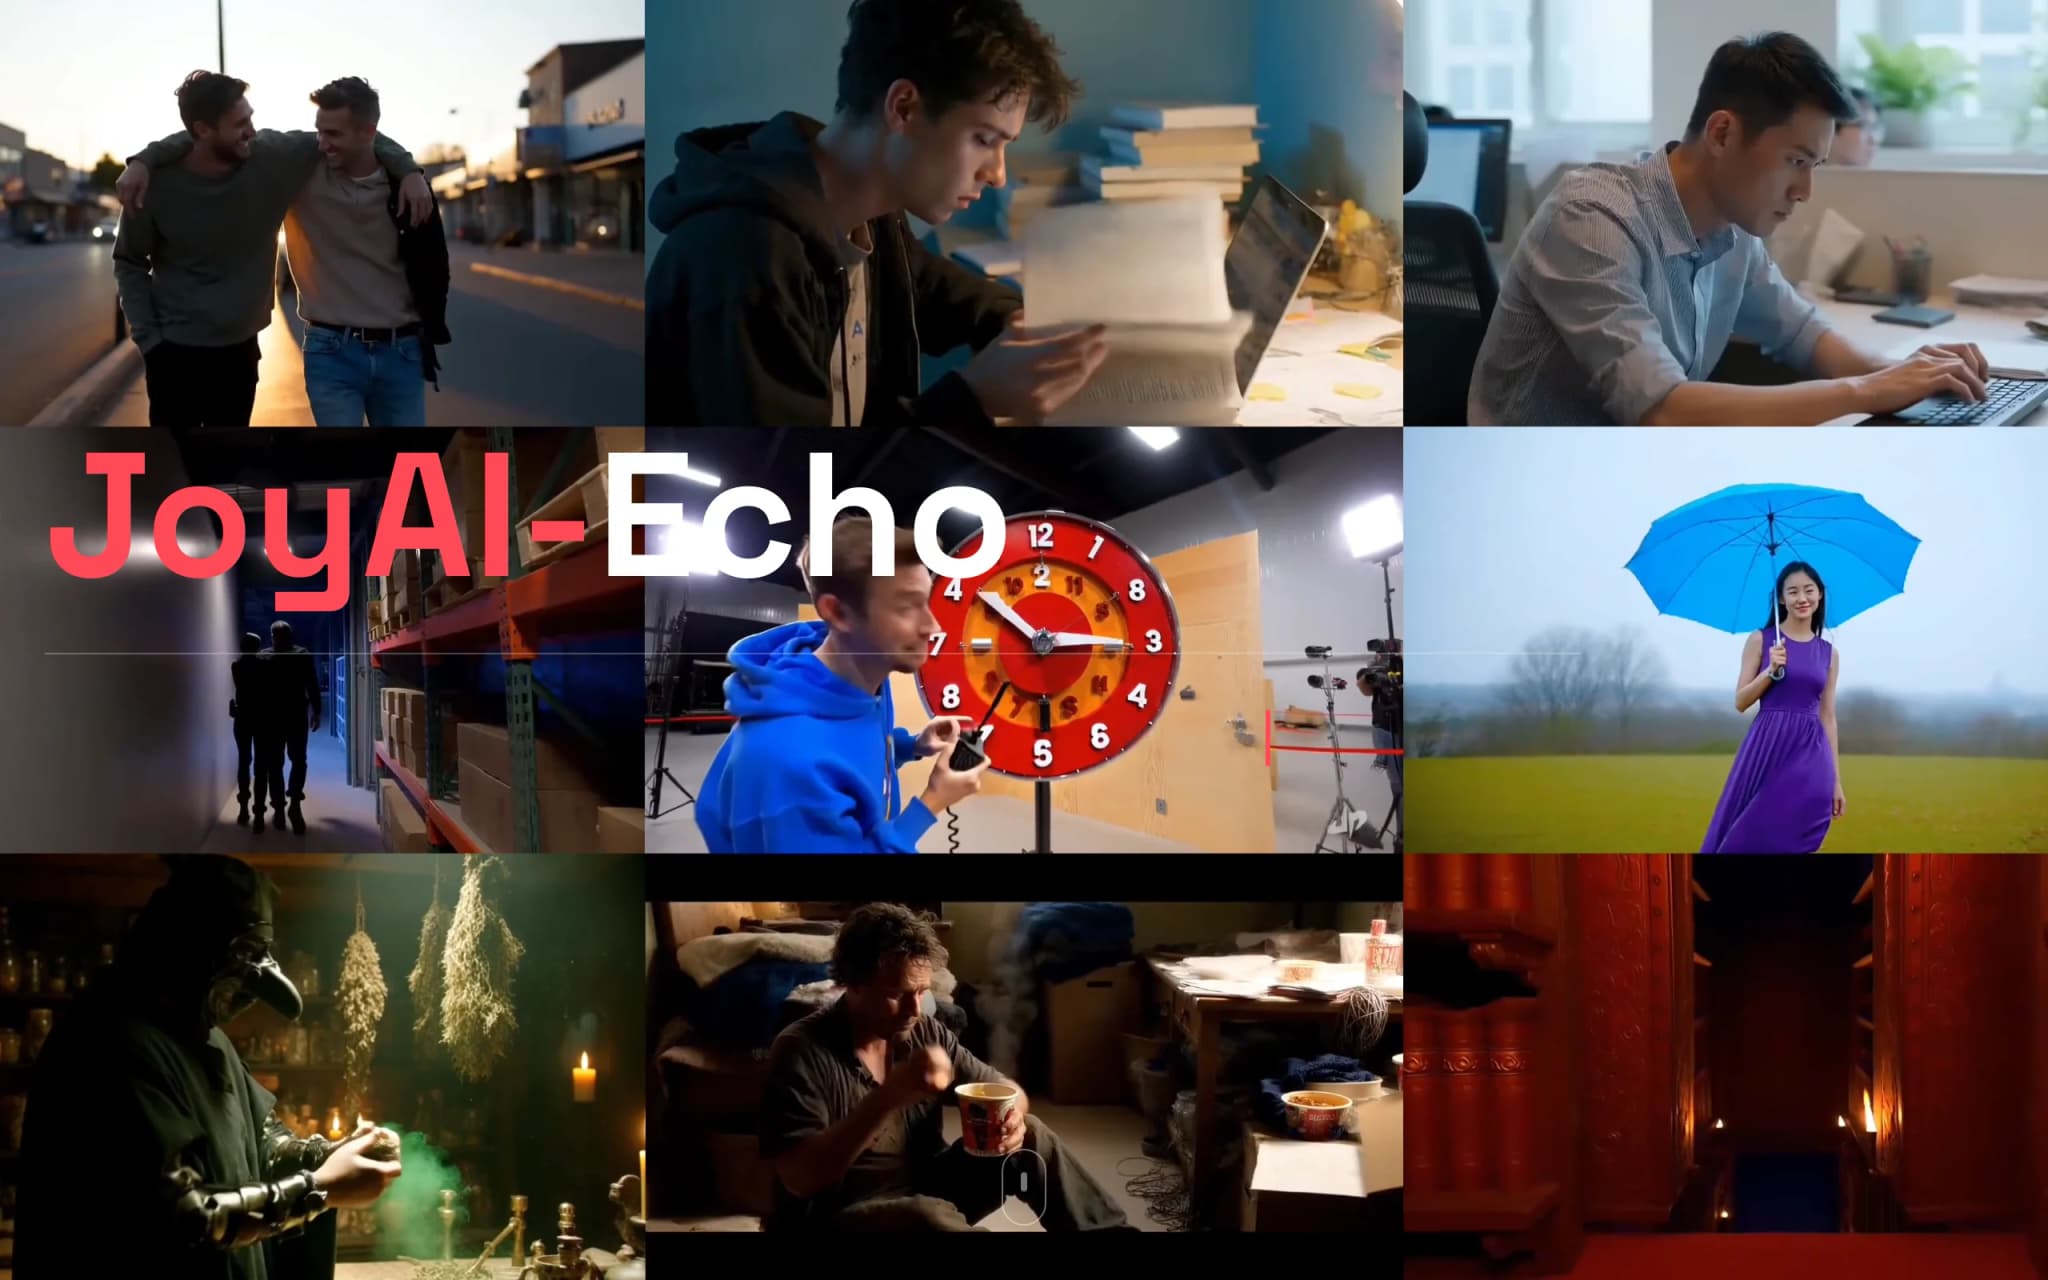
JoyAI-Echo – 京东开源的长音视频生成框架
JoyAI-Echo是京东未来实验室推出的开源长音视频生成框架,专为分钟级多镜头故事生成设计。该框架通过跨模态记忆库、记忆驱动后训练、Director Agent对话式编辑和轻量化实时超分四大技术创新,解决了长视频生成中角色变脸、音色突变、生成缓慢等核心痛点,首次实现长达5分钟的高一致性、可交互、高清长视频生成。作为基于LTX-2.3与Gemma-3-12B构建的端到端系统,JoyAI-Echo标...
MAI-Voice-2 – 微软推出的一代文本转语音模型
MAI-Voice-2 是微软于2026年6月推出的新一代文本转语音(TTS)模型,基于自研语音基础架构,在保真度、语言覆盖、说话人一致性和情感表达能力上实现了代际飞跃。该模型支持15+种语言,具备细粒度情感控制、零样本语音克隆和自然代码切换能力,在盲测中72%的听众偏好其音质超过前代,合成语音与真人录音的相似度达到难以区分的水平。作为微软AI语音体系的核心组件,MAI-Voice-2面向企业级应...
Dubbing v2 – ElevenLabs 推出的 AI 配音模型
Dubbing v2是ElevenLabs在AI配音领域的最新力作,一个集语音识别、神经机器翻译、语音克隆与合成于一体的端到端多语言配音平台。它能够将视频或音频内容自动翻译并配音成29种语言,同时高度保留原始说话人的音色、情感和语调,彻底颠覆了传统配音行业高成本、低效率的工作模式。该模型通过双工作流设计(快速自动配音与精细项目编辑),兼顾了内容创作者对效率和质量的双重需求,为全球内容本地化提供了一...

ControlFoley – 小米开源的可控视频音效生成模型
ControlFoley是由小米研究院开源的可控视频音效生成模型,旨在解决视频到音频(V2A)领域长期存在的可控性难题。该模型统一支持三类视频配音任务:文本引导配音(TV2A)、文本控制配音(TC-V2A)和参考音频控制配音(AC-V2A),通过自研的时空音视频编码器CAV-MAE-ST、时间-音色解耦机制与模态鲁棒训练策略,实现了语义对齐、时间同步与音质的全面提升。在VGGSound-Test、...
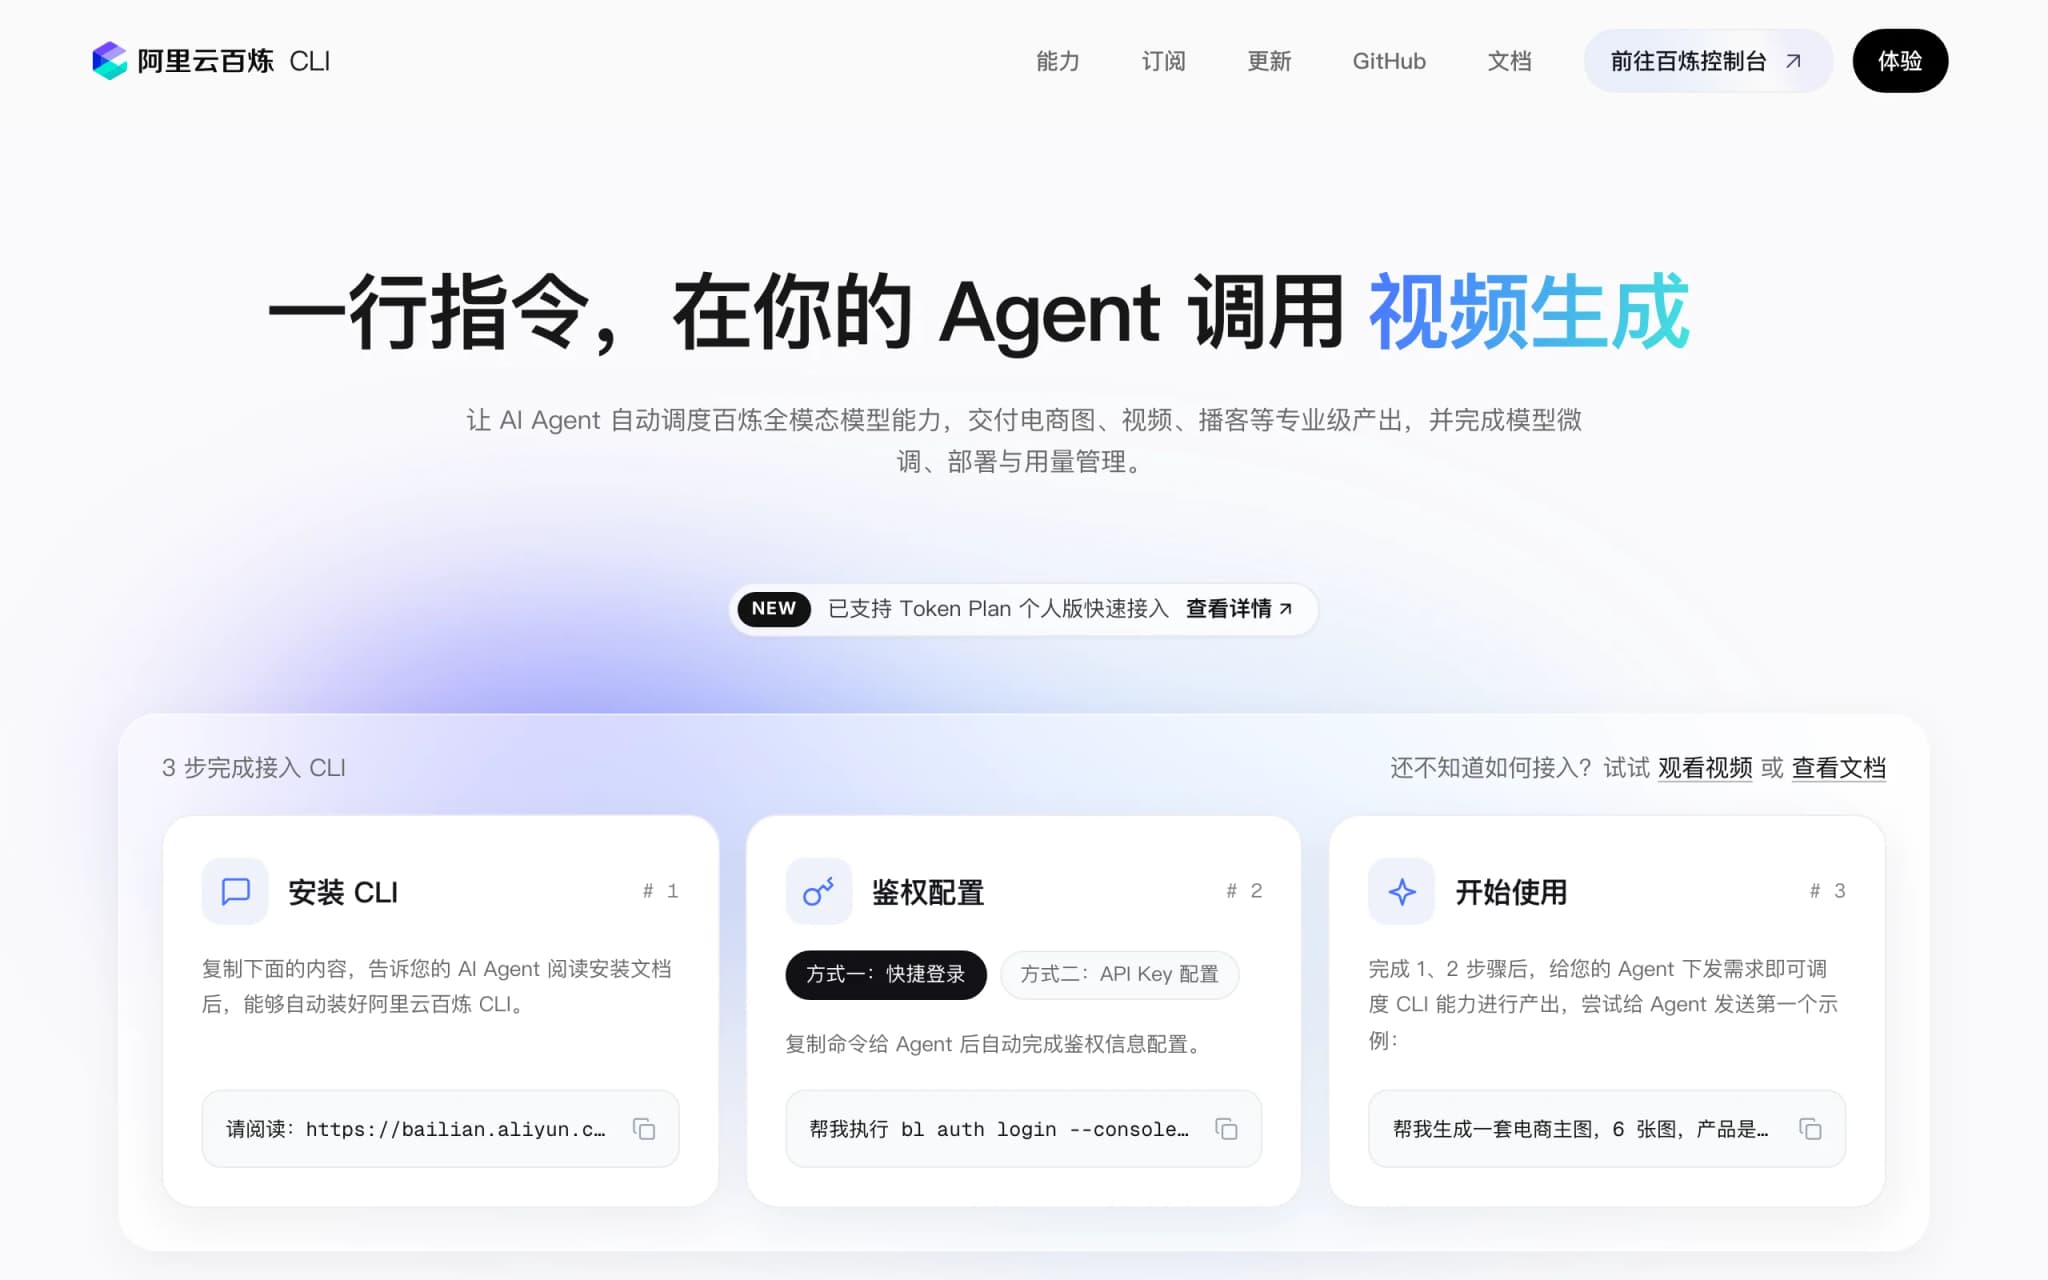
阿里云百炼 CLI – 阿里云开源的 AI Agent 命令行工具
阿里云百炼 CLI 是阿里云开源的 AI Agent 命令行工具,专为智能体(Agent)场景设计。开发者通过一行命令即可让 Agent 自动调用阿里云百炼平台上的 150+ 多模态模型、10+ 应用及知识库、记忆、联网搜索等全套能力。该工具原生兼容 Claude Code、Qoder、OpenClaw 等主流 Agent 框架,支持文本、图像、视频、语音等全模态任务调用与结构化输出,实现从单点模...
Dulus – 开源的 CLI AI Agent,可驱动多模型工具调用
Dulus 是一个约 12K 行 Python 代码的开源命令行 AI Agent 框架,支持 Claude、GPT、Gemini、DeepSeek、Kimi、Qwen 等 40 余种主流语言模型。其核心创新在于能够直接捕获浏览器中网页版 AI 的访客会话,将其转化为具备文件读写、代码编辑、Bash 执行、Web 搜索等 27 种工具调用能力的本地代理。Dulus 同时支持 MCP(Model C...
Mega-ASR – NTU、NUS、上海AI Lab开源的语音识别模型
Mega-ASR是由南洋理工大学(NTU)、新加坡国立大学(NUS)与上海人工智能实验室联合开源的全场景鲁棒语音识别基座模型。该模型以Qwen3-ASR 1.7B为底层架构,通过创新的复合数据构建与渐进式声学到语义优化框架,系统性解决了真实世界中复杂声学环境下的语音识别难题,涵盖噪音、远场、回声、遮挡、传输丢包等7种原子声学效应及54种物理合理的复合场景。
Stable Audio 3 – Stability AI 开源的音频生成模型系列
Stable Audio 3是Stability AI推出的新一代开源音频生成模型系列,基于流匹配潜空间扩散架构,支持文本转音乐与音效、音频编辑及续写。该系列提供Small、Medium、Large三种规格模型,其中Small版本可在MacBook Pro等消费级设备上本地运行并生成最长2分钟音频,Medium与Large则支持超过6分钟的高质量音频生成。全系模型采用完全授权数据训练,开放Smal...