AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:AI Agent
共 305 篇文章 · 清除标签
Claude Haiku 5.5 – Anthropic 推出的最轻量级模型
Claude Haiku 5.5 是 Anthropic 于 2026 年 10 月 7 日正式发布的最新小型语言模型,定位为"最便宜、最快、最能打"的高性价比产品。该模型将输入价格降至 $0.10/百万 token,综合成本降低约 75%,同时实现了电脑操作能力从 15.7% 到 72.4% 的大幅跃升。其支持 100 万 token 上下文窗口和五档可调思考机制,适用于智能摘要、数据分类、实时...
Startlux-Decision – StartLux Labs 开源的决策模型家族深度评测
StartLux-Decision 是 StartLux Labs 推出的开源决策模型家族,涵盖从 0.8B 至 27B 的五个稠密模型以及 35B-A3B 混合专家模型,专为类型化决策任务设计。该模型家族接收文本、JSON 或图片形式的状态输入,针对选择、是非、评分等结构化问题,通过单次前向推理直接返回每个选项的概率分布,天然可作为置信度使用。模型原生支持 256K token 超长上下文,具备...
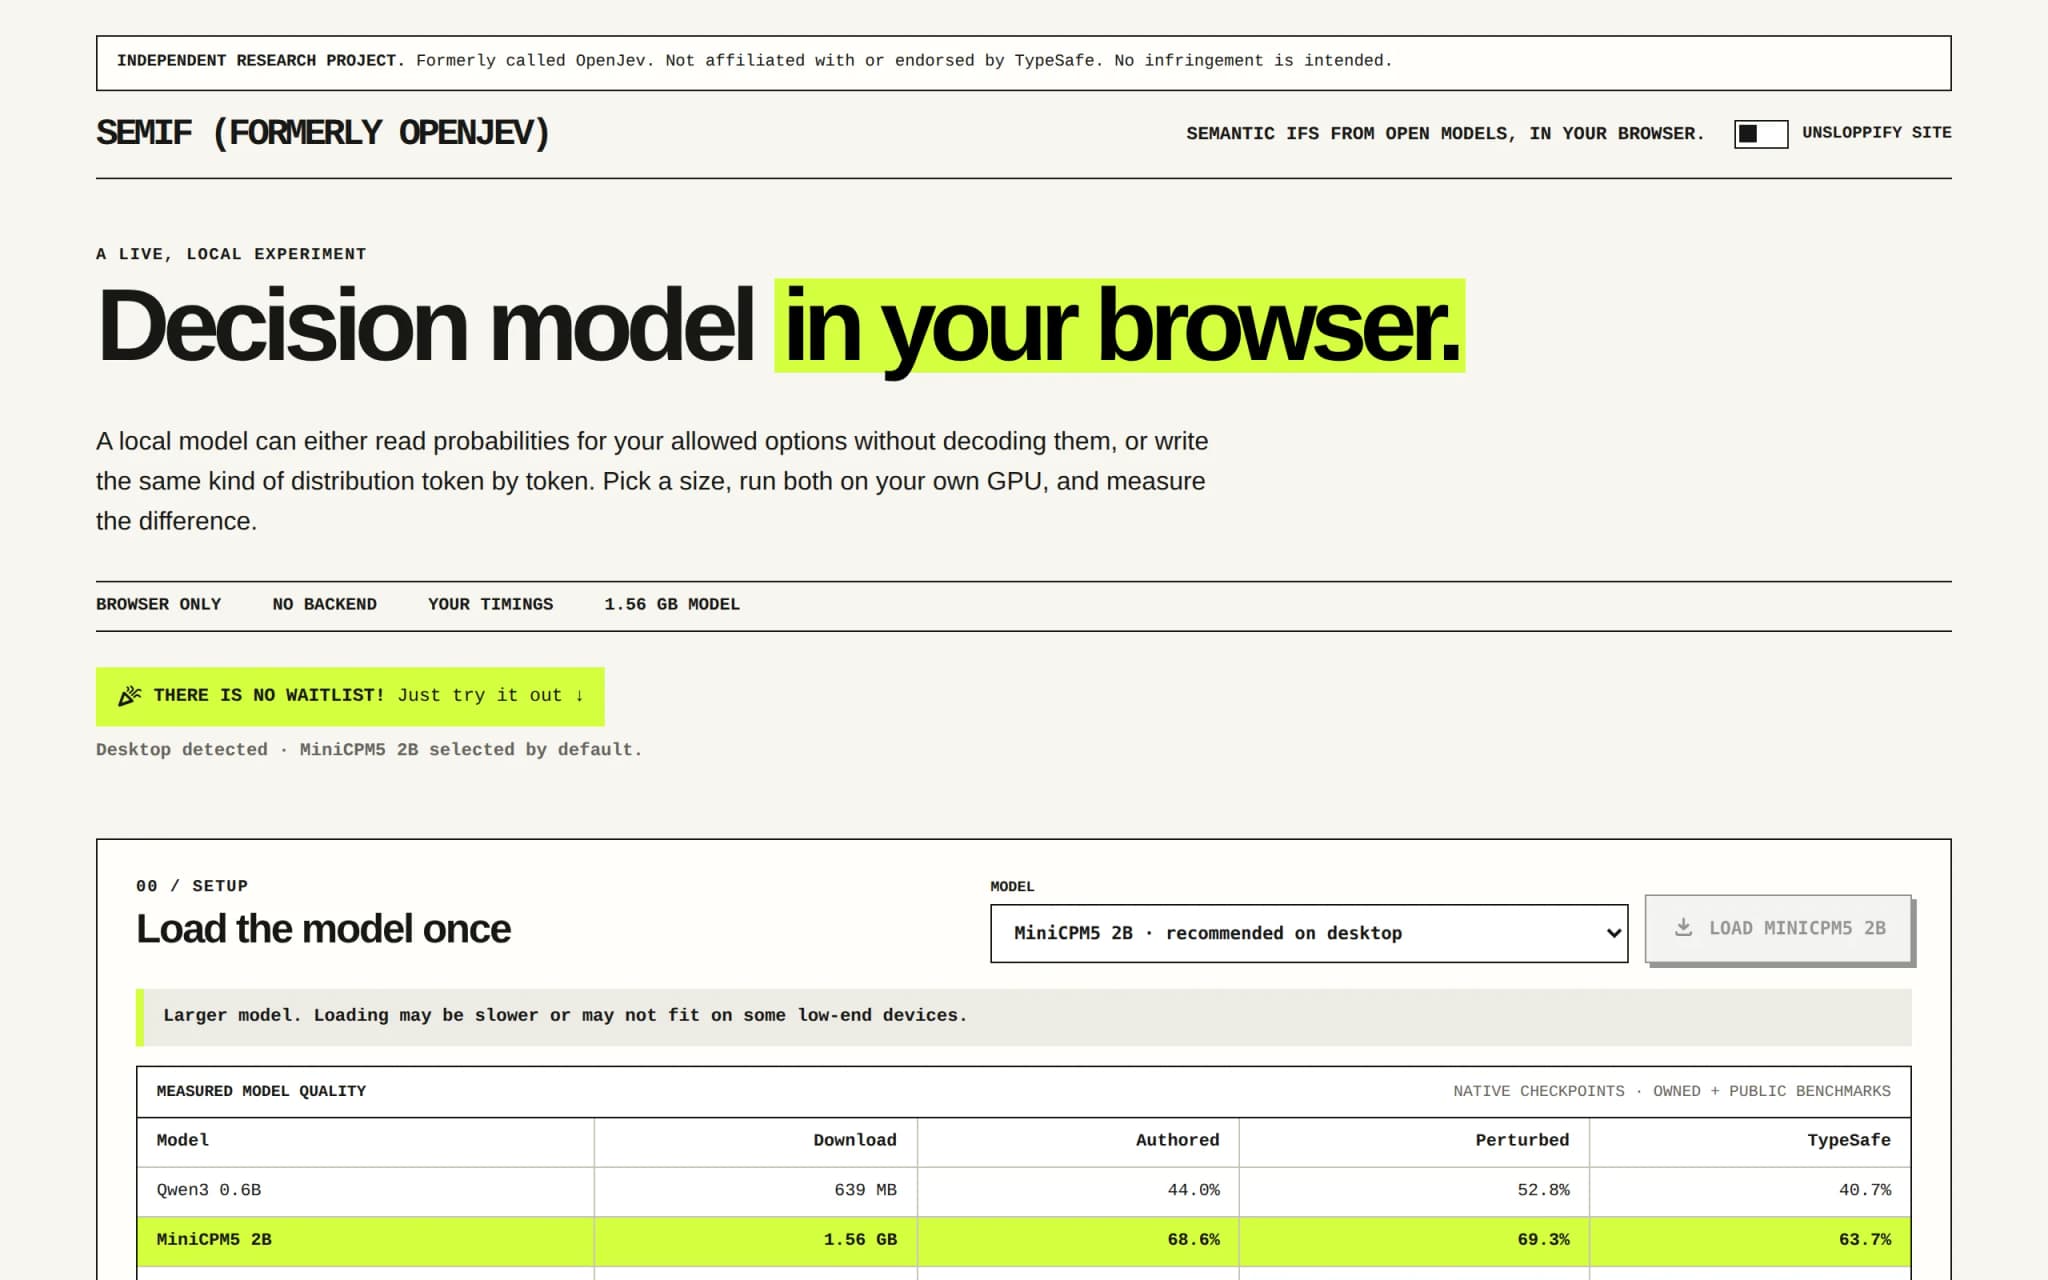
SemIf – 开源的 AI 决策模型,复现 Jev 语义决策模式
SemIf(原 OpenJev)是一个开源的 AI 决策模型,旨在通过开源手段复现 TypeSafe 闭源服务 Jev 的语义决策接口模式。该模型采用单次前向传播机制,直接读取候选选项对应的 logits 进行打分,由服务端构造结构化结果,从而规避了传统自回归生成后再解析文本的复杂流程。在多个问题共享相同状态时,SemIf 还可复用前缀计算,吞吐量提升近一个数量级。该模型在单张 RTX 3090 ...
MAI-Transcribe-2-Streaming:微软实时流式语音转写模型深度评测
MAI-Transcribe-2-Streaming 是微软推出的首个实时流式语音转写模型,能够在讲话进行时持续输出文字,覆盖 60 种语言并自动检测语言切换。该模型在 Artificial Analysis 流式转写榜单中以 2.50% 的词错误率和 0.13 秒的最终转录延迟双双登顶,首批文本延迟低至数百毫秒,文字最快在语音后 320 毫秒显示。其核心价值在于将传统语音转写从"说完再识别"的批...
Ling-3.1-flash:蚂蚁百灵团队推出的大规模稀疏激活长流程任务模型
Ling-3.1-flash是蚂蚁集团百灵团队推出的新一代大语言模型,采用混合线性Attention架构与MoE稀疏激活技术,总参数量约560B,单Token激活参数仅约25B,支持高达1M的上下文窗口。该模型专为真实世界长流程任务设计,能够连续数小时自主完成办公报告撰写、医疗咨询、代码编译与性能优化等复杂工作,目前已接入蚂蚁内部桌面Agent客户端"小虎",并开放两周免费体验期。
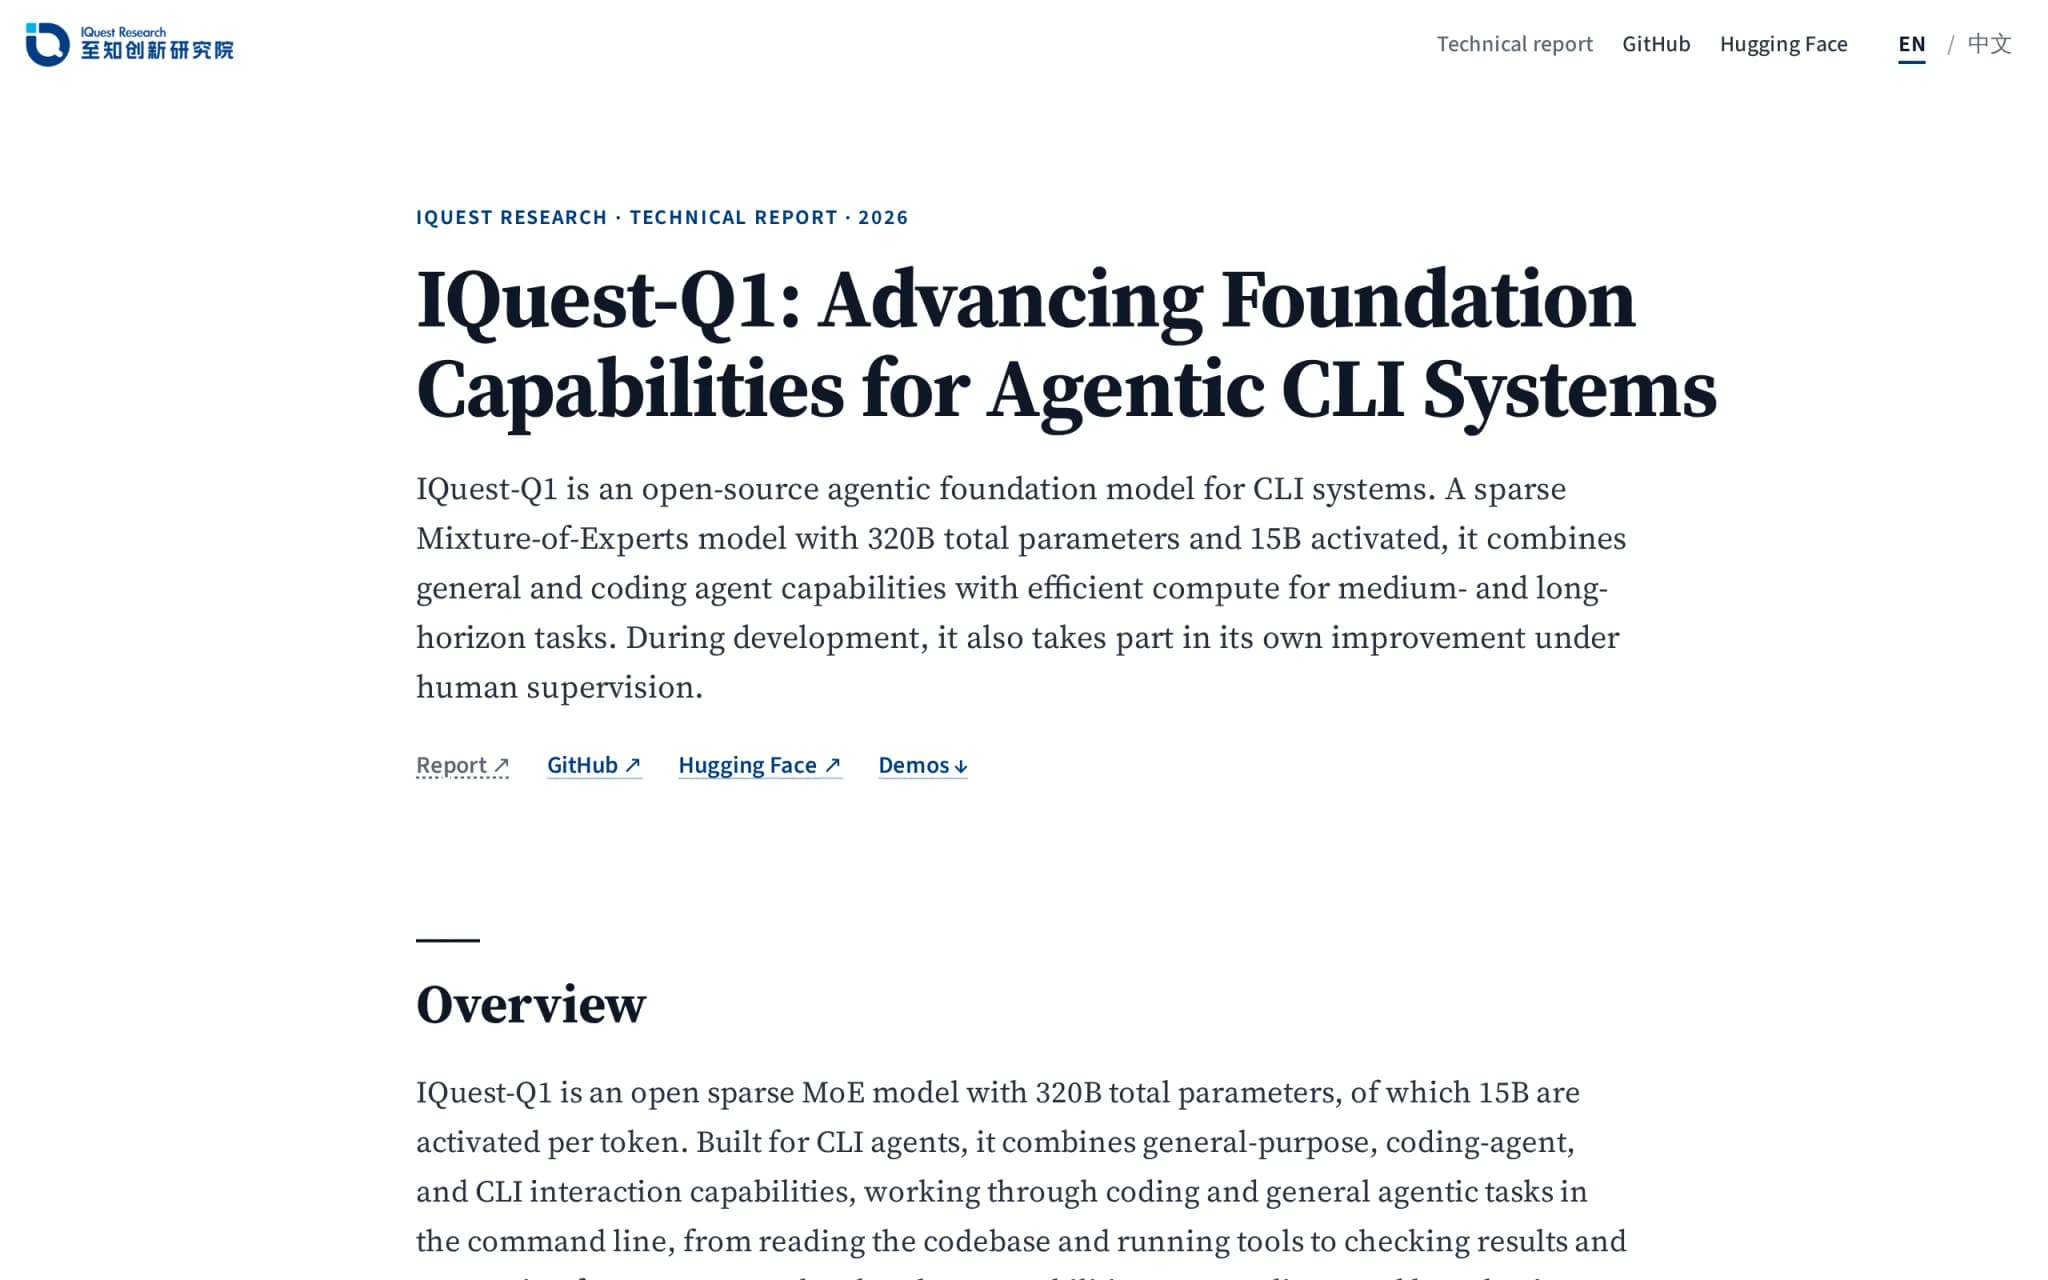
IQuest-Q1 评测:320B 稀疏 MoE 驱动的开源 Agent 基础模型,专攻代码与智能体长程任务
IQuest-Q1 是至知创新研究院(IQuestLab)开源的一款 Agent 基础模型,核心定位聚焦代码生成与智能体任务执行。该模型采用稀疏 MoE 架构,总参数量达 320B,但每个 token 仅激活约 15B 参数,在保持旗舰级任务能力的同时显著降低了推理成本。IQuest-Q1 经过合成环境中的多 harness 强化学习与多教师在线蒸馏(MOPD)训练,可直接接入 Claude Co...
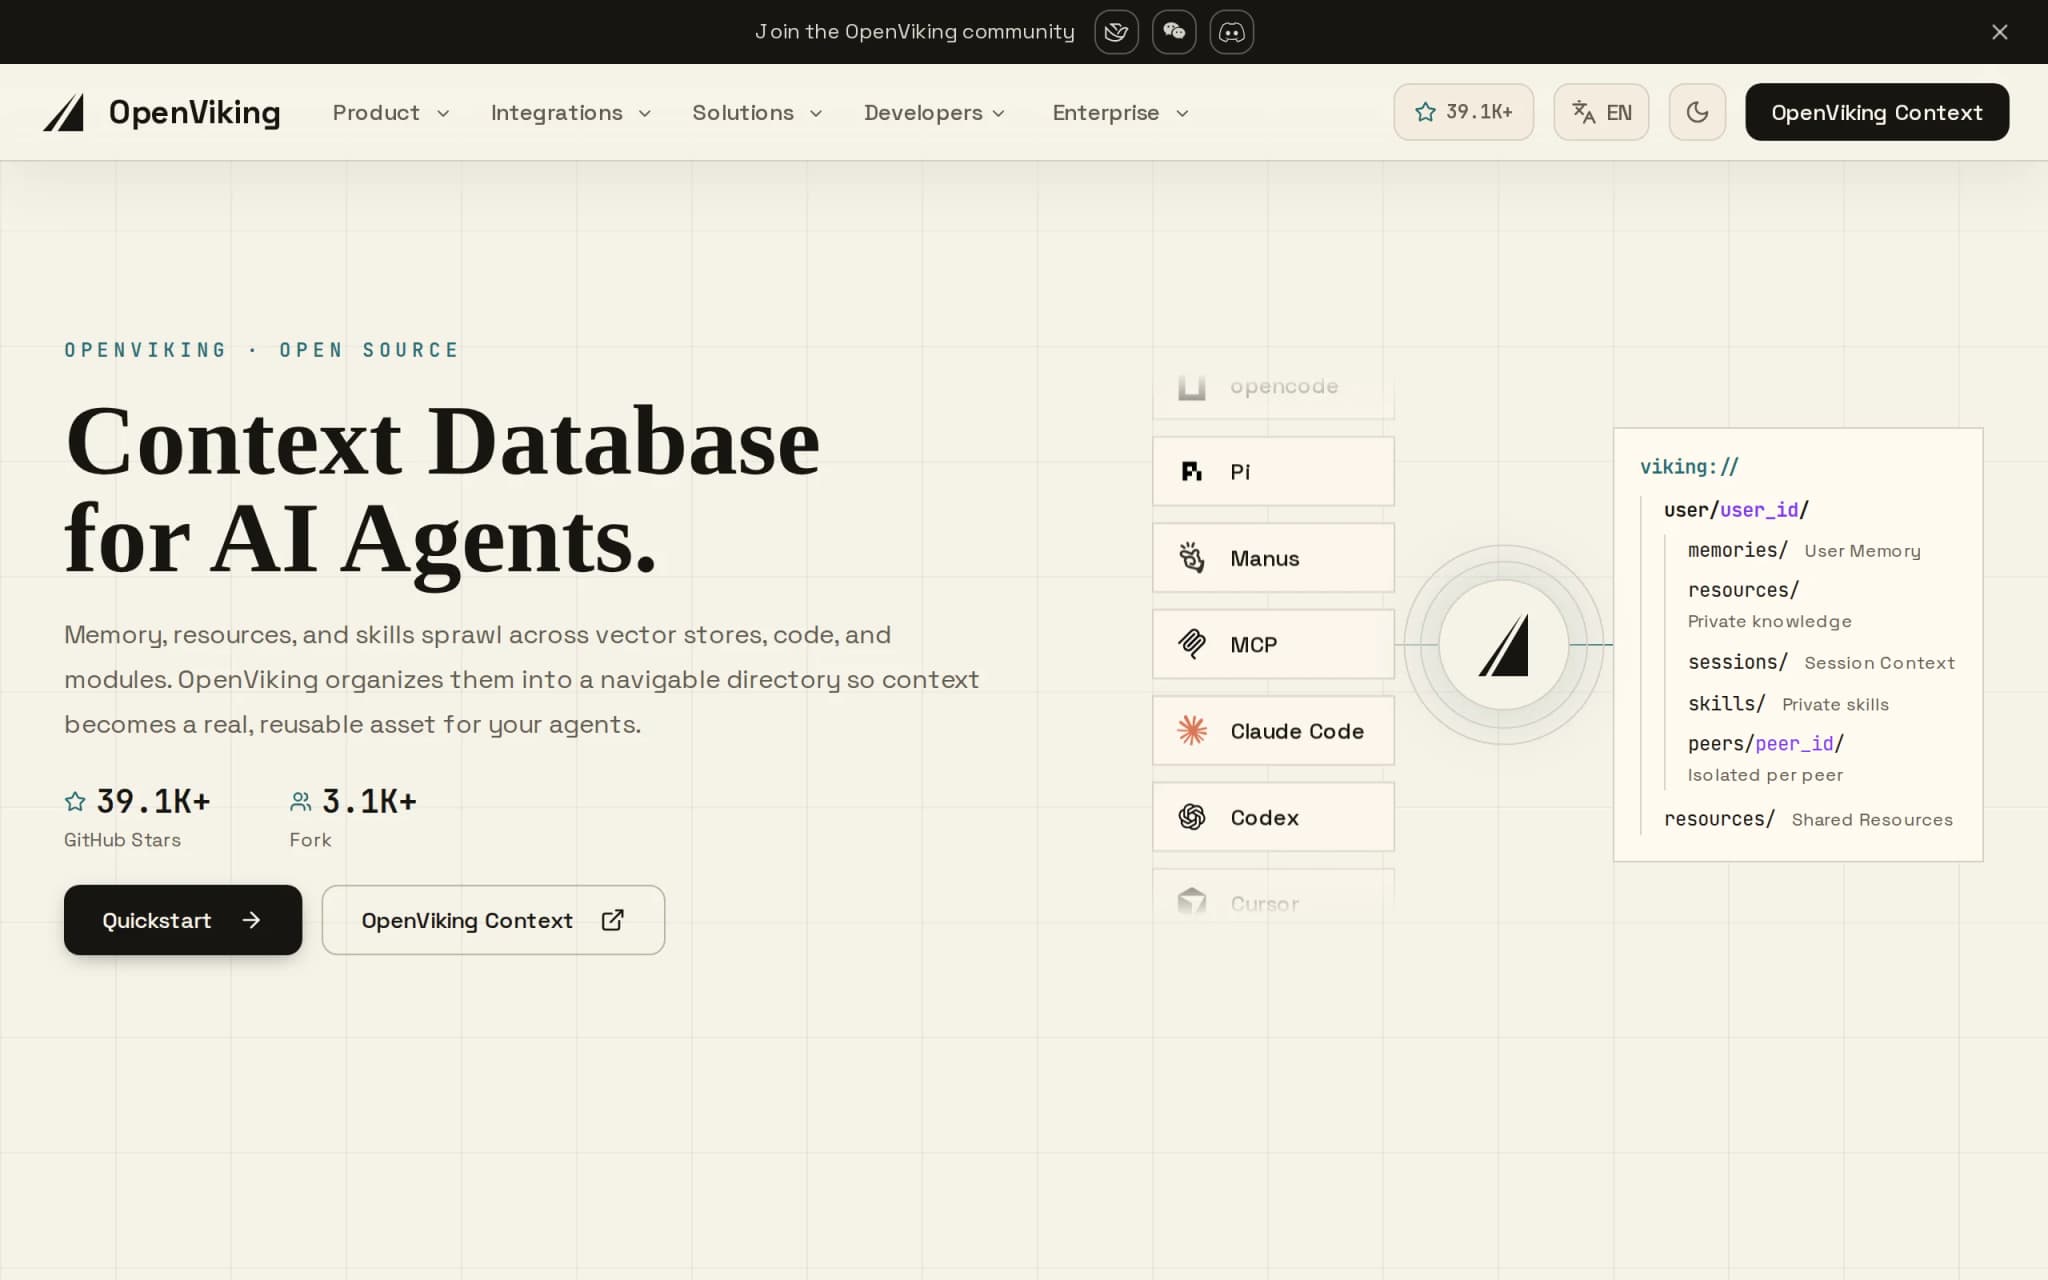
OpenViking – 字节开源的 AI Agent 上下文数据库
OpenViking是由字节跳动火山引擎开源的一款AI Agent上下文数据库,其核心思路是将Agent的记忆、知识RAG和技能统一组织在自定义的`viking://`虚拟文件系统中。Agent可以通过`ls`、`tree`、`find`、`grep`等命令像操作文件一样浏览和检索上下文,告别传统“text in, embeddings out”的黑盒模式。借助L0摘要、L1概览、L2详情三层渐进...
Gemini 4 Argon评测:谷歌DeepMind百万Token长程推理大模型的工程化实践
Gemini 4 Argon是谷歌DeepMind推出的新一代前沿大模型,核心定位是面向复杂长周期工作流的企业级AI系统,覆盖软件工程、金融法律等知识工作及网络安全防御场景。该模型将单次输出上限从6.4万Token大幅提升至100万Token,支持在单一任务轨迹中一次性完成大型代码迁移、深度研究等多步骤复杂任务。在DeepSWE v1.1软件工程评测中,Argon取得77.9%的成绩,并在按美国G...
GPT-6.1 Sol – OpenAI 推出的新一代主力模型
GPT-6.1 Sol是OpenAI于2026年推出的新一代主力模型,作为GPT-6 Sol的升级版本,以GPT-6 Astra旗舰五分之一的Token价格实现接近后者的智能水平。该模型聚焦智能体编程、电脑操作和专业工作三类高消耗场景,在DeepSWE v1.1真实代码库工程任务上追平Astra,在OSWorld 2.0电脑操作评测中仅落后2.1个百分点,同时将缓存输入价格压至每百万Token仅0...
M3.1-Flash-Preview 深度评测:MiniMax 面向日常开发场景的文本编程模型
M3.1-Flash-Preview 是 MiniMax 推出的最新文本编程模型,首发上线于 MiniMax Code 智能编程客户端。该模型面向日常开发场景设计,支持原生多模态输入和百万级上下文窗口,能够从 Bug 修复到完整功能开发形成"定位→实现→测试→交付"的完整闭环。M3.1-Flash-Preview 继承 M3 的 MoE 稀疏混合专家底座,提供 low 至 max 五档推理强度控制...